오늘날 대부분의 기업은 어떤 AI 에이전트와 애플리케이션을 구축할지 결정하는 데 많은 노력을 기울이고 있습니다. 하지만 데이터 전략이 그 속도를 따라갈 수 있는지는 전혀 다른 문제입니다. 오래된 수치를 바탕으로 답변하는 에이전트나 고객이 5분 전에 넣은 주문을 확인하지 못하는 앱은 신뢰를 빠르게 잃습니다. 결국 AI를 확장하는 일은 이를 뒷받침하는 파이프라인, 테이블, 트랜잭션 시스템에 크게 좌우됩니다.
이러한 데이터를 제대로 갖추려면 두 가지가 필요합니다. 하나는 팀이 신뢰할 수 있는 기반, 즉 선언되고 버전 관리되며 테스트된 파이프라인과 동일한 플랫폼에서 통합된 트랜잭션 및 분석 데이터를 마련하는 것이고, 다른 하나는 반복 업무를 AI에 더 많이 맡기는 것입니다.
오늘 Expedition에서 Snowflake는 이 두 가지를 모두 지원하는 기능을 발표합니다. 이 기능들은 실시간 분석과 개방형 레이크하우스 데이터부터 엔터프라이즈 액세스와 트랜잭션 시스템까지 폭넓게 포괄하지만, 모든 것은 파이프라인을 구축하고 안정적으로 운영하는 방식에서 시작됩니다.
자율 데이터 엔지니어링을 위한 기반
AI는 변환을 생성하거나 수정 방안을 제안할 수 있지만, 엔지니어링 팀은 여전히 워크플로우가 무엇을 수행해야 하는지, 무엇이 그 워크플로우에 의존하는지, 변경 사항을 안전하게 릴리스할 수 있는지를 알아야 합니다. 이러한 요소들을 제대로 이해해야 AI 지원이 실제로 업무를 줄이는지, 아니면 검토해야 할 변경 사항만 늘리는지 판단할 수 있습니다. 이를 위해 조직은 다음과 같은 기반을 갖춰야 합니다.
현대적 인프라로 전환
먼저 하드웨어 관련 의사 결정 부담부터 덜어야 합니다. Adaptive Compute(정식 출시)는 컴퓨팅 규모를 자동으로 최적화해 수동 웨어하우스 또는 클러스터 튜닝 없이 각 워크로드에 맞는 리소스를 할당합니다. 수행할 작업을 설명하면 Snowflake가 실행 방식을 최적화합니다.
Spark 워크로드도 Adaptive Compute에서 실행되므로 이러한 유형의 워크로드에 필요한 작업 부담이 줄어듭니다. 시작도 간단합니다. 기존 코드와 역량을 Snowflake로 가져와 나머지 파이프라인과 동일한 거버넌스 적용 플랫폼에서 실행할 수 있습니다. Snowpark Connect for Apache Spark™(정식 출시)는 관리할 외부 클러스터 없이 기존 PySpark, Java, Scala 코드를 Snowflake에서 직접 실행합니다. Next-Gen File Reader for Apache Spark(프라이빗 프리뷰)는 JSON, CSV, XML, Parquet에서 Spark 고유의 읽기 시맨틱을 손쉽게 실행해 정돈되지 않은 브론즈 계층 파일도 다룰 수 있게 합니다.
Snowpark Connect는 Horizon, AWS Glue 및 Unity Catalog에서 관리하는 Apache Iceberg™ 테이블에 모든 작업에서 액세스할 수 있는 완전한 상호운용성을 지원하며, Spark write-audit-publish로 프로덕션 전에 데이터 품질 검사를 활성화해 에이전트를 배포할 수 있습니다. 이 기능은 격리된 브랜치를 생성해 잘못된 데이터가 프로덕션에 도달하지 않도록 돕는 방식으로 작동합니다. 브랜치는 다른 테이블과 마찬가지로 Snowflake 또는 모든 엔진에서 쿼리할 수 있어 다운스트림 영향을 확인할 수 있습니다. 그런 다음 게시하거나 폐기할 수 있으므로 데이터가 프로덕션으로 이동하기 전에 품질 검사를 더 쉽게 구현할 수 있습니다.
Incremental reads(정식 출시)는 Spark 작업을 더 효율적으로 만듭니다. 전체를 스캔하지 않고 Iceberg 스냅샷 간 변경 사항만 처리합니다. Iceberg Time Travel 및 태그(정식 출시)는 안전한 롤백과 안정적으로 공유 가능한 체크포인트를 제공해 팀이 Spark 또는 기타 워크로드에서 더 쉽게 작업할 수 있도록 합니다. Snowpark Connect는 Spark 4.0(프라이빗 프리뷰)에서 Iceberg 지원을 Iceberg v3까지 확장했으며, 반정형 데이터를 위한 VARIANT 데이터 유형과 행 계보 등 핵심 기능을 추가해 변경 데이터 캡처(CDC), 감사, 규정 준수 워크플로우를 간소화합니다.
Spark Monitoring UI(퍼블릭 프리뷰)는 세션과 배치 작업 전반에서 개별 쿼리 프로필까지 내려가는 통합 디버깅을 제공합니다. Code Bundles for Apache Spark(퍼블릭 프리뷰)를 사용하면 REST API 또는 SQL을 통해 Spark 작업을 제출할 수 있어 Airflow부터 Snowflake 태스크까지 이미 실행 중인 스케줄러에 맞게 통합됩니다. 시작을 돕기 위해 Spark migration skill on Snowflake CoCo(정식 출시)는 기존 PySpark, Spark Scala, Spark Java 노트북과 작업을 Snowflake에서 실행되도록 변환합니다.
선언형 SQL 파이프라인의 경우, Dynamic Table의 사용자 지정 증분화(정식 출시)는 증분 로직을 완전히 제어하고 필요한 시점에 스케줄링할 수 있게 합니다. dbt의 Dynamic Table(정식 출시)는 증분화 로직을 dbt 프레임워크에 네이티브로 통합하므로 dbt 팀은 기존 툴체인을 벗어나지 않고도 Dynamic Table 성능을 활용할 수 있습니다. 고객은 Dynamic Iceberg 테이블을 사용해 임상 데이터 세트와 같은 오픈 형식 데이터 제품을 사용자 지정 파이프라인 없이 최신 상태로 유지할 수 있으며, 이제 프라이빗 프리뷰에서는 Snowflake가 이를 고객의 외부 Iceberg 카탈로그로 직접 새로 고칠 수 있습니다.
소프트웨어 수명 주기 정의
현대적 인프라는 출발점이지만, 명령형 코드는 여전히 테스트, 디버깅, 신뢰 확보가 어렵습니다. 선언형이며 버전 관리되는 워크플로우로 전환하면 리소스를 확보해 새로운 데이터 제품을 구축할 시간을 만들 수 있습니다.
dbt Projects(정식 출시)는 dbt 프레임워크를 Snowflake에 네이티브로 제공해 인프라나 외부 오케스트레이터를 관리하지 않고도 dbt 모델을 테스트하고 문서화할 수 있게 합니다. Slim CI 및 프로덕션으로 defer(정식 출시)를 사용하면 dbt 프로젝트 오브젝트 아티팩트를 재사용해 변경된 모델만 실행할 수 있습니다. 이를 통해 검증 시간이 몇 분에서 몇 초로 줄어들고 모든 풀 요청을 현실적으로 점검할 수 있습니다.
DCM Projects(정식 출시)를 사용하면 팀은 Snowflake 인프라, 데이터 파이프라인, 거버넌스 구성을 선언형으로 관리할 수 있으며, 모든 변경 사항이 프로덕션에 도달하기 전에 검증하는 감사 가능한 CI/CD 자동화를 적용할 수 있습니다. DCM Test Branches(프라이빗 프리뷰)는 이를 한 단계 더 확장해 배포 전에 프로덕션 데이터 또는 합성 데이터로 자동화된 단위 테스트와 통합 테스트를 수행할 수 있게 합니다.
데이터 네이티브 하니스 추가
현대적 인프라와 정의된 수명 주기가 마련되면, 다음 단계는 반복적인 설정, 튜닝, 문제 해결 태스크를 처리하며 데이터 기반 워크플로우를 에이전트 방식으로 구동하는 하니스입니다.
Dynamic Tables Insights(정식 출시)는 Snowflake CoCo가 대신 구현할 수 있는 구체적인 최적화 권장 사항을 표시합니다. 시스템이 스스로 진단하고, 무엇을 수정해야 하는지 알려주며, CoCo에서 구현 단계를 안내합니다.
CoCo의 Snowpipe 자동 설정(정식 출시)은 S3 경로에서 연속 파일 수집 파이프라인을 구축합니다. 스테이지, 파이프, 파일 형식, 오류 처리가 모두 구성되어 실행됩니다.
Pipeline Builder(퍼블릭 프리뷰)는 노트북, ML 작업, 태스크, SQL 오브젝트를 오케스트레이션하는 시각적 캔버스를 제공합니다. CoCo와의 대화로 구축하고 연결을 드래그해 편집할 수 있습니다. Task Graph Object(퍼블릭 프리뷰)는 태스크를 완전한 오케스트레이터로 확장합니다. 그래프를 일시 중단하지 않고 변경할 수 있으며 조건부 분기도 가능합니다.
데이터 엔지니어링 태스크에 특화된 데이터 네이티브 하니스를 사용하면 엔지니어는 토큰을 더 효율적으로 사용하고 더 높은 품질의 결과물을 생성하며, 결과적으로 파이프라인 연결과 튜닝에 쓰는 시간이 줄어듭니다. 플랫폼에는 마지막 단계, 즉 발견한 내용을 바탕으로 행동하는 데 필요한 컨텍스트도 축적됩니다.
반복 업무를 에이전트에 맡기기
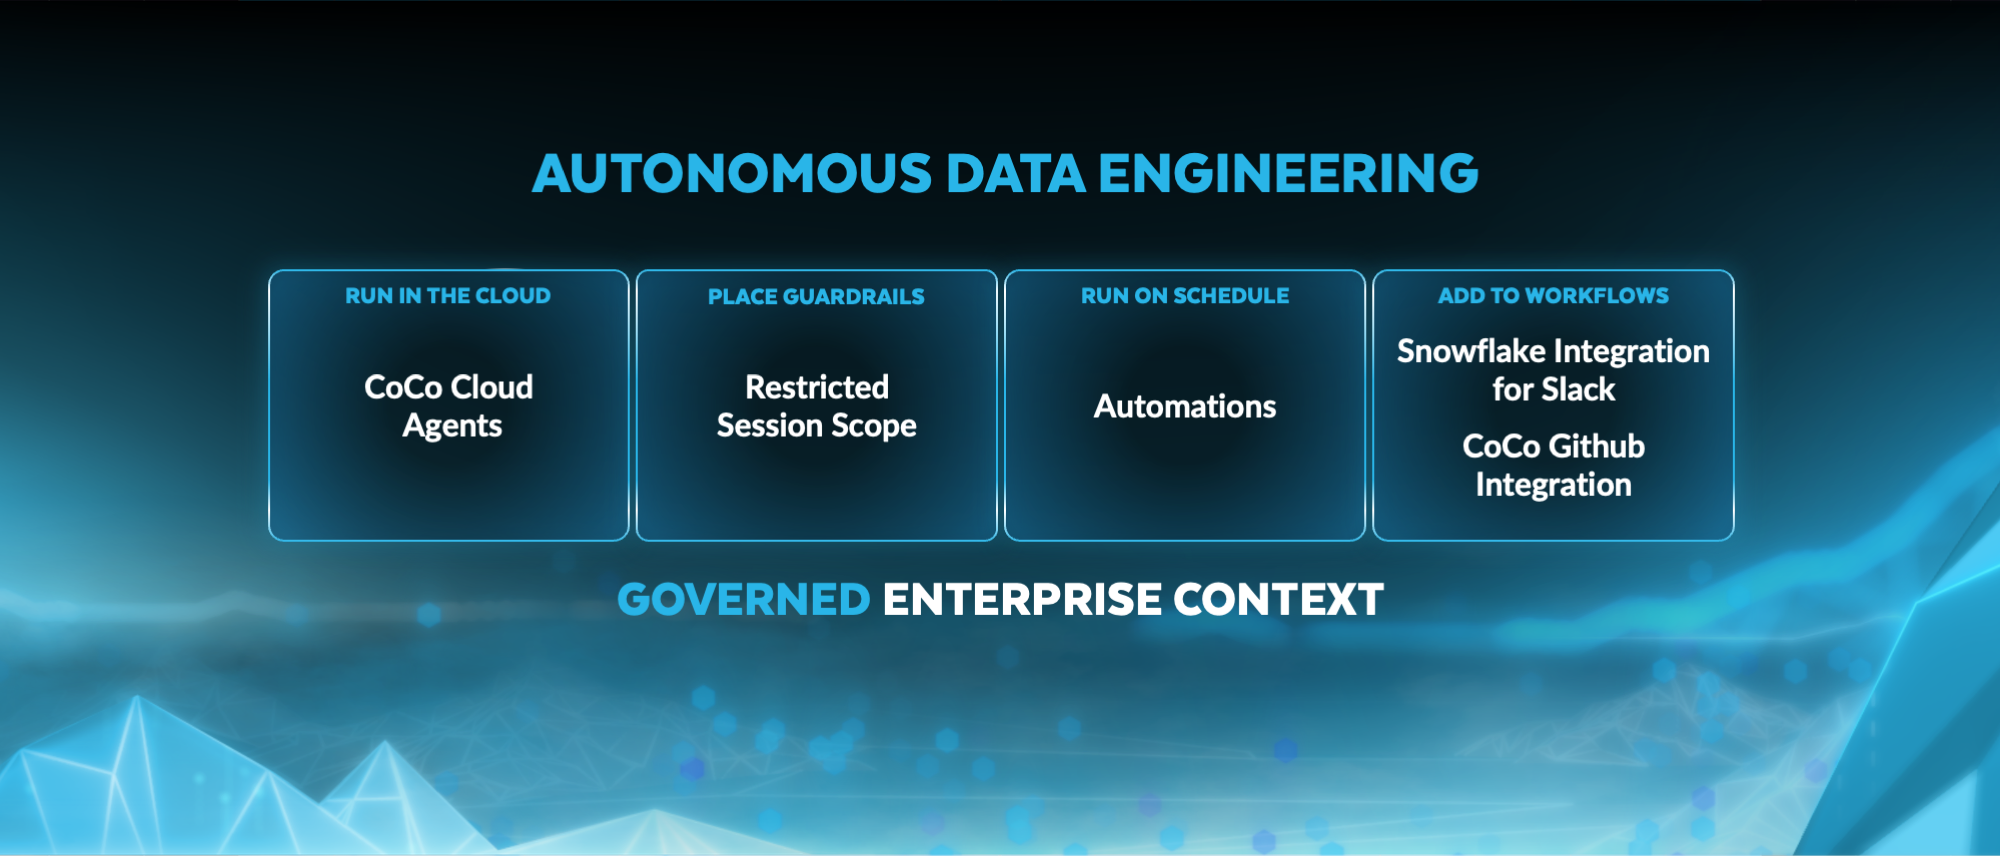
이 모든 기반은 결국 반복적이고 일상적인 업무를 스스로 처리할 수 있는 에이전트로 이어집니다. Cloud Agents(정식 출시)를 사용하면 CoCo는 엔지니어의 랩톱에서 실행되는 대신 Snowflake가 관리하는 격리된 환경을 시작합니다. 각 세션에는 고유한 보안 컨테이너가 할당되고 공유 Snowflake Workspace의 파일을 대상으로 작업하며, 데이터 엔지니어는 Restricted Session Scope(정식 출시)를 통해 에이전트가 수행할 수 있는 작업을 더 제한하거나 범위를 좁힐 수 있습니다. 작업이 클라우드에서 이루어지기 때문에 엔지니어가 로그오프한 후에도 계속 진행될 수 있으며, 장기 실행 태스크와 팀 간 협업을 지원합니다.
Coding Agents(정식 출시)는 Cortex Agents REST API 또는 SQL을 통해 자체 애플리케이션에 코딩 기능을 추가합니다. CoCo automations(Snowsight 인터페이스와 CLI에서는 정식 출시, CoCo Desktop에서는 퍼블릭 프리뷰)를 사용하면 데이터 팀이 이러한 에이전트를 자율적으로 실행할 수 있습니다. 데이터 엔지니어는 파이프라인 상태 확인이나 실패한 작업 조사와 같은 반복 태스크를 자연어로 설명할 수 있으며, 해당 태스크는 선제적으로 실행됩니다. 팀은 자체적으로 구축한 CoCo Skills를 공유할 수 있어 워크플로우를 쉽게 재사용할 수 있습니다. CoCo는 Snowflake 내에서 실행되므로 조직의 계보, 카탈로그, 거버넌스 정책과 함께 작동하며, 범용 코딩 어시스턴트에는 없는 컨텍스트를 확보합니다.
Snowflake for Slack(곧 퍼블릭 프리뷰)는 CoCo를 팀이 이미 일하는 채널로 가져와, 사용자가 스레드를 벗어나지 않고 질문하고 워크플로우를 시작하거나 결과를 검토할 수 있게 합니다. 또한 CoCo GitHub 통합(퍼블릭 프리뷰)을 통해 제안된 코드 변경은 여전히 팀의 기존 검토 프로세스를 거치게 됩니다.
각 기반 계층은 앞선 계층 위에 쌓입니다. 인프라를 추상화하고, 수명 주기를 코드화하며, 데이터 네이티브 하니스를 더하고, 에이전트가 자동화할 명확한 작업을 부여하는 방식입니다. 다음 질문은 이러한 파이프라인이 이를 필요로 하는 에이전트와 앱의 속도에 맞춰 데이터를 실시간으로 전달할 수 있는가입니다.
하나의 환경에서 구현하는 엔드투엔드 실시간 분석
자체 관리형 파이프라인은 분명 중요한 성과이지만, 최종 목표는 아닙니다. 에이전트에 오래된 정보를 전달한다면 그 가치는 줄어듭니다. 하지만 더 최신의 데이터를 확보하려면 일반적으로 이를 필요로 하는 각 워크로드마다 새로운 인프라를 추가하고 운영해야 했습니다.
이제 Snowflake는 엔드투엔드 실시간 분석을 연결성, 변환, 서빙까지 하나의 환경에 통합합니다. 이를 통해 팀은 연결되고 비용 효율적이며 거버넌스가 적용된 방식으로 이러한 사용 사례를 구축할 수 있습니다.
대용량 수집부터 살펴보면, Snowpipe Streaming은 테이블당 최대 20 GB/s, 5초 지연 시간, 예측 가능한 가격 기반 처리량으로 연속 데이터 파이프라인을 Snowflake에 직접 스트리밍할 수 있게 합니다. Elastic Channels(정식 출시)를 사용하면 수천 개의 생산자가 하나의 수집 경로를 공유할 수 있으며, 트래픽이 증가해도 Snowflake가 확장을 처리하므로 채널을 직접 조정할 필요가 없습니다. Datastream(곧 퍼블릭 프리뷰)은 데이터 엔지니어에게 익숙한 Apache Kafka 프로토콜을 Snowflake의 보안 및 거버넌스 경계 안으로 가져옵니다. 데이터가 도착하면 Streaming Transformations(프라이빗 프리뷰)를 통해 팀은 표준 SQL로 이동 중인 데이터를 변환할 수 있으므로, 다운스트림 데이터는 최신 상태를 유지하고 몇 초 안에 앱에서 사용할 준비를 마칩니다.
대시보드, 고객 대면 앱, AI 에이전트는 종종 같은 데이터에 동시에 접근하며, 많은 실시간 프로젝트가 바로 이 지점에서 정체됩니다. 팀은 이를 감당하기 위해 결국 데이터를 별도의 서빙 데이터베이스로 복사하게 되고, 이는 더 높은 인프라 비용과 운영 오버헤드로 이어집니다. Interactive Analytics(정식 출시)는 엔지니어가 이미 관리하는 동일한 거버넌스 적용 테이블에서 높은 동시성 환경의 1초 미만 쿼리로 해당 트래픽을 Snowflake에서 직접 처리합니다. 동기화해야 할 두 번째 사본도, 보안을 적용해야 할 추가 시스템도, 계속 실행해야 할 별도 파이프라인도 없습니다. 팀은 두 번째 시스템 비용을 지불하지 않고도 필요한 성능을 확보할 수 있습니다.
각 소스의 연결 방식 선택
모든 워크로드가 동일한 최신성 요구 사항을 갖지 않듯, 데이터 팀도 모든 소스에 동일한 패턴을 적용할 필요가 없습니다. 일부 데이터는 Snowflake로 수집하고 변환해야 합니다. 다른 데이터는 시스템 오브 레코드에 그대로 두고 그 위치에서 쿼리할 수 있습니다. 각 소스를 어떻게 연결할지 선택하면 관리해야 할 사본과 유지해야 할 파이프라인이 줄어듭니다.
Snowflake로 가져와야 하는 데이터의 경우, Snowflake Openflow는 광범위한 소스를 연결하도록 설계되어 엔터프라이즈 규모의 수집을 지원합니다. 온프레미스 연결성이 필요해 Data Connectivity Proxy(정식 출시)를 사용하든, 추가 클라우드 환경 지원이 필요하든, Openflow는 옵저버빌리티와 AI 지원 문제 해결 기능을 바탕으로 성능, 엔터프라이즈 범위, 운영 제어를 제공할 수 있습니다. 런타임 스케줄링과 자동 일시 중단은 통합 워크로드를 언제 실행할지에 대한 팀의 제어력도 높여줍니다.
팀은 이미 스토리지 환경에 있는 파일로 작업할 방법도 필요합니다. Zero-Copy Parquet는 소스 데이터를 다시 쓰지 않고도 기존 Parquet 파일을 Iceberg로 사용할 수 있게 합니다. Parquet Direct는 Parquet 파일을 제자리에서 쿼리하기 위한 별도의 읽기 전용 경로입니다.
이미 신뢰하는 시스템 오브 레코드에 있는 데이터의 경우, SAP Business Data Cloud, Workday Data Cloud, Salesforce 제로 카피 통합이 이제 정식 출시되었습니다. 제로 카피 통합은 소스 시스템의 데이터에 대한 액세스를 제공하도록 설계되어 분석 또는 AI를 위한 추출 파이프라인 구축 필요성을 줄입니다. SAP 고객은 프라이빗 연결성 요구 사항을 충족하면서 비즈니스 크리티컬 데이터를 분석과 AI에 활용할 수 있습니다. SAP Business Data Cloud와 Snowflake 간 단방향 AWS PrivateLink 연결성(곧 정식 출시)은 고객이 신뢰할 수 있는 SAP 비즈니스 컨텍스트를 엔터프라이즈 데이터 전반으로 확장해 비즈니스 성과를 창출하도록 돕습니다.
이러한 패턴은 하나의 데이터 아키텍처 안에서 공존할 수 있습니다. 예를 들어 엔지니어는 Openflow로 운영 이벤트를 수집하고, 제로 카피 통합을 통해 파트너 데이터에 원본 위치에서 액세스하며, Spark를 사용해 Iceberg의 파일을 처리할 수 있습니다. 따라서 각 소스에 대해 내려야 할 결정은 데이터가 이동해야 하는지, 어떻게 사용될지, 어떤 제어를 적용해야 하는지입니다. 이러한 질문은 비즈니스가 실제로 운영되는 트랜잭션 시스템에서 가장 중요합니다.
앱과 에이전트에서 운영 데이터 활용
앱과 에이전트가 비즈니스를 완전하게 이해하고 정확한 의사 결정을 내리려면 최신 운영 컨텍스트가 필수적입니다. 하지만 대부분의 조직은 여전히 한 시스템에서 트랜잭션을 실행하고 다른 시스템에서 분석을 수행하며, ETL 파이프라인으로 두 시스템 사이의 데이터를 이동합니다. 이러한 파이프라인은 지연 시간과 비용을 늘리고, 엔지니어가 유지 관리해야 할 업무를 하나 더 추가합니다.
이를 해결하기 위해 Snowflake는 Snowflake Postgres를 도입해 세계에서 가장 인기 있는 데이터베이스를 Snowflake로 가져왔습니다. 오픈소스 pg_lake를 통해 취약한 서드 파티 ETL을 데이터 자산 환경을 연결하는 더 단순하고 효율적인 방식으로 대체할 수 있었습니다. 이제 데이터 미러링을 도입해 이러한 단순성을 한 단계 더 확장합니다. 데이터 미러링은 완전 관리형 솔루션으로 트랜잭션 데이터를 인사이트로, 인사이트를 실행으로 전환합니다.
설정도 간단합니다. 명령어 하나 또는 몇 번의 클릭이면 됩니다. Postgres 데이터 미러링(정식 출시)은 분석과 AI를 위해 Postgres 테이블을 Snowflake 전반에 지속적으로 복제합니다. Snowflake 데이터 미러링(곧 퍼블릭 프리뷰 제공)은 데이터를 반대 방향으로 보냅니다. 강화된 고객 프로필과 분석 결과가 Postgres로 다시 흘러가 더 스마트한 에이전트와 더 개인화된 경험을 구동합니다.
Streamlit 또는 Snowflake App Runtime으로 구축된 내부 엔터프라이즈 앱은 이미 Snowflake에서 실행되며 Snowflake 데이터를 읽습니다. 이러한 앱에 빠른 트랜잭션 읽기와 쓰기도 필요할 때 Hybrid Table은 오버헤드를 크게 줄여 줍니다. 이제 Hybrid Table은 최대 8배 더 높은 처리량을 제공하므로, 특정 워크로드에서는 과거 8개의 XS 웨어하우스가 필요하던 작업을 이제 1개만으로 처리할 수 있어 비용을 80% 이상 줄일 수 있습니다.1 Snowflake는 포인트 작업이 포함된 운영 워크로드에서도 지연 시간을 크게 개선해 P50 지연 시간은 3배 낮추고 P99 지연 시간은 약 2배 낮췄습니다.2 이미 Hybrid Table을 사용하는 수천 곳의 고객은 아키텍처를 다시 설계할 필요 없이 기존 앱을 더 빠르고 낮은 비용으로 운영할 수 있습니다.
Hybrid Table과 Snowflake Postgres는 상호 보완적입니다. 별도의 데이터베이스 없이 다른 Snowflake 기능과 깊이 통합하려는 경우 Hybrid Table이 자연스러운 선택입니다. 팀에 Postgres 에코시스템이 필요하거나 가능한 한 가장 낮은 지연 시간이 필요하다면 Snowflake Postgres가 적합합니다.
업무 변화에 맞춰 진화하는 기반 구축
FAQ
Q: AI 에이전트는 데이터 엔지니어링 작업을 어떻게 지원할 수 있나요?
A: 파이프라인이 선언형으로 관리되고 버전 제어까지 갖추면, AI 에이전트는 파이프라인 상태 확인, 장애 원인 추적, 검토할 수정안 제안과 같은 반복적인 운영 태스크를 맡을 수 있습니다. Snowflake CoCo 자동화는 Snowflake 내부에서 일정에 따라 이러한 에이전트를 실행하며, 에이전트는 계보, 카탈로그, 거버넌스 정책과 함께 작동합니다. 제안된 코드 변경은 여전히 CoCo GitHub 통합을 통해 팀의 기존 검토 프로세스를 거칩니다.
Q: 실시간 분석이란 무엇이며 배치 분석과 어떻게 다른가요?
A: 실시간 분석은 데이터가 도착한 뒤 몇 초 안에 데이터를 처리하고 제공하며, 예약된 배치 작업이 실행되기를 기다리지 않습니다. 에이전트, 대시보드 또는 고객 대면 앱이 의사 결정을 위해 최신 정보를 필요로 할 때 이는 중요합니다. Snowflake는 단일 플랫폼에서 엔드투엔드 실시간 분석을 제공합니다. Snowpipe Streaming을 통한 스트리밍 수집(최대 20 GB/s에서 5초 지연 시간)부터 변환, Interactive Analytics를 통한 1초 미만 서빙까지, 팀이 이미 관리하는 동일한 거버넌스 적용 테이블에서 모두 처리합니다.
Q: Dynamic Table은 데이터 파이프라인을 어떻게 단순화하나요?
A: Dynamic Table을 사용하면 팀이 변환을 쿼리 형태로 선언적으로 정의할 수 있으며, Snowflake가 일정 예약, 증분화, 종속성 순서를 자동으로 처리합니다. 명령형 ETL 코드를 작성하고 유지 관리하는 대신 원하는 결과를 설명하면 플랫폼이 이를 최신 상태로 유지합니다. dbt의 Dynamic Table은 이러한 방식을 dbt 프레임워크로 직접 가져오며, 사용자 지정 증분화는 필요할 때 완전한 제어권을 제공합니다.
Q: Snowflake는 트랜잭션 시스템과 분석 시스템 사이의 ETL을 어떻게 대체하도록 지원하나요?
A: 전통적으로 조직은 한 시스템에서 트랜잭션을 실행하고 다른 시스템에서 분석을 수행하며, 그 사이에 ETL 파이프라인을 둡니다. Snowflake Postgres 데이터 미러링은 명령어 하나로 Postgres 테이블을 분석과 AI를 위해 Snowflake로 지속적으로 복제합니다. Hybrid Table은 반대 방향의 요구, 즉 Snowflake 내부의 빠른 트랜잭션 읽기와 쓰기를 지원하므로, Streamlit 또는 Snowflake App Runtime 기반으로 구축된 내부 앱에는 별도의 데이터베이스가 필요하지 않습니다.
Q: Apache Iceberg와 같은 오픈 테이블 형식은 데이터 엔지니어링에서 어떤 역할을 하나요?
A: 오픈 테이블 형식을 사용하면 데이터를 거버넌스가 적용되는 하나의 위치에 유지하면서 팀이 원하는 컴퓨팅 엔진을 선택할 수 있습니다. Snowflake는 브랜칭, Time Travel, 태그 지정을 통해 Apache Iceberg를 지원하며, 엔지니어에게 쓰기-감사-게시 워크플로우를 제공합니다. 격리된 브랜치에 변경 사항을 스테이지하고 검증한 뒤 게시하거나 폐기합니다. AI 에이전트가 파이프라인과 동일한 테이블을 읽고 쓰기 시작하는 시점에는 특히 중요합니다. 모든 변경 사항에 거버넌스가 적용된 감사 추적이 남기 때문입니다.
1 처리량 및 비용 비교는 Hybrid Table 워크로드의 프로덕션 벤치마크를 기준으로 하며, 성능 개선 전후를 측정했습니다. 동일한 처리량을 내기 위해 이전에는 8개의 XS 웨어하우스가 필요했지만, 이후에는 1개의 XS 웨어하우스만 필요했습니다. 비용 절감은 잠재적 효과이며 워크로드에 따라 달라집니다.
2 지연 시간 비교는 프로덕션 벤치마크를 기준으로 하며, 성능 개선 전후를 측정했습니다. 결과는 워크로드에 따라 달라집니다.