今日のほとんどの企業は、どのAIエージェントやアプリケーションを構築すべきかの決定に懸命に取り組んでいます。しかし、自社のデータ戦略がそれに追いつくかどうかは、まったく別の問題です。古い数値に基づいて回答を提供するエージェントや、顧客が5分前に行った注文を確認できないアプリは、すぐに信頼を失います。AIの拡張は、それにデータを供給するパイプライン、テーブル、トランザクションシステムに大きく依存していることがわかっています。
そのデータを正しく取得するには、2つのステップが必要です。チームが信頼できる基盤(宣言、バージョン管理、テストされたパイプラインと、同じプラットフォーム上で統合されたトランザクションデータおよび分析データ)を確立することと、AIにより多くのルーチン作業を任せることです。
本日のExpeditionで、Snowflakeはこれら両方を実現する機能を発表します。これらはリアルタイム分析やオープンなレイクハウスデータから、エンタープライズアクセスやトランザクションシステムまで多岐にわたりますが、すべてはパイプラインの構築と実行の維持方法から始まります。
自律型データエンジニアリングの基盤
AIは変換の生成や修正の提案に役立ちますが、エンジニアリングチームは依然として、ワークフローが何をすべきか、何がそれに依存しているか、変更をリリースしても安全かどうかを把握する必要があります。これらの要素を理解することで、AIの支援が実際に作業を減らすのか、それとも単にレビューすべき変更を増やすだけなのかが決まります。その目標を達成するために、組織は以下の基盤を整備する必要があります。
モダンインフラストラクチャの導入
まず、ハードウェアの決定を抽象化することから始めます。アダプティブコンピュート (一般提供)は、手動でのウェアハウスやクラスターのチューニングなしで、各ワークロードにリソースを一致させ、コンピュートを自動的に適切なサイズに調整します。ユーザーが作業を記述すると、Snowflakeがその実行方法を最適化します。
Sparkワークロードもアダプティブコンピュートで実行されるため、これらのタイプのワークロードの労力が軽減されます。始めるのも簡単です。既存のコードとスキルをSnowflakeに持ち込み、他のパイプラインと同じガバナンスの効いたプラットフォーム上で実行できます。Snowpark Connect for Apache Spark™(一般提供)は、管理する外部クラスターなしで、既存のPySpark、Java、ScalaコードをSnowflake上で直接実行します。Next-Gen File Reader for Apache Spark(プライベートプレビュー)は、JSON、CSV、XML、Parquet上でSpark独自の読み取りセマンティクスを簡単に実行し、煩雑なブロンズレイヤーのファイルを処理できるようにします。
Snowpark Connectは、あらゆる操作のためにHorizon、AWS Glue、Unity CatalogのマネージドApache Iceberg™テーブルにアクセスするための完全な相互運用性をサポートし、Spark write-audit-publishを使用して本番環境の前にデータ品質チェックを有効にすることでエージェントを展開します。これは、分離されたブランチを作成することで機能し、不良データが本番環境に到達するのを防ぐのに役立ちます。ブランチは、Snowflakeや任意のエンジンから他のテーブルと同様にクエリを実行して、ダウンストリームへの影響を確認できます。その後、公開または破棄を行うことで、データが本番環境に移行する前に品質チェックを簡単に実装できるようになります。
Incremental reads(一般提供)により、Sparkジョブがより効率的になります。フルキャンではなく、Icebergスナップショット間の変更のみを処理します。IcebergのTime Travelとタグ (一般提供)により、安全なロールバックと安定した共有可能なチェックポイントが可能になり、チームはSparkやその他のワークロードで簡単に作業できるようになります。Snowpark Connectはまた、Spark 4.0(プライベートプレビュー)でIcebergサポートをIceberg v3に拡張し、半構造化データ用のVARIANTデータ型や、変更データキャプチャ(CDC)、監査、コンプライアンスワークフローを簡素化する行リネージなどの主要機能を追加しました。
Spark Monitoring UI(パブリックプレビュー)は、セッションやバッチジョブ全体で、個々のクエリプロファイルに至るまで統合されたデバッグを提供します。Code Bundles for Apache Spark(パブリックプレビュー)を使用すると、REST APIまたはSQLを介してSparkジョブを送信できるため、AirflowからSnowflakeタスクまで、すでに実行しているスケジューラに適合させることができます。そして始めるにあたり、Snowflake CoCoのSpark移行スキル (一般提供)は、既存のPySpark、Spark Scala、Spark JavaのNotebookとジョブをSnowflake上で実行できるように変換します。
宣言型SQLパイプラインの場合、ダイナミックテーブルのカスタム増分化(一般提供)により、増分ロジックを完全に制御し、必要なときにスケジュールを設定できます。dbtのダイナミックテーブル (一般提供)は、増分化ロジックをdbtフレームワークにネイティブに導入するため、dbtチームはツールチェーンから離れることなくダイナミックテーブルのパフォーマンスを得ることができます。お客様はDynamic Icebergテーブルを使用して、カスタムパイプラインなしで臨床データセットなどのオープンフォーマットのデータ製品を最新の状態に保つこともできます。現在プライベートプレビューでは、Snowflakeが独自の外部Icebergカタログに直接リフレッシュできるようになりました。
ソフトウェアライフサイクルの定義
モダンインフラストラクチャは始まりにすぎず、命令型コードは依然としてテスト、デバッグ、信頼が困難です。宣言型でバージョン管理されたワークフローに移行することでリソースが解放され、新しいデータ製品を構築する時間が生まれます。
dbt Projects(一般提供)は、dbtフレームワークをSnowflakeにネイティブに導入し、インフラストラクチャや外部オーケストレーターを管理することなく、dbtモデルのテストとドキュメント化を可能にします。Slim CI and defer to production(一般提供)を使用すると、dbtプロジェクトのオブジェクトアーティファクトを再利用して変更されたモデルのみを実行でき、検証を数分から数秒に短縮し、すべてのプルリクエストをチェックすることが実用的になります。
DCMプロジェクト(一般提供)を使用すると、チームはSnowflakeインフラストラクチャ、データパイプライン、ガバナンス構成を宣言的に管理でき、すべての変更が本番環境に到達する前に検証する監査可能なCI/CD自動化を利用できます。DCM Test Branches(プライベートプレビュー)はこれをさらに拡張し、展開前に本番データまたは合成データを使用した自動化された単体テストと統合テストを可能にします。
データネイティブなハーネスの追加
モダンインフラストラクチャと定義されたライフサイクルが整ったら、次のステップは、データドリブンなワークフローをエージェント的に強化するハーネスです。これは、繰り返されるセットアップ、チューニング、トラブルシューティングのタスクを処理します。
ダイナミックテーブルインサイト(一般提供)は、Snowflake CoCoがユーザーに代わって実装できる具体的な最適化の推奨事項を提示します。システムは自己診断を行い、修正すべき箇所を通知し、CoCoでの実装手順を案内します。
CoCoによる自動化されたSnowpipeセットアップ(一般提供)は、S3パスから継続的なファイル取り込みパイプラインを構築します。ステージ、パイプ、ファイル形式、エラー処理がすべて構成され、実行されます。
Pipeline Builder(パブリックプレビュー)は、Notebook、MLジョブ、タスク、SQLオブジェクトをオーケストレーションするためのビジュアルキャンバスを提供します。これはCoCoとの対話によって構築され、接続をドラッグすることで編集できます。Task Graph Object(パブリックプレビュー)は、タスクを完全なオーケストレーターにします。グラフを一時停止せずに変更し、条件付きで分岐します。
データエンジニアリングタスク専用に構築されたデータネイティブなハーネスを使用することで、エンジニアはトークン効率を高め、より高品質な出力を生成し、最終的にパイプラインの接続やチューニングに費やす時間を削減できます。プラットフォームはまた、最終ステップである「発見したことに基づいて行動する」ために必要なコンテキストを獲得します。
エージェントに反復作業を任せる
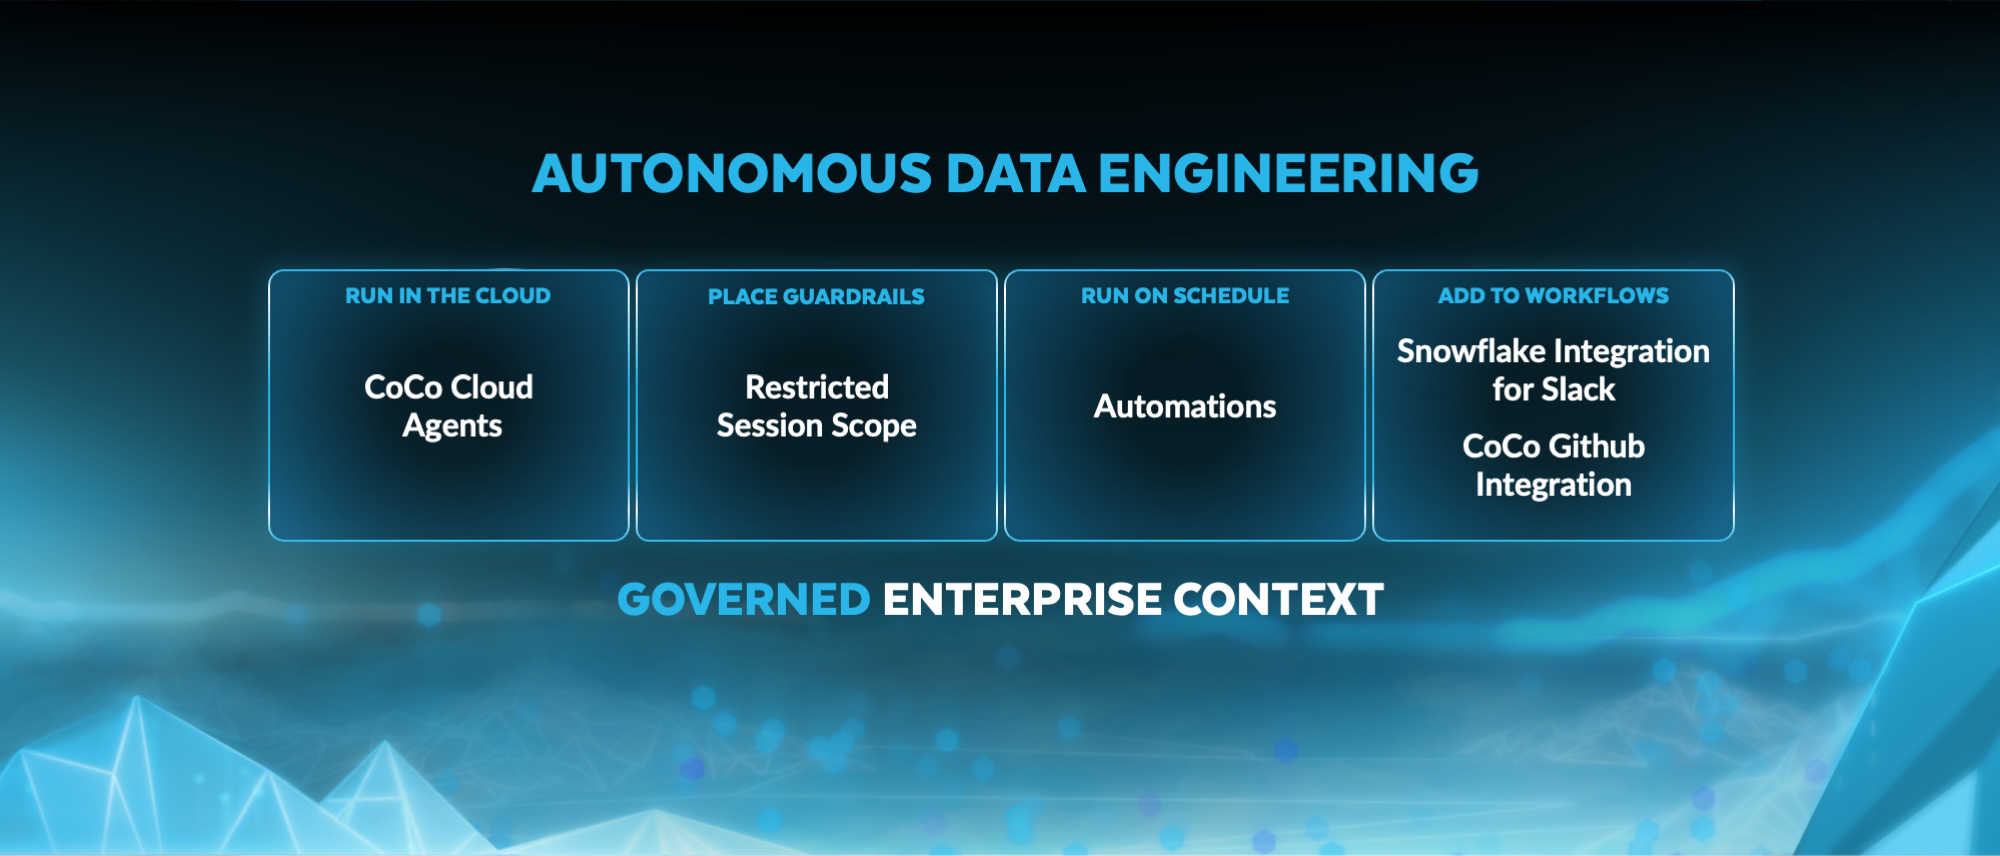
これらすべてが、日常的な作業を自ら引き受けることができるエージェントに結実します。Cloud Agents(一般提供)を使用すると、CoCoはエンジニアのラップトップで実行する代わりに、Snowflakeが管理する分離された環境を立ち上げます。各セッションは独自のセキュアなコンテナを取得し、共有のSnowflakeワークスペース内のファイルで作業します。データエンジニアは、Restricted Session Scope(一般提供)を使用して、その機能をさらに制限または限定できます。作業はクラウドで行われるため、エンジニアがログオフした後も継続でき、長時間実行されるタスクやチーム間のコラボレーションをサポートします。
Coding Agents(一般提供)は、Cortex Agents REST APIまたはSQLを通じて、独自のアプリケーションにコーディング機能を追加します。CoCo自動化(SnowsightインターフェイスとCLIで一般提供、CoCo Desktopでパブリックプレビュー)により、データチームはこれらのエージェントを自律的に実行できます。データエンジニアは、パイプラインの健全性の確認や失敗したジョブの調査など、繰り返されるタスクを平易な言葉で記述でき、タスクはプロアクティブに実行されます。チームは構築したCoCoスキルを共有できるため、ワークフローを簡単に再利用できます。CoCoはSnowflake内で実行されるため、組織のリネージ、カタログ、ガバナンスポリシーと連携し、汎用のコーディングアシスタントにはないコンテキストを提供します。
Snowflake for Slack (まもなくパブリックプレビュー)は、チームがすでに作業しているチャネルにCoCoを導入するため、スレッドから離れることなく質問したり、ワークフローを開始したり、結果をレビューしたりできます。また、CoCo GitHub統合(パブリックプレビュー)により、提案されたコード変更は引き続きチームの既存のレビュープロセスを経ることになります。
各基盤レイヤーは前のレイヤーの上に構築されます。インフラストラクチャを抽象化し、ライフサイクルを体系化し、データネイティブなハーネスを追加し、エージェントに明確に定義された作業を与えて自動化します。次の疑問は、これらのパイプラインが、それに依存するエージェントやアプリと同じくらい速く、リアルタイムでデータを提供できるかどうかです。
1つの環境でのエンドツーエンドのリアルタイム分析
自己管理型パイプラインは確かに成果ですが、それが最終目標ではありません。エージェントに古い情報を渡すのであれば、その有用性は低くなります。しかし、より新しいデータを取得することは、通常、それを必要とする各ワークロードのために新しいインフラストラクチャを追加して運用することを意味していました。
現在、Snowflakeは接続性、変換、サービングを通じたエンドツーエンドのリアルタイム分析を1つの環境に統合しているため、チームは接続された、費用対効果が高く、ガバナンスの効いたアプローチを通じてこれらのユースケースを構築できます。
大量の取り込みから始まり、Snowpipe Streamingを使用すると、予測可能な価格設定により、テーブルあたり最大20GB/秒、5秒のレイテンシーとスループットで、継続的なデータパイプラインをSnowflakeに直接ストリーミングできます。Elastic Channels(一般提供)を使用すると、何千ものプロデューサーが1つの取り込みパスを共有でき、Snowflakeがスケーリングを処理するため、トラフィックの増加に伴ってチャネルを調整する必要がありません。Datastream(まもなくパブリックプレビュー)は、データエンジニアがすでに知っていて愛用しているApache Kafkaプロトコルを、Snowflakeのセキュリティおよびガバナンスの境界内に導入します。データが到着すると、Streaming Transformations(プライベートプレビュー)により、チームは標準SQLを使用して移動中のデータを変換できるため、ダウンストリームのデータは最新の状態に保たれ、数秒でアプリの準備が整います。
ダッシュボード、顧客向けアプリ、AIエージェントは多くの場合、同じデータに同時にアクセスしますが、そこで多くのリアルタイムプロジェクトが行き詰まります。チームは追いつくためにデータを別のサービングデータベースにコピーすることになり、インフラストラクチャコストと運用オーバーヘッドの増加を意味します。Interactive Analytics(一般提供)は、エンジニアがすでに維持しているのと同じガバナンスの効いたテーブル上で、高い同時実行性で1秒未満のクエリを使用して、そのトラフィックをSnowflakeで直接処理します。同期するための2番目のコピーも、セキュアにするための追加のシステムも、実行し続けるための個別のパイプラインもありません。チームは、2番目のシステムに料金を支払うことなく、必要なパフォーマンスを得ることができます。
各ソースの接続方法の選択
すべてのワークロードが同じ鮮度を要求するわけではないのと同様に、データチームはすべてのソースに同じパターンを使用する必要はありません。一部のデータはSnowflakeに取り込まれ、変換される必要があります。他のデータは記録システムに残したまま、そこでクエリを実行できます。各ソースの接続方法を選択することは、管理するコピーと維持するパイプラインを減らすことを意味します。
Snowflakeに取り込む必要があるデータの場合、Snowflake Openflowは幅広いソースに接続し、エンタープライズ規模での取り込みをサポートするように設計されています。Data Connectivity Proxy(一般提供)を通じたオンプレミス接続が必要な場合でも、追加のクラウド環境のサポートが必要な場合でも、Openflowは、オブザーバビリティとAI支援のトラブルシューティング機能を備えたパフォーマンス、エンタープライズリーチ、運用制御を提供できます。ランタイムのスケジューリングと自動一時停止により、チームは統合ワークロードの実行タイミングをより詳細に制御できるようになります。
チームはまた、ストレージ環境にすでにあるファイルを操作する方法も必要としています。Zero-Copy Parquetは、ソースデータを書き換えることなく、既存のParquetファイルをIcebergとして利用できるようにします。Parquet Directは、Parquetファイルをその場でクエリするための個別の読み取り専用パスです。
信頼できる記録システムにすでにあるデータについては、SAP Businessデータクラウド、Workdayデータクラウド、およびSalesforceのゼロコピー統合が一般提供されるようになりました。ゼロコピー統合は、ソースシステム内のデータへのアクセスを提供するように設計されており、アナリティクスやAIのための抽出パイプラインを構築する必要性を減らします。SAPの顧客は、プライベート接続の要件を満たしながら、ビジネスクリティカルなデータをアナリティクスやAIに活用できます。SAP BusinessデータクラウドとSnowflake間の単方向AWS PrivateLink接続(まもなく一般提供)は、顧客がビジネス成果のために、信頼できるSAPビジネスコンテキストをエンタープライズデータ全体に拡張するのに役立ちます。
これらのパターンは、1つのデータアーキテクチャ内で共存できます。たとえば、エンジニアはOpenflowを通じてオペレーショナルイベントを取り込み、ゼロコピー統合を通じてパートナーデータにその場でアクセスし、Sparkを使用してIceberg上のファイルを処理できます。したがって、各ソースについて下す必要がある決定は、そのデータを移動する必要があるかどうか、どのように使用されるか、およびどの制御を適用すべきかです。これらの疑問は、ビジネスが実際に実行されるトランザクションシステムにとって最も重要です。
アプリとエージェントでのオペレーショナルデータの活用
アプリやエージェントがビジネスを完全に理解し、正確な意思決定を行うためには、最新のオペレーショナルコンテキストを持つことが不可欠です。しかし、ほとんどの組織は依然としてトランザクションをあるシステムで、アナリティクスを別のシステムで実行しており、それらの間でETLパイプラインがデータを移動させています。これらのパイプラインは、レイテンシー、コスト、そしてエンジニアが維持すべきもう1つの作業を追加します。
これに対処するため、世界で最も人気のあるデータベースをSnowflakeに導入するSnowflake Postgresを発表しました。オープンソースのpg_lakeにより、脆弱なサードパーティのETLを、データエステートを接続するためのよりシンプルで効率的な方法に置き換えることができました。現在、トランザクションデータをインサイトに、そしてインサイトをアクションに変えるフルマネージドソリューションとしてデータミラーリングを導入することで、そのシンプルさをさらに推し進めています。
1つのコマンドまたは数回のクリックで、簡単にセットアップできます。Postgresデータミラーリング(一般提供)は、アナリティクスとAIのために、PostgresテーブルをSnowflakeの他の部分に継続的に複製します。Snowflakeデータミラーリング(まもなくパブリックプレビュー)は、データを逆方向に送信します。強化された顧客プロファイルとアナリティクスの結果はPostgresにフィードバックされ、そこでよりスマートなエージェントとよりパーソナライズされたエクスペリエンスを強化します。
StreamlitまたはSnowflakeアプリランタイムで構築された社内エンタープライズアプリは、すでにSnowflake上で実行され、Snowflakeデータから読み取りを行っています。これらのアプリが高速なトランザクションの読み取りと書き込みも必要とする場合、ハイブリッドテーブルはオーバーヘッドを劇的に削減します。現在、ハイブリッドテーブルは最大8倍高いスループットを提供します。つまり、特定のワークロードでは、以前は8つのXSウェアハウスを必要としていたものが1つで済むようになり、コストを80%以上削減できます。1Snowflakeはレイテンシーも大幅に改善しており、ポイント操作を伴うオペレーショナルワークロードにおいて、P50レイテンシーは3倍低く、P99レイテンシーは約2倍低くなっています。2すでにハイブリッドテーブルを使用している何千ものお客様にとって、既存のアプリは再設計することなく、より高速かつ安価になります。
ハイブリッドテーブルとSnowflake Postgresは補完的です。別のデータベースなしで、他のSnowflake機能との深い統合が必要な場合、ハイブリッドテーブルは自然な選択です。チームがPostgresエコシステムまたは可能な限り低いレイテンシーを必要とする場合、Snowflake Postgresが最適です。
作業に合わせて変化できる基盤の構築
よくある質問
Q:AIエージェントはデータエンジニアリングの作業にどのように役立つのでしょうか。
A:パイプラインが宣言型になりバージョン管理されると、AIエージェントは、パイプラインの健全性の確認、障害原因の追跡、レビューのための修正案の提示など、繰り返されるオペレーショナルタスクを引き受けることができます。Snowflake CoCo自動化は、Snowflake内でスケジュールに従ってこれらのエージェントを実行し、そこでエージェントはリネージ、カタログ、ガバナンスポリシーと連携します。提案されたコード変更は、CoCo GitHub統合を介して、引き続きチームの既存のレビュープロセスを経ることになります。
Q:リアルタイム分析とは何であり、バッチアナリティクスとはどのように異なるのでしょうか。
A:リアルタイム分析は、スケジュールされたバッチジョブの実行を待つのではなく、データが到着してから数秒以内にデータを処理して提供します。これは、エージェント、ダッシュボード、または顧客向けアプリが意思決定を行うために最新の情報を必要とする場合に重要です。Snowflakeは、Snowpipe Streamingによるストリーミング取り込み(最大20GB/秒で5秒のレイテンシー)から、変換、Interactive Analyticsによる1秒未満のサービングまで、エンドツーエンドのリアルタイム分析を1つのプラットフォームで提供します。これらはすべて、チームがすでに維持しているのと同じガバナンスの効いたテーブル上で行われます。
Q:ダイナミックテーブルはデータパイプラインをどのように簡素化するのでしょうか。
A:ダイナミックテーブルを使用すると、チームは変換をクエリとして宣言的に定義でき、Snowflakeがスケジューリング、増分化、依存関係の順序付けを自動的に処理します。命令型のETLコードを記述して維持する代わりに、必要な結果を記述するだけで、プラットフォームがそれを最新の状態に保ちます。dbtのダイナミックテーブルはこれをdbtフレームワークに直接導入し、カスタム増分化により必要なときに完全な制御が可能になります。
Q:Snowflakeは、トランザクションシステムと分析システム間のETLの置き換えにどのように役立つのでしょうか。
A:従来、組織はトランザクションをあるシステムで、アナリティクスを別のシステムで実行し、その間にETLパイプラインを配置していました。Snowflake Postgresデータミラーリングは、1つのコマンドでアナリティクスとAIのためにPostgresテーブルをSnowflakeに継続的に複製します。ハイブリッドテーブルは、Snowflake内での高速なトランザクションの読み取りと書き込みという逆のニーズを満たすため、StreamlitまたはSnowflakeアプリランタイムで構築された社内アプリは別のデータベースを必要としません。
Q:Apache Icebergなどのオープンテーブルフォーマットは、データエンジニアリングにおいてどのような役割を果たすのでしょうか。
A:オープンテーブルフォーマットにより、チームはデータを1つのガバナンスの効いた場所に保持しながら、コンピュートエンジンを選択できます。Snowflakeは、ブランチ機能、Time Travel、タグ付けを備えたApache Icebergをサポートしており、エンジニアにwrite-audit-publishワークフローを提供します。分離されたブランチで変更をステージングし、それらを検証して、公開または破棄します。これは、AIエージェントがパイプラインと同じテーブルの読み書きを開始するにつれて特に重要になります。すべての変更にはガバナンスの効いた監査証跡があります。
1パフォーマンス改善の前後で測定された、ハイブリッドテーブルワークロードの本番ベンチマークに基づくスループットとコストの比較。同等のスループットを得るために、以前は8つのXSウェアハウスが必要でしたが、改善後は1つのXSウェアハウスで済みます。コスト削減は可能性であり、ワークロードに依存します。
2パフォーマンス改善の前後で測定された、本番ベンチマークに基づくレイテンシーの比較。結果はワークロードに依存します。