수년 동안 Snowflake에서 파이프라인 장애가 발생하면 대응 방식은 늘 같았습니다. 담당자가 호출을 받고, 로그를 뒤져 근본 원인을 추적하고, 수정 코드를 작성해 테스트한 뒤 풀 리퀘스트(PR)를 생성했습니다. 그리고 다음 날 밤에도 같은 과정을 반복했습니다.
하지만 이제는 에이전트가 이 과정을 대신 수행합니다. 이 에이전트는 모니터링 대상 파이프라인에서 발생하는 모든 장애를 조사하고, 인시던트 감지부터 검토 가능한 PR 생성까지 평균 16분이 채 걸리지 않습니다. 이 글에서는 이 에이전트를 어떻게 구축했고, 팀에 어떤 변화가 있었는지 공유합니다.
갈수록 커지던 문제
저는 Snowflake 내부 데이터 팀의 데이터 사이언티스트로, 혼자서도 충분히 파악할 수 있던 수준의 파이프라인 수가 감당하기 벅찰 정도로 늘어나는 과정을 지켜봤습니다.
파이프라인이 늘어난다는 것은 얼핏 반가운 고민처럼 들립니다. 데이터가 늘면 그만큼 가치도 커지기 때문입니다. 하지만 파이프라인이 하나 추갈될 때마다 장애가 발생할 지점도 하나씩 늘고, 종속성이 추가될 때마다 한밤중에 문제를 일으킬 요소도 늘어납니다. 장애 건수가 늘어난 것은 파이프라인의 품질이 나빠져서가 아니었습니다. 파이프라인 수는 늘어났지만, 팀의 규모는 그 속도를 따라가지 못했기 때문입니다.
우리가 만들고자 했던 에이전트
대부분의 도구는 "문제가 발생했습니다. 확인하세요."와 같은 알림을 보내는 데서 그칩니다. 하지만 우리는 문제를 설명하고 해결까지 도울 수 있는 에이전트를 원했습니다. 그러려면 에이전트가 다음의 전 과정을 책임져야 했습니다.
- 파이프라인을 지속적으로 스캔해 코드 스멜과 성능 문제를 찾아냅니다.
- 문제가 확대되기 전에 선제적으로 포착합니다.
- 로그와 코드베이스를 깊이 분석해 실제 근본 원인일 가능성이 높은 지점을 식별합니다.
- 프로덕션 환경에 반영되기 전에 수정안을 테스트합니다.
- 담당자가 빠르게 검토하고 병합할 수 있도록 전체 맥락을 담은 명확한 PR을 생성합니다.
이 중 마지막 요건이 가장 중요합니다. 에이전트는 수정안을 제안하고 실제로 무엇을 배포할지는 여전히 사람이 결정합니다.
구축 방식
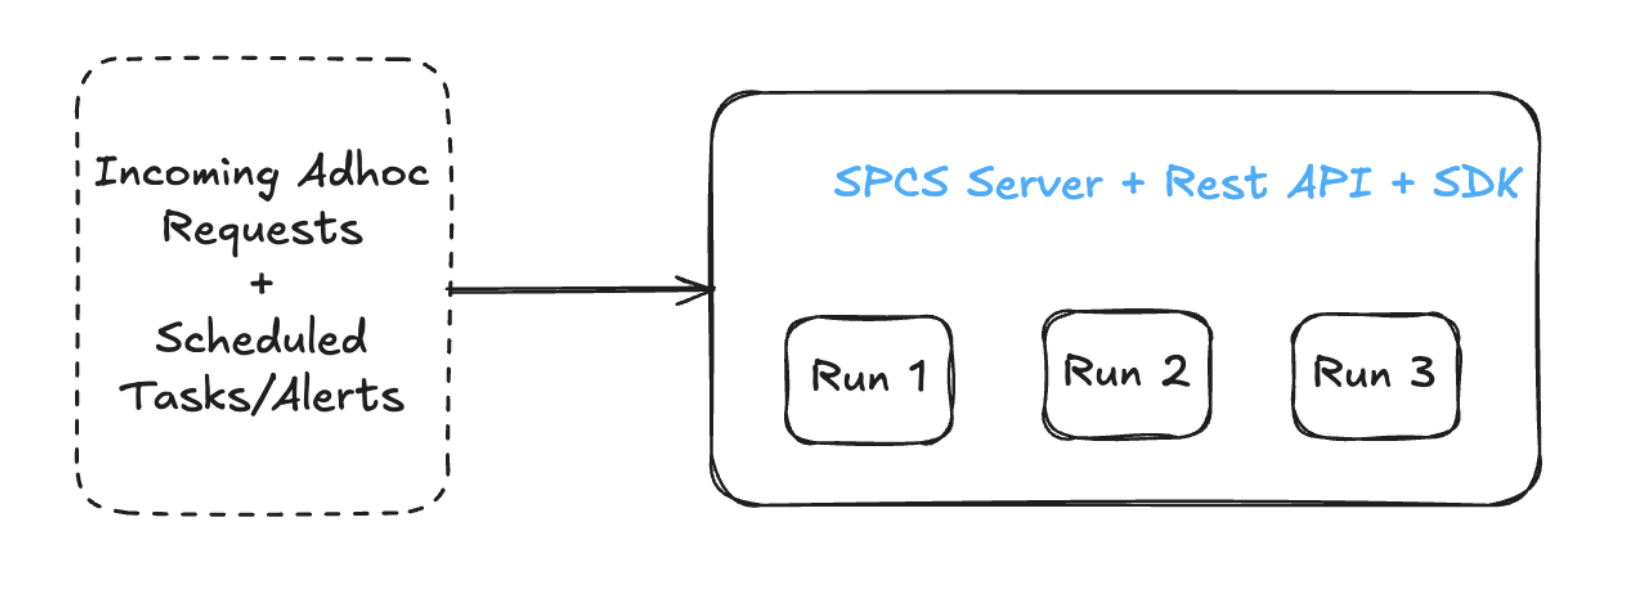
적합한 아키텍처에 도달하기까지 몇 가지 방식을 검토했습니다. 처음에는 REST API를 실행하는 Snowpark Container Services 서버를 떠올렸습니다. 모든 것을 한곳에 모은 독립적인 구조였습니다. 하지만 이 방식은 단일 서버가 처리할 수 있는 실행 횟수에 제약을 받습니다.
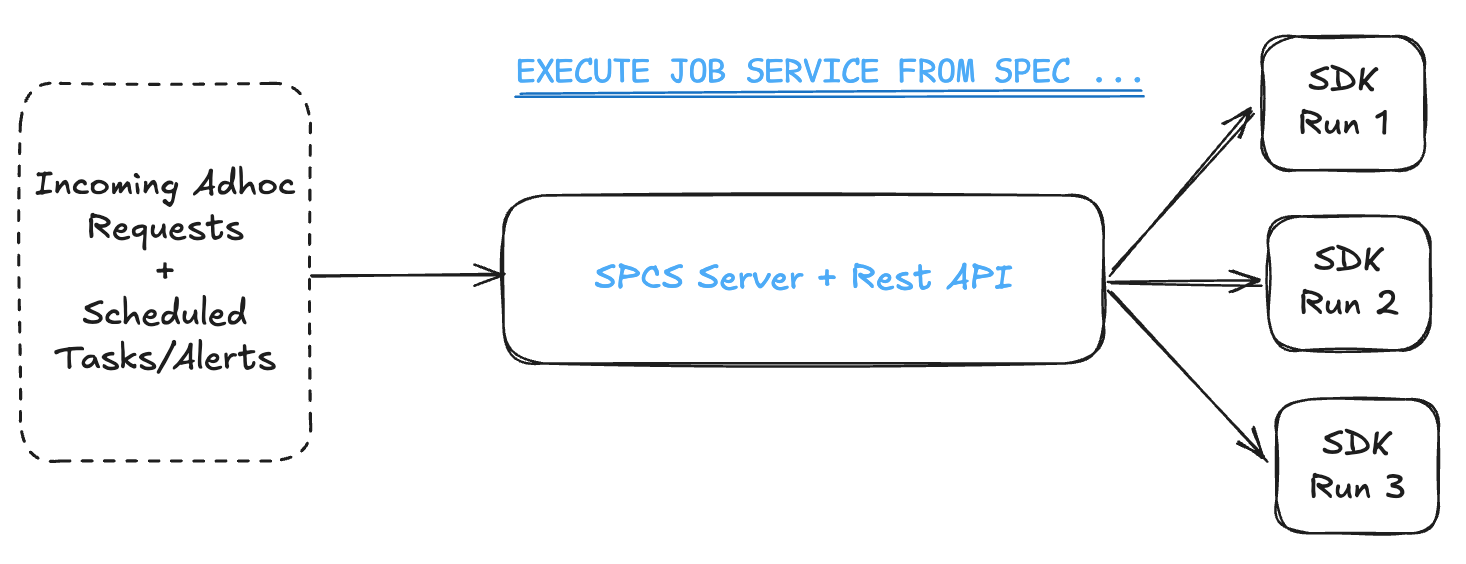
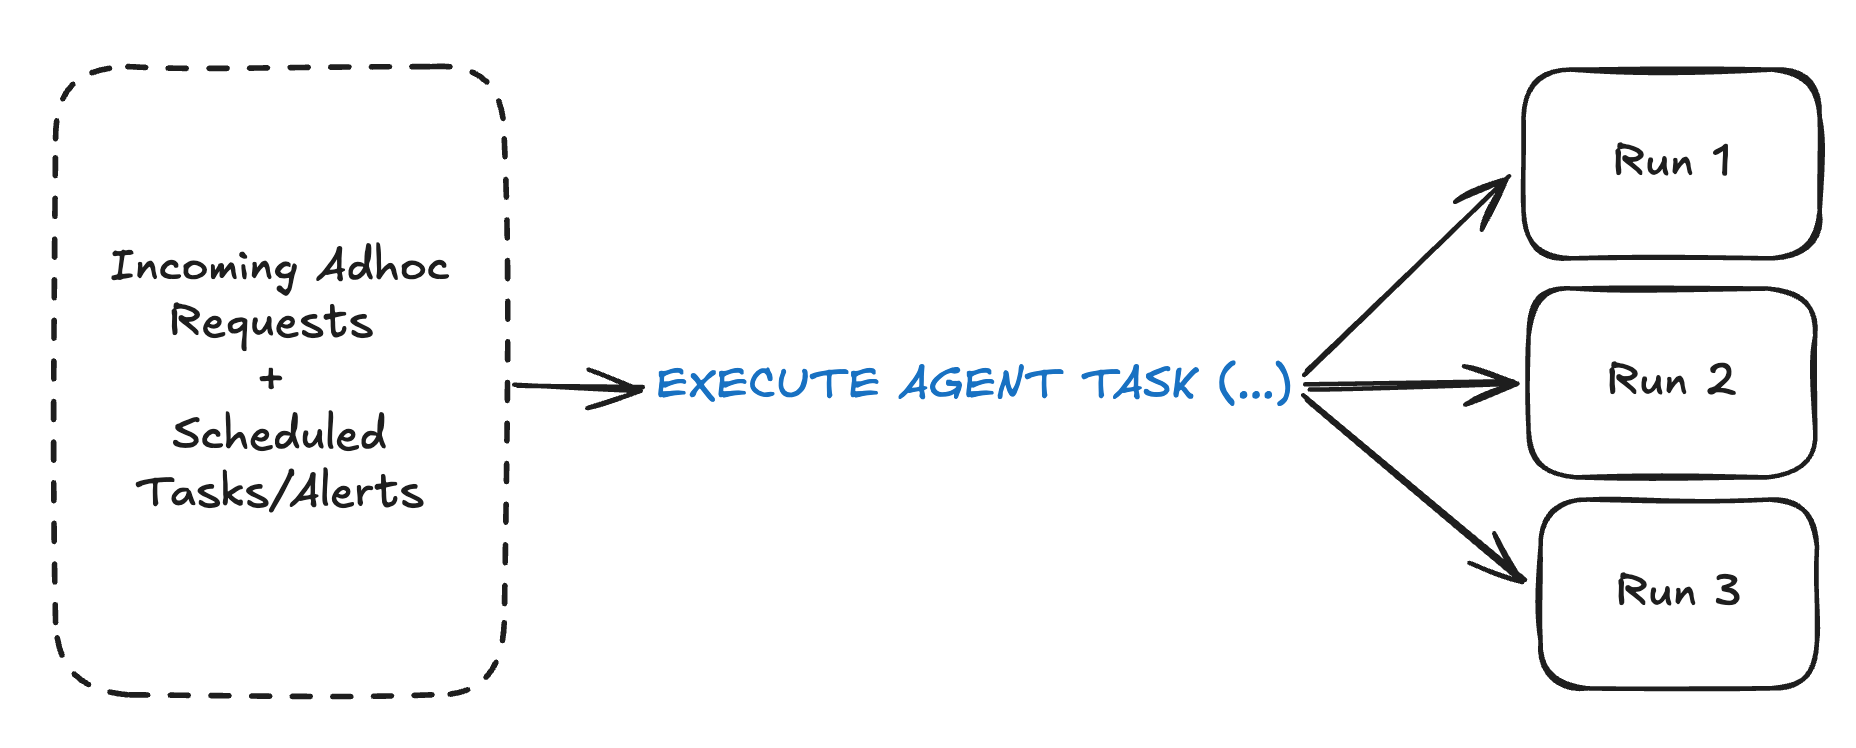
이 접근 방식 덕분에 단일 서버가 병목이 되지 않고 여러 에이전트를 병렬로 실행하도록 확장할 수 있었습니다.
향후에는 여기서 더 나아가 CoCo 자동화의 새로운 EXECUTE AGENT TASK(현재 공개 프리뷰)를 활용해 실행을 더욱 간소화하고 확장할 계획입니다.
관리할 서버도, 공유 컴퓨팅 풀도 없습니다. SQL 호출 한 번이면 에이전트 실행이 트리거되고, 나머지는 Snowflake가 처리합니다.
템플릿화된 지침으로 워크플로우를 정의할 수 있는 유연한 방식도 필요했습니다. 그래서 워크플로우는 JSON으로 정의합니다. 지침 파일, 에이전트가 액세스할 수 있는 리포지토리, 턴 예산, 실행할 모델, 작업 완료 시 알림을 보낼 위치를 지정합니다.
{
  "name": "fix-broken-pipeline",
  "owner": "your.name@snowflake.com",
  "agent": {
    "turns": [{"file": "org/repo:path/to/instructions.md"}],
    "model": "opus",
    "max_turns": 50
  },
  "repos": [{"repo": "org/repo", "branch": "main"}],
  "timeout_minutes": 30,
  "notifications": {
    "slack_channel": "#data-eng-alerts",
    "emails": ["your.name@snowflake.com"]
  }
}
실행은 SQL이면 충분합니다.
CALL RUN_WORKFLOW('fix-broken-pipeline', '{"pipeline_id": "12345"}')

CREATE TASK SCHEDULE = '12 hours' AS
  CALL RUN_WORKFLOW('code-smells')
태스크는 일정을 관리하고, 에이전트는 작업을 수행합니다. 이러한 워크플로우는 매우 단순할 수도 있고, 여러 단순한 워크플로우와 사람의 피드백을 결합해 더 복잡한 워크플로우로 확장할 수도 있습니다.
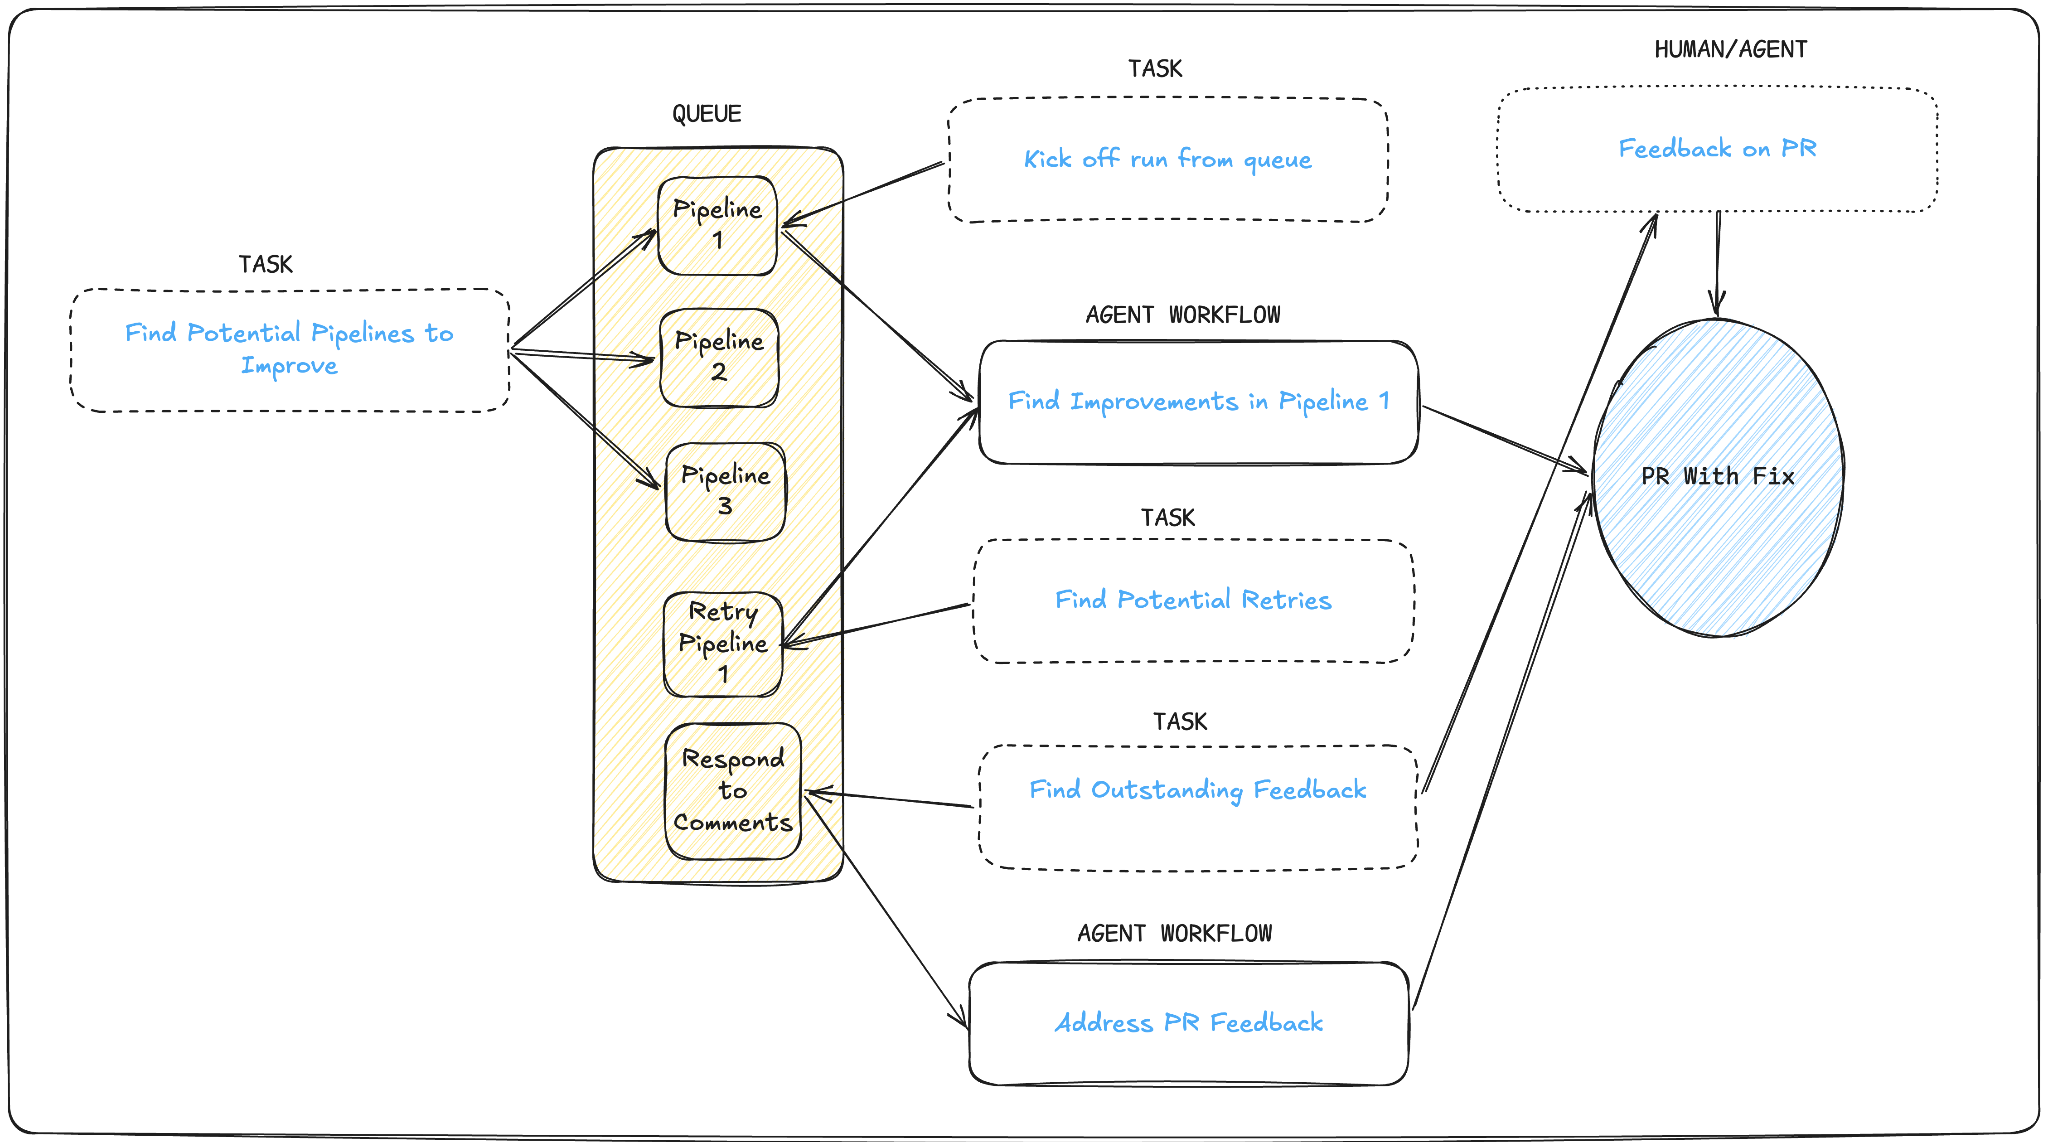
효과: 장애 전반에 대한 포괄적인 조사
이 시스템을 프로덕션 환경에서 운영하면서, 지난 5개월 동안 팀이 관리하는 파이프라인 전반에서 다음과 같은 성과를 확인했습니다.
- 모니터링 대상 파이프라인에서 발생한 거의 모든 장애에 대해 거의 완전한 수준의 트리아지 범위를 확보했습니다. 눈에 잘 띄는 장애만이 아니라 모든 장애를 조사하도록 설계했습니다.
- 인시던트 감지부터 PR 생성까지 16분 이내에 완료했습니다.
- 수백 건의 PR이 병합되었습니다.
- 500개 이상의 파이프라인이 개선되었습니다.
- 파이프라인 개선을 통해 매일 낭비되던 수백 크레딧을 절감했습니다.
마지막 수치는 특히 중요합니다. 성능이 저조한 파이프라인에서 발생하는 컴퓨팅 낭비는 보이지 않는 곳에서 계속 누적됩니다. 누군가가 나서서 들여다봐야만 이를 발견할 수 있기 때문에 대부분의 팀은 이 문제를 표면화하지 못하지만, 저희 에이전트는 끊임없이 점검합니다.
자율 데이터 엔지니어링
이번 작업은 제품 팀이 앞으로 고객에게 선보일 기능에 직접적인 영감을 주었습니다. 자율 데이터 엔지니어링에 대한 Snowflake의 비전은 여기에서 자세히 확인할 수 있습니다.
미래 전망 진술
이 페이지에는 당사의 향후 제품 제공에 대한 미래 전망 진술이 포함되어 있으며, 이는 제품 제공에 대한 보장이 아닙니다. 실제 결과 및 제공 사항은 알려진 및 알려지지 않은 위험과 불확실성에 따라 달라질 수 있습니다. 자세한 내용은 최신 10-Q를 참조하세요.
