3 novembre 2026/Lettura: 17 minProdotto e tecnologia
Data engineering autonomo: dati per agenti AI e app

La maggior parte delle aziende oggi si sta impegnando a fondo per decidere quali agenti AI e app sviluppare. Se la loro strategia dati riuscirà a tenere il passo, però, è tutta un’altra questione. Un agente AI che fornisce risposte basate su numeri obsoleti, o un’app che non riesce a vedere un ordine effettuato da un cliente cinque minuti prima, perde rapidamente credibilità. Oggi sappiamo che scalare l’AI dipende fortemente dalle pipeline, dalle tabelle e dai sistemi transazionali che la alimentano.
Ottenere questi dati in modo corretto richiede due passaggi: creare una data foundation di cui i team possano fidarsi (pipeline dichiarative, versionate e testate, insieme a dati transazionali e analitici unificati sulla stessa piattaforma) e lasciare che l’AI si occupi di una parte maggiore del lavoro di routine.
A Expedition, Snowflake annuncia funzionalità che aiutano a fare entrambe le cose. Vanno dall’analisi dei dati in tempo reale e i dati open lakehouse, all’accesso enterprise e ai sistemi transazionali, ma tutto parte dal modo in cui le pipeline vengono costruite e mantenute in funzione.
Basi per un data engineering autonomo
L’AI può aiutare a produrre una trasformazione o suggerire una correzione, ma i team di engineering devono comunque sapere cosa deve fare un workflow, cosa dipende da esso e se una modifica è sicura da rilasciare. Comprendere questi elementi determina se l’assistenza dell’AI riduce effettivamente il lavoro o si limita a creare altre modifiche da revisionare. Per arrivarci, le organizzazioni devono costruire le seguenti basi.
Adottare un’infrastruttura moderna
Il primo passo è astrarre le decisioni legate all’hardware. Adaptive Compute (in GA) dimensiona automaticamente la capacità di calcolo, adattando le risorse a ogni workload senza interventi manuali di tuning su warehouse o cluster. Descrivi il lavoro e Snowflake ottimizza il modo di eseguirlo.
Anche i workload Spark vengono eseguiti su Adaptive Compute, riducendo lo sforzo richiesto per questo tipo di workload. Anche iniziare è semplice. Porta il codice e le competenze esistenti su Snowflake ed eseguili sulla stessa piattaforma governata del resto delle pipeline. Snowpark Connect for Apache Spark™ (in GA) esegue direttamente su Snowflake il codice PySpark, Java e Scala esistente, senza cluster esterni da gestire. Il Next-Gen File Reader for Apache Spark (private preview) applica senza difficoltà la semantica di lettura nativa di Spark su file JSON, CSV, XML e Parquet, consentendo di lavorare con file bronze layer disordinati.
Snowpark Connect offre piena interoperabilità per accedere alle tabelle Apache Iceberg™ gestite da Horizon, AWS Glue e Unity Catalog per qualsiasi operazione, e consente di distribuire agenti AI attivando un controllo di qualità dei dati prima della produzione con Spark write-audit-publish. Funziona creando un branch isolato per contribuire a impedire che dati errati raggiungano la produzione. I branch possono essere interrogati come qualsiasi altra tabella da Snowflake o da qualsiasi motore, per verificare l’impatto a valle. Poi pubblichi o scarti, rendendo più semplice implementare un controllo di qualità prima che i dati passino in produzione.
Incremental reads (in GA) rendono i job Spark più efficienti. Elabora solo le modifiche tra gli snapshot Iceberg, invece di eseguire una scansione completa. Time Travel e tag per Iceberg (in GA) consentono rollback sicuri e checkpoint stabili e condivisibili, che i team possono utilizzare facilmente con Spark o altri workload. Snowpark Connect ha inoltre esteso il supporto a Iceberg v3 con Spark 4.0 (private preview), aggiungendo funzionalità chiave come il tipo di dati VARIANT per i dati semi‑strutturati e la row lineage, per semplificare i workflow di change data capture (CDC), auditing e conformità.
Spark Monitoring UI (public preview) offre un debug unificato tra sessioni e job batch, fino ai singoli profili di query. Code Bundles for Apache Spark (public preview) consentono di inviare job Spark tramite un’API REST o SQL, così da integrarsi con gli scheduler già in uso, da Airflow ai task Snowflake. E per iniziare, la Spark migration skill on Snowflake CoCo (in GA) converte i notebook e i job PySpark, Spark Scala e Spark Java esistenti per l’esecuzione su Snowflake.
Per le pipeline SQL dichiarative, custom incrementalization nelle Dynamic Tables (in GA) offre pieno controllo sulla logica incrementale e consente di pianificarla quando necessario. Dynamic Tables in dbt (in GA) portano la logica di incrementalizzazione nativamente nel framework dbt, così i team dbt ottengono le prestazioni delle Dynamic Tables senza uscire dal proprio toolchain. I clienti possono inoltre utilizzare le Dynamic Iceberg Tables per mantenere aggiornati i data product in formato open, come i data set clinici, senza pipeline personalizzate, e ora, in private preview, Snowflake può aggiornarli direttamente nel tuo catalogo Iceberg esterno.
Definire il ciclo di vita del software
Un’infrastruttura moderna è un buon inizio, ma il codice imperativo resta difficile da testare, debuggare e di cui fidarsi. Passare a workflow dichiarativi e con controllo di versione libera risorse, offrendo il tempo per sviluppare nuovi data product.
dbt Projects (in GA) porta il framework dbt nativamente su Snowflake, consentendo di testare e documentare i modelli dbt senza gestire infrastruttura o un orchestratore esterno. Slim CI and defer to production (in GA) consente di riutilizzare gli artefatti degli oggetti del progetto dbt per eseguire solo i modelli modificati, riducendo la validazione da minuti a secondi e rendendo pratico controllare ogni pull request.
DCM Projects (in GA) consente ai team di gestire in modo dichiarativo l’infrastruttura Snowflake, le pipeline di dati e le configurazioni di governance, con automazioni CI/CD verificabili che validano tutte le modifiche prima che raggiungano la produzione. DCM Test Branches (private preview) estendono ulteriormente questa possibilità, abilitando test unitari e di integrazione automatizzati con dati di produzione o sintetici prima del deployment.
Aggiungere un harness data-native
Con un’infrastruttura moderna e un ciclo di vita definito già in atto, il passo successivo è un harness che alimenta in modo agentico i workflow basati sui dati, occupandosi di task ricorrenti di configurazione, tuning e troubleshooting.
Dynamic Tables Insights (in GA) mette in evidenza raccomandazioni specifiche di ottimizzazione che Snowflake CoCo può implementare per te. Il sistema si autodiagnostica, indica cosa correggere e ti guida attraverso i passaggi di implementazione in CoCo.
Automated Snowpipe setup by CoCo (in GA) crea una pipeline di ingestion continua dei file a partire da un percorso S3: stage, pipe, formato dei file e gestione degli errori, tutto configurato e in funzione.
Pipeline Builder (public preview) offre una canvas visiva per orchestrare notebook, job ML, task e oggetti SQL, costruita in modo conversazionale con CoCo e modificabile trascinando le connessioni. Il Task Graph Object (public preview) trasforma i task in un orchestratore completo: modifica i grafi senza sospenderli ed esegui branch condizionali.
Con un harness data-native progettato appositamente per i task di data engineering, gli engineer utilizzano i token in modo più efficiente e producono output di qualità superiore, dedicando in definitiva meno tempo a collegare e ottimizzare le pipeline. La piattaforma acquisisce inoltre il contesto necessario per l’ultimo passaggio: agire in base a ciò che trova.
Affidare agli agenti AI le attività che si ripetono
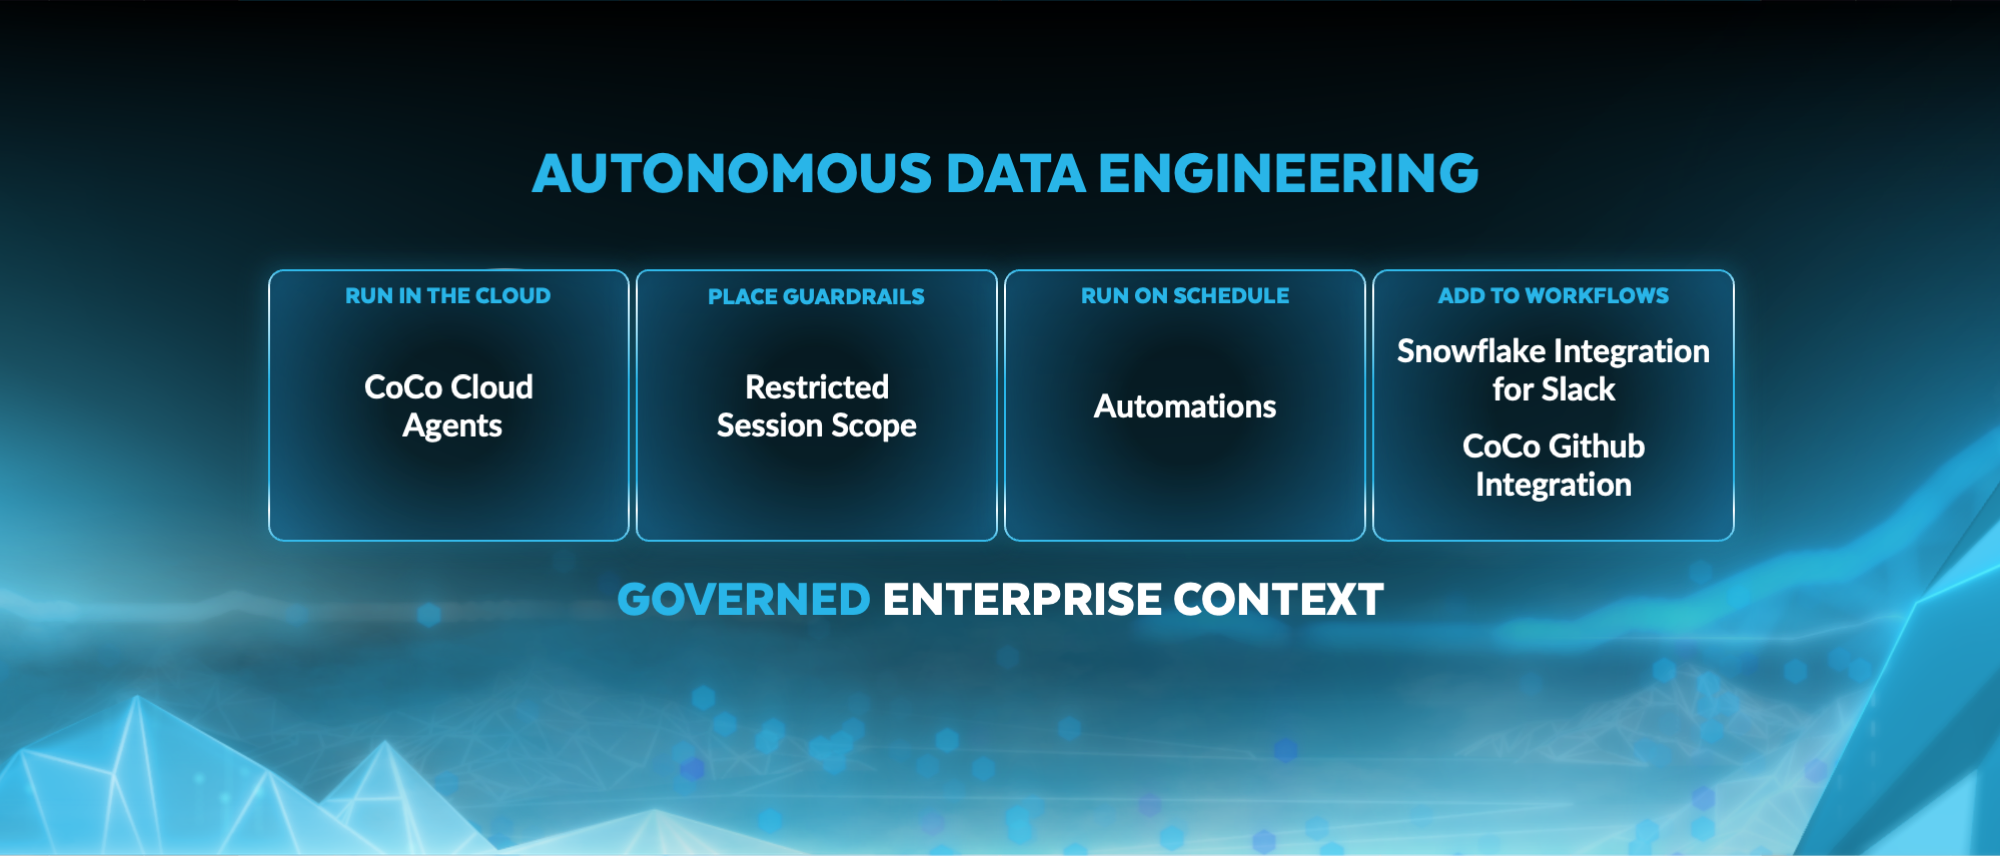
Tutto questo culmina in agenti AI in grado di occuparsi autonomamente delle attività più ripetitive. Con Cloud Agents (in GA), CoCo avvia un ambiente isolato gestito da Snowflake, invece di essere eseguito sul laptop dell’engineer. Ogni sessione ottiene un proprio container sicuro e lavora su file in un Snowflake Workspace condiviso, e un data engineer può limitare o restringere ulteriormente ciò che può fare con Restricted Session Scope (in GA). Poiché il lavoro avviene nel cloud, può continuare anche dopo che l’engineer si disconnette, supportando task di lunga durata e la collaborazione tra team.
Coding Agents (in GA) aggiungono capacità di coding alle tue app tramite l’API REST di Cortex Agents o SQL. CoCo automations (in GA nell’interfaccia Snowsight e nella CLI; in public preview in CoCo Desktop) permettono ai data team di eseguire questi agenti AI in modo autonomo. I data engineer possono descrivere un task ricorrente in linguaggio naturale, come controllare lo stato di salute di una pipeline o analizzare job falliti, e il task viene eseguito in modo proattivo. I team possono condividere le CoCo Skills che hanno sviluppato, così i workflow possono essere riutilizzati facilmente. Poiché CoCo viene eseguito all’interno di Snowflake, lavora con la lineage, il catalogo e le policy di governance dell’organizzazione, ottenendo un contesto che un assistente di coding generico non avrebbe.
Snowflake for Slack (public preview a breve) porta CoCo nei canali in cui i team già lavorano, così le persone possono fare domande, avviare un workflow o rivedere i risultati senza uscire dal thread. E CoCo GitHub integration (public preview) significa che le modifiche al codice proposte passano comunque attraverso il processo di revisione già in uso dal team.
Ogni livello fondamentale si basa sul precedente: astrarre l’infrastruttura, codificare il ciclo di vita, aggiungere un harness data-native e affidare agli agenti AI attività ben definite da automatizzare. La domanda successiva è se quelle pipeline siano in grado di fornire dati in tempo reale, con la stessa rapidità degli agenti AI e delle app che dipendono da esse.
Analisi dei dati in tempo reale end‑to‑end in un unico ambiente
Una pipeline autogestita è certamente un risultato, ma non è il traguardo finale. Se fornisce informazioni non aggiornate a un agente AI, diventa meno utile. Ma ottenere dati più aggiornati ha di solito significato aggiungere e gestire nuova infrastruttura per ogni workload che ne ha bisogno.
Ora Snowflake offre analisi dei dati in tempo reale end‑to‑end attraverso connettività, trasformazione e serving in un unico ambiente, così i team possono sviluppare questi use case con un approccio connesso, conveniente e governato.
Partendo dall’ingestion ad alto volume, Snowpipe Streaming consente di eseguire lo streaming di pipeline di dati continue direttamente in Snowflake, con fino a 20 GB/s per tabella, latenza di 5 secondi e throughput con pricing prevedibile. Con Elastic Channels (in GA), migliaia di producer possono condividere un unico percorso di ingestion, mentre Snowflake gestisce lo scaling, così non è necessario coordinare i canali con la crescita del traffico. Datastream (public preview a breve) porta il protocollo Apache Kafka, che i data engineer già conoscono e apprezzano, all’interno del perimetro di sicurezza e governance di Snowflake. Quando i dati arrivano, le Streaming Transformations (private preview) permettono ai team di trasformarli in movimento con SQL standard, così i dati a valle restano aggiornati e sono pronti per le app in pochi secondi.
Dashboard, app destinate ai clienti e agenti AI accedono spesso contemporaneamente ai medesimi dati, ed è qui che molti progetti in tempo reale si bloccano. I team finiscono per copiare i dati in un database di serving separato per riuscire a tenere il passo, il che comporta costi di infrastruttura più elevati e overhead operativo. Interactive Analytics (in GA) gestisce quel traffico direttamente in Snowflake, con query sub-secondo e alta concorrenza sulle stesse tabelle governate che gli engineer già mantengono. Non c’è una seconda copia da sincronizzare, nessun sistema extra da proteggere e nessuna pipeline separata da mantenere in funzione. I team ottengono le prestazioni di cui hanno bisogno senza pagare per un secondo sistema.
Scegliere come deve connettersi ogni fonte
Così come non tutti i workload hanno le stesse esigenze di aggiornamento dei dati, i data team non devono necessariamente usare lo stesso pattern per ogni fonte. Alcuni dati devono essere sottoposti a ingestion e trasformati in Snowflake. Altri dati possono rimanere nel proprio system of record ed essere interrogati lì. Scegliere come ogni fonte si connette significa meno copie da gestire e meno pipeline da mantenere.
Per i dati che devono essere portati in Snowflake, Snowflake Openflow è progettato per connettere un’ampia gamma di fonti e supportare l’ingestion su scala enterprise. Sia che tu abbia bisogno di connettività on-premise tramite Data Connectivity Proxy (in GA), sia di supporto per ambienti cloud aggiuntivi, Openflow può offrire prestazioni, copertura enterprise e controllo operativo, con funzionalità di osservabilità e troubleshooting assistito dall’AI. Lo scheduling a runtime e l’auto-suspend offrono inoltre ai team maggiore controllo su quando vengono eseguiti i workload di integrazione.
I team hanno anche bisogno di modi per lavorare con i file già presenti nel proprio ambiente di storage. Zero-Copy Parquet rende disponibili i file Parquet esistenti come Iceberg, senza riscrivere i dati di origine. Parquet Direct è un percorso separato di sola lettura, per eseguire query sui file Parquet restando al loro posto.
Per i dati già presenti nel system of record di cui ti fidi, le integrazioni zero-copy con SAP Business Data Cloud, Workday Data Cloud e Salesforce sono ora in GA. L’integrazione zero-copy è progettata per fornire accesso ai dati nel proprio sistema di origine, riducendo la necessità di sviluppare pipeline di estrazione per l’analisi dei dati o l’AI. I clienti SAP possono mettere al lavoro i dati business-critical per l’analisi dei dati e l’AI, soddisfacendo al contempo i requisiti di connettività privata. La connettività unidirezionale AWS PrivateLink tra SAP Business Data Cloud e Snowflake (in GA a breve) aiuta i clienti a estendere il contesto business SAP affidabile su tutti i dati enterprise, per ottenere risultati di business.
Questi pattern possono coesistere in un’unica architettura dati. Ad esempio, un engineer potrebbe importare eventi operativi tramite Openflow, accedere ai dati dei partner sul posto tramite un’integrazione zero-copy e utilizzare Spark per elaborare i file su Iceberg. Le decisioni da prendere per ciascuna fonte riguardano quindi se i suoi dati devono essere spostati, come verranno utilizzati e quali controlli applicare. Queste domande contano soprattutto per i sistemi transazionali su cui si basa realmente il business.
Mettere i dati operativi al lavoro in app e agenti AI
Perché app e agenti AI possano comprendere a fondo le aziende e prendere decisioni accurate, avere un contesto operativo aggiornato è fondamentale. La maggior parte delle organizzazioni, tuttavia, esegue ancora le transazioni in un sistema e l’analisi dei dati in un altro, con pipeline ETL che spostano i dati tra i due. Queste pipeline aggiungono latenza, costi e un altro processo che gli engineer devono gestire.
Per risolvere questo problema, abbiamo introdotto Snowflake Postgres, portando in Snowflake il database più popolare al mondo. Con pg_lake open source, ha contribuito a sostituire ETL di terze parti fragili con un modo più semplice ed efficiente di collegare il proprio patrimonio di dati. Ora stiamo portando questa semplicità ancora oltre introducendo il data mirroring, che trasforma i dati transazionali in insight (e gli insight in azioni) come soluzione completamente gestita.
È semplice da configurare, con un solo comando o pochi clic. Postgres data mirroring è in GA e replica continuamente le tue tabelle Postgres nel resto di Snowflake per l’analisi dei dati e l’AI. Snowflake data mirroring (disponibile a breve in public preview) invia i dati nella direzione opposta. Profili cliente arricchiti e risultati dell’analisi dei dati tornano in Postgres, dove alimentano agenti AI più intelligenti ed esperienze più personalizzate.
Le app aziendali interne create con Streamlit o Snowflake App Runtime vengono già eseguite su Snowflake e leggono i dati Snowflake. Quando queste app necessitano anche di letture e scritture transazionali rapide, le hybrid table riducono drasticamente i costi operativi generali. Ora le hybrid table offrono un throughput fino a 8 volte superiore, il che significa che per alcuni workload ciò che prima richiedeva otto warehouse XS ora ne richiede solo uno, il che può ridurre i costi di oltre l'80%.1 Snowflake ha inoltre apportato miglioramenti significativi alla latenza, con una latenza P50 3 volte inferiore e una latenza P99 circa 2 volte inferiore per i workload operativi che prevedono operazioni puntuali.2 Per le migliaia di clienti che già utilizzano le hybrid table, le app esistenti diventano più rapide ed economiche senza bisogno di essere riprogettate.
Le hybrid table e Snowflake Postgres sono complementari. Le hybrid table sono la scelta naturale quando si desidera un’integrazione approfondita con le altre funzionalità Snowflake, senza un database separato. Snowflake Postgres è la scelta giusta quando i team hanno bisogno dell’ecosistema Postgres o della latenza più bassa possibile.
Sviluppare una data foundation che si evolve insieme a quello che fai
Ogni agente AI, app e decisione della tua azienda dipende da dati aggiornati e affidabili. Ma per arrivarci servono pipeline testate e sistemi operativi ben collegati. Snowflake ora unisce questi elementi in modo che l’AI possa gestire il lavoro di routine lungo il percorso.
Questo libera i data engineer, che possono così concentrarsi sulla costruzione di ciò che viene dopo.
Scopri tutti gli annunci di Snowflake Expedition oppure partecipa all’evento virtuale.
FAQ
Domanda: In che modo gli agenti AI possono essere utili nel lavoro di data engineering?
Risposta: Una volta che le pipeline sono dichiarative e sottoposte a version control, gli agenti AI possono occuparsi di task operativi ricorrenti, come controllare lo stato delle pipeline, individuare le cause degli errori e proporre correzioni da sottoporre a revisione. Le automazioni di Snowflake CoCo eseguono questi agenti AI secondo una pianificazione all’interno di Snowflake, dove operano con lineage, catalogo e policy di governance. Le modifiche al codice proposte passano comunque attraverso il processo di revisione già in uso dal team, tramite l’integrazione CoCo GitHub.
Domanda: Cos’è l’analisi dei dati in tempo reale e in cosa si differenzia dall’analisi dei dati batch?
Risposta: L’analisi dei dati in tempo reale elabora e fornisce i dati entro pochi secondi dal loro arrivo, invece di attendere l’esecuzione di un processo batch pianificato. Questo è importante quando agenti AI, dashboard o app rivolte ai clienti hanno bisogno di informazioni aggiornate per prendere decisioni. Snowflake offre un’analisi dei dati in tempo reale end‑to‑end in un’unica piattaforma: dall’ingestion in streaming con Snowpipe Streaming (latenza di 5 secondi fino a 20 GB/s), passando per la trasformazione, fino al serving in meno di un secondo con Interactive Analytics, tutto sulle stesse tabelle governate che i team già gestiscono.
Domanda: In che modo le Dynamic Table semplificano le pipeline di dati?
Risposta: Le Dynamic Table permettono ai team di definire una trasformazione in modo dichiarativo (come una query), mentre Snowflake gestisce automaticamente la pianificazione, l’incrementalizzazione e l’ordine delle dipendenze. Invece di scrivere e gestire codice ETL imperativo, è sufficiente descrivere il risultato desiderato e la piattaforma lo mantiene aggiornato. Le Dynamic Table in dbt portano tutto questo direttamente nel framework dbt, mentre l’incrementalizzazione personalizzata offre il pieno controllo quando necessario.
Domanda: In che modo Snowflake aiuta a sostituire l’ETL tra sistemi transazionali e analitici?
Risposta: Tradizionalmente, le organizzazioni eseguono le transazioni in un sistema e l’analisi dei dati in un altro, con pipeline ETL a fare da collegamento. Il data mirroring di Snowflake Postgres replica continuamente le tabelle Postgres in Snowflake per l’analisi dei dati e l’AI con un solo comando. Le hybrid table rispondono all’esigenza opposta (letture e scritture transazionali rapide all’interno di Snowflake), così le app interne create con Streamlit o Snowflake App Runtime non hanno bisogno di un database separato.
Domanda: Che ruolo giocano i formati di tabella open, come Apache Iceberg, nel data engineering?
Risposta: I formati di tabella open permettono ai team di scegliere i propri motori di calcolo, mantenendo al contempo i dati in un’unica posizione governata. Snowflake supporta Apache Iceberg con branching, Time Travel e tagging, offrendo agli engineer un workflow write-audit-publish: Effettuare lo stage delle modifiche su un branch isolato, convalidarle e pubblicarle o scartarle. Questo è particolarmente importante dato che gli agenti AI iniziano a leggere e scrivere sulle stesse tabelle che leggono e su cui scrivono le pipeline: ogni modifica dispone di un audit trail governato.
1 Confronto di throughput e costi basato su benchmark di produzione dei workload delle hybrid table, misurati prima e dopo i miglioramenti delle prestazioni. Un throughput equivalente richiedeva otto warehouse XS prima e un warehouse XS dopo. Il risparmio sui costi è potenziale e dipende dal workload.
2 Confronto della latenza basato su benchmark di produzione, misurati prima e dopo i miglioramenti delle prestazioni. I risultati dipendono dal workload.

10 settembre 2026Strategia e insight
Data engineering autonomo: 5 fasi verso una vera maturità agentica
19 ottobre 2026Data engineering
Il percorso verso il data engineering autonomo: risolvere gli errori delle pipeline di dati con l’AI

10 giugno 2026Prodotto e tecnologia
Il data engineering nell’era dell’AI: nuovi strumenti Snowflake per pipeline intelligenti