3 nov. 2026/Lecture : 19 minProduit et technologie
Apporter les données au rythme de chaque agent et application

Aujourd’hui, la plupart des entreprises s’efforcent de déterminer quels agents d’IA et quelles applications créer. Mais leur stratégie data pourra-t-elle suivre le rythme ? Rien n’est moins sûr. Un agent qui répond à partir de chiffres obsolètes ou une application qui ne détecte pas une commande passée cinq minutes plus tôt perd rapidement la confiance des utilisateurs. Le déploiement de l’IA à grande échelle dépend fortement des pipelines, des tables et des systèmes transactionnels qui l’alimentent.
Pour exploiter les bonnes données, deux leviers sont essentiels : établir une base fiable pour les équipes, avec des pipelines déclarés, versionnés et testés ainsi que des données transactionnelles et analytiques unifiées sur une même plateforme, puis confier davantage de tâches courantes à l’IA.
Aujourd’hui, à l’occasion d’Expedition, Snowflake annonce des fonctionnalités qui vous aideront sur ces deux fronts. De l’analytique en temps réel aux données d’open lakehouse, en passant par l’accès à l’échelle de l’entreprise et les systèmes transactionnels, tout commence par la façon dont les pipelines sont créés et maintenus en fonctionnement.
Les fondements du data engineering autonome
L’IA peut aider à produire une transformation ou suggérer un correctif, mais les équipes d’ingénierie doivent toujours savoir ce qu’un workflow est censé accomplir, quels éléments en dépendent et si une modification peut être déployée sans risque. La compréhension de ces éléments détermine si l’assistance par l’IA réduit réellement la charge de travail ou génère simplement davantage de modifications à vérifier. Pour y parvenir, les organisations doivent mettre en place les fondements suivants.
Adoptez une infrastructure moderne
Commencez par vous affranchir des décisions liées au matériel. Adaptive Compute (disponible pour tous nos clients) dimensionne automatiquement vos ressources de calcul en fonction de chaque charge de travail, sans réglage manuel des warehouses ni des clusters. Vous décrivez le travail à effectuer, et Snowflake optimise son exécution.
Les charges de travail Spark s’exécutent également sur Adaptive Compute, ce qui réduit les efforts nécessaires pour les gérer. La prise en main est tout aussi simple. Importez votre code et vos compétences existants dans Snowflake, puis exploitez-les sur la même plateforme gouvernée que le reste de vos pipelines. Snowpark Connect for Apache Spark™ (disponible pour tous nos clients) exécute directement le code PySpark, Java et Scala existant dans Snowflake, sans aucun cluster externe à gérer. Le Next-Gen File Reader for Apache Spark (en private preview) applique simplement la sémantique de lecture propre à Spark aux formats JSON, CSV, XML et Parquet, afin de traiter les fichiers désordonnés de la couche bronze.
Snowpark Connect offre une interopérabilité complète pour accéder, quelle que soit l’opération, aux tables Apache Iceberg™ gérées par Horizon, AWS Glue and Unity Catalog, et pour déployer des agents en activant un contrôle de la qualité des données avant la mise en production avec Spark write-audit-publish. Pour cela, une branche isolée est créée afin d’éviter que des données de mauvaise qualité n’atteignent la production. Les branches peuvent être interrogées comme n’importe quelle autre table depuis Snowflake ou tout autre moteur afin d’évaluer l’impact en aval. Vous pouvez ensuite publier ou abandonner les modifications, ce qui simplifie la mise en place d’un contrôle qualité avant le passage des données en production.
Les Incremental reads (disponibles pour tous nos clients) améliorent l’efficacité des jobs Spark. Traitez uniquement les modifications entre les snapshots Iceberg plutôt que d’effectuer une analyse complète. Les fonctionnalités Iceberg Time Travel, ainsi que les balises (disponibles pour tous nos clients), permettent des restaurations sécurisées et offrent des points de contrôle stables et partageables, faciles à utiliser par les équipes avec Spark ou d’autres charges de travail. Snowpark Connect étend également sa prise en charge d’Iceberg à Iceberg v3 avec Spark 4.0 (en private preview), avec des fonctionnalités clés comme le type de données VARIANT pour les données semi-structurées et la traçabilité au niveau des lignes, afin de simplifier les workflows de capture des données modifiées (CDC), d’audit et de conformité.
Spark Monitoring UI (en public preview) offre un débogage unifié des sessions et des jobs batch, jusqu’aux profils de chaque requête. Les Code Bundles for Apache Spark (en public preview) permettent de soumettre des jobs Spark via une API REST ou SQL afin de les intégrer aux outils de planification que vous utilisez déjà, d’Airflow aux tâches Snowflake. Et pour vous lancer, la compétence de migration Spark sur Snowflake CoCo (disponible pour tous nos clients) convertit vos notebooks et jobs PySpark, Spark Scala et Spark Java existants pour les exécuter dans Snowflake.
Pour les pipelines SQL déclaratifs, la fonctionnalité d’incrémentalisation personnalisée de Dynamic Tables (disponible pour tous nos clients) vous donne un contrôle total sur la logique incrémentielle et vous permet de planifier son exécution selon vos besoins. Dynamic Tables in dbt (disponible pour tous nos clients) intègre nativement la logique d’incrémentalisation à l’environnement dbt. Les équipes dbt bénéficient ainsi de la performance de Dynamic Tables sans quitter leur chaîne d’outils. Les clients peuvent également utiliser Dynamic Iceberg Tables pour actualiser des produits de données au format ouvert, comme des jeux de données cliniques, sans pipelines personnalisés. Désormais, en private preview, Snowflake peut les actualiser directement dans votre propre catalogue Iceberg externe.
Définissez le cycle de vie de vos logiciels
Une infrastructure moderne constitue un bon début, mais le code impératif reste difficile à tester, à déboguer et à considérer comme fiable. L’adoption de workflows déclaratifs et contrôlés par version libère des ressources, vous laissant plus de temps pour créer de nouveaux produits de données.
dbt Projects (disponible pour tous nos clients) intègre nativement l’environnement dbt à Snowflake, ce qui vous permet de tester et de documenter des modèles dbt sans gérer d’infrastructure ni recourir à un orchestrateur externe. CI ciblée avec recours aux objets de production (disponible pour tous nos clients) permet de réutiliser les artefacts d’objet de votre projet dbt pour n’exécuter que les modèles modifiés. La validation passe ainsi de plusieurs minutes à quelques secondes, ce qui permet de vérifier chaque pull request.
DCM Projects (disponible pour tous nos clients) permet aux équipes de gérer de manière déclarative l’infrastructure Snowflake, les pipelines de données et les configurations de gouvernance, grâce à des automatisations CI/CD auditables qui valident chaque modification avant son passage en production. DCM Test Branches (en private preview) va encore plus loin en permettant d’automatiser les tests unitaires et d’intégration sur des données de production ou synthétiques avant le déploiement.
Ajoutez un cadre d’exécution natif pour les données
Une fois l’infrastructure moderne et le cycle de vie défini en place, l’étape suivante consiste à adopter un cadre d’exécution qui orchestre de manière agentique les workflows data-driven, en prenant en charge les tâches récurrentes de configuration, de réglage et de résolution des problèmes.
Dynamic Tables Insights (disponible pour tous nos clients) fournit des recommandations d’optimisation précises que Snowflake CoCo peut mettre en œuvre pour vous. Le système établit son propre diagnostic, vous indique les corrections à apporter et vous guide dans les étapes de mise en œuvre dans CoCo.
Automated Snowpipe setup by CoCo (disponible pour tous nos clients) crée un pipeline d’ingestion continue de fichiers à partir d’un chemin S3 : stage, pipe, format de fichier et gestion des erreurs, le tout configuré et opérationnel.
Pipeline Builder (en public preview) fournit un canevas visuel pour orchestrer les notebooks, les jobs de ML, les tâches et les objets SQL. Vous pouvez les créer en dialoguant avec CoCo, puis les modifier par simple glisser-déposer des connexions. Le Task Graph Object (en public preview) transforme les tâches en un orchestrateur complet : modifiez les graphes sans les suspendre et créez des branches conditionnelles.
Grâce à un cadre d’exécution natif pour les données et spécialement conçu pour les tâches de data engineering, les ingénieurs optimisent leur utilisation des tokens et produisent des résultats de meilleure qualité, tout en consacrant moins de temps au raccordement et au réglage des pipelines. La plateforme acquiert également le contexte nécessaire à l’étape finale : agir en fonction de ses découvertes.
Confiez les tâches récurrentes aux agents
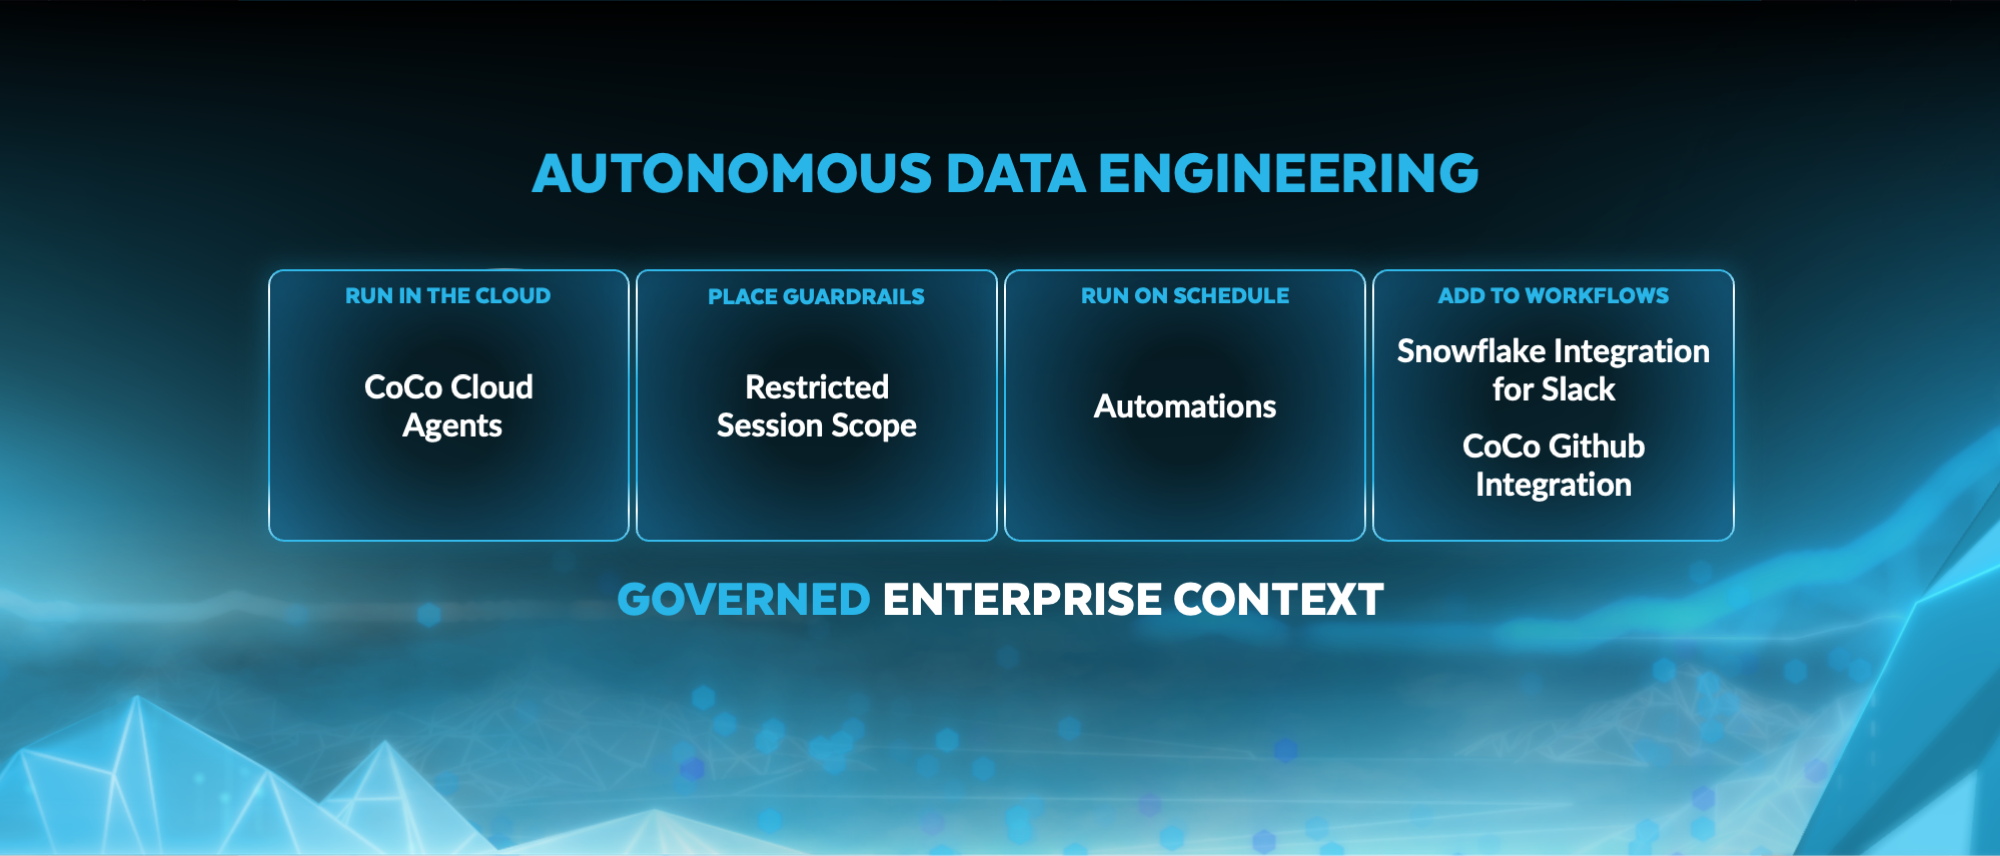
Tous ces éléments permettent aux agents de prendre en charge de façon autonome les tâches les plus fastidieuses. Avec Cloud Agents (disponible pour tous nos clients), CoCo crée un environnement isolé géré par Snowflake, plutôt que de s’exécuter sur l’ordinateur portable d’un ingénieur. Chaque session bénéficie de son propre conteneur sécurisé et utilise des fichiers stockés dans un Snowflake Workspace partagé. Un data engineer peut aussi restreindre davantage ses actions avec Restricted Session Scope (disponible pour tous nos clients). Comme le travail s’effectue dans le cloud, il peut se poursuivre après la déconnexion de l’ingénieur, ce qui facilite les tâches de longue durée et la collaboration entre les équipes.
Coding Agents (disponible pour tous nos clients) intègre des capacités de programmation à vos propres applications via l’API REST Cortex Agents ou SQL. Les CoCo automations (disponibles pour tous nos clients dans l’interface Snowsight et la CLI, et en public preview dans CoCo Desktop) permettent aux équipes data d’exécuter ces agents de façon autonome. Les ingénieurs data peuvent décrire une tâche récurrente en langage naturel, par exemple vérifier l’état d’un pipeline ou analyser l’échec de jobs, puis la tâche s’exécute de manière proactive. Les équipes peuvent partager les CoCo Skills qu’elles ont créées afin de réutiliser facilement leurs workflows. Comme CoCo s’exécute dans Snowflake, il exploite la traçabilité, le catalogue et les politiques de gouvernance de l’organisation. Il dispose ainsi d’un contexte inaccessible à un assistant de programmation généraliste.
Snowflake for Slack (bientôt en public preview) intègre CoCo aux canaux où les équipes travaillent déjà. Chacun peut ainsi poser des questions, lancer un workflow ou examiner les résultats sans quitter le fil de discussion. Et grâce à CoCo GitHub integration (en public preview), les modifications de code proposées suivent toujours le processus de revue existant de l’équipe.
Chaque couche fondamentale s’appuie sur la précédente : abstraire l’infrastructure, codifier le cycle de vie, ajouter un cadre d’exécution natif pour les données et confier aux agents des tâches clairement définies à automatiser. Reste à savoir si ces pipelines peuvent fournir des données en temps réel, au rythme des agents et des applications qui en dépendent.
L’analytique en temps réel de bout en bout dans un environnement unique
Un pipeline autonome est certes une belle avancée, mais ce n’est pas une fin en soi. S’il fournit des informations obsolètes à un agent, son utilité diminue. Or, disposer de données plus récentes nécessitait généralement d’ajouter et d’exploiter une nouvelle infrastructure pour chaque charge de travail concernée.
Snowflake réunit désormais dans un même environnement l’analytique en temps réel de bout en bout, de la connectivité à la transformation et à la mise à disposition. Les équipes peuvent ainsi créer ces cas d’usage selon une approche connectée, économique et gouvernée.
Pour commencer par l’ingestion à haut volume, Snowpipe Streaming permet de diffuser des pipelines de données en continu directement dans Snowflake, avec jusqu’à 20 GB/s par table, une latence de 5 secondes et une tarification prévisible du débit. Avec Elastic Channels (disponible pour tous nos clients), des milliers de producteurs peuvent partager un même chemin d’ingestion. Snowflake gère l’évolution de la capacité, sans que vous ayez à coordonner les canaux à mesure que le trafic augmente. Datastream (bientôt en public preview) intègre le protocole Apache Kafka, déjà bien connu et apprécié des ingénieurs data, au périmètre de sécurité et de gouvernance de Snowflake. À mesure que les données arrivent, Streaming Transformations (en private preview) permet aux équipes de les transformer à la volée avec du SQL standard. Les données en aval restent ainsi actualisées et prêtes à alimenter les applications en quelques secondes.
Les tableaux de bord, les applications destinées aux clients et les agents d’IA accèdent souvent simultanément aux mêmes données. C’est précisément là que de nombreux projets en temps réel s’enlisent. Pour suivre le rythme, les équipes finissent par copier les données dans une base de données de mise à disposition distincte, ce qui augmente les coûts d’infrastructure et les frais opérationnels. Interactive Analytics (disponible pour tous nos clients) traite ce trafic directement dans Snowflake, avec des requêtes en moins d’une seconde à forte concurrence sur les mêmes tables gouvernées que celles déjà gérées par les ingénieurs. Aucune deuxième copie à synchroniser, aucun système supplémentaire à sécuriser et aucun pipeline distinct à maintenir en fonctionnement. Les équipes bénéficient de la performance nécessaire sans financer un deuxième système.
Choisissez comment connecter chaque source
Toutes les charges de travail n’ont pas les mêmes exigences d’actualisation. De même, les équipes data n’ont pas besoin d’appliquer le même schéma à chaque source. Certaines données doivent être ingérées et transformées dans Snowflake. D’autres peuvent rester dans leur système de référence et y être interrogées. Choisir le mode de connexion de chaque source réduit le nombre de copies à gérer et de pipelines à maintenir.
Pour les données qui doivent être importées dans Snowflake, Snowflake Openflow est conçu pour connecter un large éventail de sources et prendre en charge l’ingestion à l’échelle de l’entreprise. Que vous ayez besoin d’une connectivité on-premise via Data Connectivity Proxy (disponible pour tous nos clients) ou de prendre en charge d’autres environnements cloud, Openflow offre la performance, la portée à l’échelle de l’entreprise et le contrôle opérationnel nécessaires, avec des fonctionnalités d’observabilité et de résolution des problèmes assistée par l’IA. La planification de l’exécution et la suspension automatique offrent également aux équipes un meilleur contrôle sur les périodes d’exécution des charges de travail d’intégration.
Les équipes ont également besoin de solutions pour exploiter les fichiers déjà présents dans leur environnement de stockage. Zero-Copy Parquet rend les fichiers Parquet existants accessibles au format Iceberg sans réécrire les données sources. Parquet Direct fournit un chemin distinct en lecture seule pour interroger les fichiers Parquet là où ils se trouvent.
Pour les données déjà présentes dans votre système de référence de confiance, les intégrations zéro copie avec SAP Business AI Data Cloud, Workday AI Data Cloud et Salesforce sont désormais disponibles pour tous nos clients. L’intégration zéro copie est conçue pour donner accès aux données dans leur système source, ce qui réduit la nécessité de créer des pipelines d’extraction pour l’analytique ou l’IA. Les clients SAP peuvent exploiter leurs données stratégiques à des fins d’analytique et d’IA, tout en respectant les exigences de connectivité privée. La connectivité AWS PrivateLink unidirectionnelle entre SAP Business AI Data Cloud et Snowflake (bientôt disponible pour tous nos clients) aide les clients à étendre le contexte business fiable de SAP à l’ensemble des données de l’entreprise afin d’obtenir de meilleurs résultats stratégiques.
Ces schémas peuvent coexister au sein d’une même architecture de données. Par exemple, un ingénieur peut ingérer des événements opérationnels via Openflow, accéder sur place aux données d’un partenaire grâce à une intégration zéro copie et utiliser Spark pour traiter des fichiers sur Iceberg. Pour chaque source, il faut donc déterminer si ses données doivent être déplacées, comment elles seront utilisées et quels contrôles appliquer. Ces questions sont particulièrement importantes pour les systèmes transactionnels, là où se déroule réellement le business.
Exploiter les données opérationnelles dans les applications et les agents
Pour permettre aux applications et aux agents de comprendre pleinement le fonctionnement des entreprises et de prendre des décisions précises, il est stratégique de disposer d’un contexte opérationnel à jour. Pourtant, la plupart des organisations continuent de gérer les transactions dans un système et les analyses dans un autre, avec des pipelines ETL qui transfèrent les données entre les deux. Ces pipelines augmentent la latence et les coûts, tout en ajoutant une tâche de maintenance pour les ingénieurs.
Pour y remédier, nous avons lancé Snowflake Postgres, qui intègre à Snowflake la base de données la plus populaire au monde. Associé au projet open source pg_lake, Snowflake Postgres a permis de remplacer les solutions ETL tierces et fragiles par une méthode plus simple et plus efficace pour connecter l’ensemble de votre patrimoine de données. Nous allons désormais encore plus loin avec la mise en miroir des données, une solution entièrement managée qui transforme les données transactionnelles en insights, puis les insights en actions.
Une commande ou quelques clics suffisent pour la configurer. La mise en miroir des données Postgres (disponible pour tous nos clients) réplique en continu vos tables Postgres dans le reste de Snowflake à des fins d’analyse et d’IA. La mise en miroir des données Snowflake (bientôt en public preview) transfère les données dans l’autre sens. Les profils clients enrichis et les résultats d’analyse sont renvoyés vers Postgres, où ils alimentent des agents plus intelligents et des expériences plus personnalisées.
Les applications internes d’entreprise développées avec Streamlit ou Snowflake App Runtime s’exécutent déjà sur Snowflake et utilisent les données Snowflake. Lorsque ces applications nécessitent également des lectures et des écritures transactionnelles rapides, les tables hybrides réduisent considérablement les frais opérationnels. Les tables hybrides offrent désormais un débit jusqu’à 8 fois supérieur. Pour certaines charges de travail, un seul warehouse XS suffit là où il en fallait auparavant 8, ce qui peut réduire les coûts de plus de 80 %.1 Snowflake a également considérablement réduit la latence des charges de travail opérationnelles impliquant des opérations ponctuelles, avec une latence P50 divisée par 3 et une latence P99 environ divisée par 2.2 Pour les milliers de clients qui utilisent déjà les tables hybrides, les applications existantes gagnent en rapidité tout en coûtant moins cher, sans aucune réarchitecture.
Les tables hybrides et Snowflake Postgres sont complémentaires. Les tables hybrides s’imposent naturellement lorsque vous recherchez une intégration étroite avec d’autres fonctionnalités Snowflake, sans base de données distincte. Snowflake Postgres est la solution idéale lorsque les équipes ont besoin de l’écosystème Postgres ou de la latence la plus faible possible.
Créer un socle capable d’évoluer avec vos besoins
Chaque agent, chaque application et chaque décision de votre business repose sur des données à jour et fiables. Pour y parvenir, vous avez toutefois besoin de pipelines testés et de systèmes opérationnels correctement connectés. Snowflake réunit désormais tous ces éléments pour permettre à l’IA de prendre en charge les tâches routinières tout au long du processus.
Les ingénieurs data peuvent ainsi se concentrer sur la suite.
Découvrez toutes les annonces de Snowflake Expedition ou participez à l’événement virtuel.
FAQ
Q : Comment les agents d’IA peuvent-ils faciliter le travail de data engineering ?
R : Dès lors que les pipelines sont déclaratifs et gérés sous contrôle de version, les agents d’IA peuvent prendre en charge des tâches opérationnelles récurrentes, comme vérifier l’état des pipelines, identifier les causes des défaillances et proposer des correctifs à examiner. Les automatisations Snowflake CoCo exécutent ces agents selon un calendrier défini dans Snowflake, où ils utilisent le lignage, le catalogue et les politiques de gouvernance. Les modifications de code proposées suivent toujours le processus de révision existant de l’équipe via l’intégration GitHub de CoCo.
Q : Qu’est-ce que l’analyse en temps réel et en quoi diffère-t-elle de l’analyse par batch ?
R : L’analyse en temps réel traite et met à disposition les données dans les secondes qui suivent leur arrivée, sans attendre l’exécution d’une tâche batch planifiée. Cette rapidité est essentielle lorsque des agents, des tableaux de bord ou des applications destinées aux clients ont besoin d’informations à jour pour prendre des décisions. Snowflake fournit une analyse en temps réel de bout en bout sur une seule plateforme, depuis l’ingestion en streaming avec Snowpipe Streaming, avec une latence de 5 secondes et jusqu’à 20 Go/s, jusqu’à la transformation et à la mise à disposition en moins d’une seconde avec Interactive Analytics, le tout sur les mêmes tables gouvernées que les équipes gèrent déjà.
Q : Comment les Dynamic Tables simplifient-elles les pipelines de données ?
R : Les Dynamic Tables permettent aux équipes de définir une transformation de manière déclarative, sous forme de requête. Snowflake gère ensuite automatiquement la planification, l’incrémentalisation et l’ordre des dépendances. Au lieu d’écrire et de maintenir du code ETL impératif, vous décrivez le résultat souhaité et la plateforme le maintient à jour. Les Dynamic Tables dans dbt intègrent directement cette approche à l’environnement dbt, tandis que l’incrémentalisation personnalisée vous donne un contrôle total lorsque vous en avez besoin.
Q : Comment Snowflake aide-t-il à remplacer l’ETL entre les systèmes transactionnels et analytiques ?
R : Traditionnellement, les organisations gèrent les transactions dans un système et les analyses dans un autre, avec des pipelines ETL entre les deux. La mise en miroir des données Snowflake Postgres réplique en continu les tables Postgres dans Snowflake à des fins d’analyse et d’IA, à l’aide d’une seule commande. Les tables hybrides répondent au besoin inverse en assurant des lectures et des écritures transactionnelles rapides dans Snowflake. Les applications internes développées avec Streamlit ou Snowflake App Runtime n’ont donc pas besoin d’une base de données distincte.
Q : Quel rôle les formats de table ouverts comme Apache Iceberg jouent-ils dans le data engineering ?
R : Les formats de table ouverts permettent aux équipes de choisir leurs moteurs de calcul tout en conservant les données dans un emplacement unique et gouverné. Snowflake prend en charge Apache Iceberg avec la création de branches, Time Travel et l’ajout de tags, offrant ainsi aux ingénieurs un workflow d’écriture, d’audit et de publication : préparer les modifications sur une branche isolée, les valider, puis les publier ou les abandonner. Cette approche est particulièrement importante à mesure que les agents d’IA commencent à lire et à écrire dans les mêmes tables que les pipelines. Chaque modification dispose ainsi d’une piste d’audit gouvernée.
1 Comparaison du débit et des coûts fondée sur des benchmarks de production de charges de travail utilisant des tables hybrides, effectués avant et après les améliorations de performance. Pour atteindre un débit équivalent, il fallait auparavant huit warehouses XS, contre un seul après les améliorations. Les économies potentielles dépendent de la charge de travail.
2 Comparaison de la latence fondée sur des benchmarks de production, effectués avant et après les améliorations de performance. Les résultats dépendent de la charge de travail.

10 sept. 2026Stratégie et perspectives
Data engineering autonome : 5 étapes vers une véritable maturité agentique
19 oct. 2026Data engineering
La voie vers le data engineering autonome : réparer les défaillances des pipelines de données grâce à l’IA
10 juin 2026Produit et technologie
Le data engineering à l’ère de l’IA : nouveaux outils Snowflake pour des pipelines intelligents

