3 nov 2026/19 min de lecturaProducto y tecnología
Datos que siguen el ritmo de tus agentes y aplicaciones

Hoy, la mayoría de las empresas se esfuerzan por decidir qué agentes y aplicaciones de inteligencia artificial (IA) desarrollar. Pero que su estrategia de datos pueda seguirles el ritmo es otra cuestión. Un agente que responde basándose en cifras desactualizadas o una aplicación que no puede consultar un pedido realizado por un cliente hace cinco minutos pierden rápidamente la confianza de los usuarios. En realidad, el escalado de la IA depende en gran medida de los pipelines, las tablas y los sistemas transaccionales que la alimentan.
Para disponer de los datos adecuados, hay que dar dos pasos: establecer un fundamento de datos en el que los equipos puedan confiar (pipelines declarativos, con control de versiones y probados, junto con datos transaccionales y analíticos unificados en la misma plataforma) y dejar que la IA asuma más tareas rutinarias.
Hoy, en Expedition, Snowflake anuncia funcionalidades que te ayudan a hacer ambas cosas. Abarcan desde analíticas en tiempo real y datos de lakehouse abierto hasta acceso empresarial y sistemas transaccionales, pero todo empieza por cómo se crean los pipelines y se mantienen en funcionamiento.
Las bases de la ingeniería de datos autónoma
La IA puede ayudar a crear una transformación o sugerir una corrección, pero los equipos de ingeniería siguen necesitando saber qué debe hacer un flujo de trabajo, qué depende de él y si es seguro poner un cambio en producción. Comprender estos aspectos determina si la ayuda de la IA realmente reduce el trabajo o simplemente genera más cambios que revisar. Para conseguirlo, las organizaciones necesitan establecer las siguientes bases.
Adoptar una infraestructura moderna
Para empezar, delega las decisiones sobre el hardware. Adaptive Compute (con disponibilidad general) ajusta automáticamente el tamaño de los recursos de cómputo a cada workload, sin necesidad de realizar ajustes manuales de los almacenes ni de los clústeres. Tú describes el trabajo y Snowflake optimiza su ejecución.
Los workloads de Spark también se ejecutan en Adaptive Compute, lo que reduce el esfuerzo necesario para gestionarlos. Además, empezar es fácil. Lleva a Snowflake el código y los conocimientos que ya tienes y ejecútalo en la misma plataforma gobernada que el resto de tus pipelines. Snowpark Connect for Apache Spark™ (con disponibilidad general) ejecuta código PySpark, Java y Scala existente directamente en Snowflake, sin clústeres externos que gestionar. Next-Gen File Reader for Apache Spark (en vista previa privada) aplica sin esfuerzo la semántica de lectura propia de Spark a archivos JSON, CSV, XML y Parquet para poder trabajar con archivos desordenados de la capa de bronce.
Snowpark Connect ofrece interoperabilidad total para acceder a tablas de Apache Iceberg™ gestionadas por Horizon, AWS Glue y Unity Catalog para cualquier operación, e implementar agentes al activar una comprobación de calidad de los datos antes de pasar a producción con Spark write-audit-publish. Para ello, crea una rama aislada que ayuda a evitar que los datos incorrectos lleguen a producción. Las ramas pueden consultarse como cualquier otra tabla desde Snowflake o cualquier motor para comprobar el impacto posterior. Después, puedes publicarlas o descartarlas, lo que facilita la aplicación de una comprobación de calidad antes de que los datos pasen a producción.
Las lecturas incrementales (con disponibilidad general) mejoran la eficiencia de los trabajos de Spark. Procesa solo los cambios entre instantáneas de Iceberg, en lugar de realizar un análisis completo. Iceberg Time Travel y las etiquetas (con disponibilidad general) permiten volver de forma segura a un estado anterior y proporcionan puntos de control estables y compartibles con los que los equipos pueden trabajar fácilmente en Spark u otros workloads. Snowpark Connect también ha ampliado su compatibilidad con Iceberg a Iceberg v3 con Spark 4,0 (en vista previa privada), e incorpora funcionalidades clave como el tipo de datos VARIANT para datos semiestructurados y el linaje a nivel de fila, que simplifican los flujos de trabajo de captura de cambios en los datos (CDC), auditoría y cumplimiento.
Spark Monitoring UI (en vista previa pública) ofrece una depuración unificada de sesiones y trabajos por lotes, hasta el nivel de los perfiles de cada consulta. Code Bundles for Apache Spark (en vista previa pública) permite enviar trabajos de Spark mediante una REST API o SQL para integrarlos en los planificadores que ya utilizas, desde Airflow hasta tareas de Snowflake. Y, para empezar, la skill de migración de Spark en Snowflake CoCo (con disponibilidad general) convierte tus notebooks y trabajos de PySpark, Spark Scala y Spark Java para que se ejecuten en Snowflake.
Para los pipelines SQL declarativos, el procesamiento incremental personalizado en tablas dinámicas (con disponibilidad general) te da control total sobre la lógica incremental y te permite programar su ejecución cuando la necesites. Las tablas dinámicas en dbt (con disponibilidad general) incorporan de forma nativa la lógica incremental al marco de dbt, para que sus equipos aprovechen el rendimiento de las tablas dinámicas sin salir de su conjunto de herramientas. Los clientes también pueden usar tablas dinámicas de Iceberg para mantener actualizados productos de datos en formato abierto, como los conjuntos de datos clínicos, sin pipelines personalizados. Ahora, en vista previa privada, Snowflake puede actualizarlos directamente en tu propio catálogo externo de Iceberg.
Definir el ciclo de vida del software
Una infraestructura moderna es un comienzo, pero el código imperativo sigue siendo difícil de probar, depurar y considerar fiable. Pasar a flujos de trabajo declarativos y sujetos a control de versiones libera recursos y te deja tiempo para crear nuevos productos de datos.
dbt Projects (con disponibilidad general) incorpora el marco de dbt de forma nativa a Snowflake, para que puedas probar y documentar modelos de dbt sin gestionar infraestructura ni recurrir a un orquestador externo. Slim CI y defer to production (con disponibilidad general) te permiten reutilizar los artefactos de los objetos de tu proyecto dbt para ejecutar solo los modelos que han cambiado. Así, la validación pasa de minutos a segundos y resulta viable comprobar cada solicitud de incorporación de cambios.
DCM Projects (con disponibilidad general) permite a los equipos gestionar de forma declarativa la infraestructura de Snowflake, los pipelines de datos y las configuraciones de gobernanza, con automatizaciones de CI/CD auditables que validan todos los cambios antes de que lleguen a producción. DCM Test Branches (en vista previa privada) va un paso más allá al permitir realizar pruebas unitarias y de integración automatizadas con datos de producción o sintéticos antes de la implementación.
Añadir un entorno de soporte nativo de datos
Con una infraestructura moderna y un ciclo de vida definido, el siguiente paso es contar con un entorno de soporte que impulse mediante agentes los flujos de trabajo basados en datos y se encargue de las tareas recurrentes de configuración, ajuste y resolución de problemas.
Dynamic Tables Insights (con disponibilidad general) presenta recomendaciones de optimización concretas que Snowflake CoCo puede aplicar por ti. El sistema se diagnostica a sí mismo, te indica qué debes corregir y te guía por los pasos para hacerlo en CoCo.
La configuración automatizada de Snowpipe con CoCo (con disponibilidad general) crea un pipeline de ingestión continua de archivos a partir de una ruta de S3: configura un stage, un pipe, el formato de archivo y la gestión de errores, y lo deja todo en funcionamiento.
Pipeline Builder (en vista previa pública) ofrece un lienzo visual para orquestar notebooks, trabajos de aprendizaje automático (ML), tareas y objetos SQL. Puedes crearlo mediante una conversación con CoCo y editarlo arrastrando las conexiones. Task Graph Object (en vista previa pública) convierte las tareas en un orquestador completo: modifica los grafos sin suspenderlos y crea ramificaciones condicionales.
Con un entorno de soporte nativo de datos diseñado específicamente para tareas de ingeniería de datos, los ingenieros utilizan los token de forma más eficiente y producen resultados de mayor calidad, por lo que dedican menos tiempo a conectar y ajustar pipelines. La plataforma también obtiene el contexto que necesita para el último paso: actuar en función de lo que detecta.
Dejar que los agentes asuman el trabajo recurrente
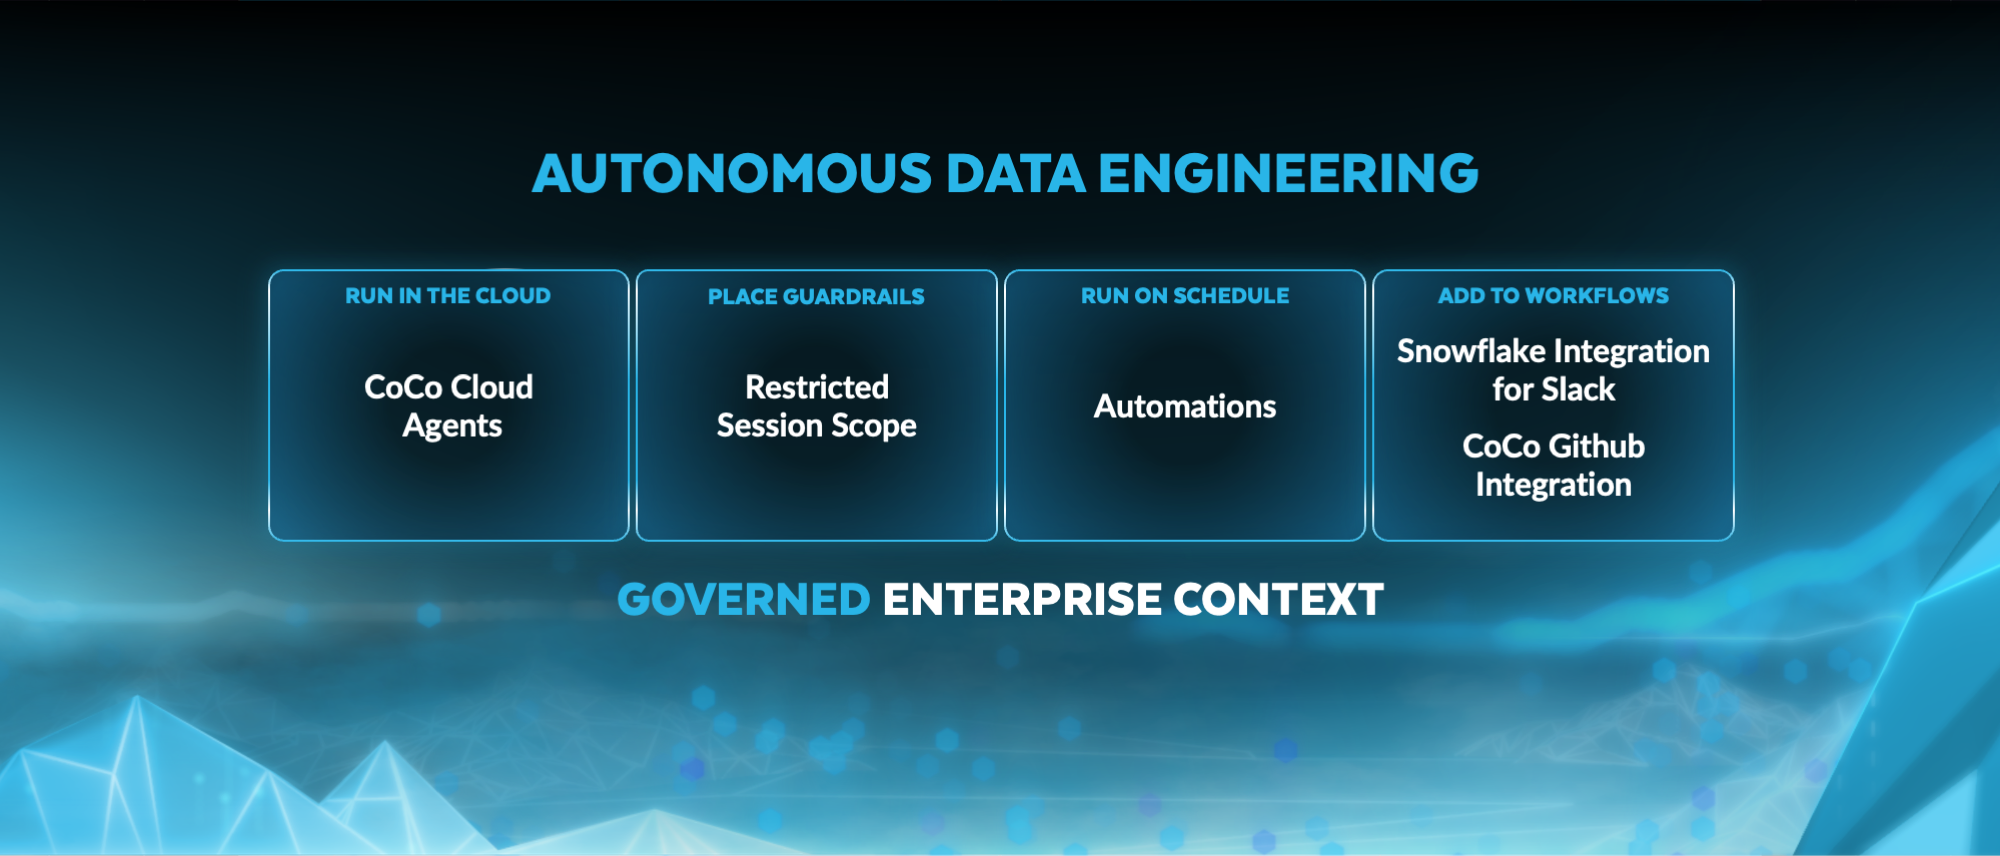
Todo esto culmina en agentes de IA capaces de encargarse por sí solos de las tareas rutinarias. Con Cloud Agents (con disponibilidad general), CoCo inicia un entorno aislado gestionado por Snowflake, en lugar de ejecutarse en el portátil de un ingeniero. Cada sesión dispone de su propio contenedor seguro y trabaja con archivos de un Snowflake Workspace compartido. Además, un ingeniero de datos puede restringir aún más lo que puede hacer mediante Restricted Session Scope (con disponibilidad general). Como el trabajo se realiza en la nube, puede continuar después de que el ingeniero cierre la sesión, lo que permite ejecutar tareas de larga duración y colaborar entre equipos.
Coding Agents (con disponibilidad general) incorpora capacidades de programación a tus propias aplicaciones mediante Cortex Agents REST API o SQL. Las automatizaciones de CoCo (con disponibilidad general en la interfaz de Snowsight y la CLI; en vista previa pública en CoCo Desktop) permiten a los equipos de datos ejecutar esos agentes de forma autónoma. Los ingenieros de datos pueden describir una tarea recurrente en lenguaje natural, como comprobar el estado de un pipeline o investigar trabajos fallidos, y la tarea se ejecuta de forma proactiva. Los equipos pueden compartir las skills de CoCo que han creado para reutilizar fácilmente los flujos de trabajo. Como CoCo se ejecuta dentro de Snowflake, puede trabajar con el linaje, el catálogo y las políticas de gobernanza de una organización, lo que le proporciona un contexto del que carecería un asistente de programación de uso general.
Snowflake for Slack (próximamente en vista previa pública) lleva CoCo a los canales donde ya trabajan los equipos, para que puedan hacer preguntas, iniciar un flujo de trabajo o revisar resultados sin salir de la conversación. Y la integración de CoCo con GitHub (en vista previa pública) garantiza que los cambios de código propuestos sigan pasando por el proceso de revisión habitual del equipo.
Cada capa de esta base se apoya en la anterior: delega la infraestructura, define el ciclo de vida mediante código, añade un entorno de soporte nativo de datos y asigna a los agentes tareas bien definidas que puedan automatizar. La siguiente pregunta es si esos pipelines pueden suministrar datos en tiempo real tan rápido como los necesitan los agentes y las aplicaciones que dependen de ellos.
Analíticas integrales en tiempo real en un único entorno
Un pipeline que se gestiona por sí solo es, sin duda, un logro, pero no es el objetivo final. Si proporciona información desactualizada a un agente, resulta menos útil. Sin embargo, obtener datos más actualizados solía implicar añadir y gestionar nueva infraestructura para cada workload que los necesitaba.
Ahora, Snowflake reúne en un único entorno las analíticas integrales en tiempo real, desde la conectividad hasta la transformación y el servicio de los datos, para que los equipos puedan desarrollar estos casos de uso con un enfoque conectado, rentable y gobernado.
Empezando por la ingestión de grandes volúmenes, Snowpipe Streaming te permite transmitir pipelines continuos de datos directamente a Snowflake con hasta 20 GB/s por tabla, una latencia de 5 segundos y un rendimiento con precios predecibles. Con Elastic Channels (con disponibilidad general), miles de productores pueden compartir una misma ruta de ingestión mientras Snowflake se encarga del escalado, de modo que no tengas que coordinar los canales a medida que aumenta el tráfico. Datastream (próximamente en vista previa pública) incorpora el protocolo de Apache Kafka que los ingenieros de datos ya conocen y aprecian dentro del perímetro de seguridad y gobernanza de Snowflake. A medida que llegan los datos, Streaming Transformations (en vista previa privada) permite a los equipos transformarlos en movimiento con SQL estándar, para que los datos destinados a los procesos posteriores se mantengan actualizados y estén listos para las aplicaciones en cuestión de segundos.
Los paneles, las aplicaciones orientadas al cliente y los agentes de IA suelen acceder a los mismos datos al mismo tiempo, y ahí es donde muchos proyectos en tiempo real se estancan. Para responder a esa demanda, los equipos acaban copiando los datos en una base de datos de servicio independiente, lo que aumenta el coste de infraestructura y la carga operativa. Interactive Analytics (con disponibilidad general) atiende ese tráfico directamente en Snowflake, con consultas de menos de un segundo y una elevada simultaneidad sobre las mismas tablas gobernadas que ya mantienen los ingenieros. No hay una segunda copia que sincronizar, un sistema adicional que proteger ni otro pipeline que mantener en funcionamiento. Los equipos obtienen el rendimiento que necesitan sin pagar por un segundo sistema.
Decidir cómo conectar cada fuente
Del mismo modo que no todos los workloads requieren el mismo grado de actualización de los datos, los equipos de datos no tienen por qué usar el mismo método para cada fuente. Algunos datos deben ingerirse y transformarse en Snowflake. Otros pueden permanecer en su sistema de registro y consultarse allí. Elegir cómo conectar cada fuente supone gestionar menos copias y mantener menos pipelines.
Para los datos que deban incorporarse a Snowflake, Snowflake Openflow está diseñado para conectar una amplia variedad de fuentes y admitir la ingestión a escala empresarial. Tanto si necesitas conectividad on‑premise mediante Data Connectivity Proxy (con disponibilidad general) como compatibilidad con más entornos de nube, Openflow puede ofrecer rendimiento, alcance empresarial y control operativo, con capacidades de observabilidad y resolución de problemas asistida por IA. La programación del entorno de ejecución y la suspensión automática también dan a los equipos más control sobre cuándo se ejecutan los workloads de integración.
Los equipos también necesitan formas de trabajar con los archivos que ya tienen en su entorno de almacenamiento. Zero-Copy Parquet permite utilizar los archivos Parquet existentes como Iceberg sin reescribir los datos de origen. Parquet Direct ofrece una vía independiente de solo lectura para consultar archivos Parquet allí donde se encuentran.
Para los datos que ya están en el sistema de registro en el que confías, las integraciones de copia cero de SAP Business Data Cloud, Workday Data Cloud y Salesforce están ahora en disponibilidad general. La integración de copia cero está diseñada para proporcionar acceso a los datos en su sistema de origen, lo que reduce la necesidad de crear pipelines de extracción para las analíticas o la IA. Los clientes de SAP pueden aprovechar los datos esenciales para su negocio en analíticas e IA y, al mismo tiempo, cumplir los requisitos de conectividad privada. La conectividad unidireccional mediante AWS PrivateLink entre SAP Business Data Cloud y Snowflake (próximamente en disponibilidad general) ayuda a los clientes a extender el contexto de negocio fiable de SAP al conjunto de sus datos empresariales para obtener resultados de negocio.
Estos modelos pueden coexistir en una misma arquitectura de datos. Por ejemplo, un ingeniero puede ingerir eventos operativos a través de Openflow, acceder a los datos de un partner en su ubicación original mediante una integración de copia cero y usar Spark para procesar archivos en Iceberg. Por tanto, para cada fuente hay que decidir si es necesario mover sus datos, cómo se utilizarán y qué controles deben aplicarse. Estas cuestiones son especialmente importantes en los sistemas transaccionales en los que se desarrolla la actividad de la empresa.
Sacar partido de los datos operativos en aplicaciones y agentes
Para que las aplicaciones y los agentes comprendan plenamente las empresas y tomen decisiones acertadas, es fundamental disponer de un contexto operativo actualizado. Sin embargo, la mayoría de las organizaciones siguen ejecutando las transacciones en un sistema y las analíticas en otro, con pipelines de ETL que trasladan los datos entre ambos. Estos pipelines añaden latencia y costes, además de otra tarea que los ingenieros deben mantener.
Para abordar este problema, presentamos Snowflake Postgres, que lleva a Snowflake la base de datos más popular del mundo. Junto con pg_lake, de código abierto, ayudó a sustituir los frágiles procesos de ETL de terceros por una forma más sencilla y eficiente de conectar tu patrimonio de datos. Ahora llevamos esa sencillez aún más lejos con la replicación de datos, una solución totalmente gestionada que convierte los datos transaccionales en información útil y esa información en acciones.
Es fácil de configurar: basta con un comando o unos pocos clics. La replicación de datos de Postgres (con disponibilidad general) replica continuamente tus tablas de Postgres en el resto de Snowflake para las analíticas y la IA. La replicación de datos de Snowflake (próximamente en vista previa pública) envía los datos en sentido contrario. Los perfiles de clientes enriquecidos y los resultados de las analíticas vuelven a Postgres, donde permiten crear agentes más inteligentes y experiencias más personalizadas.
Las aplicaciones empresariales internas creadas con Streamlit o Snowflake App Runtime ya se ejecutan en Snowflake y leen datos de Snowflake. Cuando esas aplicaciones también necesitan lecturas y escrituras transaccionales rápidas, las tablas híbridas reducen considerablemente la sobrecarga. Ahora, las tablas híbridas ofrecen una capacidad de procesamiento hasta 8 veces mayor. Esto significa que, para determinados workloads, lo que antes requería 8 almacenes XS ahora requiere uno, lo que puede reducir los costes en más de un 80 %.1 Snowflake también ha mejorado considerablemente la latencia de los workloads operativos que incluyen operaciones puntuales: la latencia P50 es 3 veces menor y la P99, aproximadamente 2 veces menor.2 Para los miles de clientes que ya utilizan tablas híbridas, las aplicaciones existentes son más rápidas y económicas sin necesidad de rediseñar su arquitectura.
Las tablas híbridas y Snowflake Postgres se complementan. Las tablas híbridas son la opción natural si quieres una integración profunda con otras capacidades de Snowflake sin una base de datos independiente. Snowflake Postgres es la opción adecuada cuando los equipos necesitan el ecosistema de Postgres o la menor latencia posible.
Crear una base que pueda adaptarse a las necesidades del trabajo
Cada agente, aplicación y decisión de tu empresa depende de datos actualizados y fiables. Pero para conseguirlo hacen falta pipelines probados y sistemas operacionales bien conectados. Ahora Snowflake reúne estas piezas para que la IA pueda encargarse de las tareas rutinarias durante el proceso.
Así, los ingenieros de datos pueden centrarse en desarrollar lo que vendrá después.
Explora todos los anuncios de Snowflake Expedition o participa en el evento virtual.
Preguntas frecuentes
P: ¿Cómo pueden ayudar los agentes de IA en el trabajo de ingeniería de datos?
R: Una vez que los pipelines son declarativos y están sujetos a control de versiones, los agentes de IA pueden asumir tareas operativas recurrentes, como comprobar el estado de los pipelines, rastrear las causas de los fallos y proponer soluciones para su revisión. Las automatizaciones de Snowflake CoCo ejecutan estos agentes de forma programada dentro de Snowflake, donde trabajan con el linaje, el catálogo y las políticas de gobernanza. Los cambios de código propuestos siguen pasando por el proceso de revisión habitual del equipo mediante la integración de CoCo con GitHub.
P: ¿Qué son las analíticas en tiempo real y en qué se diferencian de las analíticas por lotes?
R: Las analíticas en tiempo real procesan y ponen los datos a disposición de los usuarios pocos segundos después de su llegada, en lugar de esperar a que se ejecute una tarea por lotes programada. Esto importa cuando los agentes, los paneles o las aplicaciones orientadas al cliente necesitan información actualizada para tomar decisiones. Snowflake ofrece analíticas integrales en tiempo real en una sola plataforma: desde la ingesta de transmisión con Snowpipe Streaming (5 segundos de latencia a una velocidad de hasta 20 GB/s), pasando por la transformación, hasta la entrega de datos en menos de un segundo con Interactive Analytics, todo ello sobre las mismas tablas gobernadas que ya mantienen los equipos.
P: ¿Cómo simplifican las tablas dinámicas los pipelines de datos?
R: Las tablas dinámicas permiten a los equipos definir una transformación de forma declarativa, como una consulta, mientras Snowflake se encarga automáticamente de la programación, el procesamiento incremental y el orden de las dependencias. En lugar de escribir y mantener código ETL imperativo, describes el resultado que quieres y la plataforma lo mantiene actualizado. Las tablas dinámicas en dbt llevan esto directamente al marco de dbt, mientras que el procesamiento incremental personalizado te da un control total cuando lo necesitas.
P: ¿Cómo ayuda Snowflake a sustituir los procesos de ETL entre sistemas transaccionales y analíticos?
R: Tradicionalmente, las organizaciones ejecutan las transacciones en un sistema y las analíticas en otro, con pipelines de ETL entre ambos. La replicación de datos de Snowflake Postgres replica continuamente las tablas de Postgres en Snowflake para las analíticas y la IA con un solo comando. Las tablas híbridas cubren la necesidad inversa (lecturas y escrituras transaccionales rápidas dentro de Snowflake), de modo que las aplicaciones internas creadas con Streamlit o Snowflake App Runtime no necesitan una base de datos independiente.
P: ¿Qué papel desempeñan los formatos de tabla abiertos como Apache Iceberg en la ingeniería de datos?
R: Los formatos de tabla abiertos permiten a los equipos elegir sus motores de cómputo y mantener los datos en una única ubicación gobernada. Snowflake admite Apache Iceberg con ramificación, Time Travel y etiquetado, lo que ofrece a los ingenieros un proceso de escritura, auditoría y publicación: preparar los cambios en una rama aislada, validarlos y publicarlos o descartarlos. Esto es especialmente importante a medida que los agentes de IA empiezan a leer y escribir en las mismas tablas que los pipelines: cada cambio cuenta con una pista de auditoría gobernada.
1 Comparación de la capacidad de procesamiento y los costes basada en pruebas de rendimiento de workloads de tablas híbridas en producción, realizadas antes y después de las mejoras de rendimiento. Para alcanzar una capacidad de procesamiento equivalente, antes hacían falta 8 almacenes XS y después, uno. El ahorro de costes es potencial y depende del workload.
2 Comparación de la latencia basada en pruebas de rendimiento en producción, realizadas antes y después de las mejoras de rendimiento. Los resultados dependen del workload.

10 sept 2026Estrategia e información
Autonomous Data Engineering: 5 Stages to Genuine Agentic Maturity
19 oct 2026Data Engineering
The Path to Autonomous Data Engineering: Fixing Data Pipeline Failures with AI
10 jun 2026Producto y tecnología
Data Engineering in the AI Era: New Snowflake Tools Built for Smart Pipelines

