10 settembre 2026/Lettura: 7 minStrategia e insight
Data engineering autonomo: 5 fasi verso una vera maturità agentica
Il data engineering è un lavoro difficile: svegliarsi con esecuzioni fallite da analizzare per ore, gestire un backlog costante di richieste ed esigenze dei team di business, rispondere ai team finance che vogliono sapere perché il costo di tutte queste pipeline continua a salire. E sotto molti aspetti l’AI lo rende ancora più difficile: porta volumi e tipologie di dati sempre più diversi e permette a molte più persone in azienda di usare quei dati tramite agenti AI di coding e di chat capaci di scrivere SQL al posto loro. La maggior parte dei team di data engineering cerca di stare al passo adottando i propri agenti AI di coding, ma sembra comunque accumulare sempre più ritardo.
Un report di MIT Technology Review intitolato "Redefining Data Engineering in the Age of AI" ha rilevato che, sebbene 8 organizzazioni su 10 abbiano implementato strumenti di data engineering basati sull'AI, i data engineer si trovano a gestire anche una maggiore complessità, con le sfide principali segnalate rappresentate dalla garanzia della sicurezza e della privacy dei dati (55%).
Serve un cambiamento più radicale. Invece di affidarsi all’AI per velocizzare i processi esistenti, è il momento di ripensare i processi stessi e andare oltre la creazione e la manutenzione manuale delle pipeline. I team dati avranno più tempo per concentrarsi sul risultato del data engineering, i data product, anziché sul processo di trasformazione dei dati grezzi passo dopo passo. Per i team diventerà fondamentale garantire che i dati siano pronti all’uso sia per le persone sia per l’AI, con contesto e governance intatti.
Il futuro del data engineering dipenderà dalla capacità di creare data product concreti e utilizzabili, in grado di alimentare le decisioni di business, e di affidare ad agenti AI davvero autonomi lo sviluppo, la manutenzione e l’ottimizzazione di tutto ciò che serve a mantenerli aggiornati, con le persone nel ruolo di decisori e arbitri chiave.
Questi agenti AI monitoreranno i nuovi prodotti necessari, i problemi e i malfunzionamenti di quelli esistenti e cercheranno opportunità di miglioramento, pulizia e ottimizzazione.
Le persone resteranno naturalmente essenziali, ma il loro ruolo si eleva: definire i problemi di business più importanti, guidare gli agenti AI verso l’architettura complessiva corretta e assicurarsi che il contesto aziendale sia catturato in modo adeguato per gli agenti AI che consumano i data product.
I lavori “professionalizzati” dall'AI stanno crescendo a un ritmo doppio rispetto ai lavori “democratizzati” dall'AI, con una crescita salariale del 42% più rapida dal 2021.
Fonte: PwC AI Jobs Barometer 2026
Il percorso verso il data engineering autonomo
È un cambiamento profondo: i team non possono arrivarci dall’oggi al domani, né dovrebbero provarci. Meglio decidere che questo è l’obiettivo giusto e poi avvicinarsi in modo incrementale e ragionato. A ogni passo i team scopriranno di più su ciò che agenti AI e modelli sono in grado di fare e acquisiranno fiducia su quanto si può automatizzare in sicurezza e su dove servono ulteriori controlli, strumenti o processi human-in-the-loop (HITL). Molte aziende hanno già iniziato: ogni team che ha adottato un ciclo di vita software-defined, il controllo delle versioni, pipeline dichiarative o lo sviluppo assistito dall’AI ha già fatto un passo verso il futuro.
La curva di maturità del data engineering autonomo
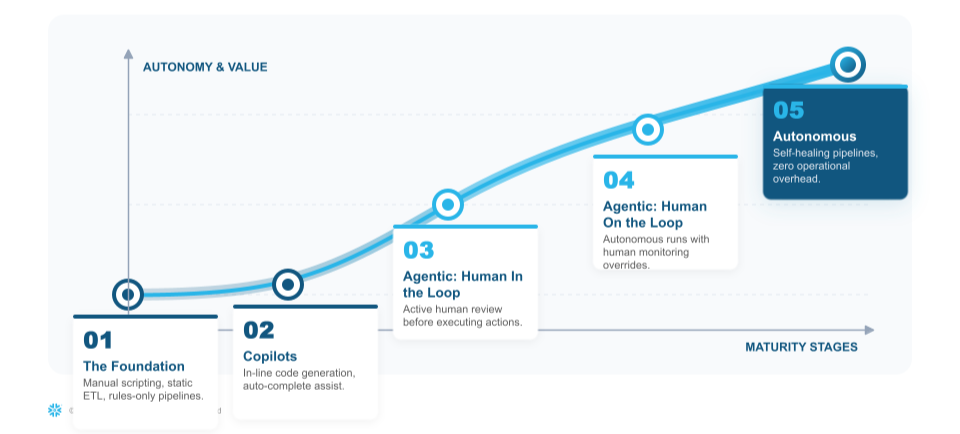
| Fase 1: Le fondamenta |
In questa fase i data engineer sviluppano e mantengono le pipeline manualmente. Ogni modifica dello schema, ogni decisione di orchestrazione e ogni risposta a un errore richiede lavoro umano. I team che sfruttano la Fase 1 per mettere a punto i fondamentali dell’engineering avranno più successo nelle fasi successive. Il passaggio a pratiche di data engineering più moderne, come le pipeline dichiarative, può migliorare l’efficienza. Travelpass, per esempio, ha reso i propri processi di data engineering più accessibili, aiutando il team a scalare e a distribuire dati alle business unit con un’efficienza superiore di oltre il 350%. |
| Fase 2: Copilot |
Qui l’AI entra nell’editor. Autocomplete e generazione di codice inline riducono le frizioni di trasformazione e configurazione, ma ogni decisione resta in mano agli engineer. Il workflow di fondo non è cambiato, anche se l’output è aumentato. |
| Fase 3: AI agentica: human in the loop |
Nella Fase 3 l’AI inizia a diventare un collaboratore. Gli agenti AI possono proporre modifiche, come cambiamenti alle pipeline, correzioni di errori e migrazioni di schema, ma nessuna operazione è eseguita senza un’approvazione umana esplicita. Gli engineer revisionano il codice anziché scriverlo, il che contribuisce a ridurre drasticamente i tempi di risposta agli incidenti. |
| Fase 4: AI agentica: human on the loop |
È qui che i vantaggi dell’automazione iniziano davvero a emergere. Gli agenti AI agiscono in autonomia su task selezionati e chiaramente definiti, come rilevare anomalie e adattare le pipeline alle modifiche a monte, senza attendere approvazioni. Gli engineer mantengono l’observability su ciò che fanno gli agenti AI e possono annullarne le azioni quando necessario. |
Fase 5: |
Nella Fase 5 il data engineering ha cambiato radicalmente il significato di lavorare con i dati. Le pipeline rilevano da sole i propri errori, individuano le cause alla radice in tutto lo stack, applicano correzioni, validano i risultati e documentano le modifiche senza intervento umano. L’overhead operativo si avvicina allo zero. I data engineer definiscono policy, standard e semantica di business. Decidono anche cosa la piattaforma può fare in autonomia e cosa richiede il loro giudizio, così le modifiche a forte impatto passano alla revisione umana. Il loro ruolo passa completamente dall’esecuzione alla governance: da costruttori di pipeline a veri business partner. |

Fare tutto esclusivamente in Snowflake ha rappresentato una svolta. Ora progettiamo qualcosa di giovedì e martedì è già in produzione."
Thomas Bodenski
COO e Chief Data & Analytics Officer, TS Imagine
Ridefinire la creazione dei data product nell’era agentica
Uno dei grandi cambiamenti che lo rendono possibile è il passaggio dal ragionare in termini di data pipeline al ragionare in termini di data product, che comprendono non solo i dati ma anche semantica, qualità e tutto ciò che serve a un agente AI per portare a termine i propri task con quei dati. Per esempio, un data product sulla fedeltà dei clienti può includere dati sul rischio di churn, che abbinano l’attività di ogni singolo account a una vista semantica che definisce cosa l’azienda considera “a rischio”, insieme a controlli di qualità documentati. Qualsiasi agente AI o analista che accede a questo data product ottiene così una risposta coerente e affidabile per le proprie iniziative di fidelizzazione dei clienti.
Il modello tradizionale parte dall’infrastruttura e procede verso l’alto: sviluppare la data foundation, definire gli schemi, creare le pipeline e infine soddisfare un’esigenza di business. Un approccio che funzionava quando i data product erano pochi e stabili.
I team dati moderni lo percorrono al contrario: Partire dal problema di business e individuare il workflow dell’agente AI che lo risolve. Stabilire di quali dati ha bisogno quell’agente AI e sviluppare il data product che li fornisce. Così il patrimonio di dati si riorganizza intorno ai risultati di business anziché ai livelli tecnici e nasce un approccio verticale ai data product, in cui le pipeline sono progettate per i risultati, non per gli schemi.
Nel vero data engineering autonomo, la piattaforma conta tanto quanto la scelta del framework di agenti AI. I team ad alte prestazioni devono prima consolidare controllo delle versioni, test automatizzati e pipeline CI/CD, le stesse best practice che i team dati più efficaci adottano da anni. Governance, interoperabilità e dati unificati sono le condizioni che permettono di affidarsi con sicurezza a workflow autonomi.
Sviluppa le fondamenta e il data engineering autonomo seguirà
Il passaggio al data engineering autonomo è una necessità operativa. I team che raggiungeranno la maturità più rapidamente non ci arriveranno perché avevano i modelli migliori. Ci arriveranno perché hanno elevato il ruolo del data engineer a business partner e hanno sviluppato una data foundation abbastanza solida perché gli agenti AI autonomi possano operarvi, con una governance abbastanza affidabile da potersi fidare di loro.
Per avere successo in questo percorso, i clienti devono puntare su una piattaforma che non solo risponda alle esigenze di oggi, ma continui a evolversi e ad assorbire le nuove innovazioni sia nel data engineering sia nell’AI, senza dover integrare o sviluppare tutto da sé. Scopri come Snowflake sta definendo lo standard per misurare qualità ed efficienza dei token nel lavoro di data engineering autonomo con Data-eng-benchmark.
Per una guida pratica su come iniziare con il data engineering autonomo, con pattern architetturali, framework di governance e le pratiche di engineering che rendono affidabili i workflow agentici, leggi Creare pipeline per l’AI: la guida essenziale a un data engineering più intelligente.
4 febbraio 2026Prodotto e tecnologia
Snowflake acquisisce TensorStax e accelera l’agentic AI per il data engineering

4 settembre 2026AI e ML
Build Reproducible Data Pipelines with CoCo, Snowflake's AI Coding Agent
18 marzo 2026Prodotto e tecnologia
Guidare l’era dell’Agentic Enterprise

