19 ottobre 2026/Lettura: 5 minData engineering
Il percorso verso il data engineering autonomo: risolvere gli errori delle pipeline di dati con l’AI
Per anni, un guasto a una pipeline in Snowflake ha seguito sempre lo stesso schema: Qualcuno riceveva un avviso. Analizzava i log, risaliva alla causa principale, scriveva una correzione, la testava e apriva una pull request (PR). E la notte dopo, tutto da capo.
Oggi, è un agente AI a eseguire questo schema per noi. Indaga su ogni guasto monitorato delle pipeline e passa dal rilevamento dell’incidente a una PR pronta per la revisione in meno di 16 minuti in media. Ecco come abbiamo fatto e cosa è cambiato per il nostro team.
Il problema che continuava a peggiorare
Sono data scientist nel team dati interno di Snowflake e ho visto il numero delle nostre pipeline crescere, passando da una quantità gestibile da una sola persona a qualcosa di davvero ingestibile.
Più pipeline può sembrare un buon problema: più dati, più valore. Ma ogni nuova pipeline è un nuovo punto di rottura, e ogni nuova dipendenza è una cosa in più che può guastarsi alle 2 di notte. Il nostro volume di guasti non stava aumentando perché le nostre pipeline stavano peggiorando. Stava aumentando perché ne avevamo di più, mentre il nostro team non cresceva allo stesso ritmo.
Cosa volevamo davvero costruire
La maggior parte degli strumenti si ferma all’avviso: Qualcosa si è rotto. Vai a controllare. Volevamo un agente AI in grado di spiegare il problema e contribuire a risolverlo. Questo significa gestire l’intero ciclo:
- Analizzare costantemente le pipeline per individuare code smell e problemi di performance.
- Individuare i guasti in modo proattivo, prima che si aggravino.
- Analizzare log e codebase per identificare la probabile causa principale.
- Testare le correzioni proposte prima che qualcosa arrivi in produzione.
- Aprire una PR chiara e completa di contesto, in modo che una persona possa revisionarla ed eseguire il merge rapidamente.
Quest’ultimo requisito è il più importante. L’agente AI propone la correzione. È sempre una persona a decidere cosa viene rilasciato.
Come l’abbiamo costruito
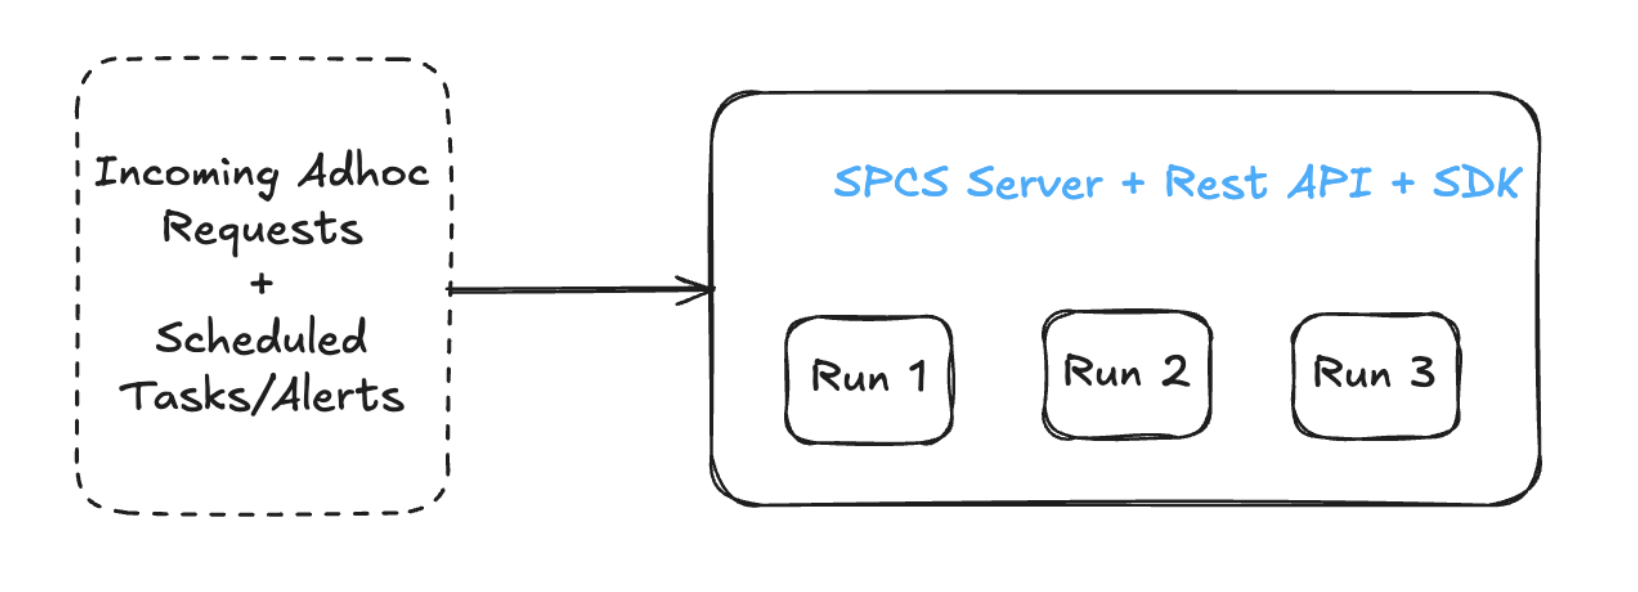
Abbiamo valutato diverse architetture prima di trovare quella giusta. La nostra prima idea è stata un server Snowpark Container Services che eseguiva una REST API: autonomo, con tutto in un unico posto. Ma significava essere limitati dal numero di esecuzioni gestibili da un singolo server.
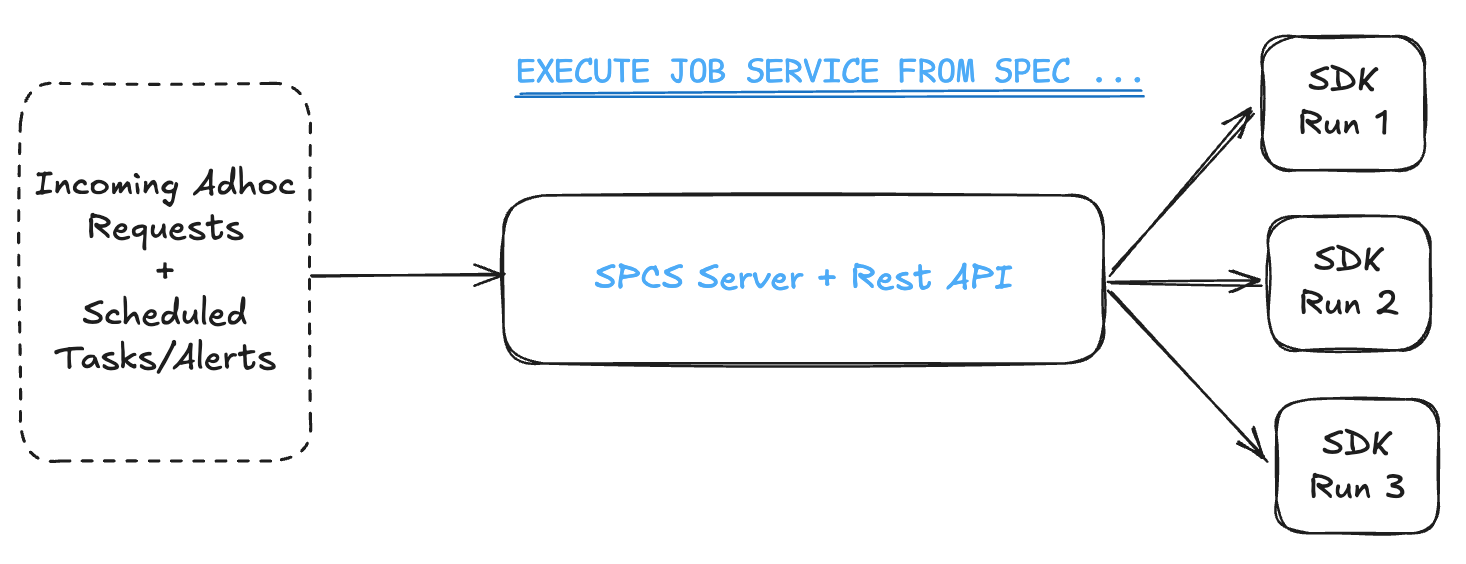
Questo ci ha permesso di scalare fino a molti agenti AI diversi in esecuzione in parallelo, senza essere limitati da un singolo server.
In futuro, prevediamo di andare oltre e di utilizzare il nuovo EXECUTE AGENT TASK di CoCo automations (ora in Public Preview) per semplificare e scalare ulteriormente le nostre esecuzioni.
Nessun server da gestire. Nessun pool di calcolo condiviso. Una singola chiamata SQL attiva l’esecuzione di un agente AI. Snowflake si occupa del resto.
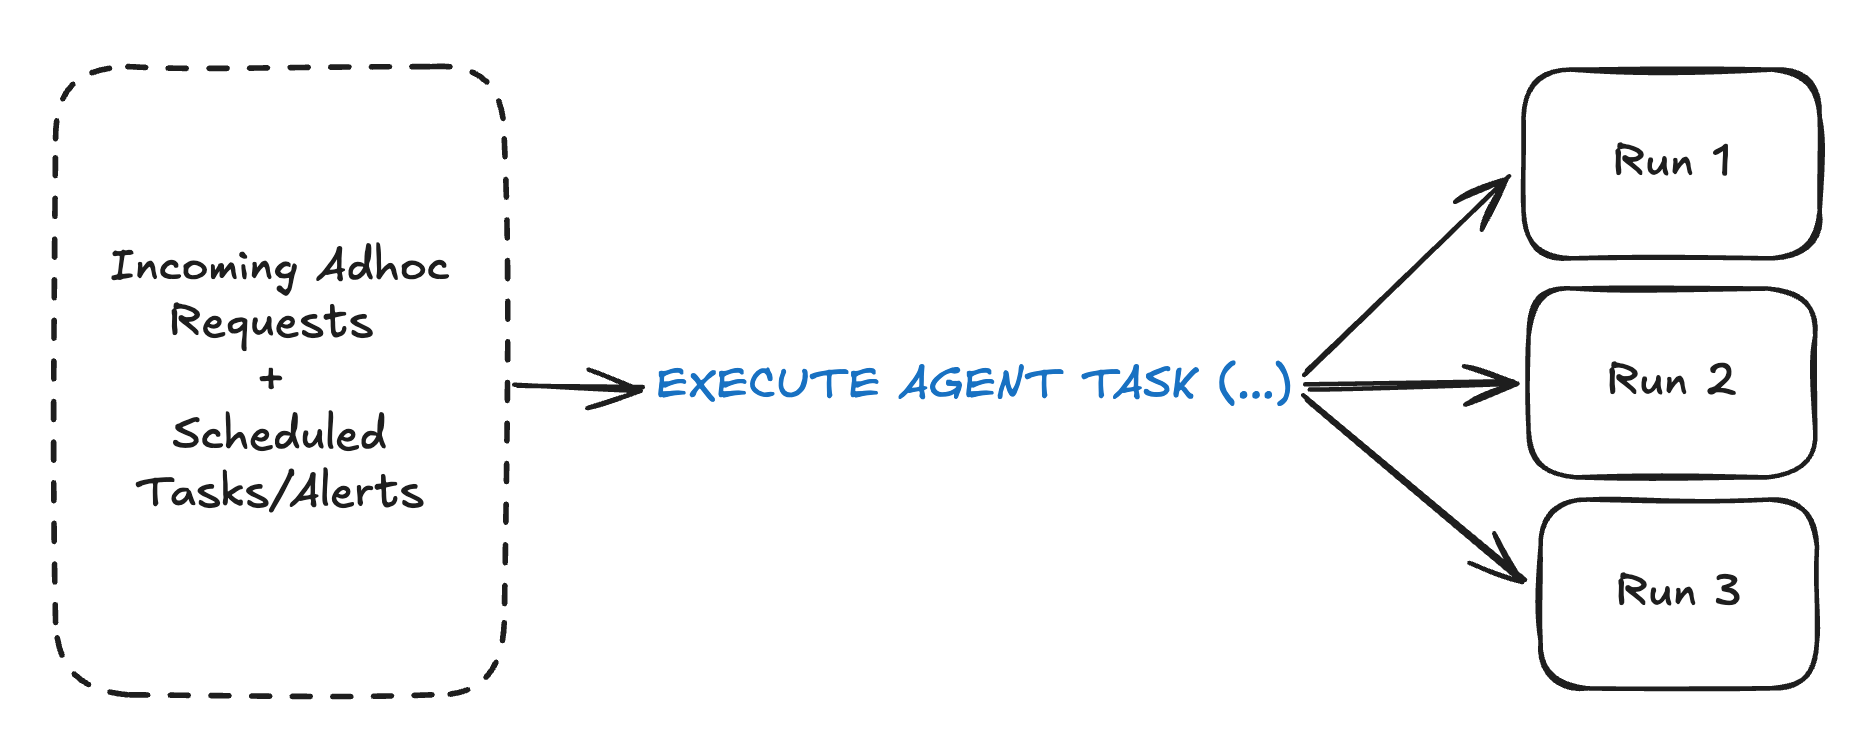
Avevamo bisogno di un modo flessibile per definire un workflow con istruzioni basate su template. Per questo, i workflow sono definiti in JSON. Si specifica il file delle istruzioni, a quali repository l’agente AI può accedere, un turn budget, quale modello eseguire e dove inviare le notifiche al termine del lavoro.
{
  "name": "fix-broken-pipeline",
  "owner": "your.name@snowflake.com",
  "agent": {
    "turns": [{"file": "org/repo:path/to/instructions.md"}],
    "model": "opus",
    "max_turns": 50
  },
  "repos": [{"repo": "org/repo", "branch": "main"}],
  "timeout_minutes": 30,
  "notifications": {
    "slack_channel": "#data-eng-alerts",
    "emails": ["your.name@snowflake.com"]
  }
}
Eseguirlo richiede solo SQL:
CALL RUN_WORKFLOW('fix-broken-pipeline', '{"pipeline_id": "12345"}')

CREATE TASK SCHEDULE = '12 hours' AS
  CALL RUN_WORKFLOW('code-smells')
Il task gestisce i tempi. L’agente AI gestisce il lavoro. Questi workflow possono essere molto semplici, oppure possiamo combinare più workflow semplici con il feedback umano per creare workflow più complessi.
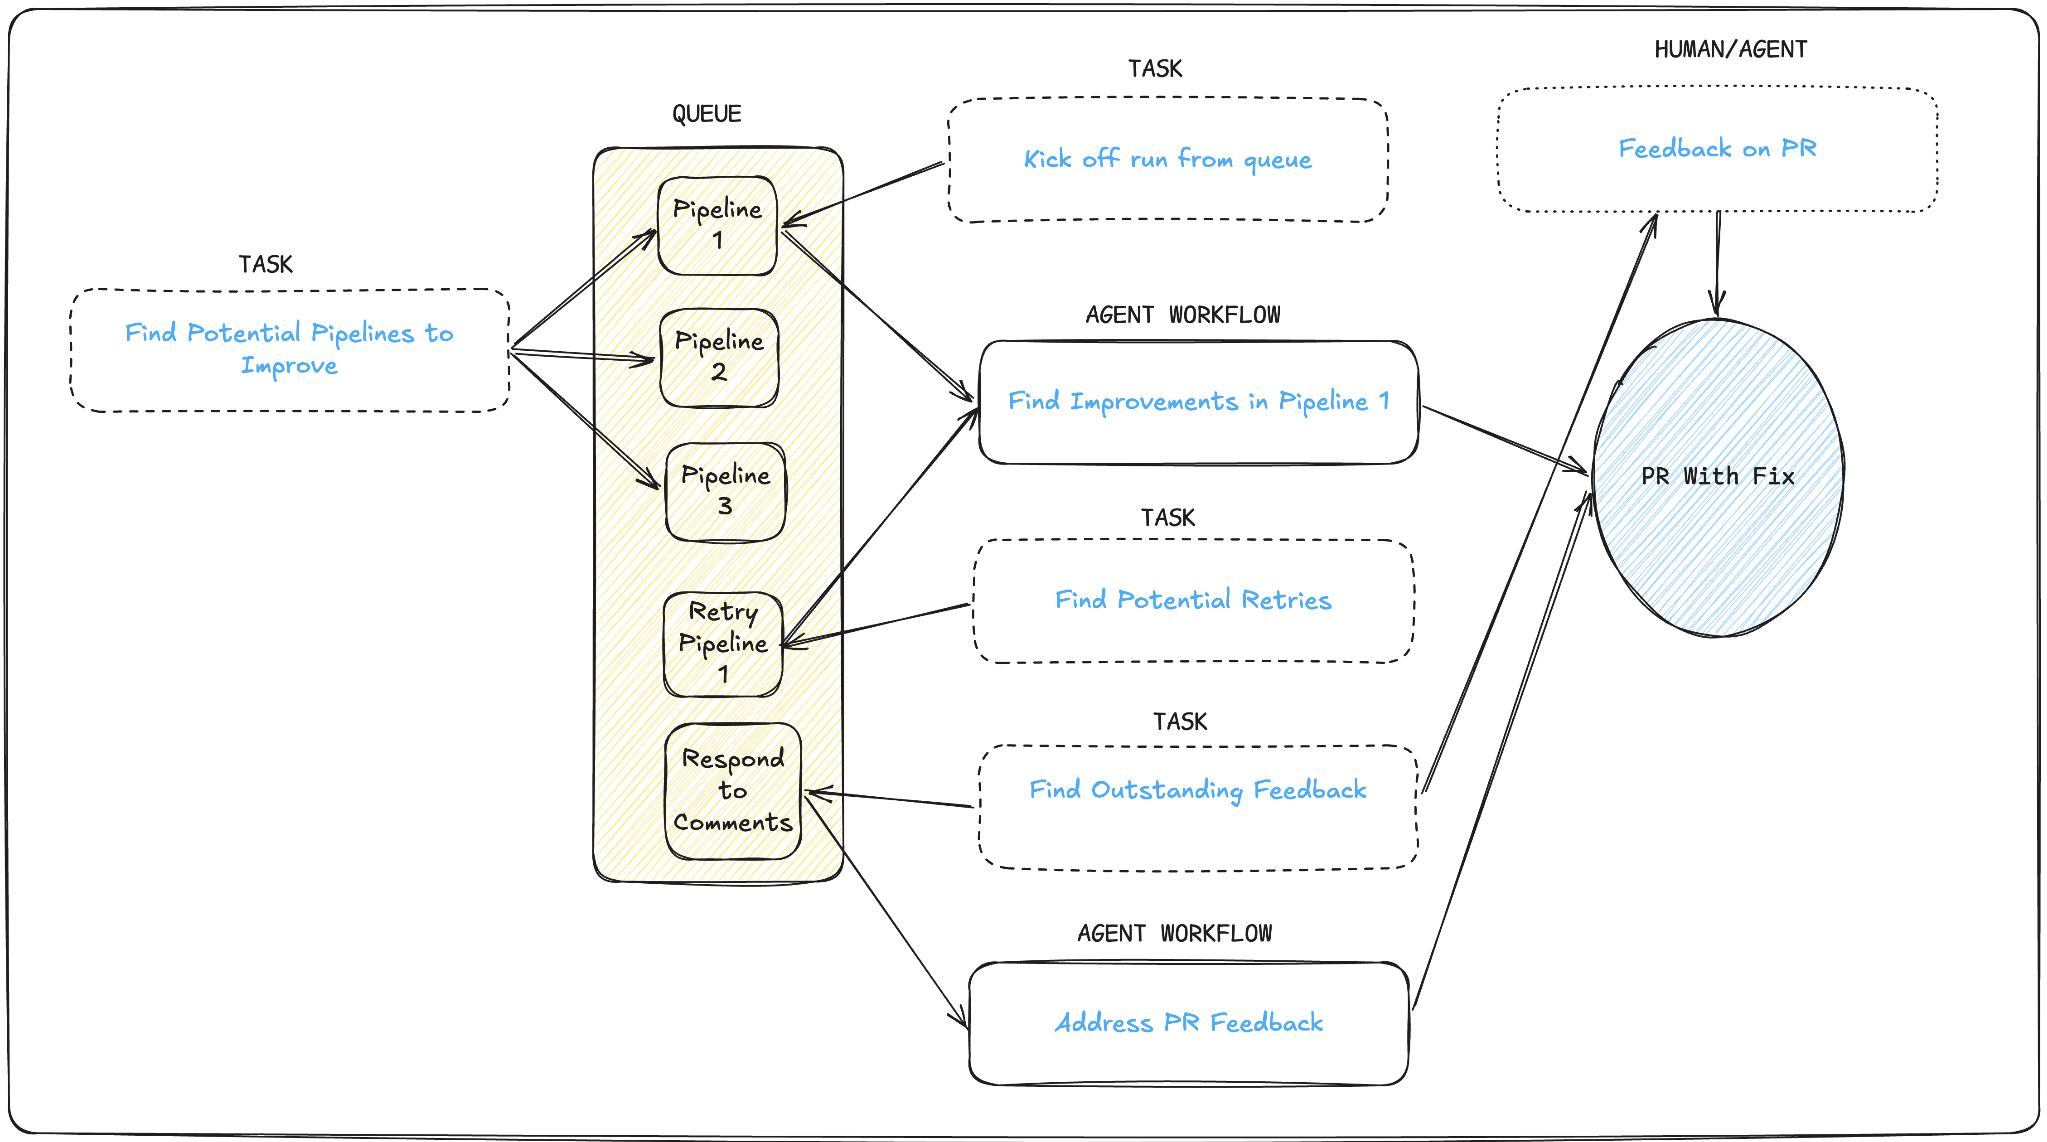
L’impatto: indagini complete sui guasti
Lo utilizziamo in produzione e, negli ultimi cinque mesi, sulle pipeline gestite dal nostro team, abbiamo registrato:
- Una copertura quasi completa del triage per i guasti delle pipeline monitorate. Progettato per analizzare ogni guasto, non solo quelli più evidenti.
- Meno di 16 minuti dal rilevamento dell’incidente alla creazione della PR.
- Merge di centinaia di PR.
- Oltre 500 pipeline migliorate.
- Centinaia di crediti sprecati ogni giorno, risparmiati grazie ai miglioramenti delle pipeline.
Quest’ultimo numero è particolarmente importante. Lo spreco di calcolo dovuto a pipeline poco performanti si accumula in modo invisibile. La maggior parte dei team non se ne accorge mai, perché richiede che qualcuno lo verifichi proattivamente, ma i nostri agenti AI osservano costantemente.
Data engineering autonomo
Questo lavoro è diventato una fonte di ispirazione diretta per ciò che il nostro team di prodotto porterà ai clienti. Scopri di più sulla nostra visione del data engineering autonomo qui.
Dichiarazioni previsionali
questo articolo contiene delle affermazioni riferite al futuro, tra cui offerte future di prodotto, che però non rappresentano un impegno a fornire alcuna offerta di prodotto. Le offerte e i risultati effettivi potrebbero essere diversi ed essere soggetti a incertezze e rischi noti e non noti. Per maggiori informazioni, consulta il nostro ultimo modulo 10-Q.
