2026년 10월 20일/12분 읽음데이터 엔지니어링
단일 테이블에서 41 GB/sec 달성: Snowpipe Streaming Elastic Channels 벤치마크
Snowflake라는 이름은 창립자들이 스키를 무척 좋아해서 붙였다는 이야기가 있습니다. 그렇다면 새로운 Elastic Channels를 테스트하는 데 스키 리조트의 한 시즌 전체 매출 데이터를 처리해 보는 것만큼 어울리는 방법도 없겠죠.
애플리케이션이 성장하고 연결되는 디바이스가 늘어나면, 분석과 AI를 위해 데이터를 Snowflake로 가져올 간편한 방법이 필요합니다. 최근 Snowflake는 Elastic Channels for Snowpipe Streaming의 GA를 발표했습니다. 이 기능을 사용하면 Snowflake가 수집 규모를 관리하는 동안 애플리케이션, 디바이스, 서비스에서 이벤트를 직접 전송할 수 있습니다. 그렇다면 이렇게 간소화된 방식은 데이터 양이 늘어날 때 어떤 성능을 보일까요?
이를 확인하기 위해 합성 리조트 매출 워크로드를 만들고 독립 프로듀서 수를 늘려 총 처리량 41 GB/sec를 달성했습니다. 이 벤치마크는 대상을 Snowflake FDN(네이티브) 테이블로 설정해 실행했으며, Snowflake 관리형 Apache Iceberg™ 테이블에서도 반복했습니다. 이 게시물에서는 부하가 증가함에 따라 처리량과 데이터 최신성이 어떻게 달라졌는지, 그리고 이러한 결과가 실제 워크로드에 어떤 의미를 갖는지 살펴봅니다.
배경
Snowpipe Streaming은 정확히 한 번 처리 시맨틱(exactly-once semantics)을 엄격히 보장하고, 메시지 순서를 철저히 유지합니다. 변경 데이터 캡처(CDC), 금융 거래, 재고 관리처럼 미션 크리티컬한 워크로드에서는 명시적 채널 관리, 오프셋 추적, 고객 측 스키마 조정까지 포함한 이러한 정교한 기록 관리가 필수입니다.
하지만 최소 한 번(at-least-once) 전달만으로 충분한 텔레메트리 파이프라인, 사물 인터넷(IoT) 디바이스 네트워크, 대용량 로그 분석을 구축한다면, 이런 추가 오버헤드는 불필요한 부담이 될 수 있습니다. Elastic Channels를 도입한 이유가 바로 여기에 있습니다. 채널 수명 주기 관리와 오프셋 기록 관리의 복잡성을 제거하기 위해서입니다. Snowflake가 확장과 채널 분산을 자동으로 처리하도록 하면, 요구 조건이 덜 엄격한 데이터 스트림을 엔지니어링 부담 없이 매우 빠르게 수집할 수 있습니다.
이전 버전의 Snowpipe Streaming에서는 클라이언트가 파일 배치마다 컬럼형 데이터와 메타데이터를 생성하고, 이를 업로드한 뒤 처리를 위해 Snowflake에 등록해야 했습니다. 2025년 Snowflake는 고성능 아키텍처를 출시했습니다. 서버 측 PIPE 오브젝트, Rust 기반 SDK 코어, 그리고 클라이언트 측 부담의 상당 부분을 제거한 재설계된 수집 경로로 구성된 아키텍처입니다. 고성능 아키텍처에서는 이제 클라이언트가 JSON 페이로드를 생성해 Snowflake로 전송하기만 하면 됩니다. Snowflake는 이 JSON 페이로드를 수락한 뒤, 확장성이 뛰어난 Snowpipe 인프라에서 실행되는 PIPE를 통해 데이터를 비동기적으로 처리합니다. 이러한 변화로 클라이언트의 컴퓨팅 및 메모리 오버헤드가 크게 줄어 배포가 단순해졌습니다. Elastic Channels(client.get_elastic_channel())는 고성능 아키텍처를 기반으로 합니다. 하나의 SDK 클라이언트가 채널 이름이나 오프셋 관리 없이 풀링된 채널을 자동으로 열고, 동일한 고성능 파이프에 기록합니다.
이번 테스트에서 확인하려던 것은 단순했습니다. Elastic Channels는 실제로 얼마나 빠르게, 또 얼마나 효율적으로 데이터를 처리할 수 있을까?
결과는 놀라웠습니다. 최적화된 클라이언트 설계와 수평 확장된 Kubernetes 플릿을 통해, 총 코어 수와 메모리, 작업자 프로세스 수를 더 적게 사용하면서도 업계에 공개된 유사한 페타바이트급 수집 벤치마크보다 지속 집계 처리량이 이전 버전 대비 3.5배 이상 높다는 것을 확인했습니다.
한눈에 보는 결과
Elastic Channels를 적용한 Snowpipe Streaming은 단일 FDN Snowflake 테이블에 대해 455개의 경량 Kubernetes 워커, 455 vCPU, 455 GiB 메모리만으로 41.8 GB/sec(초당 1억 3,350만 행)의 지속 처리량을 기록했습니다. 이는 이전 버전의 Snowpipe Streaming보다 3.5배 이상 높은 수치이며, 모든 테스트 단계에서 오류 없이 선형 확장을 보였습니다.
최대 처리량(비압축) |
41.8 GB/sec |
최대 행 처리률 |
초당 1억 3,350만 행 |
워커 수 |
455(Elastic 채널 1개) |
컴퓨팅 리소스 사용량 |
455 vCPU · 455 GiB 메모리 |
Kubernetes 노드 |
m7g.8xlarge(Graviton) 15개 |
이전 Snowpipe Streaming 대비 |
처리량 3.5배 이상 증가 |
테스트 구성
오픈소스 벤치마크 하니스(snowflake-elastic-channels)를 구축해 snowpipe-streaming Python SDK를 직접 실행했습니다.
- 간단한 배포: 워커 포드 하나에 SDK 클라이언트 하나와 Elastic Channel 하나를 구성하고 공유 RESORT_SALES_PIPE에 연결합니다.
- 전송률 및 처리량 설정: 지정된 시간 동안 워커별 목표 전송률을 설정하고, 전체 처리량은 모든 포드의 합계로 계산합니다.
- 실시간 옵저버빌리티: 클러스터 상주 모니터는 실행이 진행되는 동안 워커 로그를 추적하고, 처리량 및 지연 시간 측정값을 Snowflake(
ELASTIC_K8S_METRICS)에 기록합니다. - 타입 지정 랜딩:
MATCH_BY_COLUMN_NAME = CASE_SENSITIVE는 JSON 키를 단일VARIANTblob이 아닌 테이블 컬럼에 직접 매핑합니다. - 구성 가능한 적재 대상: 데이터는 FDN 테이블 또는 Apache Iceberg 테이블에 랜딩됩니다.
아래의 모든 측정값은 2026년 9월 us-west-2의 Amazon EKS에서 수평 확장 테스트를 수행에 얻은 실제 수치입니다. 압축되지 않은 바이트와 행 수는 SDK와 모니터가 관찰한 값을 그대로 보고하며, 외삽은 사용하지 않았습니다.
워크로드: 프로덕션 규모의 합성 리조트 매출 데이터
Kafka, S3 또는 퍼블릭 데이터 세트에서 읽어오면 프로듀서 한계가 개입되어 Snowpipe Streaming 자체의 성능을 가리게 됩니다. 그래서 외부 병목을 제거하기 위해 프로세스 내에서 데이터를 생성했습니다.
선택한 사용 사례는 합성 스키 리조트 포트폴리오 전반의 판매 시점(POS) 거래였습니다. 42개 리조트, 4개 제품 카테고리(시즌권, 일일권, 식음료, 상품), 결제 방식, 고객 유형, 리조트별 가격 등급이 포함되었습니다. 모델의 단일 테이블 스키마는 다음과 같습니다.
TXID, RESORT, CATEGORY, ITEM, CUSTOMER_TYPE, PAYMENT_METHOD,
QUANTITY, UNIT_PRICE, AMOUNT, SALE_TIME, RUN_ID, WORKER_ID
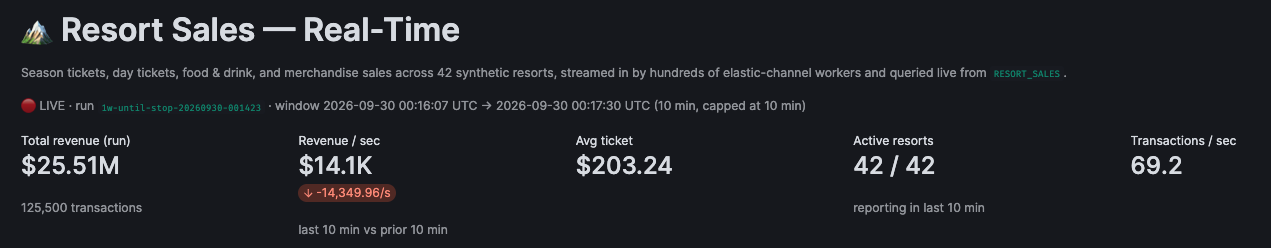
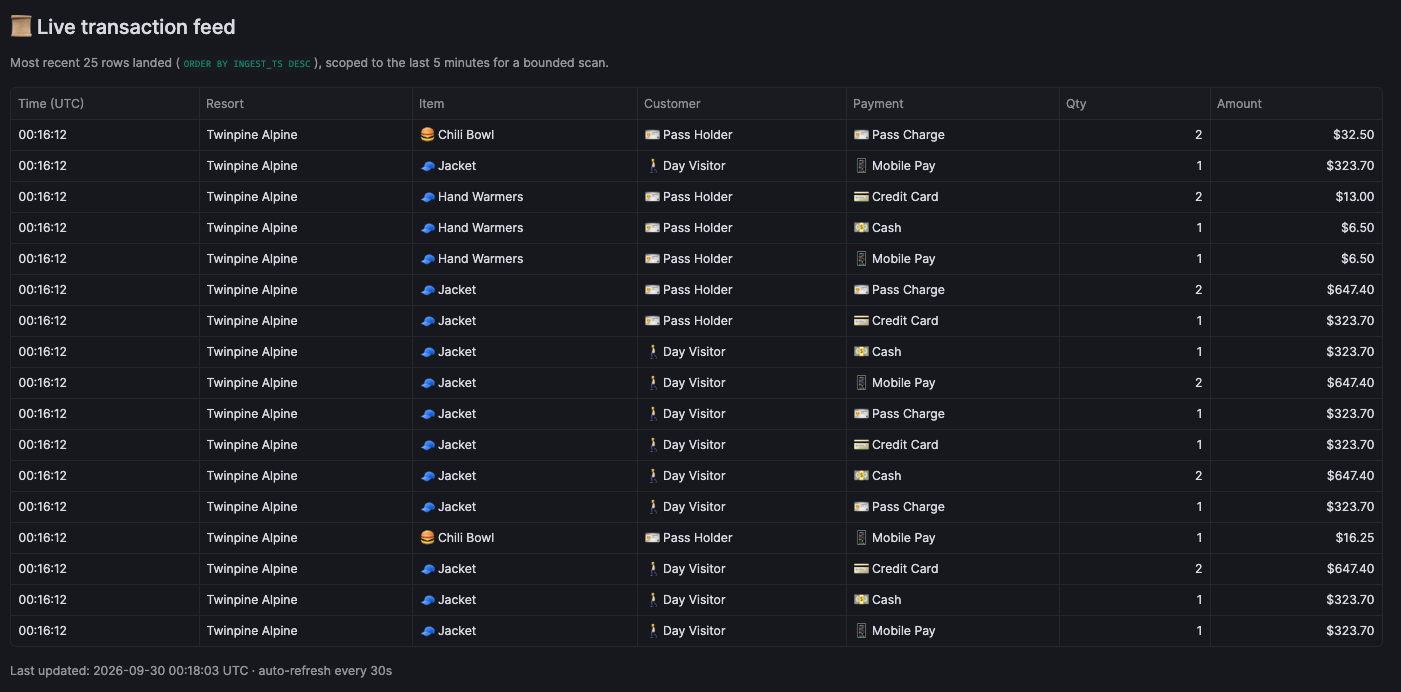
각 리조트에는 상대 규모, 카테고리 구성, 가격 등급, 패스 보유자 비중으로 구성된 결정론적 매출 프로필이 있습니다. 따라서 리조트별 매출, 구성 변화, 지리적 패턴 같은 집계 분석이 균일한 랜덤 노이즈가 아니라 현실적인 모습으로 나타납니다. 리포지토리의 Streamlit 대시보드는 바쁜 연휴 주말에 전국 리조트 체인을 지켜보는 것처럼 실시간 피드를 시각화합니다.
의도적으로 단일 리조트 POS가 생성할 수 있는 수준을 훨씬 뛰어넘어 실행했습니다. 목적은 분명했습니다. POS의 현실성을 재현하는 것이 아니라 Snowflake 수집 용량을 분리해 측정하는 것이었습니다. 행 평균 크기는 비압축 NDJSON 기준 ~277바이트였습니다. 생성은 핫 경로에서 RNG 미사용 방식으로 수행했습니다. 사전 구축된 가중치 테이블을 라운드 로빈 방식으로 인덱싱했기 때문에, 목표 처리량에서 클라이언트가 병목이 되지 않았습니다.
리조트 경영진이 각 리조트의 판매 현황과 매출, 고객 행동을 실시간으로 모니터링할 수 있도록 Streamlit 대시보드도 제공했습니다. 판매 시점 거래는 1분이 훨씬 안 되는 시간에 대시보드에 반영되었습니다.
Kubernetes 배포
벤치마크는 영구 EKS 클러스터(snowflake-elastic-channels)에서 실행했습니다. 워커 노드는 실행마다 확장되고 이후 다시 0으로 축소되었습니다. 작은 시스템 노드와 모니터 배포만 항상 켜진 상태로 유지했습니다.
아키텍처
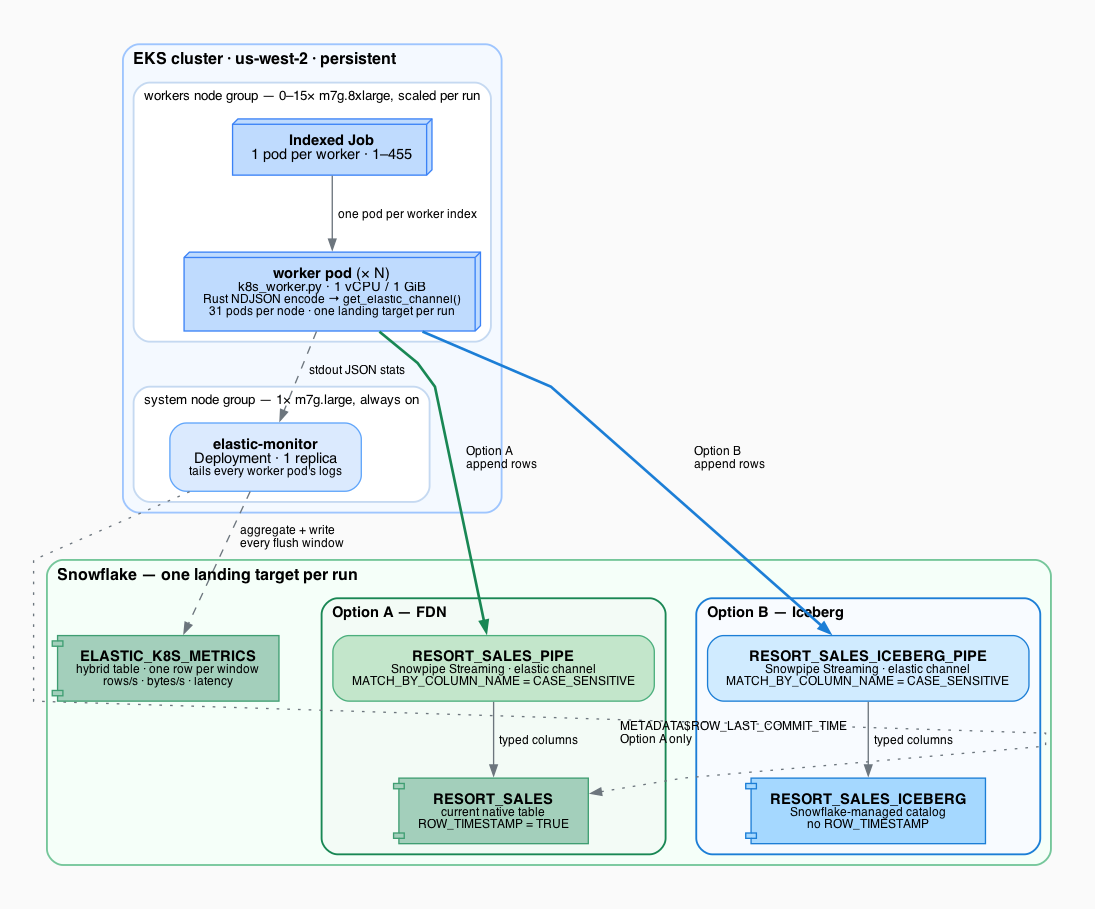
벤치마크 파라미터
| 파라미터 | 수치 |
|---|---|
| 워커 포드 | 455 |
| 채널 | 1개(공유, Elastic) |
| 워커 CPU 요청/제한 | 1 vCPU |
| 워커 메모리 요청/제한 | 1 GiB |
| 노드당 워커 수 | 31(m7g.8xlarge, Graviton arm64) |
| 최대 시점의 워커 노드 | 15 |
| 총 워커 vCPU | 455 |
| 총 워커 메모리 | 455 GiB |
| 메시지 형식 | NDJSON(타입 지정 컬럼 매핑) |
| 평균 행 크기(비압축) | ~277바이트 |
| 고속 인코딩 경로 | ELASTIC_FAST_JSON_ENCODE=true(기본값) |
| SDK | snowpipe-streaming Python 패키지 |
| 수집 파이프 | RESORT_SALES_PIPE → RESORT_SALES |
워커 포드는 측정된 정상 상태 사용량을 기준으로 적정 규모로 조정되었습니다. CPU가 노드 패킹의 주요 제약입니다. 1,000m가 전체 1 vCPU에 해당하고 이 값이 할당되었지만, 실제 필요 CPU는 약 240m~540m였습니다. 메모리 사용률은 1Gi가 할당된 상태에서 RSS 기준 68~183MiB로 관측되었습니다. m7g.8xlarge 하나에서는 메모리 여유를 충분히 남기면서 노드당 워커 31개를 스케줄링할 수 있습니다.
성능 결과
FDN에서의 최대 지속 처리량
| 지표 | 수치 |
|---|---|
| 지속 처리량(비압축) | 41.8 GB/sec |
| 지속 행 처리율 | 초당 1억 3,350만 행 |
| 최대 시점의 워커 수 | 455 |
| 워커당 처리량 | 약 92MB/초(초당 약 29만 3,000행), 워커 15개부터 455개까지 사실상 일정 |
| 스로틀링 | 관측되지 않음 |
Snowpipe Streaming과의 비교
Summit 2024에서 Snowflake는 Snowpipe Streaming 이전 버전으로 단일 테이블에 총 약 10GB/초 규모의 데이터 수집을 시연했습니다. 당시로서는 이정표가 된 결과였습니다. 이번 벤치마크는 새로 출시된 Elastic Channels 기능을 사용하는 고성능 Snowpipe Streaming에서 실행했습니다. 그 결과 FDN과 Snowflake 관리형 Apache Iceberg 테이블 모두에서 이전 벤치마크 대비 3.5배를 넘는 처리량을 달성했습니다.
| Summit 2024 당시 데모(근사치) | FDN 테이블 대상 HP + Elastic Channels | Snowflake 관리형 Apache Iceberg 테이블 대상 HP + Elastic Channels | |
|---|---|---|---|
| 처리량(비압축) | 약 10GB/초 | 41.8 GB/sec | 39.0GB/초 |
| 행 처리율 | 초당 약 3,900만 행¹ | 초당 1억 3,350만 행 | 초당 1억 2,160만 행 |
| 속도 향상 | — | > 3.5배 |
¹ 이 워크로드의 행 형태와 맞추기 위해 행당 약 277바이트로 추정했습니다.
수평 확장(EKS 스케일아웃)
처리량은 모든 단계에서 워커 수를 거의 정확히 따라갔으며, 정체 구간 없이 깔끔한 선형 확장을 보였습니다. 처리량이 증가하는 동안에도 지연 시간은 제한된 범위 안에 머물렀습니다. 배치 ack(SDK future 완료)은 모든 단계에서 평균 약 600ms 수준을 유지했습니다. 배치 ack 시간은 클라이언트가 데이터를 SDK로 전송한 시점부터 콜백을 수신할 때까지의 전체 시간입니다(데이터가 영속화된 상태). 수집 후 조회 가능 지연 시간(SALE_TIME → METADATA$ROW_LAST_COMMIT_TIME)은 약 12~29초 범위에 머물렀습니다. 초당 1억 3,350만 행에서도 데이터는 랜딩 후 몇 초 안에 쿼리 가능했습니다. 이는 데이터가 쿼리에 포함되기까지 걸리는 시간입니다.
| 워커 수 | 노드 | 초당 행 수 | 처리량 | 평균 배치 ack | 평균 수집 후 조회 가능 시간² |
|---|---|---|---|---|---|
| 15 | 1 | 4.4M | 1.38GB/초 | 582ms | 11.7초 |
| 90 | 3 | 26.6M | 8.27GB/초 | 595ms | 14.0초 |
| 180 | 6 | 52.8M | 16.52GB/초 | 611ms | 16.7초 |
| 300 | 10 | 87.8M | 27.50GB/초 | 572ms | 17.7초 |
| 420 | 14 | 123.2M | 38.6GB/초 | 587ms | 28.9초 |
| 455 | 15 | 133.5M | 41.84GB/초 | 570ms | 19.9초 |
² 수집 후 조회 가능 지연 시간은 클러스터 모니터가 ELASTIC_K8S_METRICS에서 TIMESTAMPDIFF(SALE_TIME, METADATA$ROW_LAST_COMMIT_TIME)로 측정했습니다.
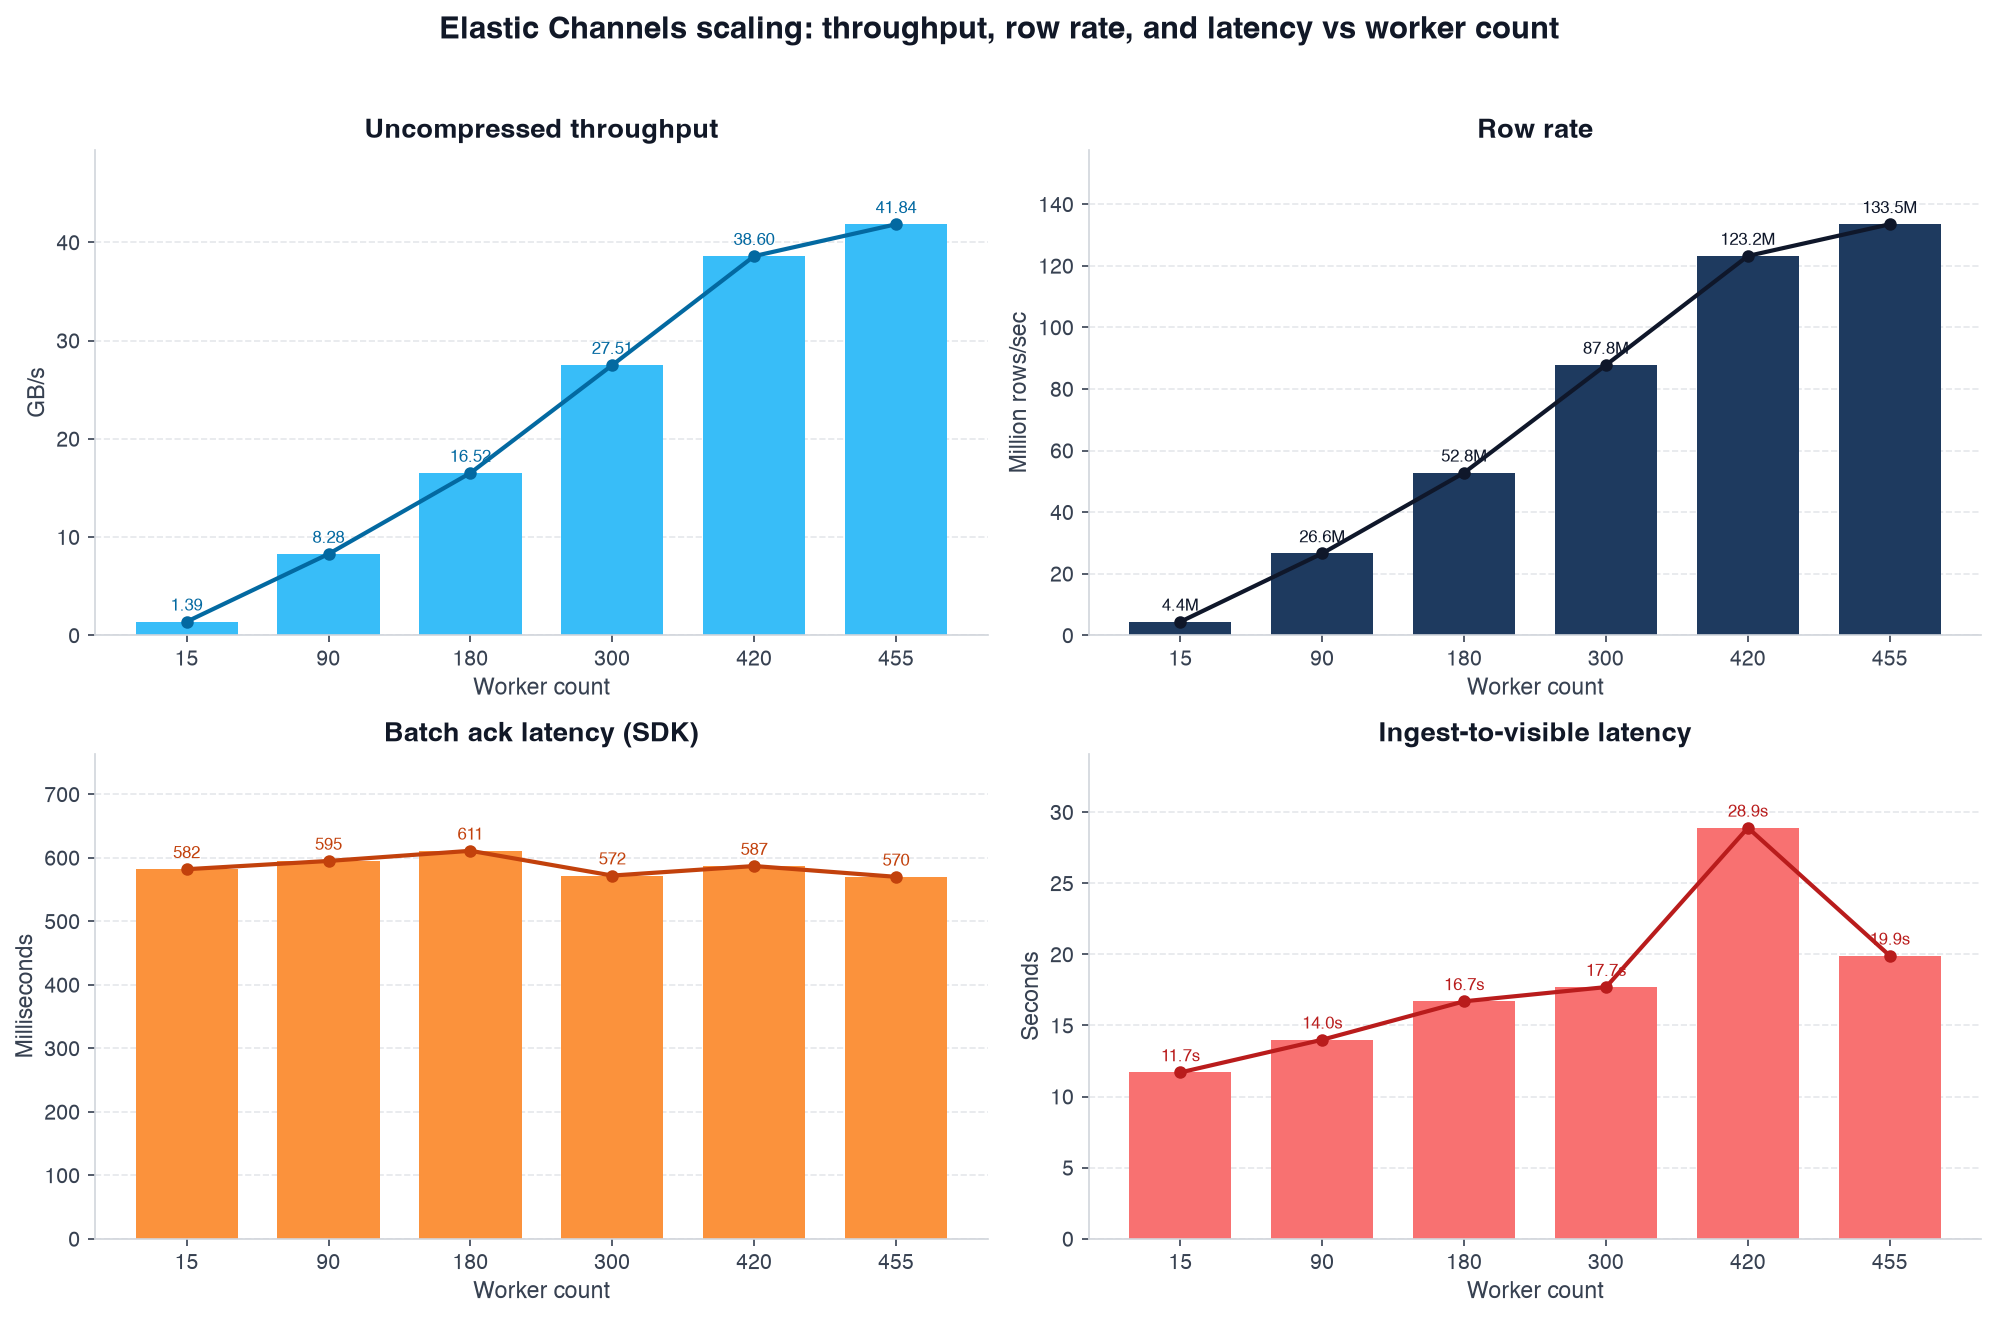
두 가지 지연 시간 지표는 서로 다른 질문에 답합니다.
- 배치 ack 지연 시간(평균 약 570~611ms)은 “SDK가 해당 배치를 얼마나 빠르게 수락했는가?”라는 질문에 답합니다. 이는
append_rows()부터 SDK future가 완료될 때까지 클라이언트 측에서 측정됩니다. 15개에서 455개 워커까지 전체 구간에서 이 값은 거의 변하지 않았으며, 클라이언트가 Snowflake가 다음 배치를 흡수하기를 기다리는 일은 없었습니다. - 수집 후 조회 가능 지연 시간(평균 약 12~29초)은 “이 행을 언제 쿼리할 수 있는가?”라는 질문에 답합니다. 이는 서버 측에서
SALE_TIME→METADATA$ROW_LAST_COMMIT_TIME로 측정됩니다. 대시보드와 운영 분석에서 중요한 수치는 바로 이것입니다. 처리량에 비례해 증가하지 않았습니다. 행 처리율이 30배 증가해도 쿼리 가능해지는 데 걸리는 시간이 30배 늘어나지는 않았으며, 캠페인 전반에서 준실시간 리조트 매출 대시보드에 실용적인 범위를 유지했습니다.
확장의 핵심 레버는 수평 확장입니다. 더 큰 포드가 아니라 경량 워커 포드를 추가하는 방식입니다. 테스트 결과, 개별 워커에 CPU를 더 할당해도 처리량은 늘지 않았습니다. 1 vCPU / 1 GiB pod는 각각 독립적으로 동일한 약 0.086 GiB/sec를 기여했습니다.
피크 시점의 리소스 효율성
핵심 수치를 업계에서 일반적으로 사용하는 페타바이트 규모 스트리밍 벤치마크 구성과 나란히 비교하면 효율성이 분명해집니다.
| 일반적인 대규모 스트리밍 벤치마크³ | Snowpipe Streaming Elastic Channels에서 FDN 테이블로 | Snowpipe Streaming Elastic Channels에서 Snowflake 관리형 Apache Iceberg 테이블로 | |
|---|---|---|---|
| 동시 워커 수 | 2,048 | 455 | 455 |
| 워커당 코어 수 | 1.5 | 1.0 | 1.0 |
| 워커당 메모리 | 2 GiB | 1 GiB | 1 GiB |
| 전체 워커 코어 수 | 3,072 | 455 | 455 |
| 총 워커 메모리 | 4,096 GiB | 455 GiB | 455 GiB |
| 지속 처리량 | 약 12 GB/sec | 약 41.8 GB/sec | 약 39.0 GB/sec |
| 지속 초당 행 수 | 약 12M | 133.5M | 121.6M |
³ 수천 개의 Kubernetes 프로듀서 pod와 네이티브 바이너리 행 인코더를 사용하는 24시간 페타바이트 규모 단일 테이블 수집 벤치마크의 대표 공개 파라미터입니다.
저희는 코어를 약 1/7만, 메모리를 1/9만, 워커 프로세스를 1/4 미만으로 사용하면서도, FDN과 Apache Iceberg 테이블을 모두 대상으로 초당 바이트 수는 3배 이상, 초당 행 수는 10배 이상을 달성했습니다.
Snowpipe Streaming의 진화 과정
이 프로젝트는 많은 Snowflake 스트리밍 평가가 시작되는 지점에서 출발했습니다. 호스트당 수십 개의 워커가 있는 대형 EC2 인스턴스, 명시적 채널, 그리고 매 배치마다 생성되는 Python 행 dict가 그 출발점이었습니다. 이러한 실행은 의미 있는 결과를 남겼습니다. Snowflake보다 훨씬 앞서 클라이언트 측 한계를 드러냈기 때문입니다.
| 시기 | 측정한 내용 | 제한 요인 |
|---|---|---|
| Snowpipe Streaming 이전 버전(Summit 2024 데모) | 스테이지에서 약 10 GB/sec, 초기 램프업에서는 호스트당 1 GB/sec 미만 | 채널/오프셋 오버헤드, 클라이언트 측 컬럼화 및 메타데이터, 기존 SDK 아키텍처 |
| 고성능 아키텍처(2025년 출시) | 대형 인스턴스당 약 2~8 GB/sec, EC2 멀티 노드에서 지속 약 16 GB/sec | 호스트당 네트워크, 워커/채널 관리, Python 인코딩 경로 |
| Elastic Channels + EKS + Rust 인코딩 | 455개 워커에서 41.8 GB/sec | 이 테스트에서는 제한 요인이 없었으며, 지원 범위 전반에서 선형 확장이 확인되었습니다. |
세 가지 변화가 맞물렸습니다.
- Elastic Channels:
get_elastic_channel()이 모든 채널을 하나의 클라이언트 아래에서 풀링합니다. 애플리케이션 코드는 더 이상 이름과 오프셋을 관리하지 않습니다. - 적정 세밀도의 Kubernetes: 워커당 pod 1개, 각각 1 vCPU, Graviton 노드당 pod 31개를 배치했습니다. 프로세스가 아니라 플릿을 확장합니다.
- 생성 및 인코딩을 위한 Rust 빠른 경로: 아래에서 설명하듯 Python은 핫 루프가 아니라 오케스트레이션을 담당합니다.
Elastic Channels 도입을 비롯한 Snowpipe Streaming 개선으로 Snowflake에 데이터를 전송하는 방식은 그 어느 때보다 향상되었습니다. Snowpipe Streaming 고성능 아키텍처를 사용하면 확장 가능한 서버리스 인프라에서 대량의 데이터를 빠르고 쉽게 수집하고, 소스에서 몇 초 만에 쿼리할 수 있습니다. 요금 청구도 간단하며, 수집된 기가바이트 기준으로 이루어집니다. 현재 시장에서 스트리밍 데이터를 쿼리하는 데 이보다 더 쉽고 확장성 높은 방법은 없습니다.
데이터 인코딩에 Rust를 사용한 이유
워커당 초당 수십만 행을 처리하는 수준에서는 Python dict 할당과 JSON 직렬화가 CPU 사용량을 지배합니다. SDK의 기본 경로는 행 dict를 받아 내부에서 다시 인코딩합니다. 방식 자체는 정확하지만, 이미 스키마를 알고 있다면 중복 작업입니다.
워커의 CPU와 메모리를 가장 효율적으로 사용하기 위해 데이터 생성과 직렬화를 Rust에서 수행했습니다. 이 방식은 SDK의 내부 메서드를 사용합니다. 이러한 메서드는 향후 변경될 수 있어 업그레이드가 복잡해질 수 있습니다.
저희는 Rust에서 행 생성과 NDJSON 직렬화를 모두 수행하는 선택적 네이티브 확장(native/, PyO3 + maturin으로 빌드해 워커 Docker 이미지에 포함)을 추가했습니다.
- 행별 Python 오브젝트 건너뛰기: 행마다
dict를 만들지 않고, 핫 경로에서msgspecstruct 왕복도 발생하지 않습니다. - SDK의 두 번째 인코딩 건너뛰기:
fast_append.py가 사전 직렬화된 바이트를 Elastic Channel의 FFI append에 직접 전달하여append_rows_with_wait내부의encode_lines패스를 우회합니다. - Python과 바이트 단위 동일성 유지:
native/generate_tables.py는 모든 가중치 테이블과 사전 포맷된 가격 문자열을resort_sales.py자체에서 도출합니다. Rust는 확정된 데이터를 재생할 뿐, 비즈니스 로직을 다시 구현하지 않습니다. 단위 테스트를 통해 네이티브 경로와 Python 경로가 동일한 NDJSON을 생성하는지 검증합니다.
UNIT_PRICE와 AMOUNT는 코드 생성 시점에 Python의 json.dumps 포맷팅을 통해 십진수 문자열로 내장됩니다. 따라서 실제로 발생하는 제한된 (item, tier, quantity) 조합에 대해 Rust와 Python의 부동소수점 포맷팅이 어긋날 일이 없습니다.
wheel이 설치되어 있지 않으면 하네스는 자동으로 Python의 msgspec 인코딩으로 폴백합니다. 프로덕션 벤치마크 실행에서는 Rust가 기본으로 활성화됩니다(ELASTIC_FAST_JSON_ENCODE=true).
그 결과, 각 1 vCPU 워커는 SDK의 네트워크 I/O에 사용할 CPU 여유를 남긴 상태로 약 0.086 GiB/sec를 지속 처리합니다. 이 워커당 처리량이 455개 워커까지의 선형 확장을 가능하게 합니다.
테스트에서 확인한 점
- Elastic Channels는 통합이 간단합니다.
get_elastic_channel()을 호출하고, 행(또는 사전 인코딩된 바이트)을 append하면 끝입니다. - 처리량은 워커 수에 따라 선형으로 확장됩니다. 15개에서 455개 워커까지 확장할 수 있었고, 곡선의 꺾임이나 스로틀링은 관찰되지 않았습니다.
- 적정 규모 pod가 대형 pod보다 효과적입니다. 인코딩이 병목이 아니라면 1 vCPU / 1 GiB로 충분합니다.
- 합성 워크로드는 꼼수가 아니라 기능입니다. 결정론적 인프로세스 생성은 I/O 편향을 제거하고 실행을 재현 가능하게 만듭니다. 데이터 소스가 아니라 아키텍처를 비교할 때 이는 매우 중요합니다.
- 클라이언트 측 최적화는 여전히 중요합니다. Rust 서버 코어를 사용하더라도 클라이언트 CPU를 절반으로 줄이면 호스트당 감당할 수 있는 Stream 수가 대략 두 배로 늘어납니다.
Elastic Channels 데모 보기
Snowflake의 Elastic Channels를 IoT 활용하는 사례를 동영상으로 확인해 보세요.
직접 체험해 보기
최소 구성으로 엔드투엔드 실행을 재현하는 데 필요한 모든 항목은 리포지토리에 있습니다. 파이프라인을 검증하는 데 455개 워커가 필요하지는 않습니다. 단일 Elastic Channel을 1분만 실행해도 연결성, 파이프 구성, 라이브 지표를 확인하기에 충분합니다.
1. 클론하고 구성하기
git clone https://github.com/snowflake-labs/snowflake-elastic-channels.git
cd snowflake-elastic-channels
pip install -r requirements.txt
cp .env.example .env   # Snowflake account, user, key-pair auth
python scripts/setup_elastic_ramp.py --ingest-ip <YOUR_INGEST_IP>
2. 일회성 EKS 설정 수행(로컬 마이크로 벤치마크만 실행하려는 경우 건너뛰기)
./infra/eks/create_cluster.sh
./infra/eks/build_and_push.sh
./infra/eks/create_secret.sh
./infra/eks/allowlist_eks.sh
./infra/eks/deploy_monitor.sh
3. 단일 워커 및 단일 채널 스모크 테스트 실행
./infra/eks/run_job.sh quicktest-$(date +%Y%m%d%H%M%S) \
    --target-bps 100000000 \
    --duration-seconds 60 \
    --workers 1
Snowflake에서 실시간 처리량을 확인하세요.
SELECT *
FROM SC_DB.SC_SCHEMA.ELASTIC_K8S_METRICS
WHERE RUN_ID = '<your-run-id>'
ORDER BY WINDOW_START;
더 큰 규모로 테스트할 준비가 되면 --workers에 1~455 사이의 값을 지정할 수 있으며, 노드 그룹은 자동으로 크기를 조정합니다.
4. 로컬 클라이언트 전용 벤치마크 실행(Snowflake 불필요)
python scripts/benchmark_client_cpu.py --workers 1 --aggregate-mbps 100리포지토리
GitHub에서 확인할 수 있습니다.
| 경로 | 목적 |
|---|---|
src/elastic_channels/k8s_worker.py |
워커 포드 진입점 |
src/elastic_channels/resort_sales.py |
합성 POS 행 생성기 |
native/ |
Rust NDJSON 고속 인코더 |
infra/eks/run_job.sh |
스케일아웃 벤치마크 오케스트레이터 |
streamlit/Monitor_App.py |
실시간 처리량 및 지연 시간 대시보드 |
docs/architecture.md |
전체 시스템 설계 |
유의 사항
- 이 결과는 클러스터링되지 않은 단일 테이블에서 단일 Snowflake 계정, 단일 리전(
us-west-2), 단일 합성 행 형태(약 277바이트 NDJSON 행)를 기준으로 합니다. 행 너비, 파이프 정의, 계정 제한은 환경에 따라 달라질 수 있습니다. - 3.5배 초과 비교 기준은 Summit 2024에서 시연된 Snowpipe Streaming(약 10GB/초)입니다. 이 벤치마크는 Elastic Channels와 함께 2025년에 출시된 고성능 아키텍처를 사용합니다. 행 크기는 동일하게 약 277바이트로 가정했지만, 조건을 통제해 두 테스트를 나란히 재현한 것이 아니라 성능 향상 추세를 보여 주는 비교입니다.
- 대부분의 스케일아웃 단계에서는 반복 테스트가 아닌 단일 측정을 수행했습니다.
- 이 글에서는 비용 분석을 다루지 않습니다. 처리량 기반 Snowpipe Streaming 요금은 수집된 비압축 데이터 양에 적용되며 사용 사례별로 계산할 수 있습니다.
- 이러한 규모의 데이터를 처리하려면 계정 담당 팀이나 지원 팀에 문의해 계정 용량을 늘려야 합니다.
