2026年10月20日/約3分で読めますデータエンジニアリング
1つのテーブルで41GB/秒を達成:Snowpipe StreamingのElastic Channelsのベンチマーク
Snowflakeという社名は、創業者がスキーをこよなく愛していたことに由来するという噂があります。そのため、新しいElastic Channelsをテストするにあたり、スキーリゾートの1シーズン分の売上データをシステムに投入するのは当然のことのように感じられました。
アプリケーションが成長し、より多くのデバイスがオンラインになるにつれて、アナリティクスやAIのためにデータをSnowflakeに取り込むシンプルな方法が必要になります。先日、Snowpipe StreamingのElastic Channelsの一般提供を発表しました。これにより、Snowflakeが取り込みのスケールを管理する一方で、アプリケーション、デバイス、サービスから直接イベントを送信できるようになります。しかし、データ量が増加した場合、このシンプルな経路はどのようなパフォーマンスを発揮するのでしょうか。
この疑問を探求するため、合成のリゾート売上ワークロードを作成し、独立したプロデューサーの数を増やして、合計41GB/秒のスループットを達成しました。このベンチマークは、Snowflake FDN(ネイティブ)テーブルを宛先として実行し、SnowflakeのマネージドApache Iceberg™テーブルでも同じテストを繰り返しました。本記事では、負荷の増加に伴ってスループットとデータの鮮度がどのように変化したか、そしてその結果がお客様のワークロードにとって何を意味するのかを検証します。
背景
Snowpipe Streamingは、厳密なexactly-onceセマンティクスと厳格なメッセージ順序付けを提供します。変更データキャプチャ(CDC)、金融取引、在庫管理などのミッションクリティカルなワークロードにおいて、明示的なチャネル管理、オフセット追跡、クライアント側のスキーマ調整を伴う、このような細心の注意を払った記録は不可欠です。
しかし、at-least-onceの配信で十分なテレメトリパイプライン、IoTデバイスネットワーク、または大量のログアナリティクスを構築している場合、そのような余分なオーバーヘッドはすべて不要な摩擦となる可能性があります。だからこそ、チャネルのライフサイクル管理とオフセット記録の複雑さを排除するために、Elastic Channelsを導入しました。スケーリングとチャネルの分散をSnowflakeに自動的に処理させることで、エンジニアリングのオーバーヘッドなしに、軽量なデータストリームの超高速な取り込みを実現できます。
以前のバージョンのSnowpipe Streamingでは、クライアントがファイルのバッチごとに列指向データとメタデータを生成し、それをアップロードしてSnowflakeに登録して処理する必要がありました。2025年、Snowflakeは高パフォーマンスアーキテクチャをリリースしました。これには、サーバー側のPIPEオブジェクト、RustベースのSDKコア、およびクライアント側の負担の多くを取り除いた再設計された取り込みパスが含まれます。高パフォーマンスアーキテクチャによりクライアントが変更され、JSONペイロードを生成してSnowflakeに送信するだけで済むようになりました。SnowflakeはこれらのJSONペイロードを受け取り、高度にスケーラブルなSnowpipeインフラストラクチャで実行されているPIPEを使用して、このデータを非同期に処理します。これらの変更により、クライアントからコンピュートとメモリのオーバーヘッドが大幅に削減され、展開が簡素化されました。Elastic Channels(client.get_elastic_channel())は、高パフォーマンスアーキテクチャに基づいて構築されており、1つのSDKクライアントがチャネル名やオフセット管理なしでプールされたチャネルを自動的に開き、同じ高パフォーマンスパイプに書き込みます。
このテストで私たちが答えを出そうとした疑問は、次のようなシンプルなものでした。Elastic Channelsは実際にどれくらい速く、どれくらい効率的に機能するのか。
その答えは私たちを驚かせるものでした。最適なクライアント側の設計と水平にスケーリングされたKubernetesフリートにより、業界の他の場所で公開されている同等のペタバイト規模の取り込みベンチマークよりも少ない合計コア数、少ないメモリ、はるかに少ないワーカープロセスで、以前のバージョンの3.5倍以上の持続的な合計スループットを測定しました。
概要
Elastic Channelsを使用したSnowpipe Streamingは、455個の軽量Kubernetesワーカーを455vCPUと455GiBのメモリで使用し、単一のFDN Snowflakeテーブルに対して41.8GB/秒(1億3,350万行/秒)を維持しました。これは以前のバージョンのSnowpipe Streamingの3.5倍以上であり、テストされたすべてのステップでエラーゼロと線形スケーリングを実現しました。
ピークスループット(非圧縮) |
41.8GB/秒 |
ピーク行レート |
1億3,350万行/秒 |
ワーカー |
455(1つのElasticチャネル) |
コンピュートフットプリント |
455vCPU・455GiBメモリ |
Kubernetesノード |
15×m7g.8xlarge(Graviton) |
以前のSnowpipe Streamingとの比較 |
3.5倍以上のスループット |
テスト内容
snowpipe-streaming Python SDKを直接実行するオープンソースのベンチマークハーネス(snowflake-elastic-channels)を構築しました。
- シンプルな展開:1つのワーカーポッド=1つのSDKクライアント=共有のRESORT_SALES_PIPEに対する1つのElasticチャネル。
- レートとスループットの構成:固定期間におけるワーカーあたりのターゲットレート。合計スループットはポッド全体の合計です。
- ライブオブザーバビリティ:クラスター常駐のモニターがワーカーのログを追跡し、実行中にスループット/レイテンシーのウィンドウをSnowflake(
ELASTIC_K8S_METRICS)に書き込みます。 - 型付きランディング:
MATCH_BY_COLUMN_NAME = CASE_SENSITIVEは、JSONキーをテーブルの列に直接マッピングします(単一のVARIANTBLOBではありません)。 - 構成可能な宛先:データはFDNテーブルまたはApache Icebergテーブルにランディングします。
以下のすべての効果測定は、2026年9月にus-west-2のAmazon EKSでの水平スケールアウトから得られた実際の数値です。SDKとモニターによって観察された非圧縮バイト数と行数を報告します。外挿はありません。
ワークロード:本番環境規模の合成リゾート売上
Kafka、S3、またはパブリックデータセットからの読み取りでは、プロデューサーの制限が生じ、Snowpipe Streaming自体ができることが不明確になります。そのため、外部のボトルネックを取り除くために、プロセス内でデータを作成しました。
選択したユースケースには、合成スキーリゾートのポートフォリオ全体にわたる販売管理(POS)トランザクションが含まれていました。42のリゾート、4つのプロダクトカテゴリ(シーズンチケット、1日チケット、飲食、商品)、支払い方法、顧客タイプ、およびリゾートごとの価格帯。モデルの単一テーブルのスキーマは次のとおりです。
TXID, RESORT, CATEGORY, ITEM, CUSTOMER_TYPE, PAYMENT_METHOD,
QUANTITY, UNIT_PRICE, AMOUNT, SALE_TIME, RUN_ID, WORKER_ID
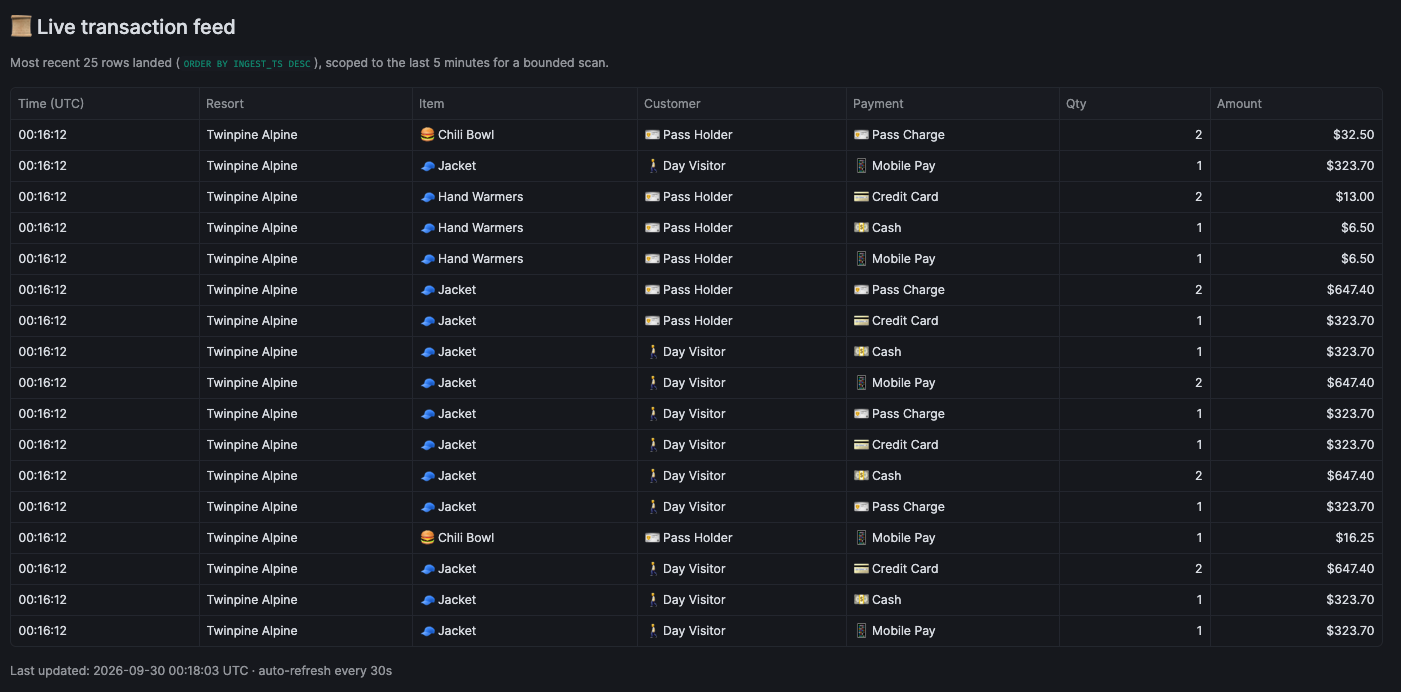
各リゾートには決定論的な販売プロファイル(相対的なボリューム、カテゴリミックス、価格帯、パス保有者の割合)があるため、リゾート別の収益、ミックスのシフト、地理的パターンなどの集計アナリティクスは、均一なランダムノイズではなく、現実的なものになります。リポジトリ内のStreamlitダッシュボードは、忙しい休日の週末に全国的なリゾートチェーンを見ているかのように、ライブフィードを視覚化します。
単一のリゾートのPOSが生成するものをはるかに超える負荷を意図的に実行しました。それがポイントでした。POSの現実味ではなく、Snowflakeの取り込み容量を分離することです。行は平均して約277バイトの非圧縮NDJSONでした。生成はホットパス上でRNGフリーでした(事前構築された重み付けテーブルがラウンドロビンでインデックス付けされます)。そのため、ターゲットスループットでクライアントがボトルネックになることはありませんでした。
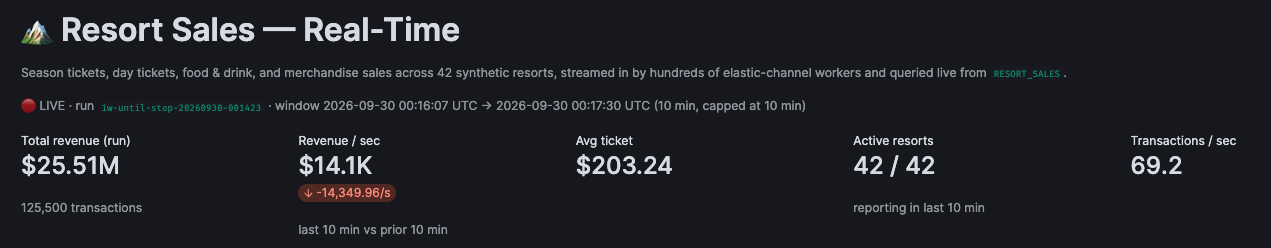
リゾートのリーダーシップがリゾート全体の売上と収益を監視し、顧客の行動をリアルタイムで監視するためのStreamlitダッシュボードも利用可能でした。販売管理トランザクションは、1分未満でダッシュボードに含まれました。
Kubernetesの展開
ベンチマークは、永続的なEKSクラスター(snowflake-elastic-channels)で実行されました。ワーカーノードは実行ごとにスケールアップし、その後ゼロに戻りました。小さなシステムノードとモニターの展開のみが常にオンのままでした。
アーキテクチャ
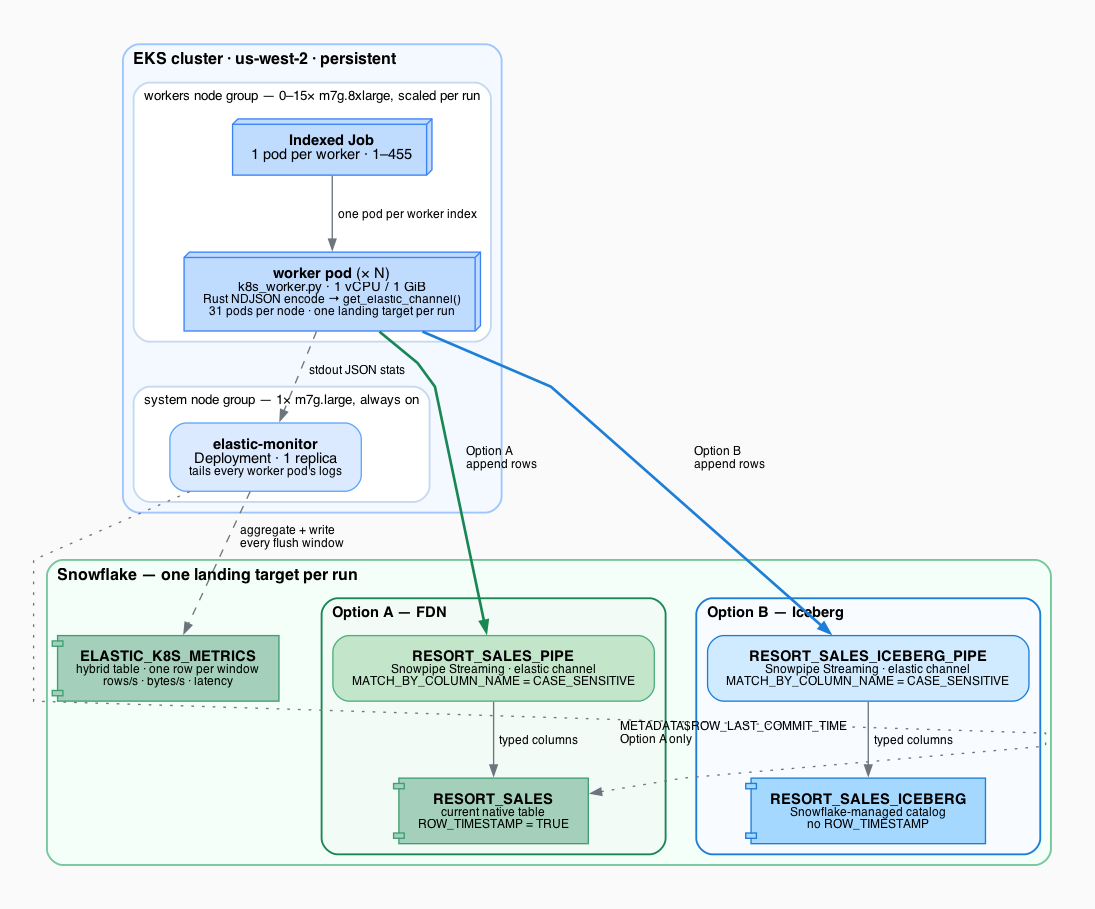
ベンチマークパラメータ
| パラメータ | 価値(Value) |
|---|---|
| ワーカーポッド | 455 |
| チャネル | 1(共有、Elastic) |
| ワーカーCPUリクエスト/制限 | 1vCPU |
| ワーカーメモリリクエスト/制限 | 1GiB |
| ノードあたりのワーカー | 31(m7g.8xlarge、Graviton arm64) |
| ピーク時のワーカーノード | 15 |
| 合計ワーカーvCPU | 455 |
| 合計ワーカーメモリ | 455GiB |
| メッセージ形式 | NDJSON(型付き列マッピング) |
| 平均行サイズ(非圧縮) | 約277バイト |
| 高速エンコードパス | ELASTIC_FAST_JSON_ENCODE=true(デフォルト) |
| SDK | snowpipe-streaming Pythonパッケージ |
| 取り込みパイプ | RESORT_SALES_PIPE → RESORT_SALES |
ワーカーポッドは、測定された定常状態の使用量に基づいて適切なサイズに設定されました。CPUはノードパッキングの制約条件であり、約240m〜540mのCPUを必要とします。ここで、1000mは割り当てられた1つの完全なvCPUです。メモリ使用量は、1Giが割り当てられた状態で68〜183MiBのRSSが観察されました。m7g.8xlargeは、メモリに余裕を持たせてノードあたり31個のワーカーをスケジュールします。
パフォーマンス結果
FDNでのピーク持続スループット
| メトリクス | 価値(Value) |
|---|---|
| 持続スループット(非圧縮) | 41.8GB/秒 |
| 持続行レート | 1億3,350万行/秒 |
| ピーク時のワーカー | 455 |
| ワーカーあたりのスループット | 約92MB/秒(約29万3,000行/秒)、15から455ワーカーまでほぼ横ばい |
| スロットリング | 観察されず |
Snowpipe Streamingとの比較
Summit 2024で、SnowflakeはSnowpipe Streamingの以前のバージョンが単一のテーブルに対して合計約10GB/秒で取り込むデモを行いました。これは当時の画期的な結果でした。私たちのベンチマークは、新しくリリースされたElastic Channels機能を使用して高パフォーマンスのSnowpipe Streamingで実行され、FDNテーブルとSnowflakeのマネージドApache Icebergテーブルの両方で、以前のベンチマークの3.5倍を超えるスループットレベルを記録しました。
| Summit 2024のオリジナルデモ(概算) | HP+Elastic ChannelsからFDNテーブルへ | HP+Elastic ChannelsからSnowflakeのマネージドApache Icebergテーブルへ | |
|---|---|---|---|
| スループット(非圧縮) | 約10GB/秒 | 41.8GB/秒 | 39.0GB/秒 |
| 行レート | 約3,900万行/秒¹ | 1億3,350万行/秒 | 1億2,160万行/秒 |
| スピードアップ | — | 3.5倍以上 |
¹ このワークロードの行の形状に合わせて、約277バイト/行と推定されます。
水平スケーリング(EKSスケールアウト)
スループットはすべてのステップでワーカー数にほぼ正確に追従し、プラトーのないきれいな線形スケーリングを示しました。スループットが上昇しても、レイテンシーは一定の範囲内に収まりました。バッチ確認(SDKのfuture完了)は、すべてのステップで平均して600ミリ秒近くに保たれました。バッチ確認時間は、クライアントがデータをSDKに送信してからコールバックを受信する(データが永続化される)までの合計時間です。取り込みから表示までのレイテンシー(SALE_TIME → METADATA$ROW_LAST_COMMIT_TIME)は、約12〜29秒の帯域にとどまりました。1億3,350万行/秒であっても、ランディングから数秒以内にデータをクエリできます。これは、データがクエリに含まれるまでの時間です。
| ワーカー | ノード | 行/秒 | スループット | 平均バッチ確認 | 平均取り込みから表示まで² |
|---|---|---|---|---|---|
| 15 | 1 | 440万 | 1.38GB/秒 | 582ミリ秒 | 11.7秒 |
| 90 | 3 | 2,660万 | 8.27GB/秒 | 595ミリ秒 | 14.0秒 |
| 180 | 6 | 5,280万 | 16.52GB/秒 | 611ミリ秒 | 16.7秒 |
| 300 | 10 | 8,780万 | 27.50GB/秒 | 572ミリ秒 | 17.7秒 |
| 420 | 14 | 1億2,320万 | 38.6GB/秒 | 587ミリ秒 | 28.9秒 |
| 455 | 15 | 1億3,350万 | 41.84GB/秒 | 570ミリ秒 | 19.9秒 |
² 取り込みから表示までのレイテンシーは、クラスターモニターによってELASTIC_K8S_METRICSからTIMESTAMPDIFF(SALE_TIME, METADATA$ROW_LAST_COMMIT_TIME)として測定されます。
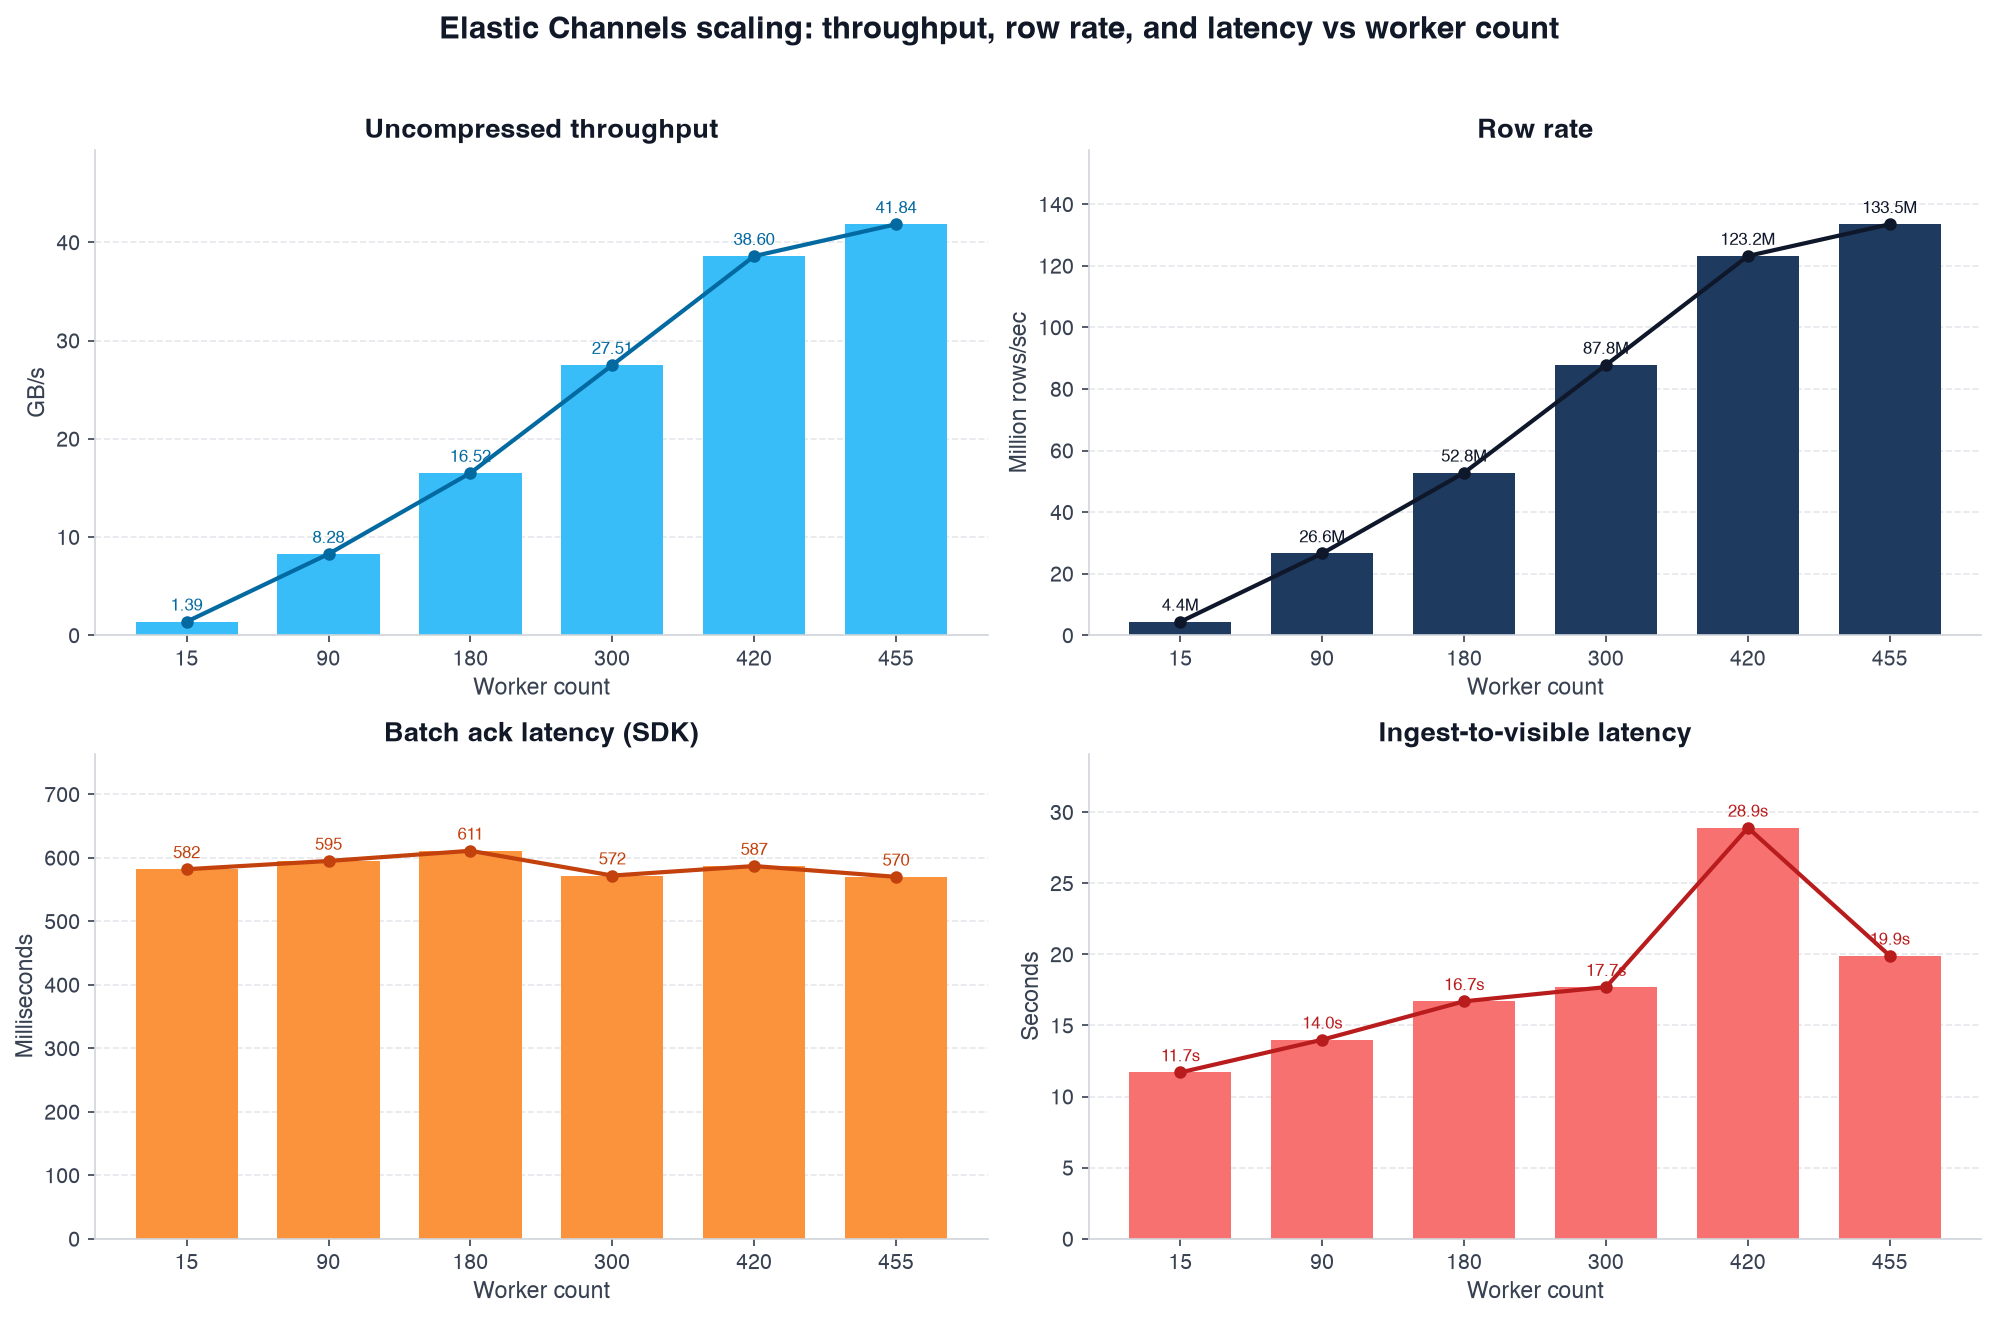
2つのレイテンシーメトリクスは、2つの異なる質問に答えます。
- バッチ確認レイテンシー(平均約570〜611ミリ秒)は、「SDKはバッチをどれくらい速く受け入れたか」という質問に答えます。これは、
append_rows()からSDKのfutureが完了するまで、クライアント側で測定されます。15から455のワーカー範囲全体でほとんど変動しませんでした。クライアントがSnowflakeが次のバッチを吸収するのを待つことはありませんでした。 - 取り込みから表示までのレイテンシー(平均約12〜29秒)は、「この行をいつクエリできるか」という質問に答えます。これは、サーバー側で
SALE_TIME→METADATA$ROW_LAST_COMMIT_TIMEとして測定されます。これは、ダッシュボードや運用アナリティクスにとって重要な数値です。スループットに比例して増加することはなく(行レートが30倍に増加しても、クエリ可能になるまでの時間が30倍に増加することはありませんでした)、キャンペーン全体を通じて、ほぼリアルタイムのリゾート売上ダッシュボードの実用的な範囲にとどまりました。
スケーリングのレバーは水平です。より大きなポッドではなく、軽量のワーカーポッドを追加します。テストでは、個々のワーカーに多くのCPUを割り当ててもスループットは向上しませんでした。各1vCPU/1GiBのポッドは、独立して同じ約0.086GiB/秒を提供しました。
ピーク時のリソース効率
見出しの数値を、業界の一般的なペタバイト規模のストリーミングベンチマークのレイアウトと並べてみると、その効率性が明らかになります。
| 一般的な大規模ストリーミングベンチマーク³ | Snowpipe StreamingのElastic ChannelsからFDNテーブルへ | Snowpipe StreamingのElastic ChannelsからSnowflakeのマネージドApache Icebergテーブルへ | |
|---|---|---|---|
| 同時ワーカー数 | 2,048 | 455 | 455 |
| ワーカーあたりのコア数 | 1.5 | 1.0 | 1.0 |
| ワーカーあたりのメモリ | 2GiB | 1GiB | 1GiB |
| 合計ワーカーコア数 | 3,072 | 455 | 455 |
| 合計ワーカーメモリ | 4,096GiB | 455GiB | 455GiB |
| 持続スループット | 約12GB/秒 | 約41.8GB/秒 | 約39.0GB/秒 |
| 持続行/秒 | 約1,200万 | 1億3,350万 | 1億2,160万 |
³ 数千のKubernetesプロデューサーポッドとネイティブバイナリ行エンコーダーを使用した、24時間のペタバイト規模の単一テーブル取り込みベンチマークの代表的な公開パラメータ。
約7分の1のコア、9分の1のメモリ、4分の1未満のワーカープロセスを使用しながら、3倍以上のバイト/秒、および宛先としてのFDNテーブルとApache Icebergテーブルの両方で10倍以上の行/秒を実現しました。
ここに至るまでの経緯:Snowpipe Streamingの進化
このプロジェクトは、多くのSnowflakeストリーミング評価と同様に、ホストあたり数十のワーカー、明示的なチャネル、およびバッチごとに構築されるPythonの行の辞書を備えた大規模なEC2インスタンスで開始されました。これらの実行は価値のあるものでした。Snowflakeよりもずっと前に、クライアント側の限界を明らかにしたからです。
| 時代 | 測定内容 | 制限要因 |
|---|---|---|
| Snowpipe Streamingの以前のバージョン(Summit 2024のデモ) | ステージ上で約10GB/秒。初期の立ち上げではホストあたり1GB/秒未満 | チャネル/オフセットのオーバーヘッド、クライアント側の列指向化とメタデータ、従来のSDKアーキテクチャ |
| 高パフォーマンスアーキテクチャ(2025年リリース) | 大規模インスタンスあたり約2〜8GB/秒。EC2上のマルチノードで約16GB/秒を持続 | ホストあたりのネットワーク、ワーカー/チャネル管理、Pythonエンコードパス |
| Elastic Channels+EKS+Rustエンコード | 455ワーカーで41.8GB/秒 | このテストではなし(サポートされている範囲全体で線形スケーリング) |
3つの変更が複合的に作用しました。
- Elastic Channels:
get_elastic_channel()は、1つのクライアントの下にすべてのチャネルをプールします。アプリケーションコードは、名前とオフセットの管理を停止します。 - 適切な粒度のKubernetes:ワーカーあたり1つのポッド、それぞれ1vCPU、Gravitonノードあたり31個のポッド。プロセスではなく、フリートをスケーリングします。
- 生成とエンコードのためのRustの高速パス:以下で説明するように、Pythonはオーケストレーションであり、ホットループではありません。
Elastic Channelsの追加を含むSnowpipe Streamingのアップデートにより、Snowflakeへのデータの送信がこれまで以上に改善されました。Snowpipe Streamingの高パフォーマンスアーキテクチャにより、スケーラブルなサーバーレスインフラストラクチャで大量のデータを迅速かつ簡単に取り込み、ソースから数秒でクエリを実行できます。課金はシンプルで、取り込まれたギガバイトに基づいています。今日の市場において、ストリーミングデータをクエリするための、これより簡単でスケーラブルな方法はありません。
データエンコードにRustを使用する理由
ワーカーあたり毎秒数十万行の場合、Pythonの辞書の割り当てとJSONのシリアル化がCPUを支配します。SDKのデフォルトパスは、行の辞書を受け入れ、内部で再エンコードします。これは正しいですが、スキーマがすでにわかっている場合は冗長です。
ワーカーのCPUとメモリを最も効率的に使用するために、データはRustで生成およびシリアル化されました。これには、SDKの内部メソッドが使用されます。これらのメソッドは将来変更される可能性があり、アップグレードが複雑になります。
Rustで両方の行生成とNDJSONシリアル化を行うオプションのネイティブ拡張機能(native/、PyO3+maturinを使用してワーカーのDockerイメージに組み込まれています)を追加しました。
- 行ごとのPythonオブジェクトをスキップ:行ごとの
dictはなく、ホットパスでのmsgspec構造体のラウンドトリップもありません。 - SDKの2番目のエンコードをスキップ:
fast_append.pyは、append_rows_with_waitの内部のencode_linesパスをバイパスして、事前シリアル化されたバイトをElasticチャネルのFFI追加に直接渡します。 - Pythonとバイト単位で同一を維持:
native/generate_tables.pyは、すべての重み付けテーブルと事前フォーマットされた価格文字列をresort_sales.py自体から派生させます。Rustは解決されたデータを再生します。ビジネスロジックを再実装するわけではありません。単体テストでは、ネイティブパスとPythonパスが同一のNDJSONを生成することがアサートされます。
UNIT_PRICEとAMOUNTは、コード生成時に(Pythonのjson.dumpsフォーマットを介して)10進文字列としてベイクされるため、発生する(item, tier, quantity)の組み合わせの有限セットにおいて、RustがPythonの浮動小数点フォーマットと一致しないことはありません。
wheelがインストールされていない場合、ハーネスは自動的にPythonのmsgspecエンコードにフォールバックします。本番環境のベンチマーク実行では、Rustはデフォルトでオンになっています(ELASTIC_FAST_JSON_ENCODE=true)。
その結果、各1vCPUワーカーは、SDKのネットワークI/O用のCPUに余裕を持たせながら、約0.086GiB/秒を維持します。これは、455ワーカーの線形スケーリングを可能にするワーカーあたりのスループットです。
学んだこと
- Elastic Channelsは統合が簡単:
get_elastic_channel()を呼び出し、行(または事前エンコードされたバイト)を追加するだけで完了です。 - スループットはワーカー数に比例して線形にスケーリング:15から455ワーカーまでスケーリングできるため、曲線に屈曲点はなく、スロットリングも観察されませんでした。
- 適切なサイズのポッドは大きなポッドに勝る:エンコードがボトルネックでない場合は、1vCPU/1GiBで十分です。
- 合成ワークロードは機能であり、チートではない:決定論的なインプロセス生成により、I/Oの偏りがなくなり、実行の再現性が高まります。これは、データソースではなくアーキテクチャを比較する場合に不可欠です。
- クライアント側の最適化は依然として重要:Rustサーバーコアを使用しても、クライアントのCPUを半分にすると、ホストあたりに許容できるストリームの数がほぼ2倍になります。
Elastic Channelsのデモを見る
IoTユースケース向けのSnowflakeのElastic Channelsのデモ動画をご覧ください。
ご自身でお試しください
最小限のエンドツーエンドの実行を再現するために必要なものはすべて、リポジトリにあります。パイプラインを検証するために455個のワーカーは必要ありません。接続性、パイプ構成、およびライブメトリクスを証明するには、1つのElasticチャネルを1分間実行するだけで十分です。
1.クローンと構成
git clone https://github.com/snowflake-labs/snowflake-elastic-channels.git
cd snowflake-elastic-channels
pip install -r requirements.txt
cp .env.example .env   # Snowflake account, user, key-pair auth
python scripts/setup_elastic_ramp.py --ingest-ip <YOUR_INGEST_IP>
2.1回限りのEKSセットアップを実行(ローカルのマイクロベンチマークのみが必要な場合はスキップ)
./infra/eks/create_cluster.sh
./infra/eks/build_and_push.sh
./infra/eks/create_secret.sh
./infra/eks/allowlist_eks.sh
./infra/eks/deploy_monitor.sh
3.単一ワーカー/単一チャネルのスモークテストを実行
./infra/eks/run_job.sh quicktest-$(date +%Y%m%d%H%M%S) \
    --target-bps 100000000 \
    --duration-seconds 60 \
    --workers 1
Snowflakeでライブスループットを監視:
SELECT *
FROM SC_DB.SC_SCHEMA.ELASTIC_K8S_METRICS
WHERE RUN_ID = '<your-run-id>'
ORDER BY WINDOW_START;スケールを調査する準備ができたら、--workersは1から455までの任意の値を受け入れます。ノードグループは自動的にサイズを調整します。
4.ローカルのクライアントのみのベンチマークを実行(Snowflakeは不要)
python scripts/benchmark_client_cpu.py --workers 1 --aggregate-mbps 100リポジトリ
GitHubで入手できます。
| パス | 目的 |
|---|---|
src/elastic_channels/k8s_worker.py |
ワーカーポッドのエントリポイント |
src/elastic_channels/resort_sales.py |
合成POS行ジェネレーター |
native/ |
Rust NDJSON高速エンコーダー |
infra/eks/run_job.sh |
スケールアウトベンチマークオーケストレーター |
streamlit/Monitor_App.py |
ライブスループット/レイテンシーダッシュボード |
docs/architecture.md |
完全なシステム設計 |
注意事項
- 結果は、1つのクラスター化されていないテーブル上の、1つのSnowflakeアカウント、1つのリージョン(
us-west-2)、および1つの合成行の形状(約277バイトのNDJSON行)を反映しています。行の幅、パイプの定義、およびアカウントの制限は異なる場合があります。 - 3.5倍以上の比較は、Summit 2024でデモされたSnowpipe Streaming(約10GB/秒)に対するものです。このベンチマークでは、2025年にリリースされたElastic Channelsを備えた高パフォーマンスアーキテクチャを使用しています。同じ行サイズの仮定(約277バイト)。制御された並行リプレイではなく、方向性を示すものです。
- ほとんどのスケールアウトステップは、繰り返しの試行ではなく、単一の測定である
- コスト分析はこの記事の範囲外である。スループットベースのSnowpipe Streamingの価格設定は、取り込まれた非圧縮ボリュームに適用され、ユースケースごとに計算できる
- これらのボリュームに到達するには、アカウントの容量を増やすために、お客様のアカウントチームまたはサポートに連絡する必要がある
