19 oct. 2026/Lecture : 18 minData engineering
Atteindre 41 Go/s sur une seule table : benchmark d’Elastic Channels pour Snowpipe Streaming
La légende raconte que Snowflake doit son nom à la passion de ses fondateurs pour les pistes de ski. Il était donc tout naturel de tester nos nouveaux Elastic Channels en faisant transiter par le système l’équivalent d’une saison entière de ventes en station.
À mesure que vos applications se développent et que de nouveaux appareils se connectent, vous avez besoin d’un moyen simple d’intégrer les données à Snowflake à des fins d’analyse et d’IA. Nous avons récemment annoncé la disponibilité générale d’Elastic Channels pour Snowpipe Streaming. Ils permettent d’envoyer des événements directement depuis les applications, appareils et services, tandis que Snowflake fait évoluer les capacités d’ingestion. Mais quelles performances cette approche simplifiée offre-t-elle lorsque les volumes de données augmentent ?
Pour le savoir, nous avons créé une charge de travail synthétique reproduisant les ventes en stations, puis augmenté le nombre de producteurs indépendants jusqu’à atteindre un débit total de 41 Go/s. Nous avons exécuté ce benchmark avec une table Snowflake FDN (native) comme destination, puis avec une table Apache Iceberg™ gérée par Snowflake. Cet article analyse l’évolution du débit et de l’actualisation des données à mesure que la charge augmente, ainsi que les enseignements à en tirer pour vos propres charges de travail.
Contexte
Snowpipe Streaming garantit une sémantique de traitement « en une seule fois » rigoureuse et un ordre strict des messages. Pour les charges de travail stratégiques, comme la capture des données modifiées (CDC), les transactions financières et la gestion des stocks, cette comptabilisation méticuleuse est incontournable. Elle comprend la gestion explicite des canaux, le suivi des écarts et la coordination des schémas côté client.
Mais si vous créez des pipelines de télémétrie, des réseaux d’appareils IoT ou des systèmes d’analyse de logs à haut volume pour lesquels une livraison « en au moins une fois » suffit, tous ces frais opérationnels supplémentaires peuvent devenir un obstacle inutile. C’est précisément pour cette raison que nous avons lancé Elastic Channels : éliminer la complexité liée à la gestion du cycle de vie des canaux et au suivi des écarts. En confiant à Snowflake l’évolution des capacités et la distribution automatique des canaux, vous bénéficiez d’une ingestion ultrarapide pour vos flux de données légers, sans les frais opérationnels d’ingénierie.
Dans la version précédente de Snowpipe Streaming, les clients devaient générer les données en colonnes et les métadonnées pour chaque batch de fichiers, les charger, puis les enregistrer auprès de Snowflake pour traitement. En 2025, Snowflake a lancé l’architecture haute performance : des objets PIPE côté serveur, des cœurs de SDK basés sur Rust et un parcours d’ingestion repensé qui a considérablement allégé la charge côté client. Avec l’architecture haute performance, le client doit désormais uniquement générer et envoyer des charges utiles JSON à Snowflake. Snowflake accepte ces charges utiles JSON et traite les données de façon asynchrone à l’aide de PIPE exécutés sur notre infrastructure Snowpipe hautement évolutive. Ces changements ont considérablement réduit les frais opérationnels de calcul et de mémoire côté client, tout en simplifiant les déploiements. Elastic Channels (client.get_elastic_channel()) s’appuie sur l’architecture haute performance : un client SDK ouvre automatiquement un canal mutualisé, sans nom de canal ni gestion des écarts, tout en écrivant dans le même pipe haute performance.
La question à laquelle nous voulions répondre avec ce test était simple : Jusqu’où Elastic Channels peut-il pousser les performances, et avec quelle efficacité ?
La réponse nous a surpris. Grâce à une conception optimale côté client et à un parc Kubernetes ayant évolué horizontalement, nous avons mesuré un débit agrégé soutenu plus de 3,5 fois supérieur à celui des versions précédentes, avec moins de cœurs et de mémoire au total, ainsi que bien moins de processus workers que dans des benchmarks d’ingestion comparables à l’échelle du pétaoctet publiés ailleurs dans le secteur d’activité.
L’essentiel en un coup d’œil
Snowpipe Streaming avec Elastic Channels a maintenu un débit de 41,8 Go/s, soit 133,5 millions de lignes par seconde, vers une seule table Snowflake FDN. C’est plus de 3,5 fois le débit des versions précédentes de Snowpipe Streaming, avec 455 workers Kubernetes légers, 455 vCPU et 455 GiB de mémoire, sans aucune erreur et avec une évolution linéaire à chaque étape testée.
Débit maximal soutenu (données non compressées) |
41,8 Go/s |
Débit maximal en lignes |
133,5 millions de lignes par seconde |
Workers |
455 (1 canal élastique) |
Empreinte de calcul |
455 vCPU · 455 GiB de mémoire |
Nœuds Kubernetes |
15 × m7g.8xlarge (Graviton) |
Par rapport à la version précédente de Snowpipe Streaming |
>3,5 fois plus de débit |
Ce que nous avons testé
Nous avons créé un outil de benchmark open source (snowflake-elastic-channels) qui sollicite directement le SDK Python snowpipe-streaming :
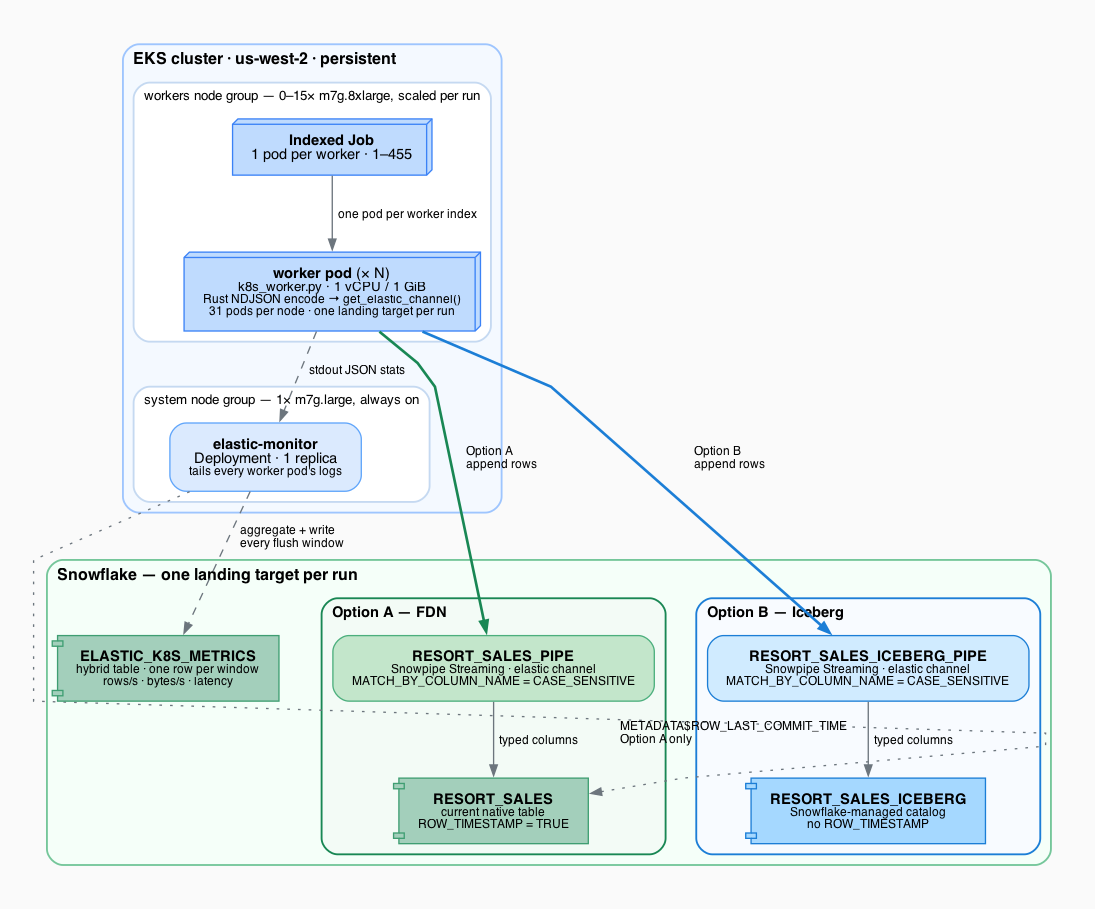
- Déploiement simple : Un pod worker = un client SDK = un canal élastique connecté à un RESORT_SALES_PIPE partagé.
- Configuration de la cadence et du débit : Cadence cible par worker pendant une durée fixe ; le débit agrégé correspond à la somme des débits de tous les pods.
- Observabilité en direct : Un moniteur exécuté dans le cluster suit en continu les logs des workers et écrit les fenêtres de débit et de latence dans Snowflake (
ELASTIC_K8S_METRICS) pendant l’exécution du test. - Ingestion typée :
MATCH_BY_COLUMN_NAME = CASE_SENSITIVEassocie directement les clés JSON aux colonnes de la table, au lieu de les regrouper dans un BlobVARIANTunique. - Destination configurable : Les données sont chargées dans des tables FDN ou Apache Iceberg.
Chaque mesure ci-dessous est une valeur réelle, issue d’une mise à l’échelle horizontale sur Amazon EKS dans la région us-west-2, en septembre 2026. Nous indiquons le nombre d’octets non compressés et de lignes relevé par le SDK et le moniteur, sans aucune extrapolation.
La charge de travail : ventes synthétiques en stations à l’échelle de la production
La lecture depuis Kafka, S3 ou un jeu de données public introduit des limites côté producteurs qui masquent les capacités réelles de Snowpipe Streaming. Nous avons donc généré les données au sein même du processus afin d’éliminer tout goulot d’étranglement externe.
Le cas d’usage retenu portait sur des transactions en point de vente (POS) réalisées dans un portefeuille synthétique de stations de ski : 42 stations, quatre catégories de produits (forfaits saison, forfaits journée, restauration et boissons, produits dérivés), plusieurs moyens de paiement et types de clientèle, ainsi que différents niveaux tarifaires par station. Voici le schéma de table unique du modèle :
TXID, RESORT, CATEGORY, ITEM, CUSTOMER_TYPE, PAYMENT_METHOD,
QUANTITY, UNIT_PRICE, AMOUNT, SALE_TIME, RUN_ID, WORKER_ID
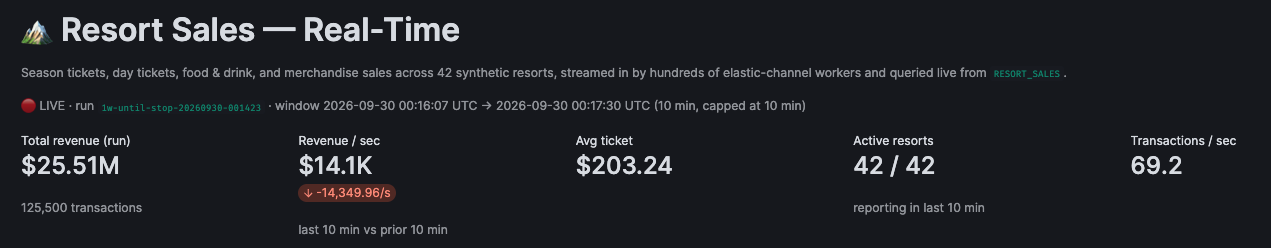
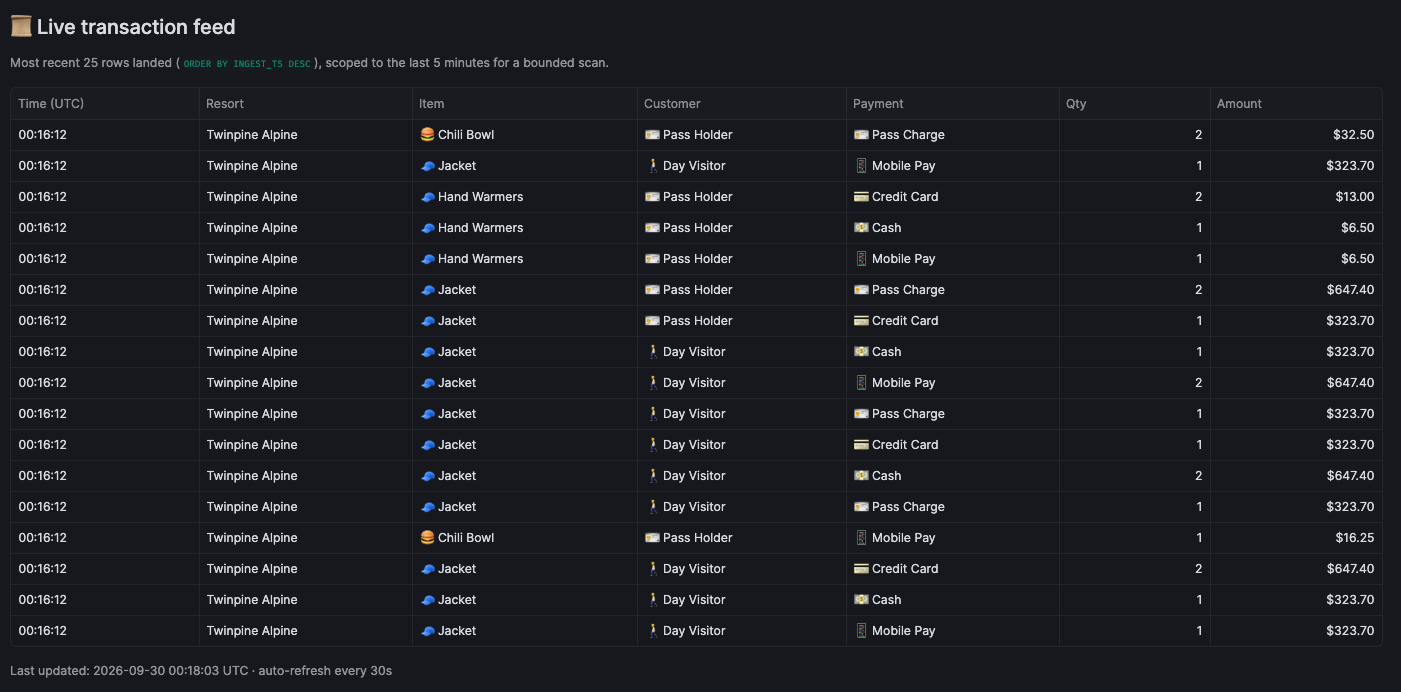
Chaque station possède un profil de vente déterministe, avec son volume relatif, sa répartition par catégorie, son niveau tarifaire et sa part de détenteurs de forfaits. Les analyses agrégées produisent ainsi des résultats réalistes, comme le chiffre d’affaires par station, l’évolution de la répartition des ventes et les tendances géographiques, plutôt qu’un bruit aléatoire uniforme. Un tableau de bord Streamlit disponible dans le dépôt permet de visualiser le flux en direct, comme si vous observiez une chaîne nationale de stations pendant un week-end de vacances particulièrement chargé.
Nous avons délibérément opéré bien au-delà du volume que pourrait générer le POS d’une seule station. C’était précisément l’objectif : isoler la capacité d’ingestion de Snowflake, et non reproduire fidèlement l’activité d’un POS. Les lignes contenaient en moyenne environ 277 octets de données NDJSON non compressées. La génération s’effectuait sans générateur aléatoire (RNG) sur le chemin critique : une table pondérée préconstruite était indexée à tour de rôle, afin que le client ne devienne jamais le goulot d’étranglement au débit cible.
Un tableau de bord Streamlit permettait également à la direction de suivre les ventes et le chiffre d’affaires de l’ensemble des stations, ainsi que le comportement des clients en temps réel. Les transactions en point de vente apparaissaient dans le tableau de bord en nettement moins d’une minute.
Déploiement Kubernetes
Le benchmark a été exécuté sur un cluster EKS persistant (snowflake-elastic-channels). Le nombre de nœuds workers augmentait pour chaque exécution, puis revenait à zéro une fois le test terminé ; seuls un petit nœud système et le déploiement du moniteur restaient actifs en permanence.
Architecture
Paramètres du benchmark
| Paramètre | Valeur |
|---|---|
| Pods workers | 455 |
| Canaux | 1 (partagé, élastique) |
| Demande/limite de CPU par worker | 1 vCPU |
| Demande/limite de mémoire par worker | 1 GiB |
| Workers par nœud | 31 (m7g.8xlarge, Graviton arm64) |
| Nœuds workers au pic d’activité | 15 |
| Nombre total de vCPU des workers | 455 |
| Mémoire totale des workers | 455 GiB |
| Format des messages | NDJSON (mappage typé des colonnes) |
| Taille moyenne d’une ligne (non compressée) | Environ 277 octets |
| Parcours d’encodage rapide | ELASTIC_FAST_JSON_ENCODE=true (par défaut) |
| SDK | Package Python snowpipe-streaming |
| Canal d’ingestion | RESORT_SALES_PIPE → RESORT_SALES |
Les pods de workers ont été dimensionnés en fonction de l’utilisation mesurée en régime permanent. Le CPU constitue la principale contrainte pour regrouper les pods sur les nœuds, avec un besoin d’environ 240m à 540m de CPU, sachant que 1 000m équivaut au vCPU complet alloué. L’utilisation observée de la mémoire se situait entre 68 et 183 Mio de RSS, sur 1 Gio alloué. Une instance m7g.8xlarge exécute 31 workers par nœud, tout en conservant une marge de mémoire confortable.
Résultats de performance
Débit soutenu maximal sur FDN
| Indicateur | Valeur |
|---|---|
| Débit soutenu (données non compressées) | 41,8 Go/s |
| Débit soutenu en lignes | 133,5 millions de lignes par seconde |
| Workers au pic d’activité | 455 |
| Débit par worker | Environ 92 Mo/s, soit environ 293 000 lignes par seconde, un niveau pratiquement stable de 15 à 455 workers |
| Limitation du débit | Aucune observée |
Comparaison avec Snowpipe Streaming
Lors du Summit 2024, Snowflake a présenté la version précédente de Snowpipe Streaming, capable d’ingérer environ 10 Go/s au total dans une seule table. Un résultat sans précédent à l’époque. Notre benchmark exploite Snowpipe Streaming haute performance avec la nouvelle feature Elastic Channels. Il a atteint des débits plus de 3,5 fois supérieurs à ceux des benchmarks précédents, aussi bien sur les tables FDN que sur les tables Apache Iceberg gérées par Snowflake.
| Démo originale du Summit 2024 (approx.) | HP + Elastic Channels vers les tables FDN | HP + Elastic Channels vers les tables Apache Iceberg gérées par Snowflake | |
|---|---|---|---|
| Débit (données non compressées) | Environ 10 Go/s | 41,8 Go/s | 39,0 Go/s |
| Débit en lignes | Environ 39 millions de lignes par seconde¹ | 133,5 millions de lignes par seconde | 121,6 millions de lignes par seconde |
| Accélération | – | > 3,5× |
¹ Estimation basée sur environ 277 octets par ligne, afin de correspondre au format des lignes de ce workload.
Mise à l’échelle horizontale (mise à l’échelle EKS)
À chaque étape, le débit a suivi presque exactement le nombre de workers, avec une mise à l’échelle linéaire nette, sans plafonnement. La latence est restée dans une plage limitée malgré la hausse du débit : Le délai d’accusé de réception du batch (finalisation du future du SDK) s’est maintenu autour de 600 ms en moyenne à toutes les étapes. Le délai d’accusé de réception du batch correspond à la durée totale entre l’envoi des données au SDK par le client et la réception du callback, qui confirme leur persistance. La latence entre l’ingestion et la disponibilité (SALE_TIME → METADATA$ROW_LAST_COMMIT_TIME) est restée dans la plage de 12 à 29 secondes environ. Les données pouvaient être interrogées quelques secondes après leur arrivée, même à 133,5 millions de lignes par seconde. Il s’agit du délai nécessaire pour que les données soient incluses dans les requêtes.
| Workers | Nœuds | Lignes par seconde | Débit | Accusé de réception moyen du batch | Délai moyen entre ingestion et disponibilité² |
|---|---|---|---|---|---|
| 15 | 1 | 4,4 M | 1,38 Go/s | 582 ms | 11,7 s |
| 90 | 3 | 26,6 M | 8,27 Go/s | 595 ms | 14,0 s |
| 180 | 6 | 52,8 M | 16,52 Go/s | 611 ms | 16,7 s |
| 300 | 10 | 87,8 M | 27,50 Go/s | 572 ms | 17,7 s |
| 420 | 14 | 123,2 M | 38,6 Go/s | 587 ms | 28,9 s |
| 455 | 15 | 133,5 M | 41,84 Go/s | 570 ms | 19,9 s |
² Latence entre l’ingestion et la disponibilité mesurée par le moniteur du cluster avec TIMESTAMPDIFF(SALE_TIME, METADATA$ROW_LAST_COMMIT_TIME), à partir de ELASTIC_K8S_METRICS.
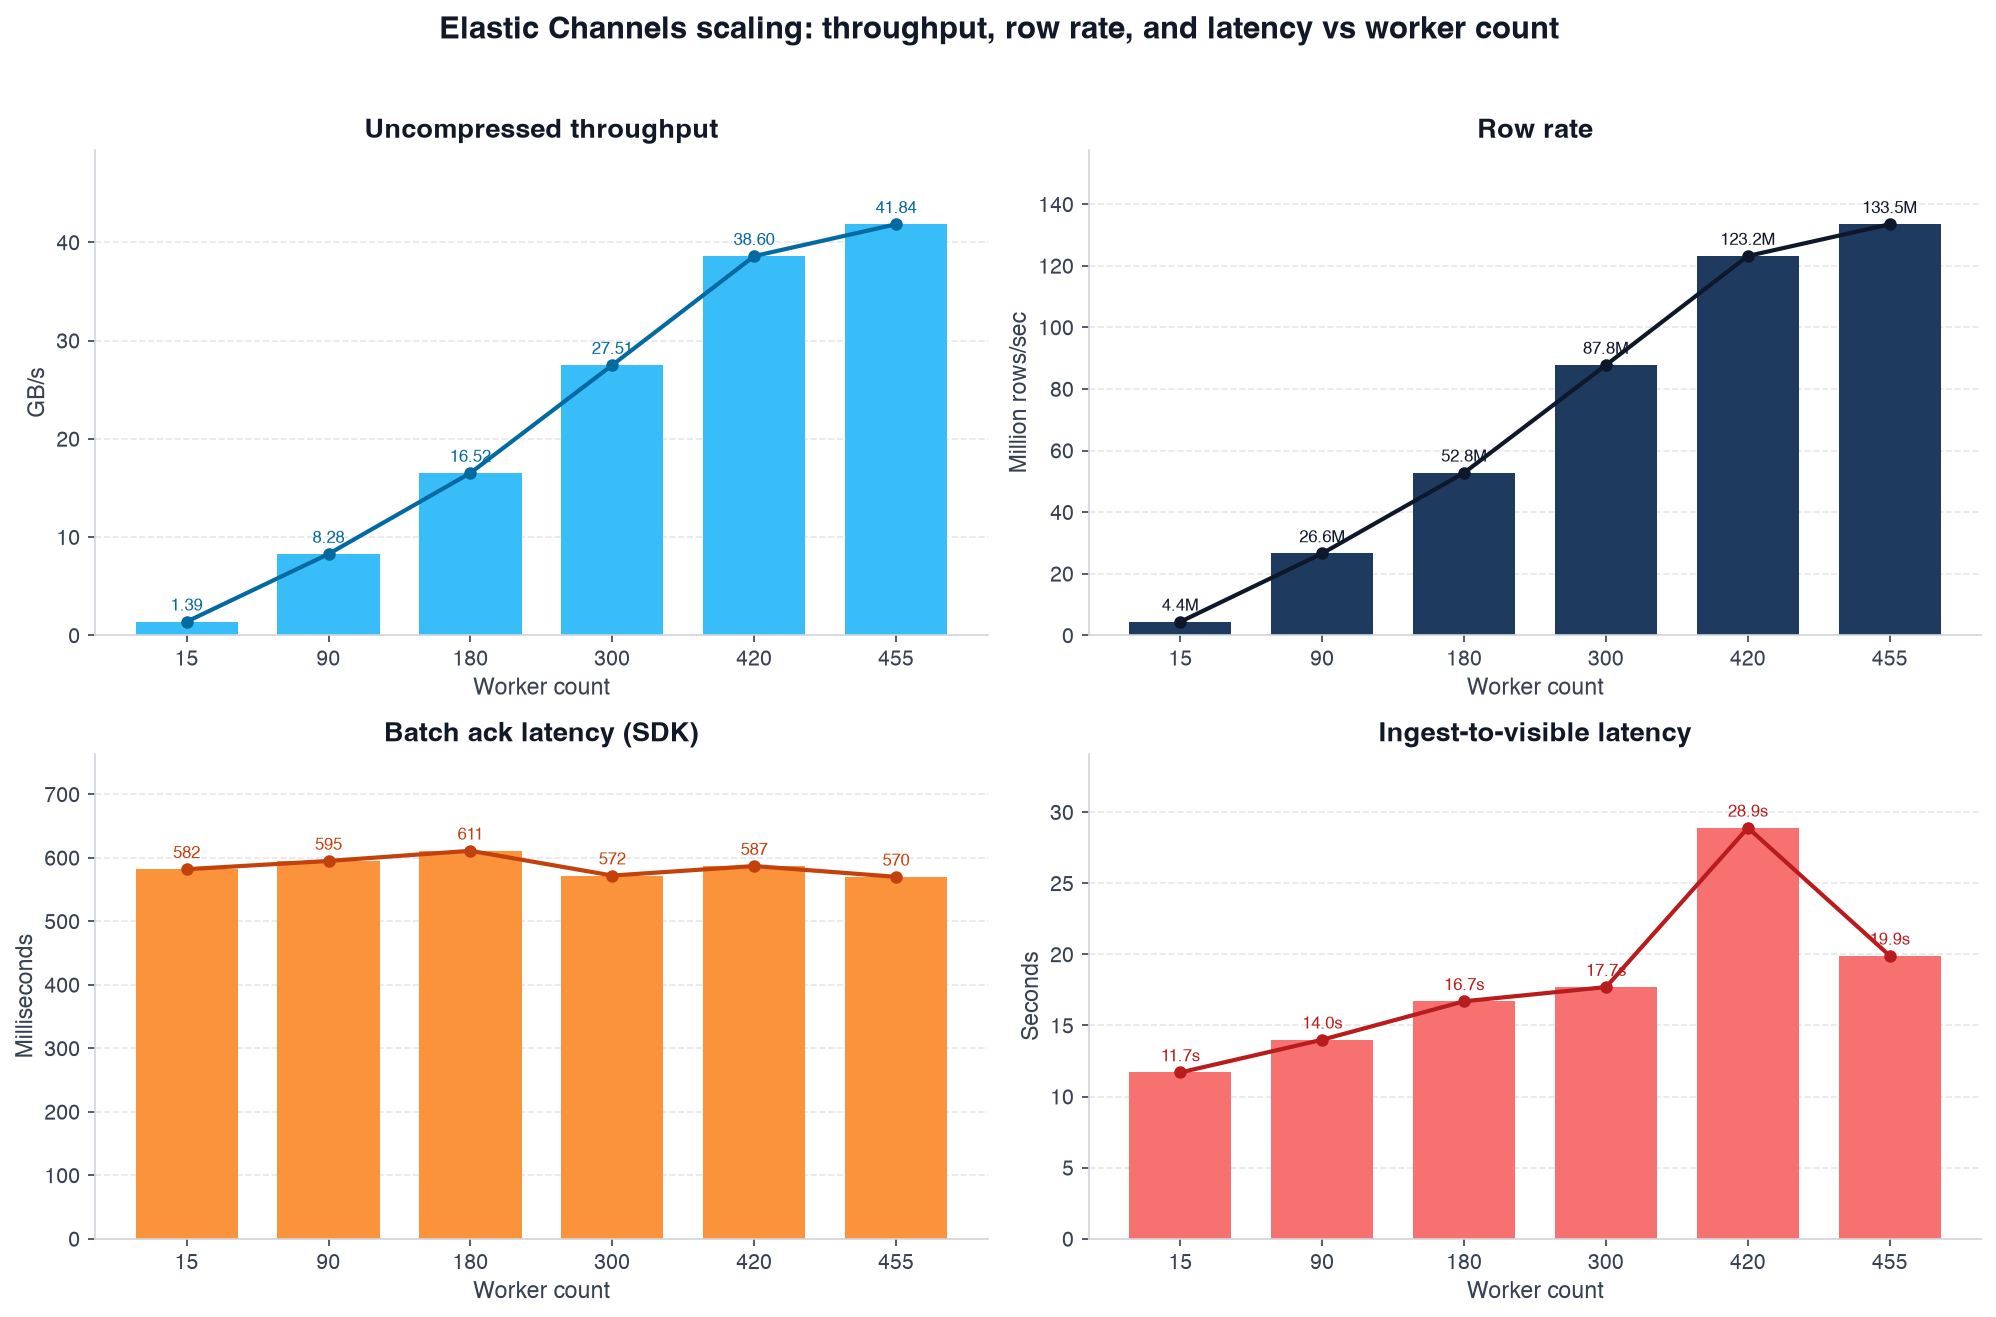
Deux métriques de latence répondent à deux questions différentes :
- La latence d’accusé de réception du batch, de 570 à 611 ms en moyenne, répond à la question : « À quelle vitesse le SDK a-t-il accepté mon batch ? » Elle est mesurée côté client, de l’appel à
append_rows()jusqu’à la finalisation du future du SDK. Elle a très peu varié sur toute la plage de 15 à 455 workers : le client n’a jamais attendu que Snowflake absorbe le batch suivant. - La latence entre l’ingestion et la disponibilité, de 12 à 29 s en moyenne, répond à la question : « Quand puis-je lancer une requête sur cette ligne ? » Elle est mesurée côté serveur comme suit :
SALE_TIME→METADATA$ROW_LAST_COMMIT_TIME. C’est la métrique qui compte pour les tableaux de bord et l’analytique opérationnelle. Elle n’a pas augmenté proportionnellement au débit : multiplier par 30 le débit en lignes n’a pas multiplié par 30 le délai avant interrogation. Cette latence est restée adaptée aux tableaux de bord de ventes des complexes touristiques en quasi-temps réel pendant toute la campagne.
Le principal levier de mise à l’échelle est horizontal : Ajoutez des pods de workers légers, plutôt que des pods plus puissants. Lors de nos tests, augmenter les ressources CPU d’un worker n’a pas amélioré son débit ; chaque pod de 1 vCPU / 1 GiB a fourni indépendamment le même débit d’environ 0,086 GiB/s.
Une efficacité optimale à plein régime
La comparaison de ces chiffres clés avec ceux d’un benchmark type du secteur conçu pour faire évoluer le streaming jusqu’à l’échelle du pétaoctet met clairement en évidence cette efficacité.
| Benchmark type pour faire évoluer le streaming à grande échelle³ | Snowpipe Streaming Elastic Channels vers une table FDN | Snowpipe Streaming Elastic Channels vers une Apache Iceberg Table gérée par Snowflake | |
|---|---|---|---|
| Workers simultanés | 2 048 | 455 | 455 |
| Cœurs par worker | 1,5 | 1,0 | 1,0 |
| Mémoire par worker | 2 GiB | 1 GiB | 1 GiB |
| Nombre total de cœurs des workers | 3 072 | 455 | 455 |
| Mémoire totale des workers | 4 096 GiB | 455 GiB | 455 GiB |
| Débit soutenu | ~12 GB/s | ~41,8 GB/s | ~39,0 GB/s |
| Nombre soutenu de lignes par seconde | ~12 M | 133,5 M | 121,6 M |
³ Paramètres représentatifs publiés pour un benchmark d’ingestion dans une table unique pendant 24 heures, conçu pour faire évoluer le traitement jusqu’à l’échelle du pétaoctet à l’aide de milliers de pods producteurs Kubernetes et d’un encodeur binaire natif de lignes.
Nous avons utilisé environ sept fois moins de cœurs, neuf fois moins de mémoire et plus de quatre fois moins de processus workers, tout en traitant plus de trois fois plus d’octets par seconde et plus de dix fois plus de lignes par seconde, avec des tables FDN ou Apache Iceberg comme destination.
Comment en sommes-nous arrivés là ? L’évolution de Snowpipe Streaming
Ce projet a commencé comme beaucoup d’évaluations du streaming avec Snowflake : sur de grandes instances EC2, avec des dizaines de workers par hôte, des canaux explicites et des dictionnaires de lignes Python créés pour chaque batch. Ces exécutions ont été riches d’enseignements : elles ont révélé les limites côté client bien avant celles de Snowflake.
| Étape | Résultats mesurés | Facteurs limitants |
|---|---|---|
| Version précédente de Snowpipe Streaming (démo Summit 2024) | ~10 GB/s sur scène ; moins de 1 GB/s par hôte lors de nos premières montées en charge | Frais opérationnels liés aux canaux et aux écarts, mise en colonnes et métadonnées côté client, architecture SDK classique |
| Architecture haute performance (lancée en 2025) | ~2 à 8 GB/s par grande instance ; ~16 GB/s soutenus sur plusieurs nœuds EC2 | Réseau par hôte, gestion des workers et des canaux, parcours d’encodage Python |
| Elastic Channels + EKS + encodage Rust | 41,8 GB/s avec 455 workers | Aucune limite lors de ce test, avec une évolution linéaire sur toute la plage prise en charge |
Trois changements ont produit un effet cumulatif :
- Elastic Channels :
get_elastic_channel()regroupe tous les canaux sous un même client. Le code de l’application n’a plus à gérer les noms ni les écarts. - Kubernetes avec la bonne granularité : Un pod par worker, avec 1 vCPU chacun et 31 pods par nœud Graviton. Faites évoluer la flotte, pas le processus.
- Un parcours rapide en Rust pour la génération et l’encodage : Python orchestre les opérations, mais n’exécute pas la boucle critique, comme expliqué ci-dessous.
Grâce aux évolutions de Snowpipe Streaming, notamment l’ajout d’Elastic Channels, l’envoi de données vers Snowflake n’a jamais été aussi simple. L’architecture haute performance de Snowpipe Streaming permet d’ingérer rapidement et facilement d’immenses volumes de données dans une infrastructure serverless évolutive, puis de les interroger en quelques secondes depuis la source. La facturation est simple et repose sur le nombre de gigaoctets ingérés. Il n’existe aujourd’hui sur le marché aucun moyen plus simple et plus évolutif d’exécuter des requêtes sur les données en streaming.
Pourquoi choisir Rust pour l’encodage des données ?
À plusieurs centaines de milliers de lignes par seconde et par worker, l’allocation de dictionnaires Python et la sérialisation JSON monopolisent les ressources CPU. Le parcours par défaut du SDK accepte les dictionnaires de lignes et les réencode en interne. Cette approche est correcte, mais redondante lorsque le schéma est déjà connu.
Pour exploiter au mieux le CPU et la mémoire du worker, nous avons généré et sérialisé les données en Rust. Cette approche utilise des méthodes internes du SDK. Ces méthodes sont susceptibles d’évoluer, ce qui pourrait compliquer les mises à niveau.
Nous avons ajouté une extension native facultative (native/, intégrée à l’image Docker du worker avec PyO3 + maturin) qui assure à la fois la génération des lignes et leur sérialisation NDJSON en Rust :
- Suppression des objets Python pour chaque ligne : aucun
dictpar ligne ni aller-retour de structuremsgspecdans le parcours critique. - Suppression du second encodage du SDK :
fast_append.pytransmet directement les octets présérialisés à l’ajout FFI du canal élastique, en contournant l’étape interneencode_linesdeappend_rows_with_wait. - Résultat strictement identique à Python, octet par octet :
native/generate_tables.pyrécupère directement toutes les tables pondérées et les chaînes de prix préformatées depuisresort_sales.py. Rust réutilise les données déjà résolues, sans réimplémenter la logique business. Les tests unitaires vérifient que les parcours natif et Python produisent un NDJSON identique.
UNIT_PRICE et AMOUNT sont intégrés sous forme de chaînes décimales lors de la génération du code, via le formatage json.dumps de Python. Ainsi, le formatage des nombres à virgule flottante en Rust correspond toujours à celui de Python pour l’ensemble fini des combinaisons (item, tier, quantity) possibles.
Lorsque le wheel n’est pas installé, le banc de test bascule automatiquement vers l’encodage msgspec en Python. Lors des benchmarks en production, Rust est activé par défaut (ELASTIC_FAST_JSON_ENCODE=true).
Résultat : chaque worker doté de 1 vCPU maintient un débit d’environ 0,086 GiB/s tout en conservant suffisamment de ressources CPU pour les E/S réseau du SDK. Ce débit par worker permet une évolution linéaire jusqu’à 455 workers.
Ce que nous avons appris
- Elastic Channels est simple à intégrer : appelez
get_elastic_channel(), ajoutez les lignes ou les octets préencodés, et le tour est joué. - Le débit évolue de façon linéaire avec le nombre de workers : La capacité à faire évoluer le nombre de workers de 15 à 455 ne révèle aucun point d’inflexion dans la courbe ni aucun bridage.
- Des pods correctement dimensionnés surpassent les pods surdimensionnés : 1 vCPU / 1 GiB suffit lorsque l’encodage n’est pas votre goulot d’étranglement.
- Les charges de travail synthétiques sont une feature, pas une triche : La génération déterministe au sein du processus élimine les variations d’E/S et garantit la reproductibilité des exécutions. Un point stratégique lorsque vous comparez des architectures, et non des sources de données.
- L’optimisation côté client reste essentielle : Même avec un cœur serveur en Rust, réduire de moitié l’utilisation du CPU client permet presque de doubler le nombre de Streams pris en charge par chaque hôte.
Découvrez une démo d’Elastic Channels
Regardez cette vidéo qui présente Elastic Channels dans Snowflake à travers un cas d’usage IoT.
Essayez
Tout ce dont vous avez besoin pour reproduire une exécution minimale de bout en bout se trouve dans le référentiel. Nul besoin de 455 workers pour valider le pipeline : un seul Elastic Channel exécuté pendant une minute suffit à vérifier la connectivité, la configuration du pipe et les métriques en temps réel.
1. Cloner et configurer
git clone https://github.com/snowflake-labs/snowflake-elastic-channels.git
cd snowflake-elastic-channels
pip install -r requirements.txt
cp .env.example .env   # Snowflake account, user, key-pair auth
python scripts/setup_elastic_ramp.py --ingest-ip <YOUR_INGEST_IP>
2. Effectuer la configuration initiale d’EKS, sauf si vous souhaitez uniquement exécuter des microbenchmarks locaux
./infra/eks/create_cluster.sh
./infra/eks/build_and_push.sh
./infra/eks/create_secret.sh
./infra/eks/allowlist_eks.sh
./infra/eks/deploy_monitor.sh
3. Exécuter un test de bon fonctionnement avec un seul worker et un seul canal
./infra/eks/run_job.sh quicktest-$(date +%Y%m%d%H%M%S) \
    --target-bps 100000000 \
    --duration-seconds 60 \
    --workers 1
Suivez le débit en direct dans Snowflake :
SELECT *
FROM SC_DB.SC_SCHEMA.ELASTIC_K8S_METRICS
WHERE RUN_ID = '<your-run-id>'
ORDER BY WINDOW_START;
Lorsque vous êtes prêt à faire évoluer le déploiement, --workers accepte toute valeur comprise entre 1 et 455 ; le groupe de nœuds adapte automatiquement sa taille.
4. Exécuter un benchmark local côté client uniquement, sans Snowflake
python scripts/benchmark_client_cpu.py --workers 1 --aggregate-mbps 100Référentiel
Disponible sur GitHub.
| Chemin | Finalité |
|---|---|
src/elastic_channels/k8s_worker.py |
Point d’entrée du pod de worker |
src/elastic_channels/resort_sales.py |
Générateur de lignes POS synthétiques |
native/ |
Encodeur NDJSON rapide en Rust |
infra/eks/run_job.sh |
Orchestrateur du benchmark de mise à l’échelle |
streamlit/Monitor_App.py |
Tableau de bord en direct du débit et de la latence |
docs/architecture.md |
Conception complète du système |
Points d’attention
- Ces résultats reposent sur un compte Snowflake, une région (
us-west-2) et un format de ligne synthétique, avec des lignes NDJSON d’environ 277 octets, dans une table sans clustering. La largeur de vos lignes, la définition de votre pipe et les limites de votre compte peuvent différer. - La comparaison, supérieure à 3,5×, porte sur Snowpipe Streaming tel que présenté au Summit 2024, à environ 10 Go/s ; ce benchmark utilise l’architecture haute performance lancée en 2025 avec Elastic Channels, qui apporte une capacité élastique. Même hypothèse de taille de ligne, environ 277 octets ; il s’agit d’une comparaison indicative, et non d’une reproduction comparative contrôlée.
- La plupart des étapes de mise à l’échelle reposent sur une mesure unique plutôt que sur des essais répétés.
- L’analyse des coûts n’entre pas dans le périmètre de cet article ; la tarification de Snowpipe Streaming basée sur le débit s’applique au volume non compressé ingéré et peut être calculée pour chaque cas d’usage.
- Pour atteindre de tels volumes, vous devrez contacter l’équipe en charge de votre compte client ou le support afin d’augmenter la capacité du compte.
