19. Okt. 2026/Lesezeit: 14 MinutenData Engineering
Erreichen von 41 GB/s in einer Tabelle: Benchmarking von Elastic Channels für Snowpipe Streaming
Der Legende nach hat Snowflake seinen Namen erhalten, weil die Gründer des Unternehmens einfach sehr gerne auf die Piste gingen. Daher fühlte es sich nur richtig an, unsere neuen Elastic Channels zu testen, indem wir die Resort-Umsätze einer ganzen Skisaison durch das System leiteten.
Wenn Ihre Anwendungen wachsen und mehr Geräte online gehen, benötigen Sie eine einfache Möglichkeit, Daten für Analytics und KI in Snowflake zu integrieren. Wir haben kürzlich die allgemeine Verfügbarkeit von Elastic Channels für Snowpipe Streaming angekündigt, mit denen Sie Ereignisse direkt aus Anwendungen, Geräten und Diensten senden können, während Snowflake die Skalierung der Ingestion verwaltet. Aber wie verhält sich dieser einfachere Weg, wenn die Datenmengen wachsen?
Um dieser Frage nachzugehen, haben wir einen synthetischen Resort-Sales-Workload erstellt und die Anzahl der unabhängigen Produzenten erhöht, wodurch ein Gesamtdurchsatz von 41 GB/s erreicht wurde. Wir haben diesen Benchmark mit einer Snowflake FDN-Tabelle (nativ) als Ziel ausgeführt und ihn für die von Snowflake verwaltete Apache Iceberg™-Tabelle wiederholt. Dieser Beitrag untersucht, wie sich Durchsatz und Datenaktualität mit zunehmender Last verändert haben und was die Ergebnisse für Ihre eigenen Workloads bedeuten.
Hintergrund
Snowpipe Streaming bietet rigorose Exactly-Once-Semantik und strikte Nachrichtenreihenfolge. Für geschäftskritische Workloads wie Change Data Capture (CDC), Finanztransaktionen und Bestandsverwaltung ist diese akribische Buchführung nicht verhandelbar – komplett mit explizitem Channel-Management, Offset-Tracking und clientseitiger Schema-Koordination.
Wenn Sie jedoch Telemetrie-Pipelines, Internet of Things (IoT)-Gerätenetzwerke oder hochvolumige Log-Analytics aufbauen, bei denen eine At-Least-Once-Bereitstellung völlig ausreicht, kann all dieser zusätzliche Overhead zu unnötiger Reibung führen. Genau aus diesem Grund haben wir Elastic Channels eingeführt: um die Komplexität des Channel-Lifecycle-Managements und der Offset-Buchführung zu beseitigen. Indem Sie Snowflake die Skalierung und Channel-Verteilung automatisch überlassen, erhalten Sie eine blitzschnelle Ingestion für Ihre leichteren Datenströme ohne den Engineering-Overhead.
In der vorherigen Version von Snowpipe Streaming mussten Clients für jeden Dateistapel spaltenbasierte Daten und Metadaten generieren, hochladen und zur Verarbeitung bei Snowflake registrieren. Im Jahr 2025 veröffentlichte Snowflake die High-Performance-Architektur: serverseitige PIPE-Objekte, Rust-basierte SDK-Kerne und einen neu gestalteten Ingest-Pfad, der einen Großteil der clientseitigen Last beseitigte. Die High-Performance-Architektur hat den Client so verändert, dass er jetzt nur noch JSON-Payloads generieren und an Snowflake senden muss. Snowflake akzeptiert diese JSON-Payloads und verarbeitet diese Daten asynchron mit PIPEs, die in unserer hochskalierbaren Snowpipe-Infrastruktur ausgeführt werden. Diese Änderungen haben einen erheblichen Teil des Rechenressource- und Speicher-Overheads von den Clients entfernt und so die Bereitstellungen vereinfacht. Elastic Channels (client.get_elastic_channel()) bauen auf der High-Performance-Architektur auf – ein SDK-Client öffnet automatisch einen gepoolten Channel, ohne Channel-Namen und ohne Offset-Management – und schreiben dabei in dieselbe High-Performance-Pipe.
Die Frage, die wir in diesem Test beantworten wollten, war einfach: Wie schnell können Elastic Channels tatsächlich sein und wie effizient?
Die Antwort hat uns überrascht. Mit einem optimalen clientseitigen Design und einer horizontal skalierten Kubernetes-Flotte haben wir einen anhaltenden Gesamtdurchsatz gemessen, der mehr als 3,5-mal so hoch ist wie bei früheren Versionen, und das bei weniger Gesamtkernen, weniger Speicher und weitaus weniger Worker-Prozessen als bei vergleichbaren Ingest-Benchmarks im Petabyte-Maßstab, die anderswo in der Branche veröffentlicht wurden.
Auf einen Blick
Snowpipe Streaming mit Elastic Channels hielt 41,8 GB/s (133,5 Millionen Zeilen pro Sekunde) in einer einzigen FDN-Snowflake-Tabelle aufrecht – mehr als das 3,5-Fache früherer Versionen von Snowpipe Streaming – unter Verwendung von 455 leichtgewichtigen Kubernetes-Workern auf 455 vCPU und 455 GiB Speicher, ohne Fehler und mit linearer Skalierung über jeden getesteten Schritt hinweg.
Spitzendurchsatz (unkomprimiert) |
41,8 GB/s |
Spitzenzeilenrate |
133,5 Millionen Zeilen pro Sekunde |
Worker |
455 (1 Elastic Channel) |
Rechenressource-Fußabdruck |
455 vCPU · 455 GiB Speicher |
Kubernetes-Knoten |
15 × m7g.8xlarge (Graviton) |
im Vergleich zum vorherigen Snowpipe Streaming |
>3,5-mal höherer Durchsatz |
Was wir getestet haben
Wir haben ein Open Source-Benchmark-Harness (snowflake-elastic-channels) entwickelt, das das snowpipe-streaming Python-SDK direkt ausführt:
- Einfache Bereitstellung: Ein Worker-Pod = ein SDK-Client = ein Elastic Channel gegen eine gemeinsam genutzte RESORT_SALES_PIPE.
- Raten- und Durchsatzkonfiguration: Zielrate pro Worker für eine feste Dauer; der Gesamtdurchsatz ist die Summe über alle Pods.
- Live-Observability: Ein im Cluster ansässiger Monitor verfolgt Worker-Protokolle und schreibt Durchsatz-/Latenzfenster in Snowflake (
ELASTIC_K8S_METRICS), während der Lauf noch im Gange ist. - Typisierte Landung:
MATCH_BY_COLUMN_NAME = CASE_SENSITIVEordnet JSON-Schlüssel direkt Tabellenspalten zu (nicht einem einzigenVARIANT-Blob). - Konfigurierbares Ziel: Daten landen in FDN-Tabellen oder Apache Iceberg-Tabellen.
Jede der folgenden Messungen ist eine tatsächliche Zahl aus einer horizontalen Skalierung auf Amazon EKS in us-west-2 im September 2026. Wir berichten über unkomprimierte Bytes und Zeilenanzahlen, wie sie vom SDK und Monitor beobachtet wurden – keine Extrapolation.
Der Workload: Synthetische Resort-Umsätze im Produktionsmaßstab
Das Lesen aus Kafka, S3 oder einem öffentlichen Dataset führt Produzentenlimits ein, die verschleiern, was Snowpipe Streaming selbst leisten kann. Daher haben wir Daten im Prozess fabriziert, um externe Engpässe zu beseitigen.
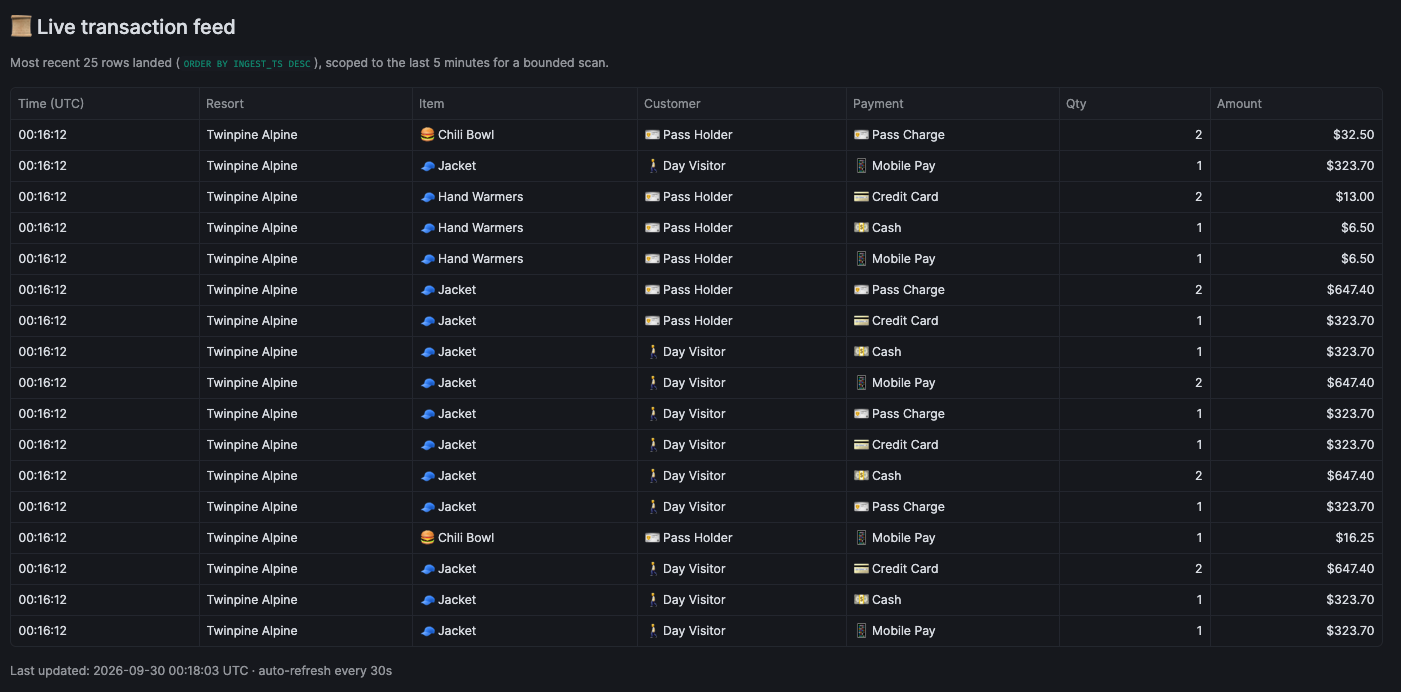
Der von uns gewählte Anwendungsfall umfasste Point-of-Sale (POS)-Transaktionen über ein synthetisches Skigebiet-Portfolio hinweg: 42 Resorts, vier Produktkategorien (Saisonkarten, Tageskarten, Essen und Trinken, Merchandise), Zahlungsmethoden, Kundentypen und Preisstufen pro Resort. Hier ist das Single-Table-Schema des Modells:
TXID, RESORT, CATEGORY, ITEM, CUSTOMER_TYPE, PAYMENT_METHOD,
QUANTITY, UNIT_PRICE, AMOUNT, SALE_TIME, RUN_ID, WORKER_ID
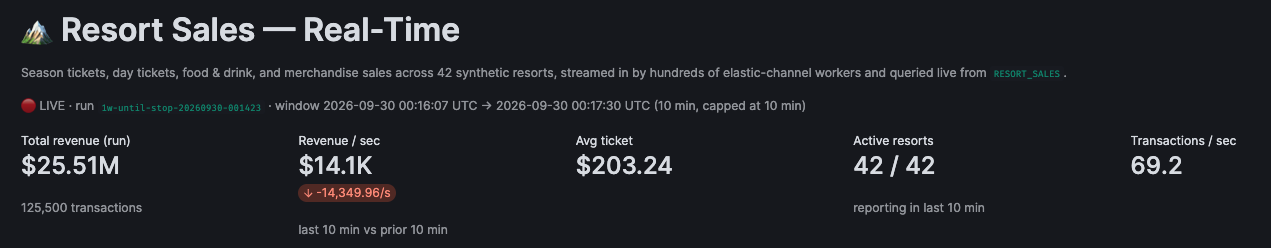
Jedes Resort verfügt über ein deterministisches Umsatzprofil (relatives Volumen, Kategorie-Mix, Preisstufe, Anteil der Passinhaber:innen), sodass aggregierte Analysen realistisch aussehen – Umsatz nach Resort, Mix-Verschiebungen, geografische Muster – und nicht wie gleichmäßiges zufälliges Rauschen. Ein Streamlit-Dashboard im Repo visualisiert den Live-Feed so, als würden Sie eine nationale Resort-Kette an einem geschäftigen Feiertagswochenende beobachten.
Wir liefen absichtlich weit über dem, was ein einzelner Resort-POS generieren würde. Das war der Punkt: Isolieren der Snowflake-Ingest-Kapazität, nicht des POS-Realismus. Die Zeilen umfassten durchschnittlich ~277 Bytes unkomprimiertes NDJSON. Die Generierung war auf dem Hot Path RNG-frei – eine vorgefertigte gewichtete Tabelle ist Round-Robin-indiziert –, sodass der Client beim Zieldurchsatz nie zum Engpass wurde.
Ein Streamlit-Dashboard stand auch der Resort-Führung zur Verfügung, um Umsatz und Ertrag in ihren Resorts zu überwachen und das Kundenverhalten in Echtzeit zu verfolgen. Point-of-Sale-Transaktionen wurden in deutlich weniger als einer Minute in das Dashboard aufgenommen.
Kubernetes-Bereitstellung
Der Benchmark lief auf einem persistenten EKS-Cluster (snowflake-elastic-channels). Worker-Knoten wurden für jeden Lauf hochskaliert und danach wieder auf null zurückgesetzt; nur ein kleiner Systemknoten und eine Monitor-Bereitstellung blieben immer eingeschaltet.
Architektur
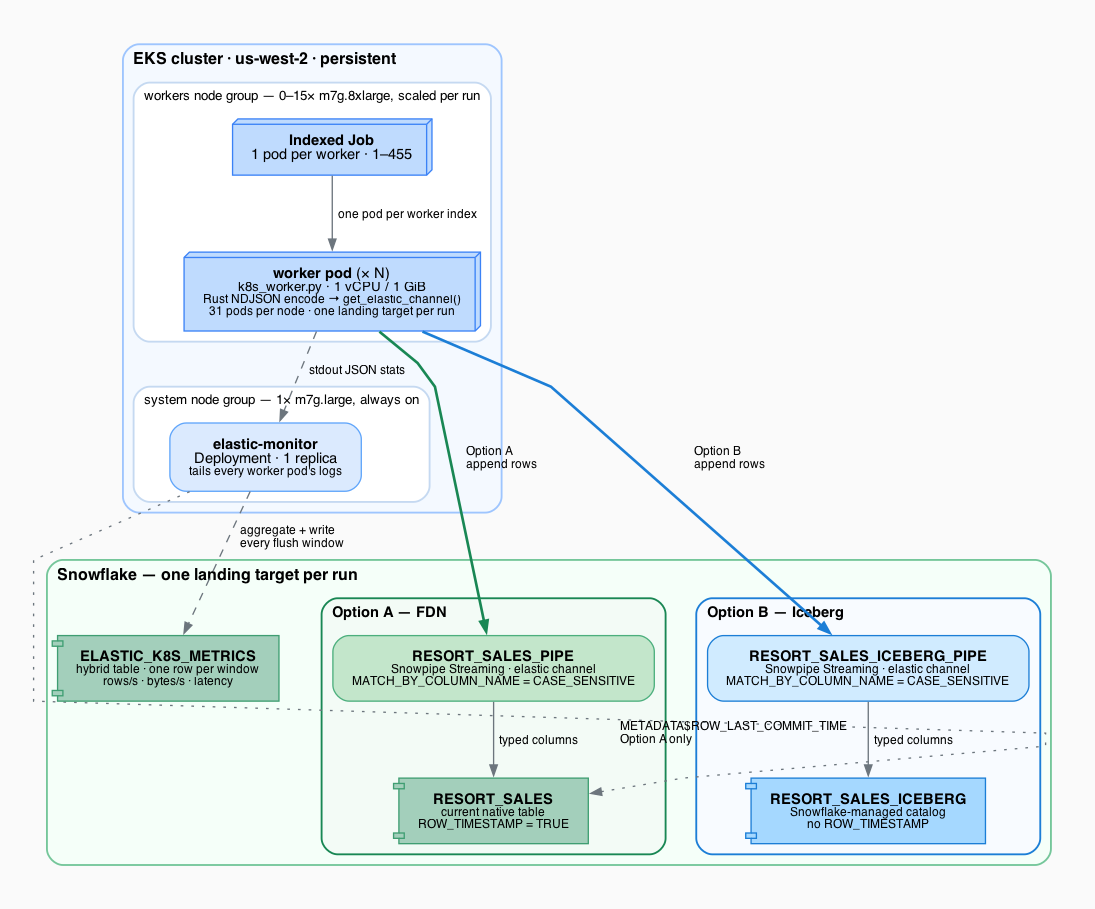
Benchmark-Parameter
| Parameter | Value (Wert) |
|---|---|
| Worker-Pods | 455 |
| Channels | 1 (gemeinsam genutzt, elastisch) |
| Worker-CPU-Anforderung/-Limit | 1 vCPU |
| Worker-Speicheranforderung/-Limit | 1 GiB |
| Worker pro Knoten | 31 (m7g.8xlarge, Graviton arm64) |
| Worker-Knoten in der Spitze | 15 |
| Gesamte Worker-vCPU | 455 |
| Gesamter Worker-Arbeitsspeicher | 455 GiB |
| Nachrichtenformat | NDJSON (typisierte Spaltenzuordnung) |
| Durchschnittliche Zeilengröße (unkomprimiert) | ~277 Bytes |
| Schneller Encode-Pfad | ELASTIC_FAST_JSON_ENCODE=true (Standard) |
| SDK | snowpipe-streaming-Python-Paket |
| Ingest-Pipe | RESORT_SALES_PIPE → RESORT_SALES |
Worker-Pods wurden anhand der gemessenen Steady-State-Nutzung richtig dimensioniert. Die CPU ist die bindende Einschränkung beim Node-Packing und benötigt ~240m-540m CPU, wobei 1000m einem vollen vCPU entsprechen, der zugewiesen wurde. Die beobachtete Speicherauslastung lag zwischen 68 und 183 MiB RSS, wobei 1 GiB zugewiesen wurde. Ein m7g.8xlarge führt 31 Worker pro Node aus, mit ausreichend Spielraum beim Speicher.
Performance-Ergebnisse
Anhaltender Spitzendurchsatz auf FDN
| Metrik | Value (Wert) |
|---|---|
| Anhaltender Durchsatz (unkomprimiert) | 41,8 GB/s |
| Anhaltende Zeilenrate | 133,5 Mio. Zeilen pro Sekunde |
| Worker in der Spitze | 455 |
| Durchsatz pro Worker | ~92 MB/s (~293.000 Zeilen pro Sekunde), im Wesentlichen flach von 15 bis 455 Workern |
| Drosselung | Keine beobachtet |
Vergleich mit Snowpipe Streaming
Auf dem Summit 2024 demonstrierte Snowflake die vorherige Version von Snowpipe Streaming mit einer Ingestion von insgesamt rund 10 GB/s in eine einzige Tabelle – ein damaliges Meilenstein-Ergebnis. Unser Benchmark läuft auf dem hochleistungsfähigen Snowpipe Streaming unter Verwendung des neu veröffentlichten Elastic Channels-Feature, das Durchsatzraten von mehr als dem 3,5-Fachen der vorherigen Benchmarks sowohl auf FDN- als auch auf von Snowflake verwalteten Apache Iceberg-Tabellen erzielte.
| Original-Demo vom Summit 2024 (ca.) | HP + Elastic Channels in FDN-Tabellen | HP + Elastic Channels in von Snowflake verwaltete Apache Iceberg-Tabellen | |
|---|---|---|---|
| Durchsatz (unkomprimiert) | ~10 GB/s | 41,8 GB/s | 39,0 GB/s |
| Zeilenrate | ~39 Mio. Zeilen pro Sekunde¹ | 133,5 Mio. Zeilen pro Sekunde | 121,6 Mio. Zeilen pro Sekunde |
| Beschleunigung | — | > 3,5-fach |
¹ Geschätzt auf ~277 Byte/Zeile, um der Zeilenform dieses Workload zu entsprechen.
Horizontale Skalierung (EKS-horizontale Skalierung)
Der Durchsatz folgte der Anzahl der Worker bei jedem Schritt fast genau – eine saubere lineare Skalierung ohne Plateau. Die Latenz blieb in einem begrenzten Bereich, selbst als der Durchsatz stieg: Batch-Ack (SDK-Future-Abschluss) lag über alle Schritte hinweg im Durchschnitt bei fast 600 ms. Die Batch-Ack-Zeit ist die Gesamtdauer vom Senden der Daten durch den Client in das SDK bis zum Empfang des Callbacks (Daten sind dauerhaft). Die Ingest-to-Visible-Latenz (SALE_TIME → METADATA$ROW_LAST_COMMIT_TIME) blieb im Bereich von ~12–29 Sekunden – Daten waren innerhalb von Sekunden nach dem Eintreffen abfragbar, selbst bei 133,5 Millionen Zeilen pro Sekunde. Dies ist die Dauer, bis Daten in Abfragen einbezogen werden.
| Worker | Nodes | Zeilen pro Sekunde | Durchsatz | Durchschnittliches Batch-Ack | Durchschnittliches Ingest-to-Visible² |
|---|---|---|---|---|---|
| 15 | 1 | 4,4 Mio. | 1,38 GB/s | 582 ms | 11,7 s |
| 90 | 3 | 26,6 Mio. | 8,27 GB/s | 595 ms | 14,0 s |
| 180 | 6 | 52,8 Mio. | 16,52 GB/s | 611 ms | 16,7 s |
| 300 | 10 | 87,8 Mio. | 27,50 GB/s | 572 ms | 17,7 s |
| 420 | 14 | 123,2 Mio. | 38,6 GB/s | 587 ms | 28,9 s |
| 455 | 15 | 133,5 Mio. | 41,84 GB/s | 570 ms | 19,9 s |
² Ingest-to-Visible-Latenz gemessen als TIMESTAMPDIFF(SALE_TIME, METADATA$ROW_LAST_COMMIT_TIME) aus ELASTIC_K8S_METRICS durch den Cluster-Monitor.
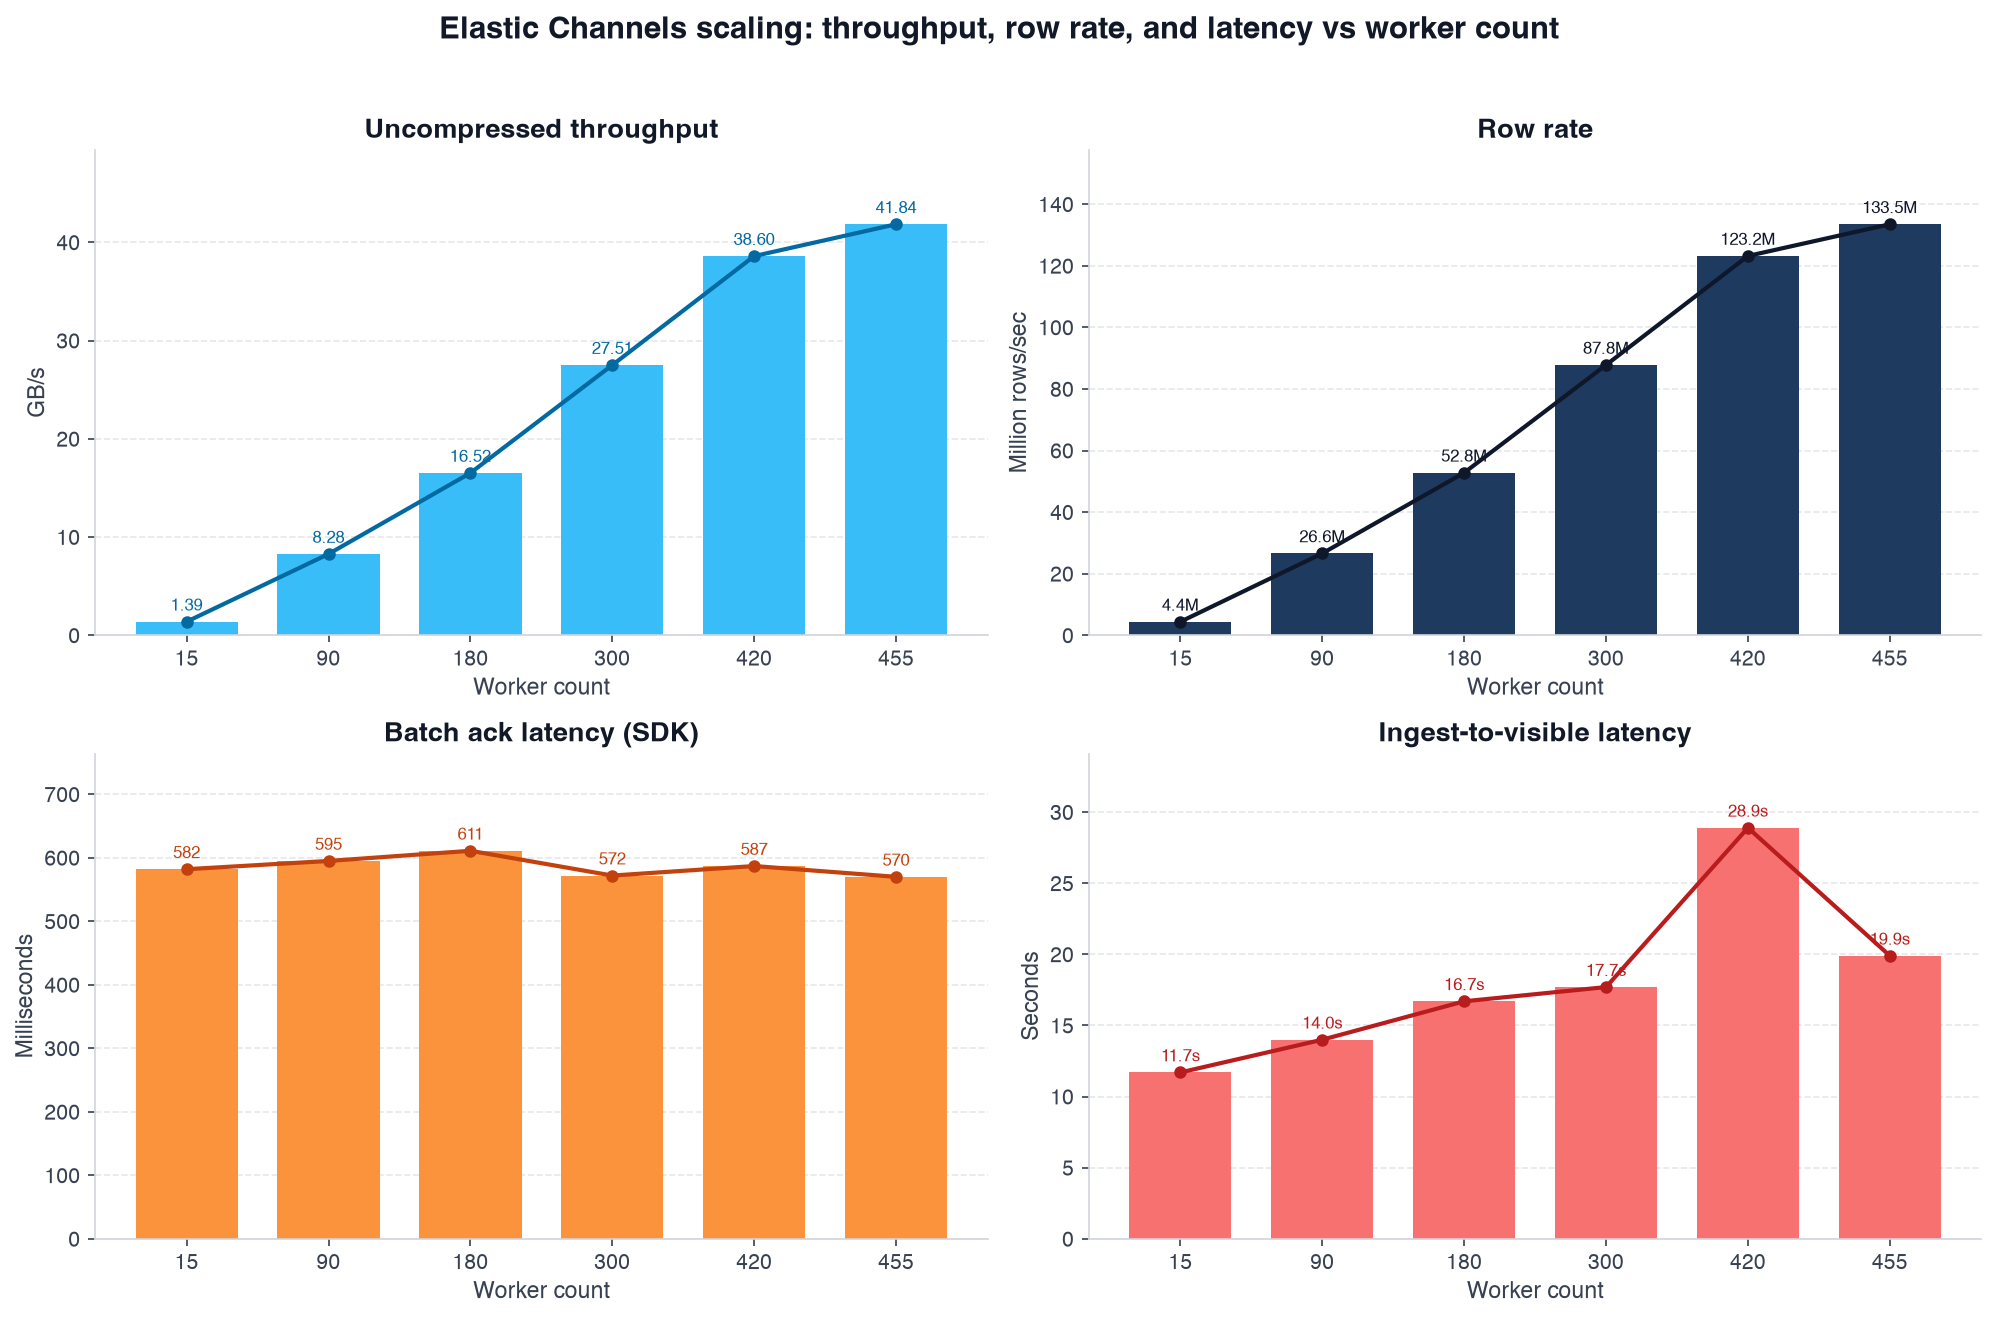
Zwei Latenzmetriken beantworten zwei verschiedene Fragen:
- Die Batch-Ack-Latenz (durchschnittlich ~570–611 ms) beantwortet die Frage: „Wie schnell hat das SDK meinen Batch akzeptiert?“ Sie wird clientseitig von
append_rows()bis zum Abschluss des SDK-Futures gemessen. Sie veränderte sich über den gesamten Bereich von 15 → 455 Workern kaum; der Client wartete nie darauf, dass Snowflake den nächsten Batch aufnimmt. - Die Ingest-to-Visible-Latenz (durchschnittlich ~12–29 s) beantwortet die Frage: „Wann kann ich diese Zeile abfragen?“ Sie wird serverseitig als
SALE_TIME→METADATA$ROW_LAST_COMMIT_TIMEgemessen. Dies ist die Zahl, die für Dashboards und operative Analytics wichtig ist. Sie stieg nicht proportional zum Durchsatz – eine 30-fache Erhöhung der Zeilenrate führte nicht zu einer 30-fachen Erhöhung der Time-to-Queryable – und blieb während der gesamten Kampagne in einem praktischen Bereich für Resort-Sales-Dashboards in Echtzeit.
Der Skalierungshebel ist horizontal: Fügen Sie leichtgewichtige Worker-Pods hinzu, keine größeren Pods. Einem einzelnen Worker mehr CPU zuzuweisen, erhöhte in unseren Tests nicht dessen Durchsatz; jeder Pod mit 1 vCPU / 1 GiB trug unabhängig davon die gleichen ~0,086 GiB/s bei.
Ressourceneffizienz auf höchstem Niveau
Stellt man die wichtigsten Zahlen einem typischen Streaming-Benchmark-Layout der Branche im Petabyte-Maßstab gegenüber, wird die Effizienz deutlich.
| Typischer groß angelegter Streaming-Benchmark³ | Snowpipe Streaming Elastic Channels zu FDN-Tabelle | Snowpipe Streaming Elastic Channels zu von Snowflake verwalteter Apache Iceberg Table | |
|---|---|---|---|
| Gleichzeitige Worker | 2.048 | 455 | 455 |
| Kerne pro Worker | 1,5 | 1,0 | 1,0 |
| Arbeitsspeicher pro Worker | 2 GiB | 1 GiB | 1 GiB |
| Gesamte Worker-Kerne | 3.072 | 455 | 455 |
| Gesamter Worker-Arbeitsspeicher | 4.096 GiB | 455 GiB | 455 GiB |
| Anhaltender Durchsatz | ~12 GB/s | ~41,8 GB/s | ~39,0 GB/s |
| Anhaltende Zeilen pro Sekunde | ~12 Mio. | 133,5 Mio. | 121,6 Mio. |
³ Repräsentative veröffentlichte Parameter für einen 24-stündigen Single-Table-Ingest-Benchmark im Petabyte-Maßstab unter Verwendung von Tausenden von Kubernetes-Producer-Pods und einem nativen binären Zeilen-Encoder.
Wir verwendeten etwa ein Siebtel der Kerne, ein Neuntel des Arbeitsspeichers und weniger als ein Viertel der Worker-Prozesse – und lieferten dennoch mehr als das Dreifache der Bytes pro Sekunde und mehr als das Zehnfache der Zeilen pro Sekunde sowohl auf FDN- als auch auf Apache Iceberg-Tabellen als Ziel.
Wie wir hierher gekommen sind: Die Entwicklung von Snowpipe Streaming
Dieses Projekt begann dort, wo viele Snowflake-Streaming-Evaluierungen beginnen – auf großen EC2-Instanzen mit Dutzenden von Workern pro Host, expliziten Kanälen und Python-Zeilen-Dicts, die bei jedem Batch erstellt werden. Diese Durchläufe waren wertvoll: Sie deckten clientseitige Obergrenzen lange vor Snowflake auf.
| Ära | Was wir gemessen haben | Was uns eingeschränkt hat |
|---|---|---|
| Vorherige Version von Snowpipe Streaming (Summit 2024 Demo) | ~10 GB/s auf der Bühne; unter 1 GB/s pro Host in unseren frühen Phasen | Kanal-/Offset-Overhead, clientseitige Spaltenbildung und Metadaten, klassische SDK-Architektur |
| High-Performance-Architektur (veröffentlicht 2025) | ~2–8 GB/s pro großer Instanz; ~16 GB/s anhaltend über mehrere Knoten auf EC2 | Netzwerk pro Host, Worker-/Kanalverwaltung, Python-Codierungspfad |
| Elastic Channels + EKS + Rust-Codierung | 41,8 GB/s bei 455 Workern | Nichts in diesem Test – lineare Skalierung über den unterstützten Bereich |
Drei Änderungen kamen zusammen:
- Elastic Channels:
get_elastic_channel()bündelt alle Kanäle unter einem Client. Der Anwendungscode verwaltet keine Namen und Offsets mehr. - Kubernetes in der richtigen Granularität: Ein Pod pro Worker, jeweils 1 vCPU, 31 Pods pro Graviton-Knoten. Skalieren Sie die Flotte, nicht den Prozess.
- Ein schneller Rust-Pfad für Generierung und Codierung: Python ist Orchestrierung, nicht die Hot Loop, wie unten beschrieben.
Die Updates für Snowpipe Streaming, einschließlich der Hinzufügung von Elastic Channels, machen das Senden von Daten an Snowflake besser denn je. Die High-Performance-Architektur von Snowpipe Streaming ermöglicht es, riesige Datenmengen schnell und einfach in einer skalierbaren, serverlosen Infrastruktur zu erfassen und in Sekundenschnelle von der Quelle abzufragen. Die Abrechnung ist einfach und basiert auf den erfassten Gigabytes. Es gibt heute auf dem Markt keine einfachere und skalierbarere Möglichkeit, Streaming-Daten abzufragen.
Warum Rust für die Datencodierung
Bei Hunderttausenden von Zeilen pro Sekunde pro Worker dominieren die Python-Dict-Zuweisung und die JSON-Serialisierung die CPU. Der Standardpfad des SDK akzeptiert Zeilen-Dicts und codiert sie intern neu – korrekt, aber redundant, wenn Sie das Schema bereits kennen.
Um die CPU und den Arbeitsspeicher des Workers am effizientesten zu nutzen, wurden Daten in Rust generiert und serialisiert. Dies verwendet interne Methoden des SDK. Diese Methoden können sich in Zukunft ändern, was Upgrades erschwert.
Wir haben eine optionale native Erweiterung hinzugefügt (native/, die mit PyO3 + maturin in das Worker-Docker-Image integriert ist), die sowohl die Zeilengenerierung als auch die NDJSON-Serialisierung in Rust durchführt:
- Überspringen von Python-Objekten pro Zeile: Kein
dictpro Zeile, keinmsgspec-Struct-Roundtrip auf dem Hot Path. - Überspringen der zweiten Codierung des SDK:
fast_append.pyübergibt vorserialisierte Bytes direkt an den FFI-Append des Elastic Channel und umgeht den internenencode_lines-Durchlauf vonappend_rows_with_wait. - Bleiben Sie byte-identisch zu Python:
native/generate_tables.pyleitet alle gewichteten Tabellen und vorformatierten Preis-Strings vonresort_sales.pyselbst ab. Rust gibt aufgelöste Daten wieder; es implementiert keine Geschäftslogik neu. Unit-Tests stellen sicher, dass die nativen und Python-Pfade identisches NDJSON erzeugen.
UNIT_PRICE und AMOUNT werden zur Codegen-Zeit als Dezimal-Strings gebacken (über die json.dumps-Formatierung von Python), sodass Rust bei der endlichen Menge der auftretenden (item, tier, quantity)-Kombinationen nie mit der Float-Formatierung von Python nicht übereinstimmt.
Wenn das Wheel nicht installiert ist, greift der Harness automatisch auf die msgspec-Codierung in Python zurück. Bei Produktions-Benchmark-Durchläufen ist Rust standardmäßig aktiviert (ELASTIC_FAST_JSON_ENCODE=true).
Das Ergebnis: Jeder Worker mit 1 vCPU hält ~0,086 GiB/s aufrecht, wobei noch CPU für die Netzwerk-E/A des SDK übrig bleibt – der Durchsatz pro Worker, der eine lineare Skalierung auf 455 Worker ermöglicht.
Was wir gelernt haben
- Elastic Channels sind einfach zu integrieren: Rufen Sie
get_elastic_channel()auf, hängen Sie Zeilen (oder vorcodierte Bytes) an, fertig. - Der Durchsatz skaliert linear mit der Anzahl der Worker: Mit der Möglichkeit, von 15 auf 455 Worker zu skalieren, gibt es keinen Knick in der Kurve und es wurde keine Drosselung beobachtet.
- Richtig dimensionierte Pods schlagen fette Pods: 1 vCPU / 1 GiB ist ausreichend, wenn die Codierung nicht Ihr Engpass ist.
- Synthetische Workloads sind ein Feature, kein Betrug: Die deterministische In-Process-Generierung beseitigt E/A-Verzerrungen und macht Durchläufe reproduzierbar – entscheidend, wenn Sie Architekturen und nicht Datenquellen vergleichen.
- Clientseitige Optimierung ist immer noch wichtig: Selbst mit einem Rust-Serverkern verdoppelt eine Halbierung der Client-CPU in etwa die Anzahl der Streams, die Sie sich pro Host leisten können.
Sehen Sie sich eine Demo von Elastic Channels an
Sehen Sie sich ein Video an, das Elastic Channels in Snowflake für einen IoT-Anwendungsfall demonstriert.
Probieren Sie es selbst aus
Alles, was zur Reproduktion eines minimalen End-to-End-Durchlaufs erforderlich ist, befindet sich im Repository. Sie benötigen keine 455 Worker, um die Pipeline zu validieren – ein einzelner Elastic Channel für eine Minute reicht aus, um Konnektivität, Pipe-Konfiguration und Live-Metriken nachzuweisen.
1. Klonen und konfigurieren
git clone https://github.com/snowflake-labs/snowflake-elastic-channels.git
cd snowflake-elastic-channels
pip install -r requirements.txt
cp .env.example .env   # Snowflake account, user, key-pair auth
python scripts/setup_elastic_ramp.py --ingest-ip <YOUR_INGEST_IP>
2. Führen Sie das einmalige EKS-Setup durch (oder überspringen Sie es, wenn Sie nur lokale Mikro-Benchmarks wünschen)
./infra/eks/create_cluster.sh
./infra/eks/build_and_push.sh
./infra/eks/create_secret.sh
./infra/eks/allowlist_eks.sh
./infra/eks/deploy_monitor.sh
3. Führen Sie einen Smoke-Test mit einem einzelnen Worker / einzelnen Kanal durch
./infra/eks/run_job.sh quicktest-$(date +%Y%m%d%H%M%S) \
    --target-bps 100000000 \
    --duration-seconds 60 \
    --workers 1
Beobachten Sie den Live-Durchsatz in Snowflake:
SELECT *
FROM SC_DB.SC_SCHEMA.ELASTIC_K8S_METRICS
WHERE RUN_ID = '<your-run-id>'
ORDER BY WINDOW_START;
Wenn Sie bereit sind, die Skalierung zu erkunden, akzeptiert --workers jeden Wert von 1 bis 455; die Knotengruppe passt ihre Größe automatisch an.
4. Führen Sie einen lokalen reinen Client-Benchmark durch (kein Snowflake erforderlich)
python scripts/benchmark_client_cpu.py --workers 1 --aggregate-mbps 100Repository
Verfügbar auf GitHub.
| Pfad | Zweck |
|---|---|
src/elastic_channels/k8s_worker.py |
Worker-Pod-Einstiegspunkt |
src/elastic_channels/resort_sales.py |
Synthetischer POS-Zeilengenerator |
native/ |
Schneller Rust-NDJSON-Encoder |
infra/eks/run_job.sh |
Benchmark-Orchestrator für horizontale Skalierung |
streamlit/Monitor_App.py |
Live-Durchsatz-/Latenz-Dashboard |
docs/architecture.md |
Vollständiges Systemdesign |
Vorbehalte
- Die Ergebnisse spiegeln ein Snowflake-Konto, eine Region (
us-west-2) und eine synthetische Zeilenform (~277-Byte-NDJSON-Zeilen) in einer nicht geclusterten Tabelle wider. Ihre Zeilenbreite, Pipe-Definition und Konto-Limits können abweichen. - Der > 3,5-fache Vergleich bezieht sich auf Snowpipe Streaming, wie auf dem Summit 2024 demonstriert (~10 GB/s); dieser Benchmark verwendet die High-Performance-Architektur, die 2025 mit Elastic Channels veröffentlicht wurde. Gleiche Annahme zur Zeilengröße (~277 Byte); richtungsweisend, kein kontrolliertes Side-by-Side-Replay.
- Die meisten Schritte für die horizontale Skalierung sind Einzelmessungen und keine wiederholten Versuche.
- Eine Kostenanalyse sprengt den Rahmen dieses Beitrags; die durchsatzbasierte Preisgestaltung für Snowpipe Streaming gilt für das erfasste unkomprimierte Volumen und kann pro Anwendungsfall berechnet werden.
- Um diese Volumen zu erreichen, müssten die zuständigen Account-Teams oder der Support kontaktiert werden, um die Kontokapazität zu erhöhen.
