19 ottobre 2026/Lettura: 17 minData engineering
Raggiungere 41 GB/sec su 1 tabella: benchmark di Elastic Channels per Snowpipe Streaming
Si narra che Snowflake abbia preso il nome perché ai fondatori dell’azienda piaceva davvero tanto sciare, quindi ci è sembrato naturale testare i nuovi Elastic Channels facendo passare attraverso il sistema le vendite di un’intera stagione sciistica in un resort.
Con la crescita delle applicazioni e la connessione di sempre più dispositivi, hai bisogno di un modo semplice per portare i dati in Snowflake per l’analisi dei dati e l’AI. Di recente abbiamo annunciato la general availability di Elastic Channels per Snowpipe Streaming, che consente di inviare eventi direttamente da applicazioni, dispositivi e servizi, mentre Snowflake gestisce la scalabilità dell’ingestion. Ma come si comporta questo percorso più semplice quando i volumi di dati crescono?
Per rispondere a questa domanda, abbiamo creato un workload sintetico di vendite di un resort e aumentato il numero di producer indipendenti, raggiungendo un throughput totale di 41 GB/sec. Abbiamo eseguito questo benchmark utilizzando come destinazione una tabella Snowflake FDN (nativa) e lo abbiamo ripetuto per la tabella Apache Iceberg™ gestita da Snowflake. Questo articolo analizza come sono cambiati il throughput e l’aggiornamento dei dati con l’aumento del carico, e cosa significano questi risultati per i tuoi workload.
Premesse
Snowpipe Streaming offre una rigorosa semantica exactly-once e un ordinamento rigoroso dei messaggi. Per i workload mission-critical come il change data capture (CDC), le transazioni finanziarie e la gestione dell’inventario, questa meticolosa gestione contabile non è negoziabile, con gestione esplicita dei canali, tracciamento degli offset e coordinamento degli schema lato client.
Ma se stai creando pipeline di telemetria, reti di dispositivi Internet delle cose (IoT) o analisi dei log ad alto volume, dove la consegna at-least-once è del tutto sufficiente, tutto quell’overhead aggiuntivo può diventare un attrito superfluo. È esattamente per questo che abbiamo introdotto Elastic Channels: eliminare la complessità della gestione del ciclo di vita dei canali e della gestione contabile degli offset. Lasciando che Snowflake gestisca automaticamente lo scaling e la distribuzione dei canali, ottieni un’ingestion fulminea per i tuoi stream di dati più leggeri, senza l’overhead operativo di ingegneria.
La versione precedente di Snowpipe Streaming richiedeva che i client generassero dati e metadati in formato colonnare per ogni batch di file, li caricassero e li registrassero con Snowflake per l’elaborazione. Nel 2025, Snowflake ha rilasciato l’architettura ad alte prestazioni: oggetti PIPE lato server, core SDK basati su Rust e un percorso di ingestion riprogettato che ha eliminato gran parte dell’onere lato client. L’architettura ad alte prestazioni ha cambiato il client, che ora deve solo generare e inviare payload JSON a Snowflake. Snowflake accetta questi payload JSON ed elabora questi dati in modo asincrono con PIPE in esecuzione nella nostra infrastruttura Snowpipe altamente scalabile. Queste modifiche hanno eliminato una parte sostanziale dell’overhead di capacità di calcolo e memoria dai client, semplificando i deployment. Elastic Channels (client.get_elastic_channel()) si basano sull’architettura ad alte prestazioni: un client SDK apre automaticamente un canale pooled, senza nomi di canale e senza gestione degli offset, scrivendo nella stessa pipe ad alte prestazioni.
La domanda a cui volevamo rispondere con questo test era semplice: quanto velocemente possono davvero andare gli Elastic Channels, e con quale efficienza?
La risposta ci ha sorpreso. Con un design lato client ottimale e una flotta Kubernetes scalata orizzontalmente, abbiamo misurato un throughput aggregato sostenuto superiore di oltre 3,5 volte rispetto alle versioni precedenti, utilizzando meno core totali, meno memoria e molti meno worker process rispetto a benchmark di ingestion su scala petabyte comparabili pubblicati altrove nel settore.
In breve:
Snowpipe Streaming con Elastic Channels ha sostenuto 41,8 GB/sec (133,5 milioni di righe al secondo) verso una singola tabella Snowflake FDN, oltre 3,5 volte le versioni precedenti di Snowpipe Streaming, utilizzando 455 worker Kubernetes leggeri su 455 vCPU e 455 GiB di memoria, con zero errori e uno scaling lineare in ogni fase testata.
Throughput massimo (non compresso) |
41,8 GB/sec |
Tasso di righe massimo |
133,5 milioni di righe al secondo |
Worker |
455 (1 canale elastico) |
Footprint di calcolo |
455 vCPU · 455 GiB di memoria |
Nodi Kubernetes |
15 × m7g.8xlarge (Graviton) |
vs. versione precedente di Snowpipe Streaming |
>3,5x throughput superiore |
Cosa abbiamo testato
Abbiamo creato un harness di benchmark open source (snowflake-elastic-channels) che testa direttamente l’SDK Python snowpipe-streaming:
- Deployment semplice: Un worker pod = un client SDK = un Elastic Channel su una RESORT_SALES_PIPE condivisa.
- Configurazione di rate e throughput: Rate target per worker per una durata fissa; il throughput aggregato è la somma su tutti i pod.
- Osservabilità live: Un monitor residente nel cluster segue i log dei worker e scrive finestre di throughput/latenza in Snowflake (
ELASTIC_K8S_METRICS) mentre l’esecuzione è ancora in corso. - Landing tipizzato:
MATCH_BY_COLUMN_NAME = CASE_SENSITIVEmappa le chiavi JSON direttamente sulle colonne della tabella (non in un unico BlobVARIANT). - Destinazione configurabile: I dati vengono scritti in tabelle FDN o in tabelle Apache Iceberg.
Ogni misurazione riportata di seguito è un numero reale ottenuto da uno scale-out orizzontale su Amazon EKS in us-west-2, nel settembre 2026. Riportiamo byte non compressi e conteggi di righe come osservati dall’SDK e dal monitor, senza estrapolazioni.
Il workload: vendite sintetiche di un resort su scala di produzione
Leggere da Kafka, S3 o da un data set pubblico introduce limiti del producer che oscurano ciò che Snowpipe Streaming è in grado di fare. Quindi abbiamo generato i dati in process per eliminare qualsiasi collo di bottiglia esterno.
Il caso d’uso che abbiamo scelto includeva transazioni point-of-sale (POS) in un portfolio sintetico di resort sciistici: 42 resort, quattro categorie di prodotto (abbonamenti stagionali, biglietti giornalieri, cibo e bevande, merchandising), metodi di pagamento, tipologie di cliente e livelli di prezzo per resort. Ecco lo schema a tabella singola del modello:
TXID, RESORT, CATEGORY, ITEM, CUSTOMER_TYPE, PAYMENT_METHOD,
QUANTITY, UNIT_PRICE, AMOUNT, SALE_TIME, RUN_ID, WORKER_ID
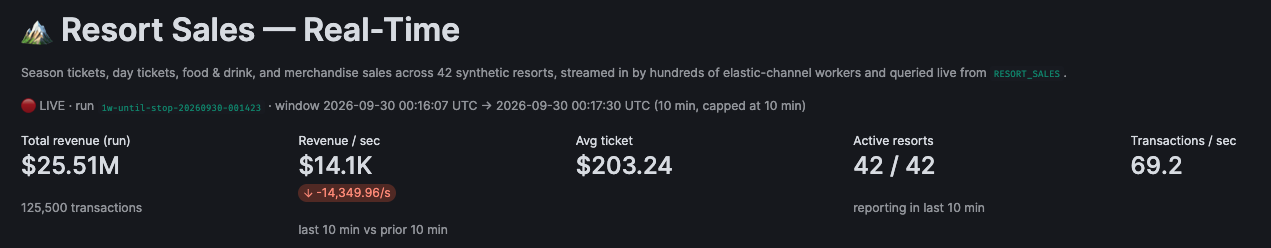
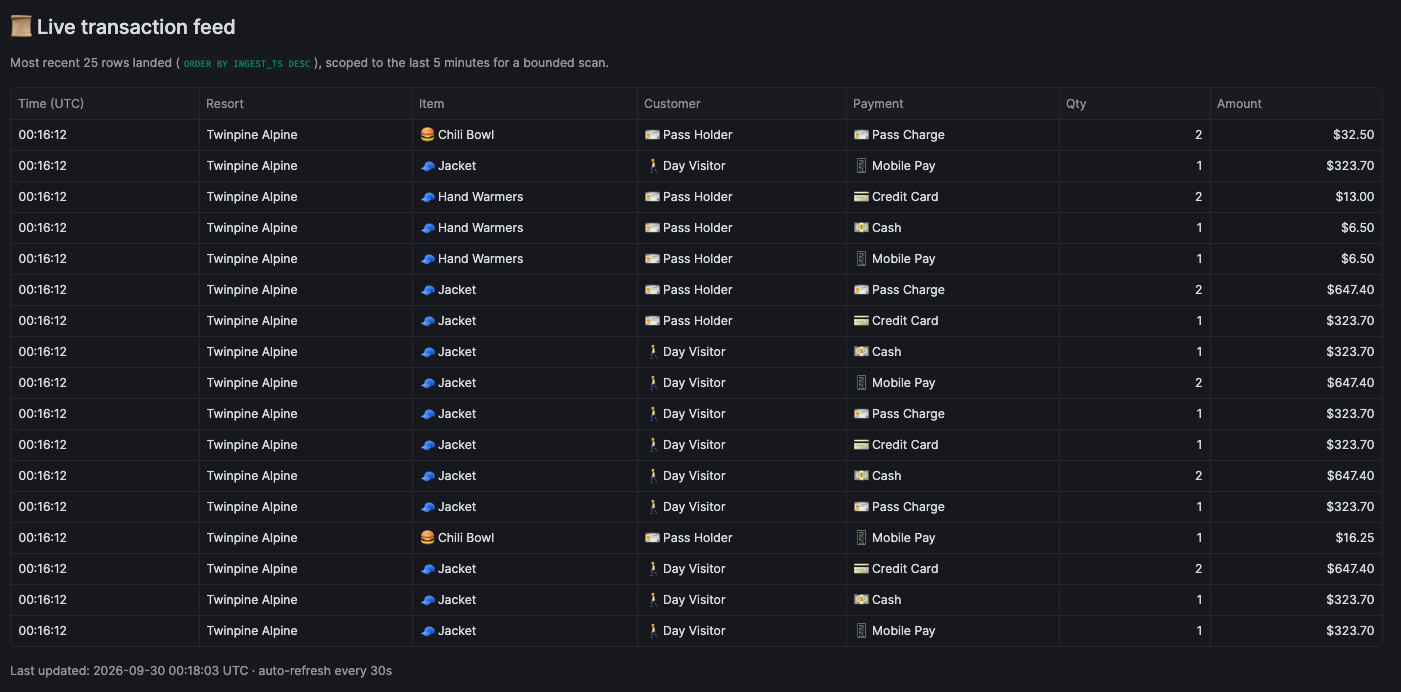
Ogni resort ha un profilo di vendita deterministico (volume relativo, mix di categorie, livello di prezzo, quota di possessori di abbonamento), in modo che l’analisi dei dati aggregata risulti realistica, con ricavi per resort, cambiamenti nel mix e pattern geografici, piuttosto che somigliare a un rumore casuale uniforme. Una dashboard Streamlit nel repository visualizza il feed live come se stessi osservando una catena nazionale di resort durante un fine settimana festivo molto affollato.
Abbiamo eseguito deliberatamente a un livello molto superiore rispetto a quanto genererebbe qualsiasi singolo POS di resort. Questo era l’obiettivo: Isolare la capacità di ingestion di Snowflake, non il realismo del POS. Le righe avevano una media di ~277 byte di NDJSON non compresso. La generazione era priva di RNG sul percorso critico (una tabella pesata precompilata è indicizzata in modalità round-robin), quindi il client non è mai diventato il collo di bottiglia al throughput target.
Una dashboard Streamlit era disponibile anche per la direzione del resort, per monitorare vendite e ricavi tra i vari resort e per monitorare il comportamento dei clienti in tempo reale. Le transazioni point-of-sale venivano incluse nella dashboard in ben meno di un minuto.
Deployment Kubernetes
Il benchmark è stato eseguito su un cluster EKS persistente (snowflake-elastic-channels). I nodi worker venivano scalati verso l’alto per ogni esecuzione e riportati a zero in seguito; solo un piccolo nodo di sistema e il deployment del monitor rimanevano sempre attivi.
Architettura
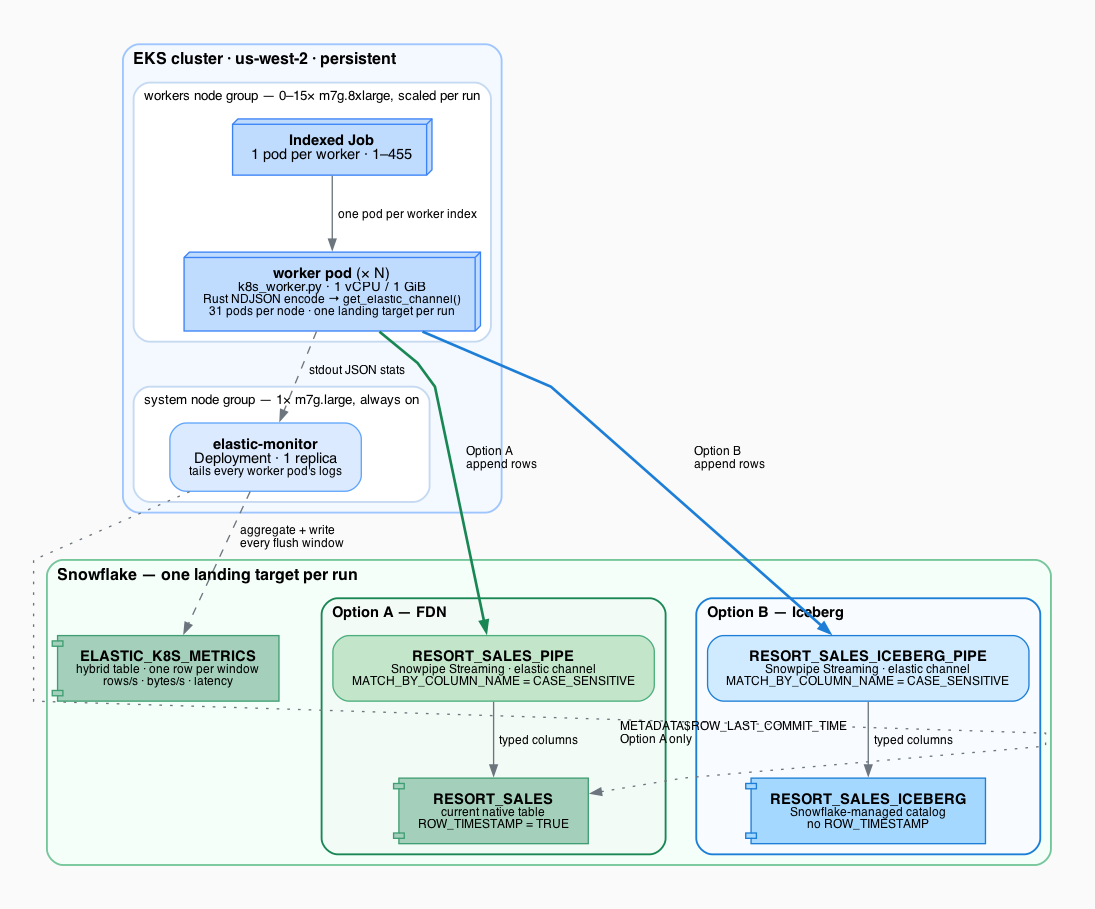
Parametri del benchmark
| Parametro | Valore |
|---|---|
| Worker pod | 455 |
| Canali | 1 (condiviso, elastico) |
| Richiesta/limite CPU worker | 1 vCPU |
| Richiesta/limite memoria worker | 1 GiB |
| Worker per nodo | 31 (m7g.8xlarge, Graviton arm64) |
| Nodi worker al picco | 15 |
| vCPU worker totali | 455 |
| Memoria worker totale | 455 GiB |
| Formato messaggio | NDJSON (mappatura delle colonne tipizzata) |
| Dimensione media della riga (non compressa) | ~277 byte |
| Percorso di codifica rapido | ELASTIC_FAST_JSON_ENCODE=true (di default) |
| SDK | Package Python snowpipe-streaming |
| Pipe di ingest | RESORT_SALES_PIPE → RESORT_SALES |
I pod worker erano dimensionati correttamente in base all’utilizzo in stato stazionario misurato. La CPU rappresenta il vincolo limitante nel packing dei nodi, che richiede circa 240m-540m di CPU, dove 1000m corrisponde a 1 vCPU completa, che è stata allocata. L’utilizzo della memoria osservato era compreso tra 68 e 183 MiB RSS, a fronte di 1Gi allocato. Un’istanza m7g.8xlarge pianifica 31 worker per nodo, con margine di memoria disponibile.
Risultati delle prestazioni
Picco di throughput sostenuto su FDN
| Metrica | Valore |
|---|---|
| Throughput sostenuto (non compresso) | 41,8 GB/sec |
| Frequenza di righe sostenuta | 133,5M righe al secondo |
| Worker al picco | 455 |
| Throughput per worker | ~92 MB/sec (~293K righe al secondo), praticamente costante da 15 a 455 worker |
| Throttling | Nessuno osservato |
Confronto con Snowpipe Streaming
Al Summit 2024, Snowflake ha dimostrato come la versione precedente di Snowpipe Streaming fosse in grado di eseguire l’ingestion a circa 10 GB/sec aggregati su una singola tabella, un risultato di riferimento per l’epoca. I nostri benchmark, eseguiti su Snowpipe Streaming ad alte prestazioni con la funzionalità Elastic Channels di recente rilascio, hanno prodotto livelli di throughput superiori di oltre 3,5 volte rispetto ai benchmark precedenti, sia su tabelle FDN che su tabelle Apache Iceberg gestite da Snowflake.
| Demo originale Summit 2024 (approssimativo) | HP + Elastic Channels su tabelle FDN | HP + Elastic Channels su tabelle Apache Iceberg gestite da Snowflake | |
|---|---|---|---|
| Throughput (non compresso) | ~10 GB/sec | 41,8 GB/sec | 39,0 GB/sec |
| Frequenza di righe | ~39M righe al secondo¹ | 133,5M righe al secondo | 121,6M righe al secondo |
| Accelerazione | – | > 3,5x |
¹ Stima di ~277 byte/riga per adattarsi alla struttura delle righe di questo workload.
Scalabilità orizzontale (EKS scale-out)
Il throughput ha seguito quasi esattamente il numero di worker a ogni passaggio, con una scalabilità lineare netta e nessun plateau. La latenza è rimasta in un intervallo limitato anche con l’aumento del throughput: Batch ack (completamento future dell’SDK) si è mantenuto in media vicino a 600 ms in tutte le fasi. Il tempo di batch ack è la durata totale che intercorre tra l’invio dei dati dal client all’SDK e la ricezione del callback (i dati sono durevoli). La latenza ingest-to-visible (SALE_TIME → METADATA$ROW_LAST_COMMIT_TIME) è rimasta nella fascia di ~12-29 secondi: i dati sono interrogabili entro pochi secondi dall’arrivo, anche a 133,5 milioni di righe al secondo. Questa è la durata necessaria perché i dati siano inclusi nelle query.
| Worker | Nodi | Righe al secondo | Throughput | Batch ack medio | Ingest-to-visible medio² |
|---|---|---|---|---|---|
| 15 | 1 | 4,4M | 1,38 GB/sec | 582 ms | 11,7 s |
| 90 | 3 | 26,6M | 8,27 GB/sec | 595 ms | 14,0 s |
| 180 | 6 | 52,8M | 16,52 GB/sec | 611 ms | 16,7 s |
| 300 | 10 | 87,8M | 27,50 GB/sec | 572 ms | 17,7 s |
| 420 | 14 | 123,2M | 38,6 GB/sec | 587 ms | 28,9 s |
| 455 | 15 | 133,5M | 41,84 GB/sec | 570 ms | 19,9 s |
² La latenza ingest-to-visible è misurata come TIMESTAMPDIFF(SALE_TIME, METADATA$ROW_LAST_COMMIT_TIME) da ELASTIC_K8S_METRICS tramite il monitor del cluster.
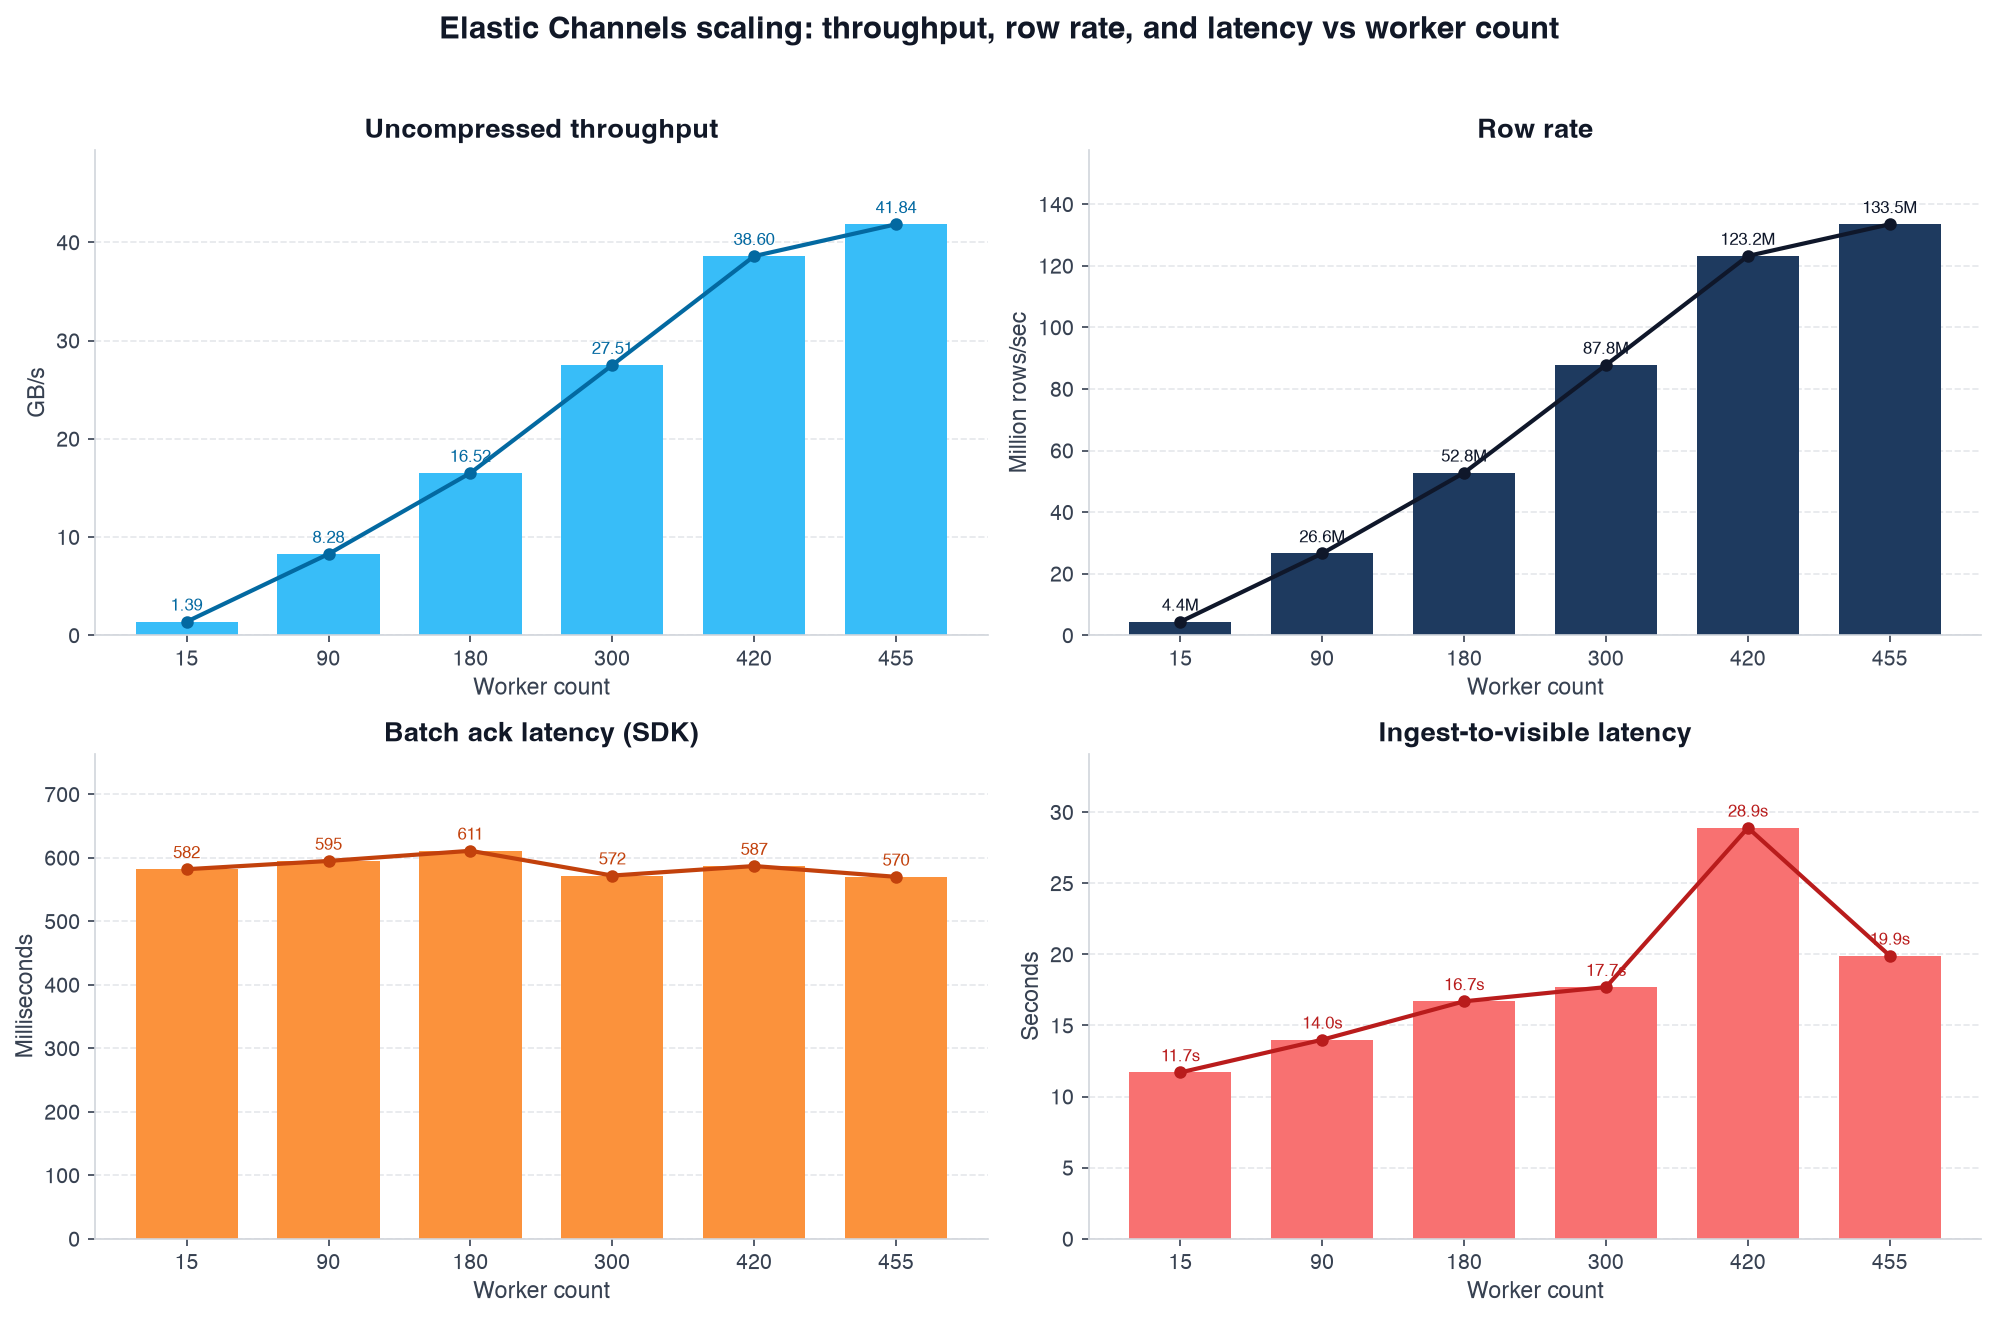
Due metriche di latenza rispondono a due domande diverse:
- Latenza di batch ack (in media ~570-611 ms) risponde alla domanda “Quanto velocemente l’SDK ha accettato il mio batch?” Viene misurata sul lato client, da
append_rows()fino al completamento del future dell’SDK. È rimasta quasi invariata nell’intero intervallo da 15 a 455 worker; il client non ha mai dovuto attendere che Snowflake assorbisse il batch successivo. - La latenza ingest-to-visible (in media ~12-29 s) risponde alla domanda “Quando posso eseguire query su questa riga?” Viene misurata sul lato server come
SALE_TIME→METADATA$ROW_LAST_COMMIT_TIME. È il numero che conta per le dashboard e l’analisi dei dati operativa. Non è cresciuta in proporzione al throughput (un aumento di 30 volte nella frequenza delle righe non ha prodotto un aumento di 30 volte nel tempo di disponibilità per le query) e si è mantenuta in un intervallo pratico per le dashboard quasi in tempo reale delle vendite dei resort durante tutta la campagna.
La leva di scalabilità è orizzontale: Aggiungere pod worker leggeri, non pod più grandi. Assegnare più CPU a un singolo worker non ha aumentato il suo throughput nei nostri test: ogni pod da 1 vCPU/1 GiB ha contribuito in modo indipendente con lo stesso ~0,086 GiB/sec.
Efficienza delle risorse al picco
Confrontando i numeri principali con un tipico layout di benchmark di streaming su scala di petabyte del settore, l’efficienza risulta evidente.
| Tipico benchmark di streaming su larga scala³ | Snowpipe Streaming Elastic Channels verso tabella FDN | Snowpipe Streaming Elastic Channels verso Apache Iceberg table gestita da Snowflake | |
|---|---|---|---|
| Worker concorrenti | 2048 | 455 | 455 |
| Core per worker | 1,5 | 1,0 | 1,0 |
| Memoria per worker | 2 GiB | 1 GiB | 1 GiB |
| Core totali dei worker | 3072 | 455 | 455 |
| Memoria worker totale | 4096 GiB | 455 GiB | 455 GiB |
| Throughput sostenuto | ~12 GB/sec | ~41,8 GB/sec | ~39,0 GB/sec |
| Righe al secondo sostenute | ~12M | 133,5M | 121,6M |
³ Parametri pubblicati rappresentativi per un benchmark di ingestione di una singola tabella su scala di petabyte, della durata di 24 ore, che utilizza migliaia di pod producer Kubernetes e un encoder binario nativo per le righe.
Abbiamo utilizzato circa un settimo dei core, un nono della memoria e meno di un quarto dei processi worker, pur ottenendo oltre 3 volte i byte al secondo e oltre 10 volte le righe al secondo, sia con FDN che con tabelle Apache Iceberg come destinazione.
Come siamo arrivati qui: evoluzione di Snowpipe Streaming
Questo progetto è partito da dove iniziano molte valutazioni di streaming Snowflake: su istanze EC2 di grandi dimensioni con decine di worker per host, canali espliciti e row dicts Python costruiti a ogni batch. Quelle esecuzioni sono state preziose: Hanno evidenziato i limiti lato client molto prima che lo facesse Snowflake.
| Era | Cosa abbiamo misurato | Cosa ci ha limitato |
|---|---|---|
| Versione precedente di Snowpipe Streaming (demo al Summit 2024) | ~10 GB/sec sul palco; meno di 1 GB/sec per host nelle nostre prime fasi di scalata | Costi operativi generali di canale/offset, columnarization lato client e metadati, architettura SDK classica |
| Architettura ad alte prestazioni (rilasciata nel 2025) | ~2-8 GB/sec per istanza di grandi dimensioni; ~16 GB/sec sostenuti multi-nodo su EC2 | Rete per host, gestione worker/canale, percorso di encoding Python |
| Elastic Channels + EKS + encoding Rust | 41,8 GB/sec con 455 worker | Niente, in questo test: scalabilità lineare in tutto l’intervallo supportato |
Tre modifiche si sono combinate:
- Elastic Channels:
get_elastic_channel()raggruppa tutti i canali sotto un unico client. Il codice dell’applicazione non deve più gestire nomi e offset. - Kubernetes con la granularità corretta: Un pod per worker, 1 vCPU ciascuno, 31 pod per nodo Graviton. Scalare la flotta, non il processo.
- Un percorso rapido Rust per la generazione e l’encoding: Python si occupa dell’orchestrazione, non del ciclo critico, come descritto di seguito.
Gli aggiornamenti a Snowpipe Streaming, incluso l’aggiunta di Elastic Channels, rendono l’invio di dati a Snowflake migliore che mai. L’architettura ad alte prestazioni di Snowpipe Streaming consente di acquisire enormi volumi di dati in modo rapido e semplice su un’infrastruttura serverless e scalabile, ed eseguire query sui dati in pochi secondi dalla fonte. La fatturazione è semplice, basata sui gigabyte acquisiti. Oggi non esiste sul mercato un modo più semplice e scalabile per eseguire query sui dati streaming.
Perché Rust per l’encoding dei dati
A centinaia di migliaia di righe al secondo per worker, l’allocazione dei dict Python e la serializzazione JSON dominano la CPU. Il percorso di default dell’SDK accetta dict di righe e li ricodifica internamente: corretto, ma ridondante quando lo schema è già noto.
Per utilizzare la CPU e la memoria del worker nel modo più efficiente possibile, i dati sono stati generati e serializzati in Rust. Questo utilizza metodi interni dell’SDK. Questi metodi potrebbero cambiare in futuro, complicando gli aggiornamenti.
Abbiamo aggiunto un’estensione nativa opzionale (native/, creata con PyO3 + maturin nell’immagine Docker del worker) che si occupa sia della generazione delle righe sia della serializzazione NDJSON in Rust:
- Saltare gli oggetti Python per riga: Nessun
dictper riga, nessun round-trip di structmsgspecnel percorso critico. - Saltare la seconda codifica dell’SDK:
fast_append.pypassa i byte preserializzati direttamente all’append FFI di Elastic Channel, bypassando il passaggio internoencode_linesdiappend_rows_with_wait. - Rimanere identico byte per byte a Python:
native/generate_tables.pyderiva tutte le tabelle pesate e le stringhe di prezzo preformattate direttamente daresort_sales.py. Rust riproduce i dati già risolti; non reimplementa la logica di business. I test unitari verificano che i percorsi nativo e Python producano NDJSON identici.
UNIT_PRICE e AMOUNT vengono incorporati come stringhe decimali al momento della generazione del codice (tramite la formattazione json.dumps di Python), in modo che Rust non sia mai in disaccordo con la formattazione float di Python sull’insieme finito di combinazioni (item, tier, quantity) che si verificano.
Quando la wheel non è installata, l’harness passa automaticamente all’encoding msgspec in Python. Nelle esecuzioni di benchmark in produzione, Rust è attivo di default (ELASTIC_FAST_JSON_ENCODE=true).
Il risultato: Ogni worker da 1 vCPU sostiene ~0,086 GiB/sec con CPU di riserva per l’I/O di rete dell’SDK: il throughput per worker che rende possibile la scalabilità lineare a 455 worker.
Cosa abbiamo imparato
- Elastic Channels è semplice da integrare: Chiamare
get_elastic_channel(), aggiungere righe (o byte precodificati) e il lavoro è fatto. - Il throughput scala in modo lineare con il numero di worker: Con la possibilità di scalare da 15 a 455 worker, non si osserva alcuna flessione nella curva né alcun throttling.
- Pod dimensionati correttamente battono i pod sovradimensionati: 1 vCPU / 1 GiB è sufficiente quando l’encoding non è il tuo collo di bottiglia.
- I carichi di lavoro sintetici sono una funzionalità, non un trucco: La generazione deterministica in-process elimina le distorsioni di I/O e rende le esecuzioni riproducibili: fondamentale quando si confrontano architetture, non fonti di dati.
- L’ottimizzazione lato client resta importante: Anche con un core server Rust, dimezzare la CPU del client raddoppia circa il numero di stream che puoi permetterti per host.
Guarda una demo di Elastic Channels
Guarda un video che mostra Elastic Channels in Snowflake per un caso d’uso IoT.
Prova subito
Tutto il necessario per riprodurre un’esecuzione end‑to‑end minima si trova nel repository. Non sono necessari 455 worker per validare la pipeline: un singolo Elastic Channel per un minuto è sufficiente per dimostrare la connettività, la configurazione del pipe e le metriche live.
1. Clonare e configurare
git clone https://github.com/snowflake-labs/snowflake-elastic-channels.git
cd snowflake-elastic-channels
pip install -r requirements.txt
cp .env.example .env   # Snowflake account, user, key-pair auth
python scripts/setup_elastic_ramp.py --ingest-ip <YOUR_INGEST_IP>
2. Eseguire la configurazione EKS una tantum (oppure saltare questo passaggio se si desiderano solo micro-benchmark locali)
./infra/eks/create_cluster.sh
./infra/eks/build_and_push.sh
./infra/eks/create_secret.sh
./infra/eks/allowlist_eks.sh
./infra/eks/deploy_monitor.sh
3. Eseguire un test di fumo con un singolo worker/canale
./infra/eks/run_job.sh quicktest-$(date +%Y%m%d%H%M%S) \
    --target-bps 100000000 \
    --duration-seconds 60 \
    --workers 1
Osservare il throughput live in Snowflake:
SELECT *
FROM SC_DB.SC_SCHEMA.ELASTIC_K8S_METRICS
WHERE RUN_ID = '<your-run-id>'
ORDER BY WINDOW_START;
Per esplorare la scalabilità, --workers accetta qualsiasi valore da 1 a 455; il node group si dimensiona automaticamente.
4. Eseguire un benchmark locale solo client (senza bisogno di Snowflake)
python scripts/benchmark_client_cpu.py --workers 1 --aggregate-mbps 100Repository
Disponibile su GitHub.
| Percorso | Scopo |
|---|---|
src/elastic_channels/k8s_worker.py |
Entry point del pod worker |
src/elastic_channels/resort_sales.py |
Generatore di righe POS sintetiche |
native/ |
Encoder NDJSON rapido in Rust |
infra/eks/run_job.sh |
Orchestratore di benchmark scale-out |
streamlit/Monitor_App.py |
Dashboard di throughput/latenza live |
docs/architecture.md |
Design completo del sistema |
Avvertenze
- I risultati si riferiscono a un account Snowflake, una regione (
us-west-2) e una forma di riga sintetica (righe NDJSON di circa 277 byte) su una tabella non clusterizzata. La larghezza delle righe, la definizione della pipe e i limiti dell’account possono variare. - Il confronto > 3,5x è rispetto a Snowpipe Streaming, come dimostrato al Summit 2024 (~10 GB/sec); questo benchmark utilizza l’architettura ad alte prestazioni rilasciata nel 2025 con Elastic Channels. Stessa ipotesi sulla dimensione delle righe (~277 byte); indicativo, non una riproduzione controllata side-by-side.
- La maggior parte dei passaggi scale-out è costituita da misurazioni singole piuttosto che da prove ripetute.
- L’analisi dei costi non è nell’ambito di questo articolo; il pricing di Snowpipe Streaming basato sul throughput si applica al volume non compresso ingerito e può essere calcolato per singolo caso d’uso.
- Per raggiungere questi volumi, sarebbe necessario contattare i team account dei clienti o il supporto per aumentare la capacità dell’account.
