
사기 문제가 심각해지면서 규정 준수에 드는 비용도 해마다 늘고 있습니다. 효과적인 실시간 사기 방지로 규정을 준수하는 일은 금융 서비스 업계에서 가장 중요하면서도 비용이 많이 드는 과제 중 하나로 빠르게 떠올랐습니다. 엔터프라이즈급 사기 탐지는 거래 패턴을 지속적이고 동적으로 분석하고, 이상 징후를 식별하며, 새로운 위협에 실시간으로 적응하는 강력한 머신러닝 인프라에 달려 있습니다.
거래 처리가 완료되기 전에 사기범을 적발하려면 밀리초 단위로 사기를 탐지하도록 설계된 프로덕션급 인프라가 필요합니다. 이 블로그에서는 Snowflake ML이 스트리밍 피처, 저지연 모델 서빙, MLOps를 단일 데이터 및 ML 플랫폼에 통합해 이러한 실시간 과제를 어떻게 해결하는지 살펴봅니다. 특히 정식 출시된 Snowflake의 Online Feature Store를 활용해 사기 탐지 워크플로우를 프로덕션 환경에 도입할 때의 이점을 살펴봅니다. 피처를 10ms 미만에 제공하고, 실시간 스트리밍 이벤트를 피처에 반영하는 지연 시간을 1초 미만으로 유지할 수 있습니다.
사기 탐지가 어려운 이유: 실무에서 마주하는 과제
금융 기관이 엔터프라이즈 규모로 사기 탐지 문제를 해결할 때 겪는 핵심 과제는 세 가지입니다. 실시간 거래에 대한 판단 결과가 나오기까지의 지연 시간, 끊임없이 변화하는 사기 수법, 민감한 고객 및 금융 데이터에 대한 포괄적인 보안과 거버넌스 요구 사항입니다.
지연 시간 문제 해결
대부분의 금융 기관은 실시간 사기 탐지에 어려움을 겪습니다. 레거시 배치 파이프라인과 정적 규칙 엔진으로는 밀리초 단위의 SLA를 충족하면서 최신 행동 데이터를 기반으로 실시간 거래를 평가할 수 없기 때문입니다. 사기를 차단하려면 최신 데이터를 1초 미만에 피처에 반영할 수 있는 아키텍처가 필요합니다. 여기에는 스트림 피처 뷰를 사용해 실시간 이벤트(e.g. 로그인, 거래)를 저지연 서빙 계층으로 지속적으로 수집하는 방식이 포함됩니다. 추론 시점에는 실시간 피처 뷰가 요청별 지표(e.g. 현재 거래 금액을 고객의 과거 기준값과 비교)를 동적으로 계산해야 합니다.
시간 경과에 따른 모델 성능 모니터링
사기범이 대응 방식을 바꾸면 사기 탐지 모델의 성능은 저하됩니다. 지난 분기에 합성 신원 사기를 탐지했던 모델이 이번 분기의 새로운 공격은 놓칠 수 있습니다. 이것이 모델 드리프트이며, 대부분의 금융 기관은 이미 늦은 뒤에야 이를 발견합니다. 모델 성능을 지속적으로 모니터링하는 데 성공한 기업은 완전 관리형 ML 시스템을 갖추고 있습니다. 필요한 피처와 모델을 쉽게 개발하고 반복적으로 개선해 프로덕션 환경에 배포할 수 있어 비즈니스 변화에 원활하게 적응합니다.
모든 데이터의 보안과 거버넌스 유지
대부분의 레거시 사기 탐지 시스템에서는 추론을 호출할 때 데이터를 외부 플랫폼으로 전송하는 경우가 많습니다. 이러한 외부 전송은 규제를 받는 금융 기관이 감당하기 어려운 수준의 거버넌스 위험을 초래할 수 있습니다. 민감한 데이터를 다루는 프로덕션 사기 탐지 시스템에는 전체 데이터 흐름을 추적하는 계보와 데이터 거버넌스가 필수입니다.
이러한 비즈니스 과제는 기존 ML 인프라의 한계에서 직접 비롯됩니다. 이를 해결하려면 엔터프라이즈 규모를 지원하도록 설계된 엔드투엔드 실시간 ML 플랫폼이 필요합니다.
성공적인 사기 탐지 사례
VALID Systems는 금융 기관이 창구, ATM, 모바일 채널 전반에서 실시간으로 사기를 방지하도록 지원합니다. 4억 2,500만 개가 넘는 고유 계좌에 걸쳐 즉시 사용 가능한 자금을 보증하며, 그 규모는 매월 60억 달러가 넘습니다.
레거시 솔루션이 한계에 도달하자 VALID Systems는 모든 피처, 학습 데이터, 모델, 추론을 한곳에서 관리하도록 Snowflake 기반으로 사기 탐지 ML 플랫폼을 재설계했습니다. 기존 API 규약은 그대로 유지하면서 데이터의 외부 전송은 없앴습니다.
VALID의 모델은 이제 각 행에 대한 예측이 맞았는지만이 아니라, 판단의 금전적 가치를 기준으로 최적화됩니다. 이러한 목표 전환은 성능 개선 효과를 배가합니다. 위험도가 가장 높은 거래에 집중한 작은 개선이 모든 거래에 고르게 적용한 더 큰 개선보다 효과적입니다. 모든 튜닝 실행 내역이 기록되어 전 과정을 감사할 수 있습니다. 따라서 규정 준수 팀은 나중에 문서를 별도로 마련할 필요 없이, 튜닝 과정에서 필요한 문서를 확보합니다.
새로운 플랫폼으로 전환한 결과, VALID는 예금 손실률을 7~10% 낮추고 은행 사기 손실을 15~17% 더 많이 탐지했습니다.

은행이 요구하는 규모의 실시간 ML 구현은 Snowflake에서 이미 해결된 과제입니다.
Michael Ring
CTO/CIO, VALID Systems
사기 탐지 환경을 대규모로 현대화한 또 다른 고객은 Neon입니다. Neon은 브라질에서 가장 빠르게 성장하는 디지털 금융 기관 중 하나로, 2,700만 명이 넘는 고객에게 결제 및 신용 상품을 제공합니다. 모든 로그인, 카드 결제, 이체, 대출 요청은 먼저 Neon이 자체 개발한 사기 탐지 엔진 Viper를 거칩니다. Viper가 실시간으로 결정을 내리려면 분 단위부터 월 단위까지 다양한 기간의 거래 횟수와 같은 최신 행동 피처가 필요합니다.
Neon이 사용하던 피처 스토어 서비스 Tecton의 종료가 예정되면서, 팀은 정해진 기한까지 전환을 마쳐야 했습니다. Neon은 여러 공급업체를 평가한 끝에 Snowflake를 선택했습니다. 낮은 지연 시간, 최신 상태를 유지하는 스트리밍 및 실시간 피처, 온라인과 오프라인 피처에 동일하게 적용되는 거버넌스, Python 친화적인 개발 환경, 비용을 한곳에서 확인하며 더 효과적으로 관리할 수 있다는 점이 선택의 이유였습니다.
팀은 3개월 만에 8개 사기 탐지 워크플로우에 사용되는 300개에 가까운 피처를 Snowflake Feature Store에 재구축했습니다. 그 결과 Neon은 P99 피처 지연 시간을 140ms에서 72ms로 줄여 Snowflake에서 피처를 거의 두 배 빠르게 제공할 수 있게 되었습니다. Viper의 서비스 가용성이 99.7%에서 99.9%로 높아지면서 사기 방지 적용 범위도 확대되었습니다.
머신러닝 모델은 저희 성장 전략의 핵심이며, 이를 뒷받침하려면 대규모로 확장할 수 있는 피처 스토어가 반드시 필요합니다. Snowflake Feature Store를 도입한 후 P99 지연 시간이 약 140밀리초에서 약 72밀리초로 줄어 속도가 거의 두 배 빨라졌고, 사기 탐지 엔진의 가용성은 99.7%에서 99.9%로 높아졌습니다.
Thiago Bianchi, Ph.D.
Senior Staff Software & Machine Learning Engineer, Neon
차세대 사기 탐지를 위한 기술 청사진
Snowflake ML을 활용하면 VALID Systems와 Neon 같은 고객은 오늘날의 비즈니스 요구에 맞춰 확장할 수 있는 강력한 사기 탐지 플랫폼을 구축할 수 있습니다. Snowflake ML이 다음과 같은 이점을 기본으로 제공하기 때문입니다.
저지연 예측: Online Feature Store는 피처를 10ms 미만에 제공하며, Snowflake Model Registry의 모델 서빙은 100ms 미만의 지연 시간을 제공합니다.
통합 모니터링: 기본 제공되는 MLOps를 통해 시간에 따른 성능과 정확도의 변화를 손쉽게 모니터링하고 설명하며, 관련 알림을 받을 수 있습니다.
보안 및 거버넌스: 데이터, 피처, 모델을 하나의 플랫폼에 통합해 민감한 고객 데이터를 외부로 전송하면서 발생하는 위험을 없앱니다.
온라인 피처 서빙과 모델 서빙을 포함한 온라인 ML 기능은 실시간 사기 탐지 워크플로우의 핵심입니다. 오늘 Snowflake의 Online Feature Store가 정식 출시되었습니다. 이제 모델 서빙과 함께 모든 프로덕션 사용 사례에 활용할 수 있다는 소식을 기쁘게 전합니다. Snowflake Postgres를 기반으로 구축된 Online Feature Store는 위험 점수, 활동 패턴, 행동 피처 등 최신 정보가 필요하고 지연 시간에 민감한 ML 신호를 예측 시점에 모델에 제공합니다. 이러한 워크로드는 초당 수천 건의 예측을 처리해야 하며, 각 예측에 필요한 피처는 밀리초 단위로 반환되어야 합니다. Online Feature Store는 온라인 모델 서빙과 직접 통합되어 지연 시간이 짧은 사기 예측을 손쉽게 수행할 수 있도록 합니다.
피처 계산이 완료되면 모델을 실시간으로 서빙할 준비가 됩니다. 모델 서빙을 위해 Snowflake는 학습된 모델을 Snowpark Container Services(SPCS) 기반의 완전 관리형 추론 서비스로 배포합니다. Snowflake Model Registry에 등록된 모든 모델은 단일 API 호출만으로 전용 REST 엔드포인트에 배포할 수 있습니다. 모델 서비스는 Online Feature Store와 직접 통합되어 온라인 스토어에서 최신 피처를 자동으로 가져옵니다. 피처 조회와 모델 실행이 긴밀하게 결합되어, 피처 조회부터 예측에 이르는 사기 점수 산정 전 과정이 한 번의 네트워크 왕복으로 처리됩니다. 따라서 네트워크 지연 시간과 외부 데이터 이동이 최소화됩니다.
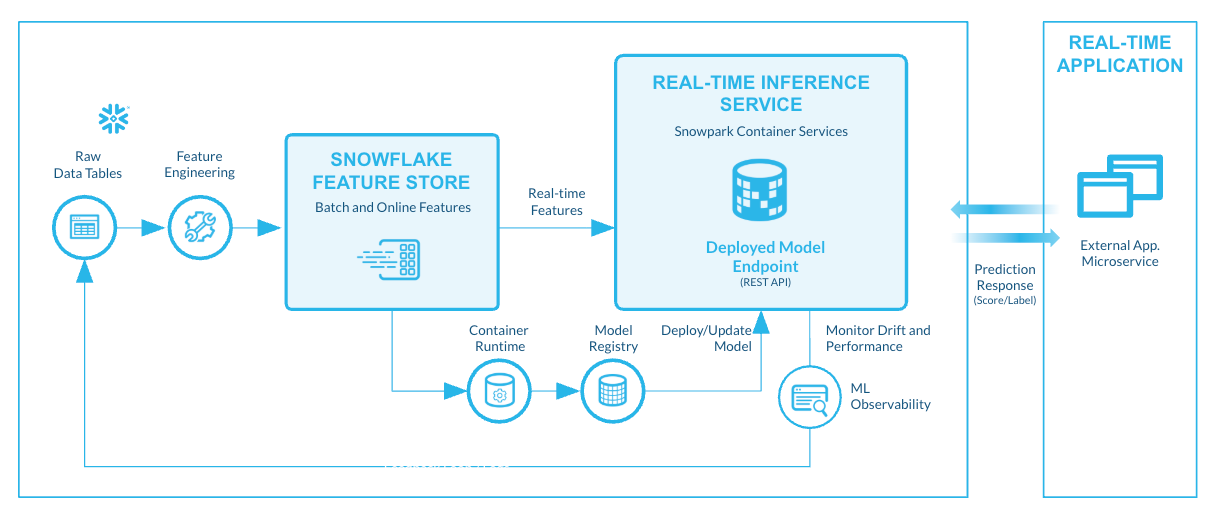
자료 1: Online Feature Store는 온라인 모델 서빙과 직접 통합되어 고객이 모델 추론 요청에서 피처를 직접 조회할 수 있도록 합니다.
Online Feature Store와 온라인 모델 서빙은 Snowflake의 통합 ML 플랫폼과 결합되어 업계의 가장 큰 사기 탐지 과제를 해결하는 데 필요한 기술적 토대를 제공합니다. Snowflake ML이 금융 기관의 핵심 비즈니스 요구를 어떻게 충족하는지 자세히 살펴보겠습니다.
이벤트에서 의사 결정까지, 밀리초 단위로
사기를 탐지하려면 모델이 최대한 최신 신호를 활용해야 합니다. 어젯밤 배치 작업으로 계산한 피처가 아니라, 불과 몇 초 전의 상황을 반영한 신호가 필요합니다. Snowflake의 온라인 ML 플랫폼은 이벤트가 발생할 때마다 최신 신호를 기반으로 사기 여부를 판단할 수 있도록 스트리밍 피처를 중심으로 구축되었습니다.
그 핵심은 스트림 피처 뷰입니다. REST 수집 API로 거래, 로그인, 디바이스 신호 등의 이벤트를 실시간으로 수집하고, 이벤트 수집부터 최신 피처 제공까지의 지연 시간을 P50 기준 200ms 미만으로 유지합니다. 내부적으로는 지연 시간이 짧은 조회를 위해 이벤트를 관리형 Postgres 서빙 계층에 동기식으로 기록합니다. 이벤트가 들어오면 Online Feature Store는 ‘최근 48시간 총지출’이나 ‘최근 1시간 거래 횟수’ 등 일정 시간 구간의 집계 값을 지속적으로 계산합니다. 원시 이벤트 이력을 주기적으로 다시 스캔하는 대신 누적 값을 갱신하는 방식입니다. 따라서 사기 탐지 모델은 오래된 스냅샷이 아니라 최신 활동을 반영하는 행동 신호를 항상 활용할 수 있습니다.
거래 금액이나 디바이스 핑거프린트처럼 현재 요청에 따라 달라지는 피처는 실시간 피처 뷰가 쿼리 시점에 파생 값을 즉시 계산합니다. 추론 시점에 실행되는 Python 함수는 요청별 입력을 업스트림 피처 뷰에서 미리 계산한 피처와 결합한 뒤 모델에 전달합니다. 예를 들어 사기 탐지 모델은 요청 시점의 거래 금액을 스트림 피처 뷰가 지속적으로 갱신하는 고객의 이동 평균 지출액과 비교해, 이상 징후를 발생 즉시 식별할 수 있습니다.
통합 모니터링과 실험
사기범이 대응 방식을 바꾸면 사기 탐지 모델의 성능은 저하됩니다. Snowflake의 MLOps는 피처 스토어 및 모델 레지스트리와 기본적으로 통합되어, 시간에 따른 성능과 정확도의 변화를 손쉽게 모니터링하고 설명하며 관련 알림을 받을 수 있습니다. 게이트웨이 모니터링, 모델 옵저버빌리티 및 온라인 피처 서빙 대시보드를 모두 Snowsight에서 이용할 수 있어, 팀은 ML 수명 주기 전반을 한 화면에서 파악할 수 있습니다. 모델 모니터는 드리프트, 성능, 예측량을 지속적으로 측정합니다. 정답 레이블이 들어오면 Snowflake가 추론 로그와 자동으로 조인해 추가 파이프라인 작업 없이 정확도, 정밀도, 재현율을 계산합니다.
Snowflake의 게이트웨이 모니터링은 A/B 테스트와 섀도 테스트를 지원합니다. 실시간 트래픽을 모델 버전 간에 분할하거나 미러링해, 후보 모델을 프로덕션에 적용하기 전에 정확도, 지연 시간, 오류율을 비교할 수 있습니다. Online Serving 탭에서는 피처 스토어의 상태를 실시간으로 확인할 수 있습니다. 이 모든 과정은 데이터와 동일한 플랫폼에서 이루어지므로 기본적으로 보안과 거버넌스가 적용됩니다.
통합 보안 및 거버넌스
사기 탐지 시스템은 계좌 번호, 거래 이력, 개인 식별 정보 등 조직이 보유한 가장 민감한 데이터를 처리합니다. 레거시 아키텍처에서 흔히 발생하는 위험은 추론 호출 시 데이터가 외부 플랫폼으로 전송되어, 규제를 받는 금융 기관이 용인할 수 없는 거버넌스 공백이 생긴다는 점입니다.
Snowflake에서는 피처 엔지니어링부터 모델 학습, 서빙, 모니터링까지 ML 수명 주기 전반이 데이터가 저장된 동일한 플랫폼에서 실행됩니다. 민감한 데이터는 Snowflake의 보안 경계 내에서 보호되고 처리됩니다. 모델은 완전한 역할 기반 액세스 제어가 적용되는 스키마 수준의 오브젝트입니다. 권한을 세분화해 데이터 사이언티스트는 개발 환경에서 반복적으로 모델을 개선하고, 프로덕션 역할은 어떤 모델을 프로덕션에 적용할지 제어하도록 할 수 있습니다. ML Lineage는 소스 테이블에서 피처 뷰와 데이터 세트를 거쳐 등록된 모델과 서비스에 이르는 데이터 흐름을 자동으로 추적해, 규정 준수 팀에 전체 과정의 출처 정보를 제공합니다. 이 모든 과정은 Snowflake의 통합 보안 모델로 관리됩니다. 따라서 데이터를 보호하는 네트워크 정책, 암호화, 감사 로깅이 ML 워크플로우에도 동일하게 적용됩니다.
에이전틱 사기 탐지 워크플로우
Snowflake는 Snowflake CoCo의 에이전틱 ML 워크플로우를 통해 팀의 개발 속도를 높이는 데도 주력하고 있습니다. 데이터 사이언스 팀은 CoCo가 개발과 추론의 각 단계를 자율적으로 계획하고 추론하며 최적의 기법을 선택하도록 해, 모든 기능이 정상적으로 작동하는 고품질 ML 파이프라인을 빠르게 구축할 수 있습니다. 문서를 찾아보거나 오류를 디버깅하고 API를 연결하는 데 시간을 쓰는 대신, 사기 탐지 분야의 전문성과 직관을 활용해 모델을 개선하고 인사이트를 도출하는 데 집중할 수 있습니다.
Snowflake는 사기 탐지 사용 사례를 위한 전 과정의 에이전틱 워크플로우를 지원합니다. 이 Quickstart를 따라 CoCo에서 자연어 프롬프트만으로 사기 탐지 모델을 구축해 보세요.
성능
Snowflake의 벤치마크에 따르면 온라인 피처 서빙과 온라인 모델 서빙 모두 기업의 사기 탐지에 필요한 지연 시간과 비용 측면에서 경쟁 제품보다 우수한 성능을 보입니다. Snowflake의 Online Feature Store는 Databricks 대비 지연 시간은 2.5분의 1, 초당 쿼리 수(QPS)는 7배로 피처를 실시간으로 제공합니다. Snowflake의 실시간 모델 추론은 Sagemaker 및 Databricks 대비 2~5배 빠르고, 비용은 3분의 1 수준까지 낮아집니다.
Snowflake Feature Store는 Postgres 기반 엔진으로 일관되게 지연 시간이 짧은 서빙을 제공하며, 조회 지연 시간은 일반적으로 P50 기준 10ms 미만입니다. 여기에 전용 스트리밍 변환 엔진을 결합해, 최신 이벤트가 피처에 반영되기까지의 엔드투엔드 지연 시간도 일반적으로 P50 기준 200ms 미만으로 유지합니다. SPCS에서 기본 제공되는 연결 풀링과 스키마별 단일 테넌트 격리를 적용한 무상태 REST 엔드포인트는 트래픽이 급증해도 일관되게 낮은 지연 시간을 유지합니다. 40,000 QPS를 넘는 부하에서도 테스트를 거쳤습니다.
또한 요청 처리, 직렬화, 배치 처리 등 CPU 집약적인 서빙 작업을 GPU 성능에 제약을 받는 모델 실행과 분리해 각 계층을 독립적으로 확장할 수 있도록 합니다. 이를 통해 모델 추론 속도를 높이고 비용을 낮춥니다. 동적 배치 처리는 트래픽이 적을 때 요청을 즉시 처리하고, 부하가 높아지면 요청을 자동으로 묶어 GPU 병렬성을 극대화합니다. 요청 파이프라이닝은 현재 배치가 끝나기 전에 다음 배치를 준비해 GPU에 작업을 끊임없이 공급합니다. 따라서 유휴 시간을 없애고 GPU당 처리량을 높일 수 있습니다.
시작하기
Snowflake에서 실시간 사기 탐지 워크플로우를 구축하려면 다음 자료를 확인하세요.
사기 탐지 전반을 다루는 단계별 Quickstart
단계별 Quickstart로 사기 탐지를 위한 에이전틱 ML 체험하기

