
20. Okt. 2026/Lesezeit: 11 MinutenFinanzdienstleistungen
So bauen Sie eine moderne Plattform zur Betrugserkennung mit Online-ML auf
Betrug ist ein wachsendes Problem, das die Compliance-Kosten Jahr für Jahr weiter in die Höhe treibt. Die Einhaltung gesetzlicher Vorschriften durch eine effektive Betrugsprävention in Echtzeit hat sich schnell zu einer der wichtigsten und teuersten Herausforderungen der Finanzdienstleistungsbranche entwickelt. Eine unternehmenstaugliche Betrugserkennung stützt sich auf eine robuste Infrastruktur für maschinelles Lernen, die Transaktionsmuster kontinuierlich und dynamisch analysiert, Anomalien meldet und sich in Echtzeit an neue Bedrohungen anpasst.
Um böswillige Akteur:innen zu fassen, bevor eine Transaktion abgewickelt wird, ist eine produktionsreife Infrastruktur erforderlich, die Betrug in Millisekunden erkennt. In diesem Blogpost gehen wir näher darauf ein, wie Snowflake ML diese Echtzeit-Herausforderungen bewältigt, indem es Streaming-Features, latenzarmes Model Serving und MLOps auf einer einzigen Daten- und ML-Plattform vereint. Insbesondere beleuchten wir die Vorteile der Nutzung von Snowflakes Online Feature Store (jetzt allgemein verfügbar), um Workflows zur Betrugserkennung zu produktionalisieren, indem Features in weniger als 10 ms bereitgestellt werden und eine Feature-Aktualität im Subsekundenbereich aus Echtzeit-Streaming-Ereignissen ermöglicht wird.
Warum es so schwierig ist: Die wahren Herausforderungen
Für alle Finanzinstitute gibt es drei zentrale Herausforderungen, die es schwierig machen, das Problem der Betrugserkennung auf Unternehmensebene anzugehen: die Latenz der Ergebnisse bei Echtzeit-Transaktionen, die sich ständig verändernde Landschaft der Betrugstaktiken sowie die umfassenden Sicherheits- und Governance-Anforderungen an sensible Kunden- und Finanzdaten.
Das Latenzproblem angehen
Die meisten Institute haben Schwierigkeiten, Betrug in Echtzeit zu erkennen, da Altlast-Batch-Pipelines und statische Regel-Engines Live-Transaktionen nicht innerhalb von Millisekunden-SLAs mit aktuellen Verhaltensdaten abgleichen können. Um Betrug zu stoppen, ist eine Architektur erforderlich, die eine Feature-Aktualität im Subsekundenbereich liefern kann. Dazu gehört die Verwendung von Stream-Feature-Views, um Live-Ereignisse (z. B. Logins, Transaktionen) kontinuierlich in eine latenzarme Serving-Schicht zu laden. Während der Inferenzzeit müssen Echtzeit-Feature-Views dynamisch Metriken auf Anfrageebene berechnen (z. B. Vergleich der aktuellen Transaktionsausgaben mit der historischen Baseline einer Kund:in).
Überwachung der Modell-Performance im Zeitverlauf
Betrugsmodelle verschlechtern sich, wenn sich Angreifer:innen anpassen. Was im letzten Quartal noch synthetischen Identitätsbetrug erkannt hat, übersieht in diesem Quartal möglicherweise die nächste Generation von Angriffen. Das ist Model Drift – und die meisten Institute entdecken ihn zu spät. Unternehmen, die ihre Performance im Laufe der Zeit erfolgreich überwachen, verfügen über vollständig verwaltete ML-Systeme, die sich leicht entwickeln und iterieren lassen und relevante Features und Modelle in die Produktion überführen, um sich nahtlos an geschäftliche Veränderungen anzupassen.
Alle Daten sicher und verwaltet halten
Bei den meisten Altlast-Betrugserkennungssystemen senden Inferenzaufrufe häufig Daten an eine externe Plattform. Egress führt zu einem Governance-Risikoniveau, das für regulierte Finanzinstitute möglicherweise inakzeptabel ist. End-to-End-Data Lineage und Data Governance sind ein Muss für ein produktives Betrugserkennungssystem, das sensible Daten enthält.
Diese geschäftlichen Herausforderungen resultieren direkt aus den Einschränkungen herkömmlicher ML-Infrastrukturen – und ihre Lösung erfordert eine End-to-End-Echtzeit-ML-Plattform, die für den Unternehmenseinsatz konzipiert ist.
Wie erfolgreiche Betrugserkennung aussieht
VALID Systems unterstützt Finanzinstitute dabei, Betrug in Echtzeit über Schalter-, Geldautomaten- und mobile Kanäle hinweg zu verhindern, und garantiert jeden Monat über 6 Milliarden USD an sofort verfügbaren Mitteln auf mehr als 425 Millionen Einzelkonten.
Nachdem die Altlast-Lösung an ihre Grenzen gestoßen war, strukturierte VALID Systems seine ML-Plattform zur Betrugserkennung auf Snowflake neu, sodass alle Features, Trainingsdaten, Modelle und Inferenzen an einem Ort vorhanden sind und derselbe API-Vertrag ohne Egress beibehalten wird.
Die Modelle von VALID optimieren nun auf den Dollarwert der getroffenen Entscheidungen und nicht nur darauf, ob eine Zeile richtig oder falsch war. Diese Zielverschiebung steigert die Performance. Eine kleine Verbesserung, die auf die Transaktionen mit dem höchsten Risiko abzielt, überwiegt eine größere Verbesserung, die gleichmäßig auf alle verteilt ist. Jede Anpassung wird protokolliert und ist vollständig überprüfbar, sodass Compliance-Teams die Dokumentation als Nebenprodukt des Prozesses und nicht als nachträglichen Gedanken erhalten.
Als Ergebnis dieser neuen Plattformänderung erreichte VALID einen Rückgang der Einlagenverlustraten um 7 bis 10 % und erkannte 15 bis 17 % mehr Bankbetrugsverluste.
„Echtzeit-ML im Bankenmaßstab ist auf Snowflake ein gelöstes Problem.“
Michael Ring
CTO/CIO, VALID Systems
Ein weiterer Kunde, der die Betrugserkennung in großem Maßstab modernisiert hat, ist Neon, eines der am schnellsten wachsenden digitalen Finanzinstitute Brasiliens, das über 27 Millionen Kund:innen mit Zahlungs- und Kreditprodukten bedient. Jeder Login, jede Kartenzahlung, jede Überweisung und jede Kreditanfrage durchläuft zunächst Viper, die hauseigene Betrugs-Engine von Neon. Viper benötigt aktuelle Verhaltens-Features, wie z. B. Transaktionszahlen über Zeitfenster von Minuten bis Monaten, um eine Entscheidung in Echtzeit zu treffen.
Der vorherige Feature Store-Anbieter von Neon, Tecton, wurde eingestellt, was dem Team eine harte Deadline bescherte. Neon evaluierte mehrere Anbieter und entschied sich aus vier Gründen für Snowflake: geringe Latenz, aktuelle Streaming- und Echtzeit-Features, dieselbe Governance für Online- und Offline-Features, eine Python-Entwicklererfahrung und mehr Kontrolle durch an einem Ort sichtbare Kosten.
In drei Monaten hat das Team fast 300 Features in acht Betrugs-Workflows im Snowflake Feature Store neu erstellt. Infolgedessen konnte Neon die P99-Feature-Latenz von 140 ms auf 72 ms senken, was sie in Snowflake fast doppelt so schnell macht. Die Serviceverfügbarkeit von Viper stieg von 99,7 % auf 99,9 %, was die Betrugsbekämpfungsabdeckung von Viper erhöhte.
„Modelle für maschinelles Lernen stehen im Mittelpunkt unserer Wachstumsstrategie, und das ist nur mit einem Feature Store möglich, der in großem Maßstab skalieren kann. Mit dem Snowflake Feature Store sank unsere P99-Latenz von etwa 140 Millisekunden auf etwa 72 Millisekunden – fast doppelt so schnell – und die Verfügbarkeit unserer Betrugs-Engine stieg von 99,7 % auf 99,9 %.“
Thiago Bianchi, Ph.D.
Senior Staff Software & Machine Learning Engineer, Neon
Der technische Entwurf für moderne Betrugserkennung
Mit Snowflake ML können Kunden wie VALID Systems und Neon robuste Plattformen zur Betrugserkennung aufbauen, die sich an moderne Geschäftsanforderungen anpassen lassen, da wir die folgenden Vorteile sofort einsatzbereit bieten:
Latenzarme Vorhersagen: Features werden in weniger als 10 ms mit dem Online Feature Store und Modelle in weniger als 100 ms aus der Snowflake Model Registry bereitgestellt.
Integriertes Monitoring: Die Möglichkeit, Performance und Genauigkeit im Laufe der Zeit mit integrierten MLOps einfach zu überwachen, zu erklären und Warnmeldungen dazu zu erhalten.
Sicherheit und Governance: Einheitliche Daten, Features und Modelle auf einer einzigen Plattform, wodurch Risiken durch den Egress sensibler Kundendaten eliminiert werden.
Online-ML-Funktionen, einschließlich Online-Feature-Serving und Model Serving, bilden den Kern von Echtzeit-Workflows zur Betrugserkennung. Heute freuen wir uns, Ihnen mitteilen zu können, dass Snowflakes Online Feature Store nun allgemein verfügbar ist und sich dem Model Serving für jeden Produktions-Anwendungsfall anschließt. Basierend auf Snowflake Postgres liefert unser Online Feature Store aktuelle, latenzempfindliche ML-Signale – Risikobewertungen, Aktivitätsmuster und Verhaltens-Features – zum Zeitpunkt der Vorhersage an Modelle. Diese Workloads erfordern Tausende von Vorhersagen pro Sekunde, für die jeweils Features in Millisekunden zurückgegeben werden müssen. Der Online Feature Store ist direkt in das Online-Model-Serving integriert, um auf einfache Weise latenzarme Betrugsvorhersagen zu generieren.
Sobald die Features berechnet sind, ist das Modell bereit, in Echtzeit bereitgestellt zu werden. Für das Model Serving stellt Snowflake trainierte Modelle als vollständig verwaltete Inferenzdienste auf Snowpark Container Services (SPCS) bereit. Jedes in der Snowflake Model Registry registrierte Modell kann mit einem einzigen API-Aufruf an einem dedizierten REST-Endpunkt bereitgestellt werden. Der Modelldienst ist direkt in den Online Feature Store integriert, und der Dienst ruft automatisch die neuesten Features aus dem Online-Store ab. Diese enge Kopplung zwischen Feature-Abruf und Modellausführung bedeutet, dass eine umfassende Betrugsbewertungsentscheidung – von der Feature-Suche bis zur Vorhersage – in einem einzigen Netzwerk-Roundtrip erfolgt, wodurch Netzwerklatenz und externe Datenbewegungen minimiert werden.
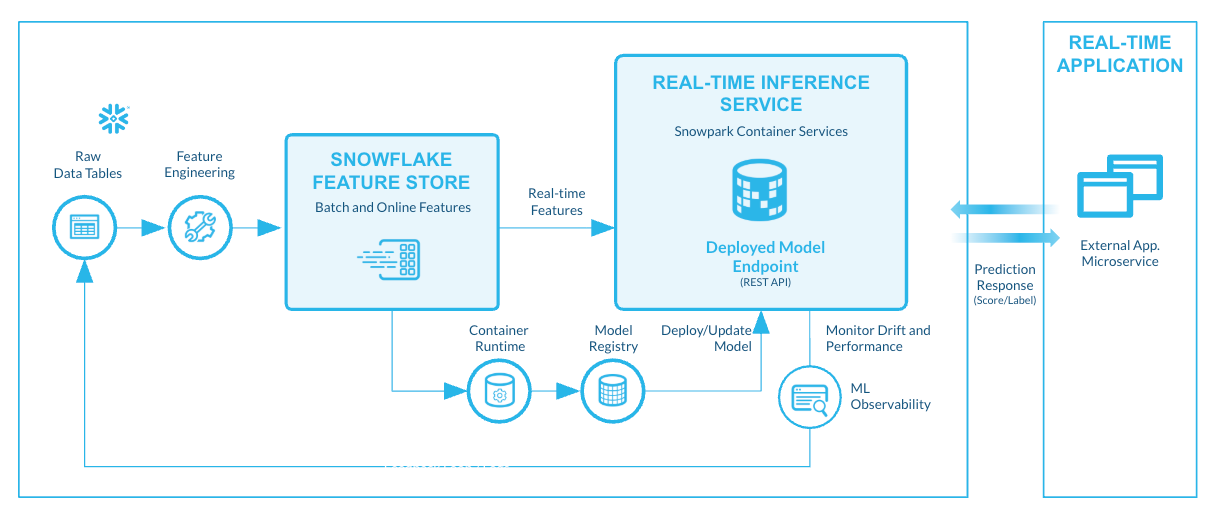
Abbildung 1: Der Online Feature Store ist direkt in das Online-Model-Serving integriert, sodass Kunden Features direkt aus Modellinferenzanfragen nachschlagen können.
Zusammen bieten der Online Feature Store und das Online-Model-Serving, gepaart mit unserer integrierten ML-Plattform, die technische Grundlage, die zur Überwindung der größten Hürden bei der Betrugserkennung in der Branche erforderlich ist. Lassen Sie uns näher darauf eingehen, wie Snowflake ML die geschäftskritischsten Anforderungen von Finanzinstituten erfüllt.
Vom Ereignis zur Entscheidung in Millisekunden
Betrug zu erkennen bedeutet, dass das Modell die aktuellsten Signale sehen muss – keine Features, die im Batch-Lauf der letzten Nacht berechnet wurden, sondern Signale, die widerspiegeln, was vor Sekunden passiert ist. Die Online-ML-Plattform von Snowflake basiert auf Streaming-Features, die Betrugsentscheidungen auf der Grundlage aktueller Signale treffen, während sich Ereignisse entfalten.
Das Herzstück sind Stream-Feature-Views, die Ereignisse wie Transaktionen, Logins und Gerätesignale in Echtzeit über eine REST-Ingestion-API aufnehmen und aktualisierte Features mit End-to-End-Aktualität in unter 200 ms p50 bereitstellen. Hinter den Kulissen werden Ereignisse synchron in eine verwaltete Postgres-Serving-Schicht für latenzarme Lesevorgänge geschrieben. Wenn Ereignisse eintreffen, berechnet der Online Feature Store kontinuierlich Zeitfenster-Aggregationen wie „Gesamtausgaben in den letzten 48 Stunden“ oder „Anzahl der Transaktionen in der letzten Stunde“ und verwaltet laufende Summen, anstatt den rohen Ereignisverlauf regelmäßig neu zu scannen. Das bedeutet, dass das Betrugsmodell immer Verhaltenssignale sieht, die die allerneuesten Aktivitäten widerspiegeln, und keinen veralteten Snapshot.
Für Features, die von der aktuellen Anfrage abhängen, wie z. B. der Transaktionsbetrag oder der Geräte-Fingerabdruck, berechnen Echtzeit-Feature-Views abgeleitete Werte on the fly zur Abfragezeit. Eine Python-Funktion wird zur Inferenzzeit ausgeführt und kombiniert Eingaben pro Anfrage mit vorberechneten Features aus vorgelagerten Feature-Views, bevor sie das Modell erreichen. Beispielsweise kann ein Betrugsmodell den aktuellen Transaktionsbetrag (zum Zeitpunkt der Anfrage) mit den gleitenden Durchschnittsausgaben eines Kunden (die kontinuierlich durch die Stream-Feature-View verwaltet werden) vergleichen, um Anomalien in dem Moment zu melden, in dem sie auftreten.
Integriertes Monitoring und Experimentieren
Betrugsmodelle verschlechtern sich, wenn sich Angreifer:innen anpassen. Die MLOps von Snowflake sind nativ in unseren Feature Store und unsere Modellregistrierung integriert, um Performance und Genauigkeit im Laufe der Zeit einfach zu überwachen, zu erklären und Warnmeldungen dazu zu erhalten. Gateway-Monitoring, Modell-Beobachtbarkeit und Online-Feature-Serving-Dashboards sind alle über Snowsight zugänglich und bieten Teams eine zentrale Ansicht über den gesamten ML-Lebenszyklus hinweg. Modellmonitore messen kontinuierlich Drift, Performance und Vorhersagevolumen. Wenn Ground-Truth-Labels eintreffen, verknüpft Snowflake sie automatisch mit Inferenzprotokollen und berechnet Genauigkeit, Präzision und Recall ohne zusätzliche Pipeline-Arbeit.
Für Experimente unterstützt das Gateway-Monitoring von Snowflake A/B-Tests und Shadow-Tests, sodass Sie Live-Traffic zwischen Modellversionen aufteilen oder spiegeln und Genauigkeit, Latenz und Fehlerraten vergleichen können, bevor Sie einen Challenger befördern. Die Registerkarte „Online Serving“ bietet Echtzeit-Einblicke in den Zustand des Feature Store. All dies ist standardmäßig gesichert und verwaltet, da es auf derselben Plattform wie Ihre Daten stattfindet.
Einheitliche Sicherheit und Governance
Betrugserkennungssysteme verarbeiten einige der sensibelsten Daten, über die ein Unternehmen verfügt: Kontonummern, Transaktionshistorien und personenbezogene Daten. Ein häufiges Risiko bei Altlast-Architekturen besteht darin, dass Inferenzaufrufe diese Daten an eine externe Plattform senden, wodurch Governance-Lücken entstehen, die regulierte Finanzinstitute nicht tolerieren können.
In Snowflake läuft der gesamte ML-Lebenszyklus – vom Feature Engineering über das Modelltraining bis hin zu Serving und Monitoring – auf derselben Plattform ab, auf der sich die Daten bereits befinden. Sensible Daten werden innerhalb des Sicherheitsperimeters von Snowflake gesichert und verarbeitet. Modelle sind Objekte auf Schemaebene mit vollständiger Role-Based Access Control (RBAC): Sie können feingranulare Berechtigungen erteilen, sodass Data Scientists in der Entwicklung iterieren können, während Produktionsrollen steuern, was befördert wird. ML Lineage verfolgt automatisch, wie Daten von Quelltabellen über Feature-Views und Datensätze in registrierte Modelle und Dienste fließen, und bietet Compliance-Teams eine End-to-End-Herkunft. Und da all dies durch das einheitliche Sicherheitsmodell von Snowflake geregelt wird, schützen dieselben Netzwerkrichtlinien, Verschlüsselungen und Audit-Protokollierungen, die Ihre Daten schützen, auch Ihre ML-Workflows.
Agentic Workflows zur Betrugserkennung
Bei Snowflake setzen wir uns auch dafür ein, Teams dabei zu helfen, die Entwicklung mit Agentic-ML-Workflows von Snowflake CoCo zu beschleunigen. Data Science-Teams können schnell voll funktionsfähige, hochwertige ML-Pipelines aufbauen, indem sie CoCo verwenden, um die optimale Technik für jeden Schritt in der Entwicklung und Inferenz durch Agentic Planning zu planen, zu begründen und auszuwählen. Anstatt Zeit mit dem Durchsuchen von Dokumentationen, dem Beheben von Fehlern oder dem Verknüpfen von APIs zu verbringen, können Sie sich darauf konzentrieren, Ihr Fachwissen und Ihre Intuition im Bereich Betrug anzuwenden, um Modelle zu verfeinern und Erkenntnisse zu gewinnen.
Wir unterstützen vollständige Agentic Workflows für Anwendungsfälle der Betrugserkennung. Folgen Sie diesem Quickstart, um ein Betrugserkennungsmodell mit CoCo zu erstellen, das nur Prompts in natürlicher Sprache verwendet.
Performance
Unsere Benchmarks zeigen, dass sowohl Online-Feature-Serving als auch Online-Model-Serving die Konkurrenz in Bezug auf Latenz und Kosten übertreffen, die Unternehmen für die Betrugserkennung benötigen. Der Online Feature Store von Snowflake stellt Features in Echtzeit mit 2,5-mal geringerer Latenz und 7-mal höheren QPS als Databricks bereit, und die Echtzeit-Modellinferenz in Snowflake ist 2- bis 5-mal schneller und bis zu 3-mal günstiger in Snowflake als in Sagemaker und Databricks.
Für den Snowflake Feature Store können wir durch eine Postgres-gestützte Engine eine konsistente Bereitstellung mit geringer Latenz liefern, typischerweise unter 10 ms bei P50 für Lesevorgänge mit geringer Latenz – gepaart mit einer dedizierten Streaming-Transformations-Engine, die eine End-to-End-Aktualität von typischerweise unter 200 ms bei P50 ermöglicht. Mit nativem Connection Pooling und Single-Tenant-Isolation pro Schema auf SPCS hält der zustandslose REST-Endpunkt selbst bei Traffic-Spitzen eine konsistent niedrige Latenz aufrecht, die bei über 40.000 QPS unter Last getestet wurde.
Für die Inferenz liefern wir auch eine schnellere und günstigere Modellinferenz, indem wir CPU-intensive Bereitstellungsaufgaben – wie Anforderungsverarbeitung, Serialisierung und Batching – von der GPU-gebundenen Modellausführung entkoppeln, sodass jede Schicht unabhängig skaliert werden kann. Dynamisches Batching verarbeitet Anforderungen bei geringem Traffic sofort und kombiniert sie unter Last automatisch, um die GPU-Parallelität zu maximieren. Das Request-Pipelining hält die GPUs kontinuierlich versorgt, indem der nächste Batch bereitgestellt wird, bevor der aktuelle abgeschlossen ist – wodurch Leerlaufzeiten eliminiert und ein höherer Durchsatz pro GPU erzielt wird.
Erste Schritte
Um mit der Erstellung von Echtzeit-Workflows zur Betrugserkennung in Snowflake zu beginnen, sehen Sie sich die folgenden Ressourcen an:
Umfassender geführter Quickstart zur Betrugserkennung
Geführter Quickstart zum Ausprobieren von Agentic ML für die Betrugserkennung

