
不正行為は深刻化する問題であり、コンプライアンス費用を年々押し上げています。効果的でリアルタイムな不正防止によって規制コンプライアンスを達成することは、金融サービス業界において最も重要かつコストのかかる課題の1つに急速になりつつあります。エンタープライズ対応の不正検知は、トランザクションパターンを継続的かつ動的に分析し、異常をフラグ付けし、新たな脅威にリアルタイムで適応する堅牢な機械学習インフラストラクチャに依存しています。
トランザクションが決済される前に悪意のあるアクターを捕捉するには、ミリ秒単位で不正を検知するように設計された本番環境レベルのインフラストラクチャが必要です。本ブログ記事では、Snowflake MLがストリーミング特徴量、低レイテンシーのモデルサービング、MLOpsを単一のデータおよびMLプラットフォームに統合することで、これらのリアルタイムの課題にどのように対処するかについて詳しく説明します。特に、Snowflakeのオンライン特徴量ストア(一般提供開始)を使用して、10ミリ秒未満で特徴量を提供し、リアルタイムのストリーミングイベントから1秒未満の特徴量の鮮度を実現することで、不正検知ワークフローを本番環境に導入する利点に焦点を当てます。
困難な理由:実際の課題
すべての金融機関にとって、エンタープライズ規模で不正検知の問題に対処することを困難にする3つの主要な課題があります。リアルタイムトランザクションの結果のレイテンシー、絶えず変化する不正手口の状況、そして機密性の高い顧客データおよび財務データの包括的なセキュリティとガバナンスの要件です。
レイテンシーの課題への対処
レガシーなバッチパイプラインや静的なルールエンジンでは、ミリ秒単位のSLA内で最新の行動データに対してライブトランザクションを評価できないため、ほとんどの機関はリアルタイムでの不正検知に苦労しています。不正行為を阻止するには、1秒未満の特徴量の鮮度を提供できるアーキテクチャが必要です。これには、ストリーム特徴量ビューを使用して、ライブイベント(e.g.ログイン、トランザクション)を低レイテンシーのサービングレイヤーに継続的に取り込むことが含まれます。推論時には、リアルタイム特徴量ビューがリクエストレベルのメトリクスを動的にコンピュートする必要があります(e.g.現在のトランザクションの支出を顧客の過去のベースラインと比較するなど)。
経時的なモデルパフォーマンスの監視
攻撃者が適応するにつれて、不正モデルは劣化します。前四半期に合成ID不正を検知したものが、今四半期の次世代の攻撃を見逃す可能性があります。これがモデルドリフトであり、ほとんどの機関は発見が遅すぎます。経時的なパフォーマンスの監視に成功している企業は、ビジネスの変化にシームレスに適応するために、関連する特徴量やモデルを簡単に開発、反復、本番環境に昇格できるフルマネージドのMLシステムを備えています。
すべてのデータをセキュアに保ち、ガバナンスを維持
ほとんどのレガシーな不正検知システムでは、推論呼び出しによってデータが外部プラットフォームに送信されることがよくあります。エグレスは、規制対象の金融機関にとって許容できないレベルのガバナンスリスクにつながります。機密データを含む本番環境の不正検知システムには、エンドツーエンドのデータリネージとデータガバナンスが不可欠です。
これらのビジネス上の課題は、従来のMLインフラストラクチャの制限に直接起因しており、それらを解決するには、エンタープライズ規模で構築されたエンドツーエンドのリアルタイムMLプラットフォームが必要です。
成功する不正検知の姿
VALID Systemsは、金融機関が窓口、ATM、モバイルチャネル全体でリアルタイムに不正を防止できるよう支援し、4億2,500万以上のユニークアカウント全体で毎月60億ドル以上の即時利用可能な資金を保証しています。
レガシーソリューションが限界に達した後、VALID SystemsはSnowflake上で不正検知MLプラットフォームを再構築し、すべての特徴量、トレーニングデータ、モデル、推論が1か所に存在するようにして、エグレスなしで同じAPIコントラクトを維持しました。
VALIDのモデルは現在、単に行が正しいか間違っているかだけでなく、下した決定の金額価値を最適化しています。この目的の移行により、パフォーマンスが向上します。最もリスクの高いトランザクションを対象とした小さな改善は、すべてのトランザクションに均等に分散された大きな改善を上回ります。すべてのチューニングの実行はログに記録され、監査可能であるため、コンプライアンスチームは後付けではなくプロセスの副産物としてドキュメントを取得できます。
この新しいプラットフォームの変更の結果、VALIDは預金損失率を7%〜10%低下させ、銀行の不正損失を15%〜17%多く検知しました。

銀行規模におけるリアルタイム機械学習は、Snowflake上ですでに『解決済みの課題』です。
Michael Ring
CTO/CIO, VALID Systems
大規模な不正検知をモダナイズしたもう1つのお客様はNeonです。同社はブラジルで最も急成長しているデジタル金融機関の1つであり、2,700万人以上の顧客に決済およびクレジット製品を提供しています。すべてのログイン、カード支払い、送金、ローンリクエストは、まずNeonの社内不正エンジンであるViperを通過します。Viperがリアルタイムで決定を下すには、数分から数か月のウィンドウでのトランザクション数など、最新の行動特徴量が必要です。
Neonの以前の特徴量ストアベンダーであるTectonが廃止されることになり、チームには厳しい期限が設けられました。Neonは複数のプロバイダーを評価し、低レイテンシー、最新のストリーミングおよびリアルタイム特徴量、オンライン特徴量とオフライン特徴量全体での同じガバナンス、Pythonicな開発者体験、そしてコストを1か所で可視化して制御を強化できるという4つの理由からSnowflakeを選択しました。
チームは3か月で、Snowflake特徴量ストア上の8つの不正ワークフロー全体で約300の特徴量を再構築しました。その結果、NeonはP99の特徴量レイテンシーを140ミリ秒から72ミリ秒に短縮し、Snowflakeでほぼ2倍の速度を実現しました。Viperのサービス可用性は99.7%から99.9%に向上し、Viperの不正防止カバレッジが拡大しました。
機械学習モデルは当社の成長戦略の中核を担っており、それを実現できるのは、大規模な拡張に耐えうる特徴量ストアがあってこそです。Snowflake特徴量ストアの導入により、P99レイテンシは約140ミリ秒から約72ミリ秒へとほぼ半減(約2倍の高速化)し、不正検知エンジンの可用性は99.7%から99.9%へと向上しました。
Thiago Bianchi, Ph.D.
Senior Staff Software & Machine Learning Engineer, Neon
モダンな不正検知のための技術的ブループリント
Snowflake MLを使用することで、VALID SystemsやNeonなどのお客様は、以下の利点をすぐに利用できるため、モダンなビジネス要件に合わせてスケールする堅牢な不正検知プラットフォームを構築できます。
低レイテンシーの予測:オンライン特徴量ストアを使用して10ミリ秒未満で提供される特徴量と、Snowflakeモデルレジストリから100ミリ秒未満で提供されるモデル。
統合された監視:組み込みのMLOpsを使用して、経時的なパフォーマンスと精度の監視、説明、アラートの受信を簡単に行う機能。
セキュリティとガバナンス:単一のプラットフォーム上でデータ、特徴量、モデルを統合し、機密性の高い顧客データのエグレスによるリスクを排除します。
オンライン特徴量サービングやモデルサービングなどのオンラインML機能は、リアルタイムの不正検知ワークフローの中核です。本日、Snowflakeのオンライン特徴量ストアが一般提供され、あらゆる本番環境のユースケース向けのモデルサービングに加わったことをお知らせします。Snowflake Postgres上に構築されたオンライン特徴量ストアは、予測時にモデルに対して、リスクスコア、アクティビティパターン、行動特徴量などの最新でレイテンシーに敏感なMLシグナルを提供します。これらのワークロードでは、1秒あたり数千回の予測が必要であり、それぞれがミリ秒単位で特徴量を返す必要があります。オンライン特徴量ストアはオンラインモデルサービングと直接統合されており、低レイテンシーの不正予測を簡単に生成できます。
特徴量がコンピュートされると、モデルはリアルタイムで提供される準備が整います。モデルサービングの場合、Snowflakeはトレーニング済みのモデルをSnowpark Container Services(SPCS)上のフルマネージド推論サービスとしてデプロイします。Snowflakeモデルレジストリに登録されているモデルは、専用のRESTエンドポイントへの単一のAPI呼び出しでデプロイできます。モデルサービスはオンライン特徴量ストアと直接統合されており、サービスはオンラインストアから最新の特徴量を自動的にフェッチします。特徴量の取得とモデルの実行がこのように密接に結合されているため、特徴量の検索から予測まで、包括的な不正スコアリングの決定が単一のネットワークラウンドトリップで行われ、ネットワークレイテンシーと外部データの移動が最小限に抑えられます。
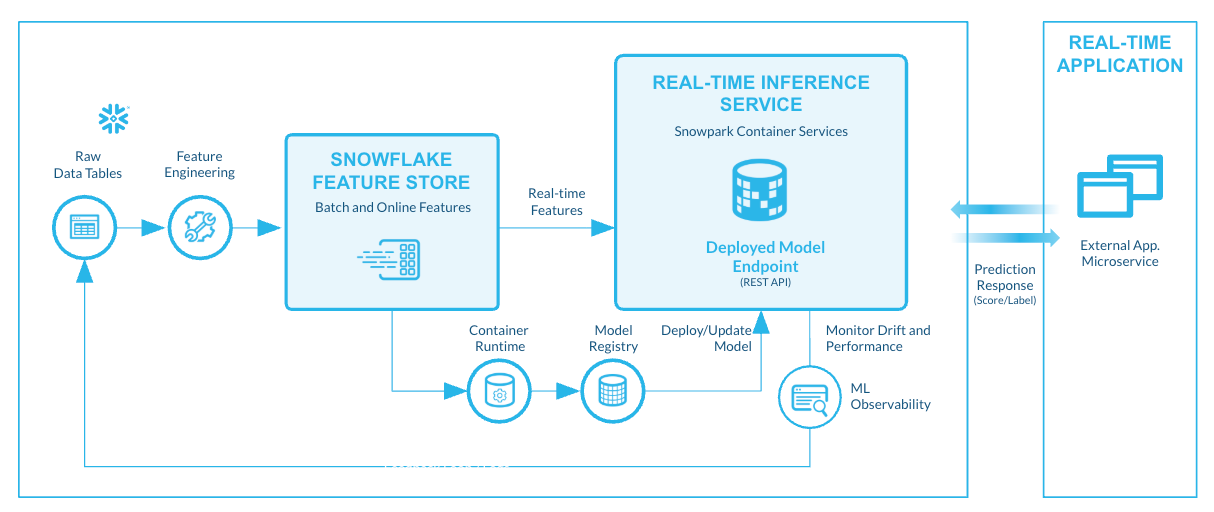
図1:オンライン特徴量ストアはオンラインモデルサービングと直接統合されており、お客様はモデル推論リクエストから直接特徴量を検索できます。
オンライン特徴量ストアとオンラインモデルサービングを統合されたMLプラットフォームと組み合わせることで、業界最大の不正検知のハードルを解決するために必要な技術的基盤が提供されます。Snowflake MLが金融機関の最もビジネスに不可欠なニーズにどのように対処するかについて詳しく見ていきましょう。
ミリ秒単位でのイベントから決定まで
不正を捕捉するということは、モデルが可能な限り最新のシグナルを確認する必要があることを意味します。昨晩のバッチ実行でコンピュートされた特徴量ではなく、数秒前に起こったことを反映するシグナルです。SnowflakeのオンラインMLプラットフォームは、イベントの展開に合わせて最新のシグナルに基づいて不正の決定を維持するストリーミング特徴量を中心に構築されています。
その中核となるのがストリーム特徴量ビューです。これは、REST取り込みAPIを介してトランザクション、ログイン、デバイスシグナルなどのイベントをリアルタイムで取り込み、p50で200ミリ秒未満のエンドツーエンドの鮮度で更新された特徴量を提供します。バックグラウンドでは、イベントは低レイテンシーの読み取りのためにマネージドPostgresサービングレイヤーに同期的に書き込まれます。イベントが到着すると、オンライン特徴量ストアは「過去48時間の総支出」や「過去1時間のトランザクション数」などの時間枠の集計を継続的にコンピュートし、生のイベント履歴を定期的に再スキャンするのではなく、累計を維持します。つまり、不正モデルは常に、古いスナップショットではなく、最新のアクティビティを反映した行動シグナルを確認します。
トランザクション金額やデバイスフィンガープリントなど、現在のリクエストに依存する特徴量の場合、リアルタイム特徴量ビューはクエリ時間中にオンザフライで派生値をコンピュートします。推論時にPython関数が実行され、リクエストごとの入力と、モデルに到達する前の上流の特徴量ビューからの事前コンピュートされた特徴量を組み合わせます。たとえば、不正モデルは、現在のトランザクション金額(リクエスト時)を顧客の移動平均支出(ストリーム特徴量ビューによって継続的に維持される)と比較して、異常が発生した瞬間にフラグを立てることができます。
統合された監視と実験
攻撃者が適応するにつれて、不正モデルは劣化します。SnowflakeのMLOpsは、特徴量ストアおよびモデルレジストリとネイティブに統合されており、経時的なパフォーマンスと精度の監視、説明、アラートの受信を簡単に行うことができます。ゲートウェイ監視、モデルのオブザーバビリティ、オンライン特徴量サービングダッシュボードはすべてSnowsightからアクセスでき、チームはMLライフサイクル全体を単一の画面で確認できます。モデルモニターは、ドリフト、パフォーマンス、予測ボリュームを継続的に測定します。グラウンドトゥルースラベルが到着すると、Snowflakeはそれらを推論ログに自動的に結合し、追加のパイプライン作業なしで精度、適合率、再現率をコンピュートします。
実験のために、Snowflakeのゲートウェイ監視はA/Bテストとシャドウテストをサポートしており、モデルバージョン間でライブトラフィックを分割またはミラーリングし、チャレンジャーを昇格させる前に精度、レイテンシー、エラー率を比較できます。[オンラインサービング]タブでは、特徴量ストアの健全性をリアルタイムで可視化できます。これらはすべてデータと同じプラットフォーム上で発生するため、デフォルトでセキュアに保たれ、ガバナンスが維持されます。
統合されたセキュリティとガバナンス
不正検知システムは、アカウント番号、トランザクション履歴、個人を特定できる情報など、組織が保持する最も機密性の高いデータを処理します。レガシーアーキテクチャの一般的なリスクは、推論呼び出しによってこのデータが外部プラットフォームに送信され、規制対象の金融機関が許容できないガバナンスのギャップが生じることです。
Snowflakeでは、特徴量エンジニアリングからモデルトレーニング、サービング、監視に至るまで、MLライフサイクル全体が、データがすでに存在する同じプラットフォーム上で実行されます。機密データは、Snowflakeのセキュリティ境界内でセキュアに処理されます。モデルは、完全なロールベースのアクセス制御を備えたスキーマレベルのオブジェクトです。きめ細かい権限を付与して、データサイエンティストが開発で反復できるようにする一方で、本番環境のロールが昇格されるものを制御できます。MLリネージは、ソーステーブルから特徴量ビューやデータセットを経由して、登録されたモデルやサービスにデータがどのように流れるかを自動的にトレースし、コンプライアンスチームにエンドツーエンドの出所を提供します。また、これらはすべてSnowflakeの統合セキュリティモデルによってガバナンスが維持されるため、データを保護するのと同じネットワークポリシー、暗号化、監査ログがMLワークフローも保護します。
エージェンティックな不正検知ワークフロー
Snowflakeでは、Snowflake CoCoのエージェンティックMLワークフローを使用して、チームが開発を加速できるよう支援することにも取り組んでいます。データサイエンスチームは、CoCoを使用して、開発と推論全体の各ステップに最適な手法をエージェンティックに計画、推論、選択することで、完全に機能する高品質のMLパイプラインを迅速に構築できます。ドキュメントの確認、エラーのデバッグ、APIのつなぎ合わせに時間を費やす代わりに、不正に関するドメインの専門知識と直感を適用してモデルを改良し、インサイトを導き出すことに集中できます。
不正検知のユースケース向けに、完全なエージェンティックワークフローをサポートしています。自然言語のプロンプトのみを使用してCoCoで不正検知モデルを構築するには、このクイックスタートに従ってください。
パフォーマンス
当社のベンチマークによると、オンライン特徴量サービングとオンラインモデルサービングはどちらも、企業が不正検知に必要とするレイテンシーとコストの面で競合他社を上回っています。Snowflakeのオンライン特徴量ストアは、Databricksと比較して2.5倍低いレイテンシーと7倍高いQPSで特徴量をリアルタイムに提供し、Snowflakeでのリアルタイムモデル推論は、SagemakerやDatabricksと比較して2〜5倍高速で最大3倍安価です。
Snowflake特徴量ストアでは、Postgresベースのエンジンを通じて一貫して低レイテンシーのサービングを提供でき、低レイテンシーの読み取りでは通常P50で10ミリ秒未満を実現します。これに専用のストリーミング変換エンジンを組み合わせることで、通常P50で200ミリ秒未満のエンドツーエンドの鮮度を可能にします。SPCS上のネイティブな接続プーリングとスキーマごとのシングルテナント分離により、ステートレスなRESTエンドポイントはトラフィックの急増時でも一貫した低レイテンシーを維持し、40,000 QPSを超える負荷テストをクリアしています。
推論については、リクエスト処理、シリアル化、バッチ処理などのCPU負荷の高いサービングタスクを、GPUバウンドのモデル実行から分離することで、各レイヤーを独立してスケールできるようにし、より高速で安価なモデル推論も提供します。動的バッチ処理は、トラフィックが少ない場合はリクエストを即座に処理し、負荷がかかっている場合は自動的に組み合わせてGPUの並列処理を最大化します。また、リクエストのパイプライン処理により、現在のバッチが終了する前に次のバッチをステージングすることでGPUに継続的に供給し、アイドル状態のギャップを排除してGPUあたりのスループットを向上させます。
使用を開始する
Snowflakeでリアルタイムの不正検知ワークフローの構築を開始するには、以下のリソースをご確認ください。
包括的な不正検知のガイド付きクイックスタート
不正検知向けのエージェンティックMLを試すためのガイド付きクイックスタート

