
20 ottobre 2026/Lettura: 11 minServizi finanziari
Come creare una piattaforma moderna di rilevamento frodi con l’ML online
Le frodi sono un problema in crescita che continua a far aumentare i costi di conformità anno dopo anno. Garantire la conformità normativa con una prevenzione delle frodi efficace e in tempo reale è diventata rapidamente una delle sfide più critiche e costose per il settore dei servizi finanziari. Un sistema di rilevamento delle frodi pronto per l’enterprise si basa su un’infrastruttura di machine learning robusta, in grado di analizzare in modo continuo e dinamico i pattern delle transazioni, segnalare anomalie e adattarsi alle minacce emergenti in tempo reale.
Individuare gli attori malevoli prima che una transazione venga completata richiede un’infrastruttura di livello produttivo progettata per rilevare le frodi in millisecondi. In questo post, approfondiremo come Snowflake ML affronta queste sfide in tempo reale unificando feature in streaming, model serving a bassa latenza e MLOps su un’unica piattaforma dati e ML. In particolare, evidenziamo i vantaggi derivanti dall’utilizzo dell’Online Feature Store Snowflake (ora disponibile in GA) per portare in produzione i workflow di rilevamento delle frodi, servendo le feature in meno di 10 ms e garantendo un aggiornamento delle feature inferiore al secondo a partire da eventi di streaming in tempo reale.
Perché è difficile: le sfide reali
Per tutte le istituzioni finanziarie, ci sono tre sfide principali che rendono difficile affrontare il problema del rilevamento delle frodi su scala enterprise: la latenza dei risultati per le transazioni in tempo reale, il panorama in continua evoluzione delle tattiche di frode e i requisiti completi di sicurezza e governance dei dati sensibili dei clienti e finanziari.
Affrontare il problema della latenza
La maggior parte delle istituzioni fatica a rilevare le frodi in tempo reale perché le pipeline batch legacy e i motori di regole statiche non sono in grado di valutare le transazioni live rispetto a dati comportamentali aggiornati entro SLA dell’ordine dei millisecondi. Bloccare le frodi richiede un’architettura in grado di garantire un aggiornamento delle feature inferiore al secondo. Questo include l’utilizzo di stream feature view per acquisire in modo continuo eventi live (e.g. login, transazioni) in un livello di serving a bassa latenza. Durante l’inferenza, le real-time feature view devono calcolare dinamicamente metriche a livello di richiesta (e.g. confrontando la spesa della transazione corrente con il baseline storico del cliente).
Monitorare le performance del modello nel tempo
I modelli di rilevamento delle frodi si degradano man mano che gli avversari si adattano. Ciò che rilevava le frodi da identità sintetica nel trimestre scorso potrebbe non individuare la nuova generazione di attacchi di questo trimestre. Questo è il model drift, e la maggior parte delle istituzioni lo scopre troppo tardi. Le aziende che hanno successo nel monitorare le performance nel tempo dispongono di sistemi ML completamente gestiti, facili da sviluppare, su cui iterare e portare in produzione feature e modelli rilevanti, per adattarsi senza interruzioni ai cambiamenti del business.
Mantenere tutti i dati sicuri e governati
Nella maggior parte dei sistemi legacy di rilevamento delle frodi, le chiamate di inferenza spesso inviano dati a una piattaforma esterna. L’egress comporta un livello di rischio di governance che può risultare inaccettabile per le istituzioni finanziarie regolamentate. Il data lineage end-to-end e la governance dei dati sono requisiti indispensabili per un sistema di rilevamento delle frodi in produzione che gestisce dati sensibili.
Queste sfide di business derivano direttamente dai limiti delle infrastrutture ML tradizionali, e risolverle richiede una piattaforma ML end-to-end e in tempo reale, progettata per la scala enterprise.
Com’è fatto un sistema di rilevamento delle frodi di successo
VALID Systems aiuta le istituzioni finanziarie a prevenire le frodi in tempo reale sui canali teller, ATM e mobile, garantendo ogni mese oltre 6 miliardi di dollari di fondi immediatamente disponibili su più di 425 milioni di conti unici.
Dopo che la sua soluzione legacy aveva raggiunto il proprio limite massimo, VALID Systems ha riprogettato la propria piattaforma ML di rilevamento delle frodi su Snowflake, in modo che feature, dati di training, modelli e inferenza esistessero tutti in un unico posto, mantenendo lo stesso contratto API con zero egress.
I modelli di VALID ora si ottimizzano in base al valore in dollari delle decisioni che prendono, non solo in base al fatto che una riga sia corretta o errata. Questo cambio di obiettivo amplifica le performance. Un piccolo miglioramento mirato alle transazioni a più alto rischio supera un miglioramento più ampio ma distribuito uniformemente su tutte le transazioni. Ogni run di tuning viene registrato ed è completamente verificabile, così i team di compliance ottengono la documentazione come sottoprodotto del processo e non come un ripensamento successivo.
Grazie a questo cambiamento di piattaforma, VALID ha ottenuto una riduzione del 7-10% nei tassi di perdita sui depositi e ha rilevato il 15-17% in più di perdite dovute a frodi bancarie.

L'ML real-time per il il banking è un problema risolto con Snowflake.
Michael Ring
CTO/CIO, VALID Systems
Un altro cliente che ha modernizzato il rilevamento delle frodi su larga scala è Neon, una delle istituzioni finanziarie digitali in più rapida crescita in Brasile, che serve oltre 27 milioni di clienti con prodotti di pagamento e credito. Ogni login, pagamento con carta, trasferimento e richiesta di prestito passa prima attraverso Viper, il motore antifrode interno di Neon. Viper ha bisogno di feature comportamentali aggiornate, come il conteggio delle transazioni su finestre temporali che vanno da minuti a mesi, per prendere una decisione in tempo reale.
Tecton, il precedente fornitore di feature store di Neon, stava per essere dismesso, il che ha imposto al team una scadenza improrogabile. Neon ha valutato diversi fornitori e ha scelto Snowflake per quattro motivi: bassa latenza, feature in streaming e in tempo reale sempre aggiornate, la stessa governance su feature online e offline, un’esperienza di sviluppo Pythonic e maggiore controllo, con i costi visibili in un unico posto.
In tre mesi, il team ha ricostruito quasi 300 feature su otto workflow antifrode con Snowflake Feature Store. Di conseguenza, Neon ha ridotto la latenza P99 delle feature da 140 ms a 72 ms, quasi raddoppiando la velocità con Snowflake. La disponibilità del servizio Viper è passata dal 99,7% al 99,9%, aumentando la copertura antifrode di Viper.
I modelli di machine learning sono al centro della nostra strategia di crescita, e questo è possibile solo con un feature store in grado di scalare. Con Snowflake Feature Store la nostra latenza P99 è scesa da circa 140 millisecondi a circa 72 millisecondi, quasi il doppio della velocità, e la disponibilità del nostro motore antifrode è passata dal 99,7% al 99,9%.
Thiago Bianchi, Ph.D.
Senior Staff Software & Machine Learning Engineer, Neon
Il modello tecnico per il rilevamento moderno delle frodi
Con Snowflake ML, clienti come VALID Systems e Neon sono in grado di creare piattaforme di rilevamento delle frodi robuste e scalabili per soddisfare le esigenze di business moderne, grazie ai seguenti vantaggi disponibili immediatamente:
Previsioni a bassa latenza: feature servite in meno di 10 ms con Online Feature Store e modelli in meno di 100 ms da Snowflake Model Registry.
Monitoraggio integrato: capacità di monitorare, spiegare e ricevere avvisi facilmente su performance e accuratezza nel tempo, grazie a MLOps integrato.
Sicurezza e governance: dati, feature e modelli unificati su un’unica piattaforma, eliminando i rischi legati all’egress di dati sensibili dei clienti.
Le capacità di ML online, tra cui online feature serving e model serving, sono al centro dei workflow di rilevamento delle frodi in tempo reale. Oggi siamo entusiasti di annunciare che l’Online Feature Store Snowflake è ora disponibile in GA, affiancandosi al model serving per qualsiasi caso d’uso in produzione. Basato su Snowflake Postgres, il nostro Online Feature Store fornisce ai modelli, al momento della previsione, segnali ML aggiornati e sensibili alla latenza (punteggi di rischio, pattern di attività e feature comportamentali). Questi workload richiedono migliaia di predizioni al secondo, ognuna delle quali necessita di feature restituite in millisecondi. L’Online Feature Store è integrato direttamente con l’online model serving per generare facilmente previsioni antifrode a bassa latenza.
Una volta calcolate le feature, il modello è pronto per essere servito in tempo reale. Per il model serving, Snowflake distribuisce i modelli addestrati come servizi di inferenza completamente gestiti su Snowpark Container Services (SPCS). Qualsiasi modello registrato nel Snowflake Model Registry può essere distribuito con un’unica chiamata API verso un endpoint REST dedicato. Il servizio del modello si integra direttamente con l’Online Feature Store e recupera automaticamente le feature più recenti dallo store online. Questo stretto accoppiamento tra il recupero delle feature e l’esecuzione del modello fa sì che una decisione completa di scoring antifrode (dalla ricerca delle feature alla previsione) avvenga in un unico round trip di rete, riducendo al minimo la latenza di rete e lo spostamento di dati esterni.
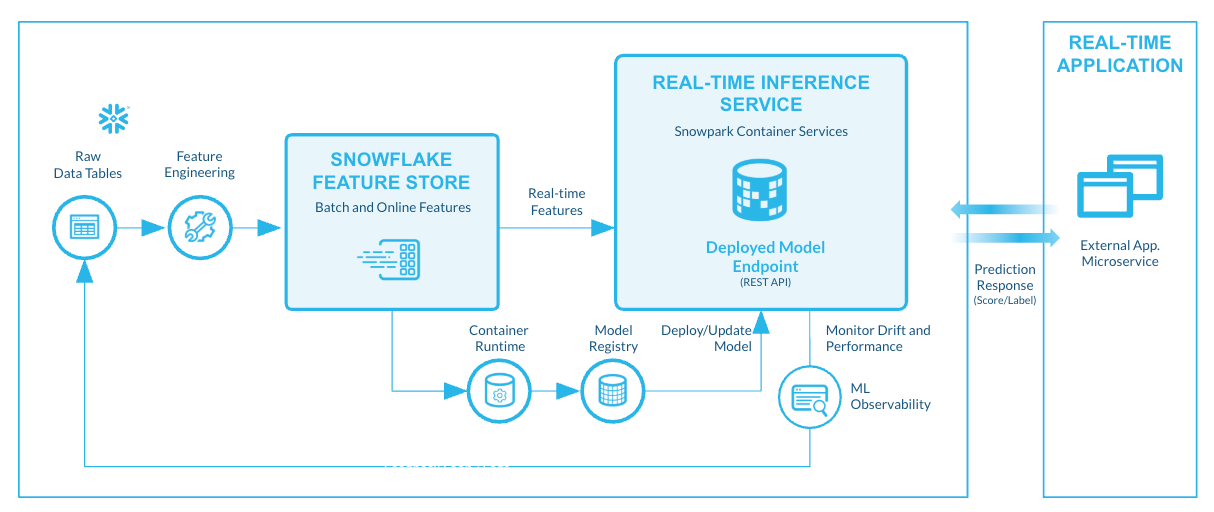
Figura 1. L’Online Feature Store è integrato direttamente con l’online model serving, consentendo ai clienti di cercare le feature direttamente dalle richieste di inferenza del modello.
Insieme, l’Online Feature Store e l’online model serving, uniti alla nostra piattaforma ML integrata, offrono le basi tecniche necessarie per risolvere i maggiori ostacoli del settore nel rilevamento delle frodi. Vediamo ora come Snowflake ML risponde alle esigenze più critiche per il business delle istituzioni finanziarie.
Dall’evento alla decisione in millisecondi
Individuare le frodi significa che il modello deve vedere i segnali più aggiornati possibili: non feature calcolate nel batch della notte precedente, ma segnali che riflettono ciò che è accaduto pochi secondi prima. La piattaforma di ML online Snowflake è costruita attorno a feature in streaming che mantengono le decisioni antifrode basate su segnali aggiornati man mano che gli eventi si verificano.
Al centro ci sono le stream feature view, che acquisiscono in tempo reale eventi come transazioni, login e segnali dei dispositivi tramite una REST ingestion API e servono feature aggiornate con una freschezza end-to-end inferiore a 200 ms al p50. Dietro le quinte, gli eventi vengono scritti in modo sincrono in un livello di serving Postgres gestito, per garantire letture a bassa latenza. Man mano che gli eventi arrivano, l’Online Feature Store calcola continuamente aggregazioni su finestre temporali, come “spesa totale nelle ultime 48 ore” o “numero di transazioni nell’ultima ora”, mantenendo totali progressivi invece di riscansionare periodicamente la cronologia completa degli eventi. Questo significa che il modello antifrode vede sempre segnali comportamentali che riflettono l’attività più recente, non uno snapshot obsoleto.
Per le feature che dipendono dalla richiesta corrente, come l’importo della transazione o il fingerprint del dispositivo, le real-time feature view calcolano valori derivati al volo al momento della query. Una funzione Python viene eseguita al momento dell’inferenza, combinando gli input specifici della richiesta con le feature precalcolate provenienti dalle feature view upstream, prima che raggiungano il modello. Ad esempio, un modello antifrode può confrontare l’importo della transazione corrente (al momento della richiesta) con la spesa media mobile del cliente (mantenuta continuamente dalla stream feature view) per segnalare le anomalie nel momento esatto in cui si verificano.
Monitoraggio e sperimentazione integrati
I modelli di rilevamento delle frodi si degradano man mano che gli avversari si adattano. L’MLOps Snowflake è integrato in modo nativo con il nostro feature store e model registry, per monitorare, spiegare e ricevere avvisi facilmente su performance e accuratezza nel tempo. Il gateway monitoring, l’osservabilità dei modelli e le dashboard online di feature serving sono tutti accessibili da Snowsight, offrendo ai team un’unica vista su tutto il ciclo di vita ML. I model monitor misurano continuamente drift, performance e volume delle previsioni. Quando arrivano le etichette di ground truth, Snowflake le unisce automaticamente ai log di inferenza, calcolando accuratezza, precision e recall senza ulteriore lavoro sulla pipeline.
Per la sperimentazione, il gateway monitoring Snowflake supporta A/B testing e shadow testing, consentendo di dividere o replicare il traffico live tra diverse versioni del modello e confrontare accuratezza, latenza e tassi di errore prima di promuovere uno sfidante. La scheda Online Serving offre visibilità in tempo reale sullo stato di salute del feature store. Tutto questo è protetto e governato per impostazione predefinita, perché avviene sulla stessa piattaforma dei tuoi dati.
Sicurezza e governance unificate
I sistemi di rilevamento delle frodi gestiscono alcuni dei dati più sensibili in possesso di un’organizzazione: numeri di conto, storici delle transazioni e informazioni personali identificabili. Un rischio comune delle architetture legacy è che le chiamate di inferenza inviano questi dati a una piattaforma esterna, creando lacune di governance che le istituzioni finanziarie regolamentate non possono permettersi.
In Snowflake, l’intero ciclo di vita ML (dal feature engineering al training, al serving e al monitoraggio dei modelli) viene eseguito sulla stessa piattaforma in cui i dati già risiedono. I dati sensibili sono protetti ed elaborati all’interno del perimetro di sicurezza Snowflake. I modelli sono oggetti a livello di schema con controllo degli accessi basato sui ruoli completo: puoi concedere privilegi granulari in modo che i data scientist possano iterare in fase di sviluppo, mentre i ruoli di produzione controllano cosa viene promosso. ML Lineage traccia automaticamente il flusso dei dati dalle tabelle di origine, attraverso feature view e dataset, fino ai modelli e ai servizi registrati, offrendo ai team di compliance una provenienza end-to-end. E poiché tutto questo è governato dal modello di sicurezza unificato Snowflake, le stesse policy di rete, la crittografia e l’audit logging che proteggono i tuoi dati proteggono anche i tuoi workflow ML.
Workflow agentici per il rilevamento delle frodi
In Snowflake, ci impegniamo anche ad aiutare i team ad accelerare lo sviluppo con workflow di ML agentico grazie a Snowflake CoCo. I team di data science possono creare rapidamente pipeline ML pienamente funzionali e di alta qualità, utilizzando CoCo per pianificare, ragionare e selezionare in modo agentico la tecnica ottimale per ogni fase, dallo sviluppo all’inferenza. Invece di perdere tempo a consultare la documentazione, eseguire il debug degli errori o assemblare API diverse, puoi concentrarti sull’applicare la tua esperienza e intuizione nel dominio della frode per perfezionare i modelli e ottenere insight.
Supportiamo flussi di lavoro agentici completi per i casi d’uso di rilevamento delle frodi. Segui questa quickstart per creare un modello di rilevamento delle frodi con CoCo utilizzando solo prompt in linguaggio naturale.
Prestazioni
I nostri benchmark dimostrano che sia l’online feature serving sia l’online model serving superano la concorrenza in termini di latenza e costi richiesti dalle aziende per il rilevamento delle frodi. L’Online Feature Store Snowflake offre feature in tempo reale con una latenza 2,5 volte inferiore e un QPS 7 volte superiore rispetto a Databricks, mentre l’inferenza dei modelli in tempo reale su Snowflake è da 2 a 5 volte più rapida e fino a 3 volte più economica rispetto a Sagemaker e Databricks.
Per lo Snowflake Feature Store, siamo in grado di garantire un serving costantemente a bassa latenza grazie a un motore basato su Postgres, in genere sotto i 10 ms al P50 per le letture a bassa latenza, abbinato a un motore di trasformazione in streaming dedicato che consente una freschezza end-to-end tipicamente inferiore a 200 ms al P50. Grazie al connection pooling nativo e all’isolamento single-tenant per schema su SPCS, l’endpoint REST stateless mantiene una latenza costantemente bassa anche durante i picchi di traffico, con test di carico superiori a 40.000 QPS.
Per l’inferenza, offriamo anche un’esecuzione dei modelli più rapida ed economica disaccoppiando le attività di serving ad alto utilizzo di CPU (come la gestione delle richieste, la serializzazione e il batching) dall’esecuzione dei modelli legata alla GPU, permettendo a ciascun livello di scalare in modo indipendente. Il batching dinamico elabora le richieste istantaneamente in caso di traffico basso, combinandole automaticamente sotto carico per massimizzare il parallelismo delle GPU, mentre il pipelining delle richieste mantiene le GPU costantemente alimentate preparando il batch successivo prima che quello corrente sia terminato, eliminando i tempi morti e aumentando il throughput per GPU.
Come iniziare
Per iniziare a creare flussi di lavoro per il rilevamento delle frodi in tempo reale su Snowflake, consulta le seguenti risorse:
Quickstart guidata completa per il rilevamento delle frodi
Quickstart guidata per provare l’ML agentico per il rilevamento delle frodi

