지난 몇 년 동안 엔터프라이즈 AI 스택은 정교해졌습니다. 하지만 이와 동시에 파편화되고 관리하기 어려운 에코시스템으로 진화했습니다. 이제 AI 스택은 벡터 데이터베이스, 모니터링 시스템, 파이프라인 튜닝을 비롯해 엔터프라이즈 시스템과 인터페이스하는 코딩 에이전트, 임베디드 에이전트, Model Context Protocol(MCP) 서버의 방대한 조합까지 포괄합니다. 여기에 몇 주마다 바뀌는 모델 포트폴리오가 더해집니다. 각 팀이 서로 다른 시점에 스택의 일부를 도입하면서 관리와 거버넌스 공백이 생길 수 있고, 이는 보안에도 영향을 미칠 수 있습니다.
이처럼 분절된 환경에서는 여러 접점에 걸쳐 다음과 같은 기본적인 질문에 정확히 답하는 데 필요한 완전한 맥락을 갖춘 기업이 많지 않습니다. 어떤 모델을 호출하고 있는가, 누가 호출하고 있는가, 어떤 작업을 수행하고 있는가, 그리고 관련 비용은 얼마인가?
이에 대한 본능적인 대응은 제한을 강화하는 것이지만, 장기적으로 지속 가능한 솔루션은 아닙니다. 직원들의 AI 사용 역량을 막으면 결국 승인되지 않은 AI 도구로 우회하게 되고, 이는 위험을 더욱 키웁니다.
이 공백은 도구의 문제가 아니라 빠져 있는 계층의 문제입니다. 최신 AI 스택에는 모든 AI 클라이언트와 이들이 접근하는 엔터프라이즈 시스템 사이에 위치하는 제어점이 필요합니다. Cortex AI Gateway(퍼블릭 프리뷰3)는 이러한 중앙 집중식 제어 영역으로 작동해, 현대적이고 다면적인 인프라에 필요한 통합 가시성, 거버넌스, 감독 체계를 제공함으로써 이 문제를 해결합니다. Snowflake는 최신 엔터프라이즈 AI 인프라 스택에 다음 6가지 요소가 반드시 필요하다고 봅니다.
통합되고 거버넌스가 적용되는 추론
동적 모델 라우팅
MCP 및 도구 거버넌스
중앙 집중식 옵저버빌리티
보안 정책과 가드레일
비용 거버넌스 및 제어
현재 퍼블릭 프리뷰로 제공되는 Cortex AI Gateway는 플랫폼 팀이 한곳에서 모델과 MCP 서버에 대한 액세스를 부여하고, 지출 속성을 파악하며 비용을 제어하고, AI가 사용자를 대신해 수행한 작업을 확인할 수 있도록 합니다. 애플리케이션 팀은 개발 기준으로 삼을 단일 엔드포인트를 확보합니다. 이제 스택의 각 계층에 Cortex AI Gateway가 어떻게 대응하는지 살펴보겠습니다.
Cortex AI Gateway는 기업 AI 인프라를 위한 Snowflake의 중앙 집중식 제어 영역입니다. 단일 엔드포인트를 통해 거버넌스가 적용된 모델 추론, 동적 모델 라우팅, MCP 도구 거버넌스, 옵저버빌리티, 보안 가드레일 및 비용 통제 기능을 제공합니다. 이를 통해 플랫폼 팀은 조직 내 모든 AI 클라이언트와 에이전트에 대한 통합 가시성을 확보할 수 있습니다.
통합되고 거버넌스가 적용되는 추론 에이전트에 단일 엔드포인트 사용
AI 스택이 커질 때 가장 먼저 문제가 되는 것은 모델로 향하는 경로의 수입니다. 엔지니어는 하나의 공급자에 맞춰 코딩 에이전트를 구성합니다. 플랫폼 팀은 두 번째 공급자에 애플리케이션을 연결합니다. 또 다른 사용자는 세 번째 공급자에 맞춰 스크립트를 작성합니다. 각 경로마다 별도의 자격 증명, 로그, 청구 체계가 생깁니다.
Cortex AI Gateway는 이를 하나의 엔드포인트로 통합합니다. Cortex AI Gateway는 OpenAI, Grok, GLM, Gemini, Llama, Mistral, DeepSeek 모델을 위한 Chat Completions API 와 Claude를 위한 Messages API 를 구현합니다. 이 두 프로토콜은 모델 서빙이 수렴해 온 표준입니다. 스트리밍, 도구 호출, 구조화된 출력, 프롬프트 캐싱, 이미지 입력, 추론이 모두 네이티브 방식과 동일하게 작동하므로, 기존 클라이언트를 Cortex AI Gateway에 연결하려면 다른 기본 URL과 토큰만 지정하면 됩니다. OpenAI Responses API 지원도 곧 제공될 예정입니다. 다음 예시는 Cortex AI Gateway로 OpenCode를 구성하는 데 필요한 전체 설정을 보여줍니다.
export PAT="<pat>"
export BASE_URL="<base_url>"
export OPENCODE_CONFIG_CONTENT='{
  "$schema": "https://opencode.ai/config.json",
  "model": "snowflake-cortex/openai-gpt-5.4",
  "small_model": "snowflake-cortex/openai-gpt-5.4",
  "provider": {
    "snowflake-cortex": {
      "options": {
        "baseURL": "${BASE_URL}",
        "account": "<ACCOUNT>.snowflakecomputing.com",
        "apiKey": "<PAT>",
        "headers": {
          "snow-agent-name": "opencode"
        }
      }
    }
  }
}'
액세스 제어는 Snowflake의 기존 역할 기반 액세스 제어(RBAC) 프레임워크를 사용합니다. 관리자는 게이트웨이를 통해 사용할 수 있는 모델을 구성해, 조직이 승인한 모델만 액세스 가능하도록 할 수 있습니다.
Cortex AI Gateway에서 코딩 에이전트를 더 쉽게 사용할 수 있도록 Snowflake CLI가 트래픽이 게이트웨이를 통과하도록 설정하는 과정을 처리할 예정입니다. 단 하나의 명령으로 활성 Snowflake 연결에서 자격 증명을 읽고, 이를 코딩 에이전트 구성에 주입한 뒤, 트래픽이 Cortex AI Gateway를 통해 라우팅되도록 에이전트를 실행할 수 있습니다. 예를 들어 Snowflake CLI로 OpenCode를 실행하려면 이제는 snow ai opencode만 실행하면 됩니다.
Cortex AI Gateway의 동적 모델 라우팅: 각 작업에 적합한 모델 선택
대부분의 팀은 모든 작업에 하나의 프런티어 모델을 사용하는 방식에 안착했습니다. 시작하기에는 합리적이지만, 확장 단계에서는 비용이 많이 드는 방식입니다. 에이전트 단계의 상당 부분은 파일 수정, 서식 지정, 조회처럼 더 저렴한 모델로도 동일한 품질과 정확도로 처리할 수 있는 작업입니다.
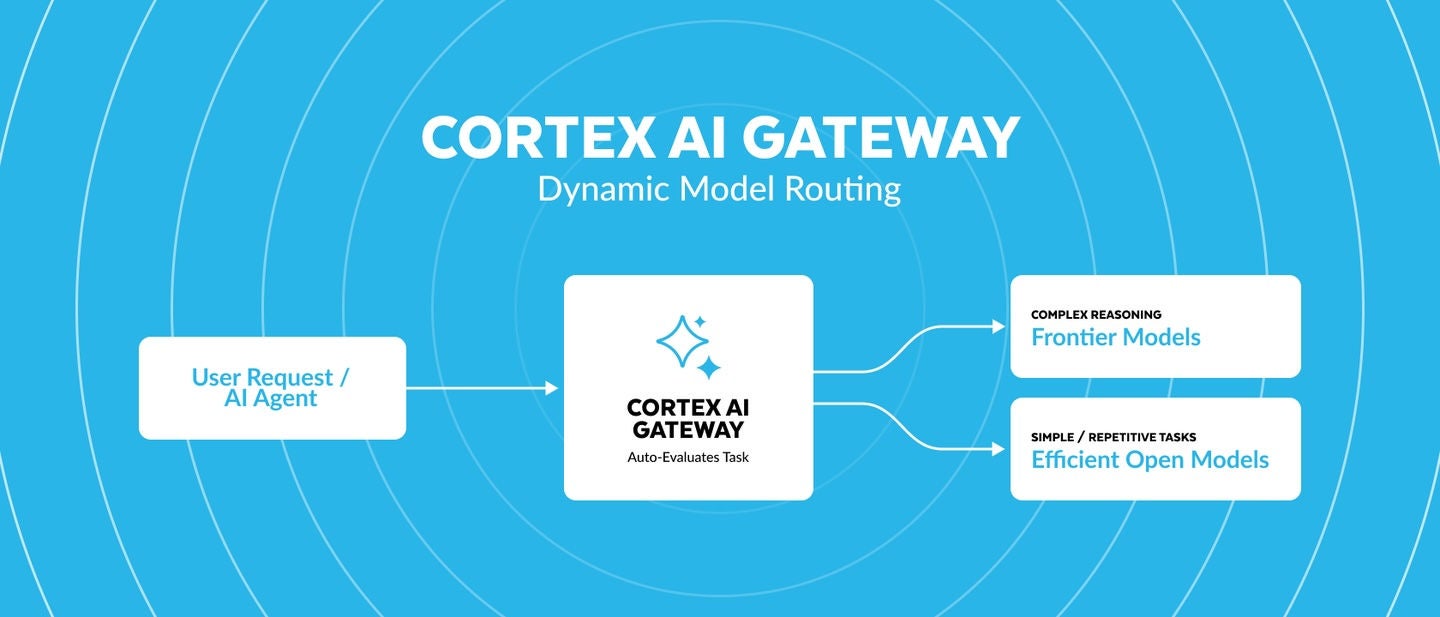
곧 Cortex AI Gateway를 통해 프라이빗 프리뷰로 제공될 동적 모델 라우팅은 에이전트 실행의 각 단계에서 작업을 자신 있게 완료할 수 있는 가장 경제적인 모델을 사용 가능한 옵션 중에서 선택합니다. Snowflake 연구팀이 이를 파인튜닝했기 때문에 복잡성이 낮고 반복적인 작업은 효율적인 모델로, 더 깊은 추론이 필요한 작업은 프런티어 모델로 전달됩니다. 내부 평가에서 이 기능은 유사한 품질을 유지하면서 프런티어 모델만 사용하는 방식보다 dbt 파이프라인 워크로드를 최대 3배 더 높은 토큰 효율성으로 완료했습니다. 별도의 코딩 테스트에서는 엔지니어링 팀이 약 25% 더 적은 토큰을 사용하면서도 pull request 처리량을 안정적으로 유지했습니다.1 이러한 결과는 기업의 실질적인 비용 절감으로 이어질 수 있습니다.
라우팅은 수동 모델 선택과 동일하게 거버넌스가 적용됩니다. 승인된 모델만 사용되고, 기존 데이터 레지던시 설정이 준수되며, 모든 라우팅 결정이 기록되므로 규정 준수 팀은 어떤 모델이 어떤 요청을 처리했는지 확인할 수 있습니다. 라우팅이 각 애플리케이션이 아니라 Cortex AI Gateway에 있기 때문에, 모델 가격과 성능이 바뀌더라도 Snowflake는 에이전트 구성을 변경하지 않고 라우팅 결정을 업데이트할 수 있습니다.
오픈소스 모델 측면도 중요합니다. Snowflake CoCo를 에이전트 하네스로 사용해 ADE-bench에서 평가한 결과, DeepSeek-V4-Flash는 74.4%를 기록해2 테스트한 주요 독점 모델을 앞섰습니다. GLM-5.3은 곧 프라이빗 프리뷰로 제공될 예정이며, 이전 모델인 GLM-5.2는 ADE-bench2에서 66%를 기록하고 벤치마크 내 모든 모델 중 가장 낮은 토큰 사용량을 보였습니다.2 이는 대용량 워크로드가 원하는 특성입니다. Snowflake는 이러한 모델을 안전한 Snowflake 경계 내에서 제공하므로, 이미 해당 데이터를 포괄하는 동일한 RBAC와 감사 추적 안에서 거버넌스가 적용된 데이터 가까이에서 추론이 실행됩니다.
MCP 및 도구 거버넌스: 에이전트 작업 권한 제어
에이전트가 도구를 호출할 수 있는 순간, 그 에이전트는 엔터프라이즈 안에서 행위자가 됩니다. MCP는 이를 매우 쉽게 만들었습니다. 직원이 설치하는 관리되지 않는 모든 MCP 서버는 프로덕션 시스템으로 향하는 새로운 경로가 되며, 그 경로는 런타임에 보유한 액세스로 무엇을 할지 결정하는 것에 의해 운영됩니다. 이 점에서는 섀도우 IT와 같지만, 승인되지 않은 소프트웨어가 프로덕션 데이터베이스를 읽고 엔터프라이즈 SaaS의 레코드를 수정할 수 있다는 점이 다릅니다.
API 게이트웨이는 클라이언트가 엔드포인트를 호출할 권한이 있는지 묻습니다. 도구 게이트웨이는 다른 질문에 답해야 합니다. 이 에이전트가 지금 이 사용자를 대신해 이 도구 호출을 수행할 권한이 있는가? Snowflake의 Natoma 인수 이후, Cortex AI Gateway의 Tools가 이 질문에 답합니다. 현재 프라이빗 프리뷰로 제공되는 이 기능에는 엄선한 100개 이상의 MCP 서버 카탈로그가 포함되어 있으며, 각 서버의 OAuth 인증을 대신 처리해 주고, MCP 서버의 난립을 줄이는 데 도움이 됩니다.
관리자는 특정 도구, 현재 게시된 모든 도구, 또는 현재와 향후 제공될 모든 도구 중 무엇을 활성화할지 선택할 수 있습니다. 활성화되지 않은 도구는 클라이언트에 표시되지 않고 호출될 수도 없습니다. 따라서 거부된 기능은 대개 호출 시점에 실패하는 대신 처음부터 노출되지 않습니다. 도구 호출은 로그로 기록할 수 있어, 하나의 프롬프트에서 시작된 전체 에이전트 시퀀스를 순서 있는 시퀀스로 확인할 수 있습니다. 도구 호출 시에도 모델 추론과 동일한 트레이스 테이블에 스팬이 기록되므로, 하나의 트레이스로 사고 과정과 실행 동작을 모두 추적할 수 있습니다.
이 감사 추적은 이 계층에 특화된 공격을 방어하는 기반입니다. 도구 포이즈닝, 도구 섀도잉, 러그 풀(승인된 서버가 도구 정의를 몰래 악의적인 내용으로 바꾸고 클라이언트가 그 변경 사항을 자동으로 반영하는 상황)은 은 설계상 최종 사용자에게 드러나지 않습니다. 하지만 모든 도구 정의와 호출을 기록하는 시스템에서는 이러한 행위가 보이지 않는 것은 아닙니다.
옵저버빌리티: 에이전트 트레이스를 한 곳에서 확인
조직에 현재 어떤 에이전트가 시스템을 이용하고 있는지 물으면, 대부분은 최신 상태가 아닌 스프레드시트의 에이전트 목록을 확인해 답하는 것이 현실입니다. Snowflake가 실시한 설문조사 결과도 이를 뒷받침합니다. 조사에 참여한 고객 중 약 3분의 1이 에이전트 옵저버빌리티를 확보하기 위해 자체 구축한 내부 대시보드를 사용하고 있었습니다. Cloud Security Alliance의 설문조사에 따르면, 지난 1년 동안 조직의 82%가 보안 또는 IT 부서가 이전에 파악하지 못했던 AI 에이전트나 자율 워크플로우를 하나 이상 발견했습니다. 또한 2026 데이터 유출 비용 보고서에 따르면 섀도우 AI 사용이 많은 조직의 평균 데이터 유출 비용은 539만 달러였으며, 데이터 유출이 발생한 조직의 43%가 섀도우 AI 관련 사고의 영향을 받았습니다.
일반적인 대응 방식은 모든 클라이언트에 계측을 적용하는 것이지만, 존재조차 모르는 대상을 계측할 수 없다는 단순한 이유로 한계에 부딪힙니다. Cortex AI Gateway는 다른 접근 방식을 택해 옵저버빌리티를 서빙 계층 자체에 내재화합니다. 개발자의 노트북에서 로컬로 실행되는 에이전트든 원격 Kubernetes 클러스터에서 실행되는 에이전트든, 게이트웨이를 통과하는 모델 또는 MCP 도구 호출은 Snowflake에 OpenTelemetry 스팬으로 기록됩니다. 따라서 에이전트 코드를 수정하지 않고도 서드 파티 런타임 전반의 실행 과정을 빠짐없이 파악할 수 있습니다.
이러한 스팬은 OpenTelemetry의 생성형 AI 시맨틱 규약에 따라 AGENT_TRACE_TABLE에 저장됩니다. 각 레코드에는 요청된 모델, 입력 및 출력 토큰, 캐시 읽기와 쓰기, 기간, 상태 코드, MCP 서버와 도구, 그리고 호출을 수행한 클라이언트의 버전과 세션까지 포함됩니다. 프롬프트, 응답, 도구 호출의 입력과 출력은 관리자가 페이로드 캡처를 켠 경우에만 캡처되며, 캡처된 텍스트는 조직이 이미 운영 중인 액세스 제어 아래 Snowflake 내부에 보관됩니다. 텔레메트리는 AGENT_TRACE_TABLE와 같은 고객 소유 Event Tables에 직접 저장되므로, Snowflake 보안 경계 안에 엄격하게 유지됩니다.
Cortex AI Gateway는 자체 엔드포인트를 통해 클라이언트 측 OTLP 트레이스도 수신합니다. 서버 측과 고객 측 트레이스를 모두 파악할 수 있어, 에이전틱 옵저버빌리티 리더에게 필요한 수준의 인트로스펙션을 제공합니다.
CoCo를 사용하면 프롬프트 하나만으로 AGENT_TRACE_TABLE의 텔레메트리를 분석할 수 있습니다. 아래 예시는 캐시 적중률 하락을 발견하고 모델 비용을 절감할 기회를 식별하는 방법을 보여줍니다.
보안 및 가드레일: 가장 중요한 접점 보호
에이전틱 AI는 이전과는 다른 새로운 방식으로 공격 표면을 확장했습니다. 이를 가장 분명하게 보여 주는 것은 최근 몇 달간 언론에 보도된 보안 사고들입니다.
이러한 사고에서 얻을 수 있는 결론은 분명합니다. 안전한 AI 스택을 구축하려면 가드레일이 필수입니다. 가드레일은 에이전트 내부가 아니라 에이전트가 반드시 통과해야 하는 경계에 있어야 합니다. 문제를 일으키는 것이 바로 에이전트 자체의 판단이기 때문입니다.
Snowflake Cortex AI Guardrails는 이미 CoCo, Snowflake CoWork, Cortex Agents 전반에서 프롬프트 인젝션과 탈옥 시도에 대한 런타임 보호 기능을 제공합니다. 이 기능은 시스템 명령을 우회하려는 간접 프롬프트 인젝션을 찾기 위해 도구 출력을 스캔하고, 모델 안전 경계를 우회하려는 시도를 탐지하며, 이전에 발견되지 않은 공격 패턴을 실시간으로 식별합니다.
Cortex AI Gateway는 곧 이 보호 인프라를 게이트웨이 트래픽에도 적용할 예정입니다. 이를 통해 Snowflake 자체 AI 접점에 적용되던 보호 기능이 게이트웨이를 경유하는 모든 서드 파티 에이전트와 하네스로 확장되어, 외부에 노출되는 공격 표면을 최소화합니다.
자세한 내용은 Cortex AI Guardrails 설명서를 참조하세요.
비용 거버넌스: AI 지출의 가치 극대화
2026년에는 AI 지출이 예산을 초과하는 경우가 많았지만, 근본적인 문제는 과도한 지출 자체보다 부정확한 예측에 있었습니다. 여기에 토큰 사용량을 생산성의 척도로 삼는 ‘토큰맥싱(tokenmaxxing)’도 더해졌습니다. 일부 기업은 사내 순위표를 공개했다가 결국 중단했습니다. 사용자들이 순위표 상위에 오르기 위해 AI에 과도한 비용을 지출했기 때문입니다. 토큰 사용량이 많다고 해서 일반적으로 ROI까지 높아지는 것은 아니라는 사실이 빠르게 드러났습니다.
Snowflake는 이러한 문제에 대응하기 위해 기존 비용 제어 기능을 Cortex AI Gateway로 확장했습니다.
Budgets는 검증된 비용 거버넌스 제어 기능을 제공하며, 이제 Cortex AI Gateway를 통해 라우팅되는 모든 AI 트래픽에 적용할 수 있습니다. 제어 수준은 결국 관리자가 결정합니다. Budgets는 세분화된 관리를 위해 게이트웨이 수준에서 설정할 수도 있고, 리소스 및 사용자 태그를 통해 필요한 어떤 차원으로든 비용 제어를 세분화할 수도 있습니다. 부서, 역할, 비용 센터, 사용자 ID, 에이전트, 애플리케이션 등 어떤 기준이든 Cortex AI Gateway는 전반에 걸쳐 비용 가시성과 제어를 지원합니다.
사용자별 할당량 설정(Per-user Quotas)을 사용하면 개인별 월간 한도와 선택적 일일 한도를 설정하고, 몇 분 내에 차단을 적용할 수 있습니다.
게이트웨이 트래픽은 모델별로 세분화된 크레딧과 AGENT_TRACE_TABLE에 직접 조인되는 요청 ID와 함께 AI_GATEWAY_USAGE_HISTORY에 기록됩니다. 이를 통해 어떤 에이전트 대화, 워크플로우, 태스크, 모델 요청, 도구 호출이 비용 급증으로 이어졌는지 세밀하게 파악할 수 있습니다. CoCo는 트레이스 데이터를 쉽게 파고들어 AI 비용을 이해하는 데 유용합니다.
AI 비용 거버넌스 자세히 알아보기
Cortex AI Gateway 시작하기
Snowflake는 기업이 AI를 안전하고 경제적으로 활용할 수 있도록 지원하는 데 전념하고 있으며, Cortex AI Gateway는 그 출발점입니다. 직접 경험해 보세요. 클라이언트 하나를 Cortex AI Gateway에 연결해 트레이스를 확인하고, 세분화된 비용 제어를 구현하기 시작하거나, 모델 사용량 추세를 심층 분석해 보세요.
Cortex AI Gateway는 AWS 상용 리전에서 퍼블릭 프리뷰로 제공됩니다.3 기능과 시작 방법에 대해 자세히 알아보려면 Cortex AI Gateway 설명서를 확인하세요.
본 콘텐츠에는 향후 제품 제공에 대한 미래 전망 진술이 포함되어 있으며, 이는 제품 제공에 대한 약속이 아닙니다. 실제 결과 및 제공 내용은 달라질 수 있으며, 알려진 위험과 알려지지 않은 위험 및 불확실성의 영향을 받을 수 있습니다. 보다 자세한 내용은 최신 10-Q를 참조하세요.
1 토큰 효율성 및 ADE-bench 결과는 Snowflake 내부 테스트를 기반으로 하며, 방법론과 조건은 요청 시 제공됩니다. 개별 결과는 워크로드와 구성에 따라 달라질 수 있습니다. https://www.snowflake.com/ko/blog/dynamic-model-routing-open-models-cortex-ai/
2 효율성 점수는 실제 분석 및 데이터 엔지니어링 작업에서 AI 에이전트를 평가하기 위해 dbt가 개발한 프레임워크인 ADE Bench를 활용한 내부 테스트 결과를 기반으로 합니다.
3 Amazon Web Services(AWS) 상용 리전의 계정에서만 사용할 수 있으며, 아시아 태평양(뉴질랜드), 아시아 태평양(말레이시아), 유럽(스페인) 리전은 제외됩니다.