8 oct. 2026/Lecture : 9 minProduit et technologie
Bâtir un stack d’infrastructure IA moderne avec Cortex AI Gateway
Ces dernières années, le stack de l’IA d’entreprise est progressivement devenu un écosystème sophistiqué, mais il s’avère souvent fragmenté et difficile à gérer. Il englobe désormais les bases de données vectorielles, les systèmes de surveillance et le réglage des pipelines. Le tout est relié par un vaste ensemble d’agents de codage, d’agents intégrés et de serveurs Model Context Protocol (MCP) interagissant avec les systèmes d’entreprise, et repose sur un portefeuille de modèles qui ne cesse d’évoluer, parfois en quelques semaines. Les différentes équipes adoptent les composants du stack à des rythmes différents, au risque de créer des lacunes dans la gestion et la gouvernance, susceptibles de compromettre la sécurité.
Dans cet environnement fragmenté, peu d’entreprises disposent de tout le contexte nécessaire pour répondre précisément à des questions pourtant élémentaires sur ces différents composants : Quels modèles appelons-nous ? Qui les appelle ? Quelles actions effectuent-ils et à quel coût ?
Le premier réflexe consiste à imposer des restrictions, mais cette approche n’est pas viable à long terme. Limiter l’accès des collaborateurs à l’IA ne fera que les pousser vers des outils d’IA non autorisés, ce qui accentuera encore les risques.
Cette lacune ne vient pas des outils, mais de l’absence d’une couche essentielle. Le stack d’IA moderne a besoin d’un point de contrôle entre chaque client d’IA et les systèmes d’entreprise auxquels il accède. Cortex AI Gateway (en public preview3) comble cette lacune en faisant office de plan de contrôle centralisé. Il apporte la visibilité unifiée, la gouvernance et la supervision qu’exige cette infrastructure moderne aux multiples facettes. Selon nous, six éléments sont indispensables au stack d’infrastructure de l’IA des entreprises modernes :
Inférence unifiée et gouvernée
Routage dynamique des modèles
Gouvernance de MCP et des outils
Observabilité centralisée
Politiques de sécurité et garde-fous
Gouvernance et contrôle des coûts
Désormais en public preview, Cortex AI Gateway offre aux équipes plateforme un espace unique pour accorder l’accès aux modèles et aux serveurs MCP, attribuer et contrôler les dépenses, et connaître les actions réalisées par l’IA pour le compte de leurs utilisateurs. Les équipes d’application disposent d’un point de terminaison unique sur lequel créer leurs solutions. Voyons comment Cortex AI Gateway répond aux besoins de chaque couche de ce stack.
Cortex AI Gateway est le plan de contrôle centralisé de Snowflake pour l'infrastructure d'IA des entreprises. Il offre un point d'accès unique pour l'inférence encadrée des modèles, le routage dynamique entre modèles, la gouvernance des outils MCP, l'observabilité, les garde-fous de sécurité et la maîtrise des coûts. Les équipes plateforme bénéficient ainsi d'une visibilité unifiée sur l'ensemble des clients et des agents d'IA de l'organisation.
Inférence unifiée et gouvernée : un point de terminaison unique pour vos agents
Dans un stack d’IA en pleine croissance, la multiplication des chemins d’accès aux modèles est le premier point de rupture : un ingénieur configure un agent de codage auprès d’un fournisseur. Une équipe plateforme relie une application à un deuxième fournisseur. Une autre personne crée un script pour un troisième. Chaque chemin a ses propres identifiants, son propre journal et sa propre facture.
Cortex AI Gateway les réunit derrière un point de terminaison unique. Il met en œuvre l’API Chat Completions pour les modèles OpenAI, Grok, GLM, Gemini, Llama, Mistral et DeepSeek, ainsi que l’API Messagespour Claude, les deux protocoles qui se sont imposés pour la mise à disposition des modèles. Le streaming, l’appel d’outils, les sorties structurées, la mise en cache des prompts, les images en entrée et le raisonnement fonctionnent comme dans les environnements natifs. Pour connecter un client existant à Cortex AI Gateway, il suffit donc de modifier l’URL de base et d’utiliser un token. La prise en charge de l’API OpenAI Responses arrivera également très bientôt. L’exemple suivant présente toute la configuration nécessaire pour utiliser OpenCode avec Cortex AI Gateway :
export PAT="<pat>"
export BASE_URL="<base_url>"
export OPENCODE_CONFIG_CONTENT='{
  "$schema": "https://opencode.ai/config.json",
  "model": "snowflake-cortex/openai-gpt-5.4",
  "small_model": "snowflake-cortex/openai-gpt-5.4",
  "provider": {
    "snowflake-cortex": {
      "options": {
        "baseURL": "${BASE_URL}",
        "account": "<ACCOUNT>.snowflakecomputing.com",
        "apiKey": "<PAT>",
        "headers": {
          "snow-agent-name": "opencode"
        }
      }
    }
  }
}'
Le contrôle des accès s’appuie sur l’environnement existant de contrôle d’accès basé sur les rôles (RBAC) de Snowflake. Un administrateur peut définir les modèles disponibles via la passerelle (gateway) afin que seuls ceux approuvés par l’organisation soient accessibles.
Pour simplifier encore l’utilisation des agents de codage avec Cortex AI Gateway, la Snowflake CLI pourra configurer automatiquement l’acheminement de votre trafic via la passerelle. Une seule commande suffit pour lire les identifiants de votre connexion Snowflake active, les injecter dans la configuration de l’agent de codage et lancer celui-ci en acheminant son trafic via Cortex AI Gateway. Par exemple, pour lancer OpenCode avec la Snowflake CLI, il suffit désormais d’exécuter snow ai opencode.
Routage dynamique des modèles dans Cortex AI Gateway : Choisissez le bon modèle pour chaque tâche
La plupart des équipes utilisent un seul modèle de pointe pour tous leurs besoins. C’est une approche raisonnable pour démarrer, mais coûteuse lorsqu’il faut évoluer. Une grande partie des étapes exécutées par les agents concerne la modification de fichiers, le formatage et les recherches, autant de tâches qu’un modèle moins coûteux peut accomplir avec une qualité et une précision équivalentes.
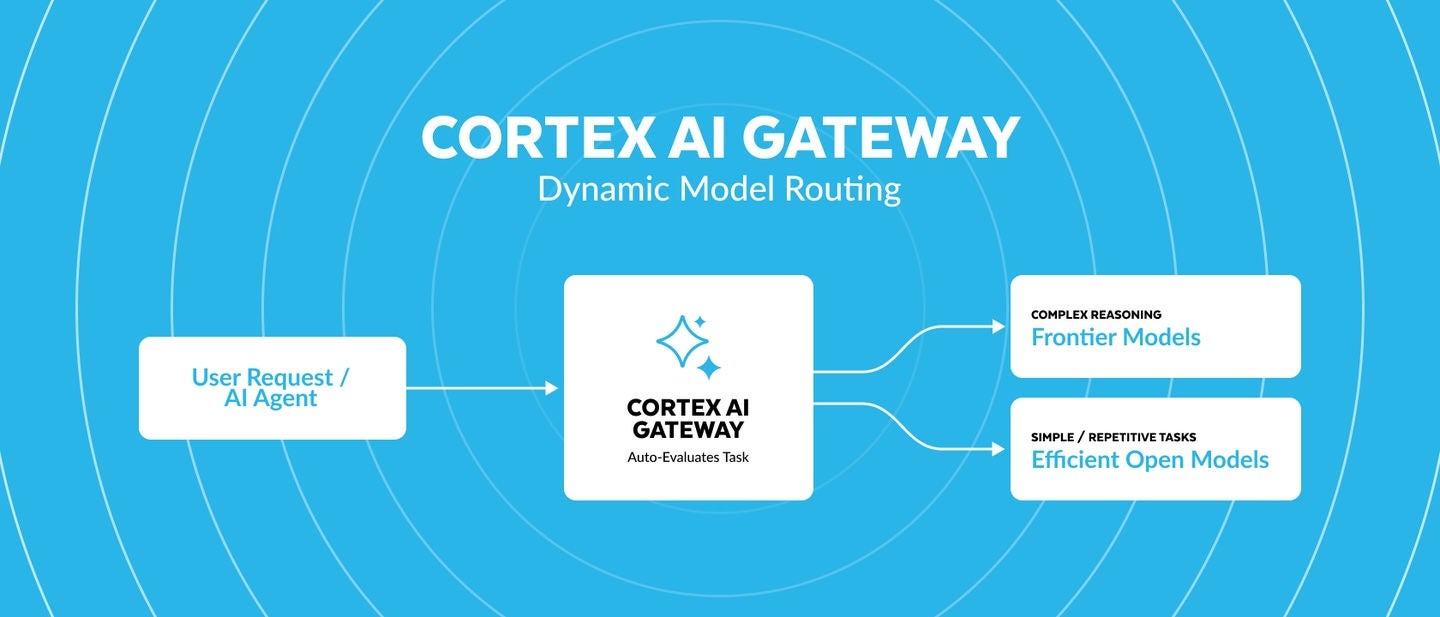
Le routage dynamique des modèles, bientôt disponible en private preview dans Cortex AI Gateway, sélectionne à chaque étape de l’exécution de l’agent le modèle disponible le plus économique capable d’accomplir la tâche de manière fiable. Optimisé par l’équipe de recherche de Snowflake, il confie les tâches répétitives et peu complexes à des modèles efficaces, et celles qui nécessitent un raisonnement approfondi à des modèles de pointe. Lors d’une évaluation interne, il a exécuté une charge de travail de pipeline dbt avec une efficacité en tokens jusqu’à trois fois supérieure à celle d’une approche reposant uniquement sur un modèle de pointe, pour une qualité comparable. Dans un autre test de codage, les équipes d’ingénierie ont maintenu un débit constant de pull requests tout en utilisant environ 25 % de tokens en moins1. Pour les entreprises, ces résultats peuvent se traduire par de réelles économies.
Le routage est soumis à la même gouvernance que la sélection manuelle des modèles. Seuls les modèles approuvés sont utilisés, les paramètres de résidence des données existants sont respectés et chaque décision de routage est journalisée. L’équipe chargée de la conformité peut ainsi savoir quel modèle a traité chaque requête. Comme le routage s’effectue dans Cortex AI Gateway plutôt que dans chaque application, Snowflake peut adapter les décisions à l’évolution des tarifs et des performances des modèles sans jamais modifier la configuration des agents.
Les modèles open source ont également leur importance. Évalué sur ADE-bench avec Snowflake CoCo comme cadre d’exécution de l’agent, DeepSeek-V4-Flash obtient un score de 74,4 %2, devant le meilleur modèle propriétaire que nous avons testé. GLM-5.3 sera bientôt disponible en private preview. Son prédécesseur, GLM-5.2, a obtenu un score de 66 % sur ADE-bench2 avec la plus faible consommation de tokens parmi tous les modèles du benchmark2, exactement le profil recherché pour une charge de travail à volume élevé. Snowflake met ces modèles à disposition dans son périmètre sécurisé. L’inférence s’exécute ainsi au plus près des données gouvernées, avec le même contrôle d’accès basé sur les rôles (RBAC) et la même piste d’audit qui les protègent déjà.
En savoir plus sur le routage dynamique des modèles.
Gouvernance de MCP et des outils : Gardez le contrôle sur les actions de vos agents
Dès qu’un agent peut appeler des outils, il devient un acteur de l’entreprise, et MCP a rendu cela extrêmement simple. Chaque serveur MCP non géré installé par un collaborateur ouvre une nouvelle voie vers les systèmes de production. Il est piloté par un système qui décide, au moment de l’exécution, comment utiliser les accès dont il dispose. C’est de l’informatique fantôme, à ceci près que le logiciel non autorisé peut lire les bases de données de production et modifier les enregistrements des solutions SaaS de l’entreprise.
Une passerelle d’API vérifie si un client est autorisé à appeler un point de terminaison. Une passerelle d’outils doit répondre à une autre question : cet agent est-il autorisé à appeler cet outil pour le compte de cet utilisateur, à cet instant précis ? À la suite de l’acquisition de Natoma par Snowflake, Tools in Cortex AI Gateway apporte la réponse. Désormais disponible en private preview, cette solution propose un catalogue sélectionné de plus de 100 serveurs MCP, avec une gestion intégrée d’OAuth, afin de limiter leur prolifération.
Les administrateurs peuvent activer des outils précis, tous les outils actuellement publiés ou l’ensemble des outils actuels et futurs. Les outils qui ne sont pas activés restent invisibles pour le client et ne peuvent pas être invoqués. Ainsi, une fonctionnalité refusée n’est généralement même pas annoncée, plutôt que de provoquer un échec au moment de l’appel. Les appels d’outils peuvent être journalisés afin de restituer dans l’ordre toute la séquence exécutée par un agent à partir d’un prompt. Les appels d’outils génèrent également des spans dans la même table de traces que l’inférence. Une seule trace couvre ainsi le raisonnement et les actions.
Cette piste d’audit protège contre les attaques propres à cette couche. L’empoisonnement et le masquage d’outils, ainsi que les substitutions malveillantes, où un serveur approuvé modifie discrètement la définition d’un outil à des fins malveillantes et où les clients appliquent automatiquement ce changement, sont par nature invisibles pour les utilisateurs finaux. En revanche, un système qui enregistre chaque définition d’outil et chaque appel peut les détecter.
Observabilité : centralisez les traces de vos agents
Demandez aux organisations quels agents accèdent à leurs systèmes : la plupart du temps, la réponse se trouve dans une feuille de calcul obsolète. Les résultats d’une enquête que nous avons menée corroborent ce constat : environ un client interrogé sur trois utilisait des tableaux de bord internes sur mesure pour observer ses agents. Une enquête de la Cloud Security Alliance révèle qu’au cours de l’année écoulée, 82 % des organisations ont découvert au moins un agent d’IA ou un workflow autonome dont leurs équipes de sécurité ou IT ignoraient jusque-là l’existence. Par ailleurs, selon le Rapport 2026 sur le coût d’une violation de données, les organisations qui recourent largement à l’IA fantôme ont enregistré un coût moyen de 5,39 millions USD par violation, et les incidents liés à l’IA fantôme ont concerné 43 % des organisations victimes d’une violation.
La réponse habituelle consiste à instrumenter chaque client. Cette approche échoue pour une raison simple : impossible d’instrumenter ce dont vous ignorez l’existence. Cortex AI Gateway adopte une autre approche et intègre l’observabilité directement à la couche de mise à disposition des modèles. Chaque appel de modèle ou d’outil MCP qui transite par la passerelle est enregistré dans Snowflake sous forme de span OpenTelemetry, qu’il provienne d’un agent exécuté localement sur l’ordinateur portable d’un développeur ou dans un cluster Kubernetes distant. Vous bénéficiez ainsi d’une visibilité complète sur l’exécution dans les environnements tiers, sans modifier le code des agents.
Ces spans sont enregistrés dans la table AGENT_TRACE_TABLE selon les conventions sémantiques OpenTelemetry pour l’IA générative. Chaque enregistrement contient le modèle demandé, les tokens d’entrée et de sortie, les lectures et écritures dans le cache, la durée, le code d’état, les serveurs et outils MCP, ainsi que le client à l’origine de l’appel, jusqu’à sa version et sa session. Les prompts, les réponses ainsi que les entrées et sorties des appels d’outils ne sont enregistrés que lorsqu’un administrateur active la capture des données utiles. Le texte reste alors dans Snowflake, protégé par les contrôles d’accès déjà appliqués par l’organisation. Comme les données de télémétrie sont directement enregistrées dans les Event Tables appartenant au client, telles que la table AGENT_TRACE_TABLE, elles restent strictement confinées à votre périmètre de sécurité Snowflake.
Cortex AI Gateway accepte également les traces OTLP côté client via son propre point de terminaison. La visibilité sur les traces côté serveur et côté client offre le niveau d’introspection indispensable à tout acteur de référence de l’observabilité agentique.
Avec CoCo, un seul prompt suffit pour analyser les données de télémétrie de la table AGENT_TRACE_TABLE. L’exemple ci-dessous montre comment détecter les baisses du taux de succès du cache et identifier les possibilités de réduction des coûts liés aux modèles.
Sécurité et garde-fous : protégez vos surfaces stratégiques
L’IA agentique a étendu la surface d’attaque d’une manière réellement inédite. Les incidents qui ont fait la une ces derniers mois en sont la preuve la plus évidente.
La conclusion à tirer de ces incidents est simple : les garde-fous sont indispensables à un stack d’IA sécurisé. Ils doivent se situer à la frontière que l’agent doit franchir, et non dans l’agent lui-même, car c’est précisément son propre jugement qui peut être pris en défaut.
Les Snowflake Cortex AI Guardrails offrent déjà une protection à l’exécution contre les injections de prompts et les tentatives de jailbreak dans CoCo, Snowflake CoWork et Cortex Agents. Ils analysent les sorties des outils pour repérer les injections indirectes de prompts visant à contourner les instructions système, détectent les tentatives de franchissement des limites de sécurité des modèles et identifient en temps réel des schémas d’attaque inédits.
Cortex AI Gateway étendra très bientôt cette infrastructure au trafic transitant par la passerelle. Elle étend la protection des environnements d’IA de Snowflake à tout agent ou environnement d’exécution tiers passant par la passerelle, ce qui réduit la surface d’attaque exposée.
Consultez la documentation de Cortex AI Guardrails pour en savoir plus.
Gouvernance des coûts : Tirez le maximum de chaque investissement dans l’IA
Les dépenses d’IA ont mis à mal de nombreux budgets en 2026. Mais le véritable problème tient à un Forecasting insuffisant, pas à des dépenses extravagantes. Dans le même temps est apparu le « tokenmaxxing », qui consiste à considérer le volume de tokens comme un indicateur de productivité. Certaines entreprises ont publié des classements internes, qu’elles ont fini par supprimer, car les utilisateurs cherchaient à prendre la tête en dépensant excessivement dans l’IA. Il est rapidement apparu qu’une utilisation accrue des tokens ne se traduit généralement pas par un meilleur ROI.
Pour contrer cette tendance, Snowflake étend désormais ses contrôles de coûts existants à Cortex AI Gateway.
Les Budgets offrent des mécanismes éprouvés de gouvernance des coûts, désormais disponibles pour tout trafic d’IA passant par Cortex AI Gateway. C’est l’administrateur qui détermine le niveau de contrôle. Les budgets peuvent être définis au niveau de la passerelle pour assurer un contrôle granulaire, ou s’appuyer sur des tags de ressource et d’utilisateur afin de décliner les contrôles de coûts selon l’axe souhaité. Qu’il s’agisse du département, du rôle, du centre de coûts, de l’ID utilisateur, de l’agent ou de l’application, Cortex AI Gateway offrira une visibilité et des contrôles sur les coûts pour chacun de ces axes.
Les quotas par utilisateur permettent de définir des limites mensuelles et, si nécessaire, quotidiennes pour chaque personne, puis d’appliquer les blocages en quelques minutes.
Le trafic de la passerelle est consigné dans AI_GATEWAY_USAGE_HISTORY, avec une ventilation des crédits par modèle et un ID de requête permettant une jointure directe avec la table AGENT_TRACE_TABLE. Vous bénéficiez ainsi d’une visibilité très fine sur les conversations des agents, les workflows, les tâches, les requêtes de modèles et les appels d’outils à l’origine de dépenses incontrôlées. CoCo vous permet d’explorer facilement vos données de trace et de mieux comprendre vos coûts d’IA.
En savoir plus sur la gouvernance des coûts de l’IA.
Bien démarrer avec Cortex AI Gateway
Snowflake s’engage à rendre l’IA sûre et économique pour les entreprises, et Cortex AI Gateway constitue le point de départ de cette démarche. Faites-en vous-même l’expérience : connectez un client à Cortex AI Gateway pour examiner les traces, commencez à mettre en place un contrôle granulaire des coûts ou analysez les tendances d’utilisation des modèles.
Cortex AI Gateway est disponible en public preview dans les régions commerciales AWS.3 Consultez notre documentation Cortex AI Gateway pour en savoir plus sur ses fonctionnalités et sa prise en main.
Ce contenu contient des déclarations prospectives, notamment concernant nos futures offres de produits, et ne constitue pas un engagement à fournir une quelconque offre de produits. Les offres et résultats réels peuvent varier et faire l’objet de risques connus et inconnus, ainsi que d’incertitudes. Découvrez notre dernier 10‑Q pour en savoir plus.
1 Les résultats d’efficacité des tokens et d’ADE-bench reposent sur des tests internes de Snowflake ; la méthodologie et les conditions sont disponibles sur demande, et les résultats spécifiques peuvent varier selon le workload et la configuration. https://www.snowflake.com/fr/blog/dynamic-model-routing-open-models-cortex-ai/
2 Score d’efficacité basé sur des tests internes utilisant ADE-bench, un environnement créé par dbt pour évaluer les agents d’IA sur des tâches concrètes d’analytique et de data engineering.
3 Disponible uniquement pour les comptes hébergés dans les régions commerciales Amazon Web Services (AWS), à l’exception des régions Asie-Pacifique (Nouvelle-Zélande), Asie-Pacifique (Malaisie) et Europe (Espagne).