8. Okt. 2026/Lesezeit: 9 MinutenProdukt & Technologie
Aufbau des modernen KI-Infrastruktur-Stacks mit Cortex AI Gateway
In den letzten Jahren hat sich der KI-Stack für Unternehmen zu einem hochentwickelten, aber fragmentierten und unhandlichen Ökosystem entwickelt. Er umfasst nun alles, einschließlich Vektordatenbanken, Überwachungssystemen und Pipeline-Anpassung, verbunden durch eine ausufernde Mischung aus Coding-Agenten, eingebetteten Agenten und Model Context Protocol (MCP)-Servern, die mit Unternehmenssystemen interagieren – alles unterstützt durch ein Modellportfolio, das sich alle paar Wochen ändert. Verschiedene Teams übernehmen Teile des Stacks zu unterschiedlichen Zeitpunkten, was potenziell eine Management- und Governance-Lücke schafft, die sich auf die Sicherheit auswirken kann.
In dieser fragmentierten Umgebung haben nur wenige Unternehmen den vollständigen Kontext, den sie benötigen, um grundlegende Fragen über diese Oberflächen hinweg genau zu beantworten: Welche Modelle rufen wir auf, wer ruft sie auf, welche Aktionen führen sie aus und wie hoch sind die damit verbundenen Kosten?
Der erste Instinkt als Reaktion darauf ist eine Einschränkung, aber das ist keine praktikable langfristige Lösung. Die Fähigkeit der Mitarbeitenden, KI zu nutzen, einzuschränken, führt nur dazu, dass sie auf nicht genehmigte KI-Tools zurückgreifen, was das Risiko noch weiter erhöht.
Diese Lücke ist kein Tooling-Problem; es ist eine fehlende Schicht. Der moderne KI-Stack benötigt einen Kontrollpunkt, der zwischen jedem KI-Client und den von ihm erreichten Unternehmenssystemen sitzt. Cortex AI Gateway (Public Preview3) löst dieses Problem, indem es als diese zentralisierte Steuerungsebene fungiert und die einheitliche Transparenz, Governance und Aufsicht bietet, die diese moderne, facettenreiche Infrastruktur erfordert. Aus unserer Sicht sind sechs Elemente im KI-Infrastruktur-Stack des modernen Unternehmens nicht verhandelbar:
Einheitliche, kontrollierte Inferenz
Dynamisches Modell-Routing
MCP- und Tool-Governance
Zentrale Observability
Sicherheitsrichtlinien und Guardrails
Kosten-Governance und -Kontrolle
Jetzt in Public Preview, bietet Cortex AI Gateway Plattformteams einen zentralen Ort, um Zugriff auf Modelle und MCP-Server zu gewähren, Ausgaben zuzuordnen und zu kontrollieren und zu sehen, was die KI im Namen ihrer Nutzer:innen getan hat. Anwendungsteams erhalten einen einzigen Endpunkt, für den sie entwickeln können. Lassen Sie uns einen Blick darauf werfen, wie es sich auf jede Schicht des Stacks abbildet.
Cortex AI Gateway ist die zentrale Steuerungsebene von Snowflake für die Enterprise-KI-Infrastruktur. Es bietet einen zentralen Endpunkt für kontrollierte Modell-Inferenz, dynamisches Model-Routing, MCP-Tool-Governance, Observability, Security Guardrails und Kostenkontrolle – und gibt Plattform-Teams so einen einheitlichen Überblick über jeden KI-Client und Agenten im gesamten Unternehmen.
Einheitliche, kontrollierte Inferenz: Nutzen Sie einen Endpunkt für Ihre Agenten
Das Erste, was in einem wachsenden KI-Stack zusammenbricht, ist die Anzahl der Pfade zu einem Modell: Ein Engineer konfiguriert einen Coding-Agenten für einen Anbieter. Ein Plattformteam verbindet eine Anwendung mit einem zweiten. Jemand anderes schreibt Skripte für einen dritten. Jeder Pfad hat seine eigenen Anmeldeinformationen, sein eigenes Protokoll und seine eigene Rechnung.
Cortex AI Gateway fasst diese in einem Endpunkt zusammen. Es implementiert die Chat Completions API für OpenAI-, Grok-, GLM-, Gemini-, Llama-, Mistral- und DeepSeek-Modelle sowie die Messages API für Claude, die beiden Protokolle, auf die sich das Model Serving geeinigt hat. Streaming, Tool Calling, strukturierte Ausgabe, Prompt Caching, Bildeingabe und Reasoning funktionieren alle genauso wie nativ, sodass das Verweisen eines bestehenden Clients auf Cortex AI Gateway nur eine weitere Basis-URL und ein Token erfordert. Die Unterstützung für die OpenAI Responses API folgt ebenfalls in Kürze. Das folgende Beispiel zeigt die gesamte Einrichtung, die Sie benötigen, um OpenCode mit Cortex AI Gateway zu konfigurieren:
export PAT="<pat>"
export BASE_URL="<base_url>"
export OPENCODE_CONFIG_CONTENT='{
  "$schema": "https://opencode.ai/config.json",
  "model": "snowflake-cortex/openai-gpt-5.4",
  "small_model": "snowflake-cortex/openai-gpt-5.4",
  "provider": {
    "snowflake-cortex": {
      "options": {
        "baseURL": "${BASE_URL}",
        "account": "<ACCOUNT>.snowflakecomputing.com",
        "apiKey": "<PAT>",
        "headers": {
          "snow-agent-name": "opencode"
        }
      }
    }
  }
}'
Die Zugriffskontrolle nutzt Snowflakes bestehendes Role-Based-Access-Control-(RBAC)-Framework. Ein Admin kann konfigurieren, welche Modelle über das Gateway verfügbar sind, und so sicherstellen, dass nur die von einem Unternehmen genehmigten Modelle zugänglich sind.
Um die Nutzung von Coding-Agenten mit Cortex AI Gateway noch einfacher zu machen, wird die Snowflake CLI in der Lage sein, die Einrichtung Ihres Traffics über das Gateway zu übernehmen. Ein einziger Befehl reicht aus, um Anmeldeinformationen aus Ihrer aktiven Snowflake-Verbindung zu lesen, sie in die Konfiguration des Coding-Agenten einzufügen und den Agenten zu starten, wobei sein Traffic über Cortex AI Gateway geleitet wird. Zum Beispiel ist das Starten von OpenCode über die Snowflake CLI jetzt so einfach wie das Ausführen von snow ai opencode.
Dynamisches Modell-Routing in Cortex AI Gateway: Wählen Sie das richtige Modell für jede Aufgabe
Die meisten Teams haben sich auf ein einziges Frontier-Modell für alles festgelegt, was ein vernünftiger Anfang und ein teurer Weg zur Skalierung ist. Ein großer Teil der Agentenschritte sind Dateibearbeitungen, Formatierungen und Suchvorgänge, die ein günstigeres Modell mit der gleichen Qualität und Genauigkeit bewältigt.
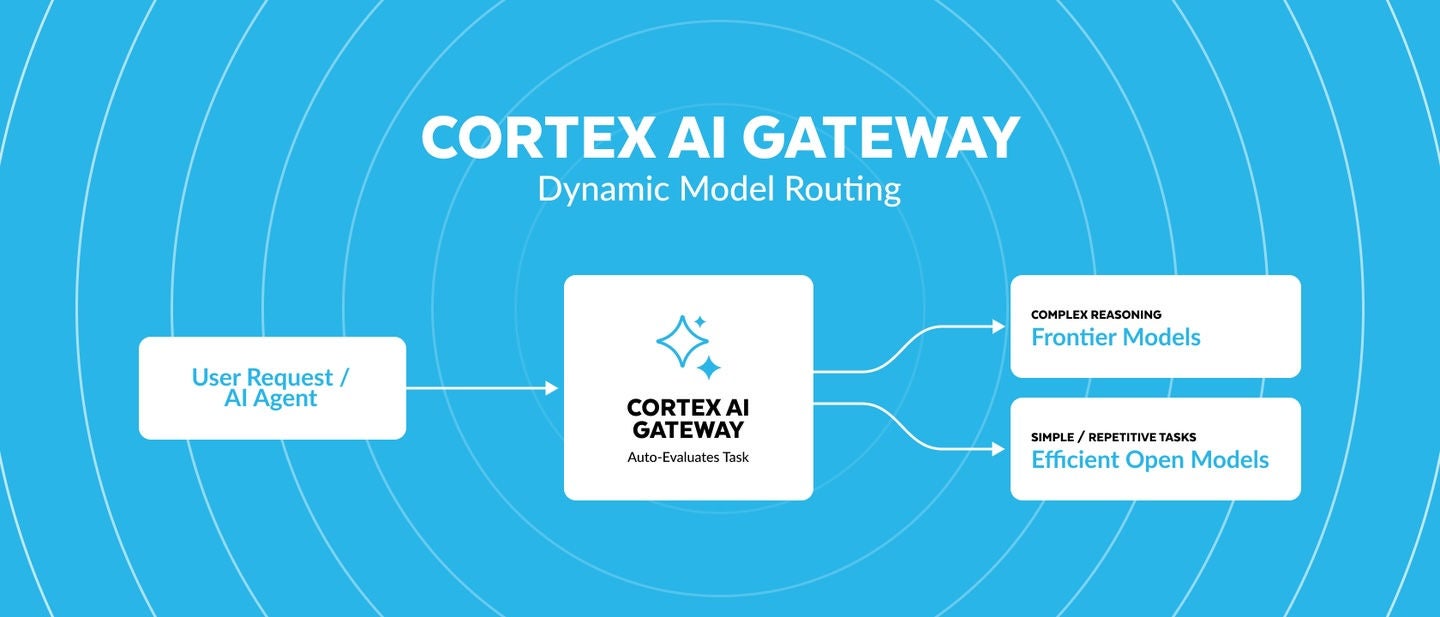
Dynamisches Modell-Routing, das bald in Private Preview über Cortex AI Gateway verfügbar sein wird, wählt das kostengünstigste Modell (aus den verfügbaren Optionen) aus, das die Aufgabe bei jedem Schritt der Agentenausführung zuverlässig erledigen kann. Es wurde vom Snowflake-Forschungsteam feinabgestimmt, sodass weniger komplexe und sich wiederholende Arbeiten an effiziente Modelle gehen und Arbeiten, die tieferes Reasoning erfordern, an Frontier-Modelle. In einer internen Evaluierung schloss es einen dbt-Pipeline-Workload mit bis zu dreimal höherer Token-Effizienz als ein reiner Frontier-Modell-Ansatz bei vergleichbarer Qualität ab, und in einem separaten Coding-Test hielten Engineering-Teams den Pull-Request-Durchsatz konstant, während sie etwa 25 % weniger Token verwendeten.1 Diese Ergebnisse können sich in realen Kosteneinsparungen für Unternehmen niederschlagen.
Das Routing wird genauso kontrolliert wie die manuelle Modellauswahl. Es werden nur genehmigte Modelle verwendet, bestehende Data-Residency-Einstellungen werden respektiert und jede Routing-Entscheidung wird protokolliert, sodass ein Compliance-Team sehen kann, welches Modell welche Anfrage bearbeitet hat. Da das Routing in Cortex AI Gateway und nicht in jeder Anwendung stattfindet, kann Snowflake Entscheidungen aktualisieren, wenn sich Modellpreise und Performance ändern, ohne dass Agentenkonfigurationen jemals geändert werden müssen.
Die Open-Source-Modellseite spielt hier ebenfalls eine Rolle. Evaluiert auf ADE-bench mit Snowflake CoCo als Agenten-Harness, erreicht DeepSeek-V4-Flash 74,4 %,2 und liegt damit vor dem führenden proprietären Modell, das wir getestet haben. GLM-5.3 kommt bald in Private Preview, aber sein Vorgänger GLM-5.2 erreichte 66 % auf ADE-bench2 mit dem geringsten Token-Fußabdruck aller Modelle im Benchmark,2 was genau das Profil ist, das ein hochvolumiger Workload benötigt. Snowflake stellt diese Modelle innerhalb des sicheren Snowflake-Perimeters bereit, sodass die Inferenz neben kontrollierten Daten stattfindet, innerhalb desselben RBAC und Audit-Trails, der sie bereits abdeckt.
Erfahren Sie mehr über dynamisches Modell-Routing.
MCP- und Tool-Governance: Kontrollieren Sie, was Ihre Agenten tun können
In dem Moment, in dem ein Agent Tools aufrufen kann, wird er zu einem Akteur im Unternehmen – und MCP hat dies trivial einfach gemacht. Jeder nicht verwaltete MCP-Server, den ein:e Mitarbeiter:in installiert, ist ein neuer Weg in Produktionssysteme, betrieben von etwas, das zur Laufzeit entscheidet, was es mit dem Zugriff tun soll, den es hat. Das ist Schatten-IT, nur dass die nicht autorisierte Software Produktionsdatenbanken lesen und Datensätze in Unternehmens-SaaS ändern kann.
Ein API-Gateway fragt, ob ein Client autorisiert ist, einen Endpunkt aufzurufen. Ein Tool-Gateway muss eine andere Frage beantworten: Ist dieser Agent autorisiert, diesen Tool-Aufruf im Namen dieses Nutzers genau jetzt durchzuführen? Nach Snowflakes Übernahme von Natoma beantwortet Tools in Cortex AI Gateway diese Frage. Jetzt in Private Preview, wird es mit einem kuratierten Katalog von mehr als 100 MCP-Servern geliefert, bei denen OAuth jeweils für Sie abgewickelt wird, was dazu beiträgt, die Ausbreitung von MCP-Servern zu beseitigen.
Administratoren wählen zwischen der Aktivierung bestimmter Tools, aller derzeit veröffentlichten Tools oder aller aktuellen und zukünftigen Tools. Tools, die nicht aktiviert sind, sind für den Client nicht sichtbar und können nicht aufgerufen werden, sodass eine verweigerte Funktion in der Regel nie beworben wird, anstatt beim Aufruf fehlzuschlagen. Tool-Aufrufe können protokolliert werden, sodass sich eine vollständige Agentensequenz aus einem Prompt wie eine Sequenz liest. Tool-Aufrufe geben auch Spans in dieselbe Trace-Tabelle wie die Inferenz aus, sodass ein einziger Trace das Reasoning und die Aktionen abdeckt.
Dieser Audit-Trail ist die Verteidigung gegen Angriffe, die spezifisch für diese Schicht sind. Tool Poisoning, Tool Shadowing und Rug Pulls, bei denen ein genehmigter Server die Definition eines Tools stillschweigend auf etwas Bösartiges aktualisiert und Clients die Änderung automatisch übernehmen, sind für Endnutzer:innen absichtlich unsichtbar. Sie sind jedoch nicht unsichtbar für ein System, das jede Tool-Definition und jeden Aufruf aufzeichnet.
Observability: Sehen Sie die Traces Ihrer Agenten an einem Ort
Fragen Sie Unternehmen, welche Agenten mit ihren Systemen interagieren, und die ehrliche Antwort kommt meistens aus einer veralteten Tabelle von Agenten. Dies wird durch die Ergebnisse einer von uns durchgeführten Umfrage untermauert, bei der etwa ein Drittel der befragten Kund:innen maßgeschneiderte interne Dashboards für die Agenten-Observability nutzte. Eine Umfrage der Cloud Security Alliance ergab, dass im vergangenen Jahr 82 % der Unternehmen mindestens einen KI-Agenten oder autonomen Workflow entdeckt haben, von dem die Sicherheit oder IT zuvor nichts wusste. Darüber hinaus verzeichneten Unternehmen mit hoher Schatten-KI-Nutzung laut dem Cost of a Data Breach Report 2026 durchschnittliche Kosten für Datenschutzverletzungen in Höhe von 5,39 Millionen US-Dollar, wobei Schatten-KI-Vorfälle 43 % der betroffenen Unternehmen betrafen.
Die übliche Reaktion besteht darin, jeden Client zu instrumentieren, was aus dem einfachen Grund fehlschlägt, dass man nicht instrumentieren kann, was man nicht kennt. Cortex AI Gateway geht den anderen Weg und macht Observability zu einer Eigenschaft der Serving-Schicht. Ein Modell- oder MCP-Tool-Aufruf, der das Gateway durchläuft, unabhängig davon, ob er von einem Agenten stammt, der lokal auf dem Laptop eines Entwicklers oder in einem Remote-Kubernetes-Cluster ausgeführt wird, wird als OpenTelemetry-Span in Snowflake aufgezeichnet. Dies gibt Ihnen volle Ausführungstransparenz über Laufzeiten von Drittanbietern hinweg, ohne den Agentencode zu ändern.
Diese Spans landen in der AGENT_TRACE_TABLE unter Verwendung der semantischen Konventionen für generative KI von OpenTelemetry. Jeder Datensatz enthält das angeforderte Modell, Eingabe- und Ausgabe-Token, Cache-Lese- und -Schreibvorgänge, Dauer, Statuscode, MCP-Server und -Tools sowie den Client, der den Aufruf getätigt hat, bis hin zu seiner Version und Sitzung. Prompts, Antworten sowie Ein- und Ausgaben von Tool-Aufrufen werden nur erfasst, wenn ein Admin die Payload-Erfassung aktiviert, und wenn dies der Fall ist, befindet sich dieser Text in Snowflake unter der Zugriffskontrolle, die das Unternehmen bereits ausführt. Da die Telemetrie direkt in kundeneigenen Ereignistabellen wie AGENT_TRACE_TABLE landet, bleibt sie strikt innerhalb Ihrer Snowflake-Sicherheitsgrenze.
Cortex AI Gateway akzeptiert auch clientseitige OTLP-Traces an seinem eigenen Endpunkt. Die Transparenz sowohl bei serverseitigen als auch bei clientseitigen Traces bietet das Maß an Introspektion, das jede Führungskraft im Bereich der Agentic Observability benötigt.
Die Verwendung von CoCo macht die Untersuchung der Telemetrie in AGENT_TRACE_TABLE zu einem Ein-Prompt-Schritt. Das folgende Beispiel zeigt, wie Sie Rückgänge bei der Cache-Trefferrate finden und Möglichkeiten zur Senkung Ihrer Modellkosten identifizieren können.
Sicherheit und Guardrails: Schützen Sie Ihre wichtigsten Oberflächen
Agentic AI hat die Angriffsfläche auf eine Weise erweitert, die wirklich neu ist, und der deutlichste Beweis dafür sind die Vorfälle, die in den letzten Monaten Schlagzeilen gemacht haben.
Die Schlussfolgerung, die sich aus diesen Vorfällen leicht ziehen lässt: Guardrails sind für einen sicheren KI-Stack unerlässlich. Sie gehören an die Grenze, die der Agent überschreiten muss, nicht in den Agenten, denn das eigene Urteilsvermögen des Agenten ist genau das, was versagt.
Snowflake Cortex AI Guardrails bieten bereits Laufzeitschutz vor Prompt-Injection- und Jailbreak-Versuchen über CoCo, Snowflake CoWork und Cortex Agents hinweg. Sie scannen Tool-Ausgaben auf indirekte Prompt-Injections, die versuchen, Systemanweisungen außer Kraft zu setzen, erkennen Versuche, Modellsicherheitsgrenzen zu umgehen, und identifizieren bisher ungesehene Angriffsmuster in Echtzeit.
Cortex AI Gateway wird diese Infrastruktur in Kürze für den Gateway-Traffic bereitstellen. Es weitet den Schutz von Snowflakes eigenen KI-Oberflächen auf jeden Drittanbieter-Agenten und jedes Harness aus, das durch das Gateway geleitet wird, und minimiert so die exponierte Angriffsfläche.
Weitere Details finden Sie in der Cortex AI Guardrails-Dokumentation.
Kosten-Governance: Sorgen Sie dafür, dass sich jeder KI-Dollar auszahlt
KI-Ausgaben haben 2026 viele Budgets gesprengt, aber das eigentliche Problem sind schlechte Prognosen, nicht Verschwendung. Damit einher ging Tokenmaxxing, die Praxis, das Token-Volumen als Indikator für Produktivität zu betrachten. Einige Unternehmen veröffentlichten interne Bestenlisten, die sie schließlich wieder einstellten, weil Nutzer:innen versuchten, durch übermäßige KI-Ausgaben an die Spitze dieser Listen zu gelangen. Es wurde ziemlich schnell klar, dass eine höhere Token-Nutzung nicht generell mit einem höheren ROI gleichzusetzen ist.
Die bestehenden Kostenkontrollen von Snowflake werden nun auf das Cortex AI Gateway ausgeweitet, um dem entgegenzuwirken.
Budgets bieten etablierte Kosten-Governance-Kontrollen und stehen nun für den gesamten KI-Traffic zur Verfügung, der über das Cortex AI Gateway geleitet wird. Der Grad der Kontrolle liegt ganz bei den Administrator:innen. Budgets können auf Gateway-Ebene festgelegt werden, um die Dinge detailliert zu halten, oder durch Ressourcen- und Benutzer-Tags, um Kostenkontrollen in jeder gewünschten Dimension aufzuschlüsseln. Ob nach Abteilung, Rolle, Kostenstelle, Benutzer-ID, Agent oder Anwendung – das Cortex AI Gateway unterstützt Kostentransparenz und -kontrollen für all diese Bereiche.
Kontingente pro Nutzer:in ermöglichen die Festlegung monatlicher und optionaler täglicher Limits pro Person und setzen Sperren innerhalb von Minuten durch.
Der Gateway-Traffic wird in AI_GATEWAY_USAGE_HISTORY gemeldet, wobei die Credits pro Modell aufgeschlüsselt sind und eine Request-ID direkt mit der AGENT_TRACE_TABLE verknüpft ist. Dies eröffnet eine detaillierte Transparenz darüber, welche Agenten-Konversationen, Workflows, Aufgaben, Modellanfragen und Tool-Aufrufe zu ausufernden Ausgaben geführt haben. CoCo ist eine großartige Möglichkeit für Sie, einfach in Ihre Trace-Daten einzutauchen und Ihre KI-Kosten zu verstehen.
Erfahren Sie mehr über KI-Kosten-Governance.
So gelingt der Einstieg in das Cortex AI Gateway
Snowflake hat es sich zur Aufgabe gemacht, KI für Unternehmen sicher und wirtschaftlich zu machen, und das Cortex AI Gateway ist der Ausgangspunkt. Überzeugen Sie sich selbst: Richten Sie einen Client auf das Cortex AI Gateway und sehen Sie sich die Traces an, beginnen Sie mit der Implementierung detaillierter Kostenkontrollen oder analysieren Sie Trends bei der Modellnutzung.
Das Cortex AI Gateway ist in kommerziellen AWS-Regionen in Public Preview verfügbar.3 Lesen Sie unsere Cortex AI Gateway-Dokumentation, um mehr über die Features und Funktionen sowie den Einstieg zu erfahren.
Dieser Inhalt enthält zukunftsgerichtete Aussagen, unter anderem über unsere künftigen Produktangebote, und stellt keine Verpflichtung dar, irgendwelche Produktangebote bereitzustellen. Die tatsächlichen Ergebnisse und Angebote können abweichen und unterliegen bekannten und unbekannten Risiken und Unsicherheiten. Weitere Informationen finden Sie in unserem jüngsten 10-Q-Formular.
1 Die Ergebnisse zu Token-Effizienz und ADE-bench basieren auf internen Tests von Snowflake; Methodik und Bedingungen sind auf Anfrage erhältlich, und individuelle Ergebnisse können je nach Workload und Konfiguration variieren. https://www.snowflake.com/en/blog/dynamic-model-routing-open-models-cortex-ai/
2 Effizienz-Score basierend auf internen Tests mit ADE-bench, einem von dbt erstellten Framework zur Bewertung von KI-Agenten bei realen Analytics- und Data Engineering-Aufgaben.
3 Nur für Konten in kommerziellen Regionen von Amazon Web Services (AWS) verfügbar, ausgenommen Asien-Pazifik (Neuseeland), Asien-Pazifik (Malaysia) und Europa (Spanien).