8 ottobre 2026/Lettura: 9 minProdotto e tecnologia
Creare lo stack moderno di infrastruttura AI con Cortex AI Gateway
Negli ultimi anni, lo stack enterprise AI si è evoluto in un ecosistema sofisticato ma frammentato e difficile da gestire. Ora comprende tutto, dai database vettoriali ai sistemi di monitoraggio e al tuning delle pipeline, collegati tramite un insieme eterogeneo di coding agent, agenti integrati e server Model Context Protocol (MCP) che interagiscono con i sistemi enterprise, tutto supportato da un portfolio di modelli che cambia ogni poche settimane. Team diversi adottano componenti dello stack secondo tempistiche diverse, creando potenzialmente un vuoto di gestione e governance che può incidere sulla sicurezza.
In questo contesto frammentato, poche aziende dispongono del contesto completo necessario per rispondere con precisione a domande di base su queste superfici: Quali modelli stiamo chiamando, chi li chiama, quali azioni stanno eseguendo e qual è il costo associato?
L’istinto naturale è limitare l’accesso, ma non è una soluzione valida nel lungo termine. Ostacolare la capacità dei dipendenti di utilizzare l’AI li spingerà solo a ricorrere a strumenti AI non autorizzati, amplificando ulteriormente il rischio.
Quel vuoto non è un problema di strumenti, è un livello mancante. Lo stack AI moderno ha bisogno di un punto di controllo posizionato tra ogni client AI e i sistemi aziendali a cui accede. Cortex AI Gateway (public preview3) risolve questo problema agendo come piano di controllo centralizzato, fornendo la visibilità unificata, la governance e la supervisione richieste da questa infrastruttura moderna e multiforme. A nostro avviso, sei elementi sono irrinunciabili nello stack di infrastruttura AI dell’enterprise moderna:
Inferenza unificata e governata
Routing dinamico tra modelli
Governance di MCP e strumenti
Osservabilità centrale
Policy di sicurezza e guardrail
Governance e controllo dei costi
Ora in public preview, Cortex AI Gateway offre ai team della piattaforma un unico posto per concedere l’accesso a modelli e server MCP, attribuire e controllare la spesa, e vedere cosa ha fatto l’AI per conto dei propri utenti. I team applicativi ottengono un singolo endpoint su cui sviluppare. Vediamo come si posiziona rispetto a ogni livello dello stack.
Cortex AI Gateway è il control plane centralizzato di Snowflake per l'infrastruttura AI aziendale. Fornisce un singolo endpoint per l'inferenza dei modelli governata, il routing dinamico dei modelli, la governance degli strumenti MCP, l'osservabilità, le barriere di sicurezza e il controllo dei costi offrendo ai team di piattaforma una visibilità unificata su ogni client e agente AI nell'organizzazione.
Inferenza unificata e governata: usa un unico endpoint per i tuoi agenti AI
La prima cosa che si rompe in uno stack AI in crescita è il numero di percorsi verso un modello: Un ingegnere configura un coding agent su un provider. Un team della piattaforma collega un’applicazione a un secondo. Qualcun altro scrive script su un terzo. Ogni percorso ha le proprie credenziali, il proprio log e la propria fattura.
Cortex AI Gateway unifica tutto questo in un unico endpoint. Implementa la Chat Completions API per i modelli OpenAI, Grok, GLM, Gemini, Llama, Mistral e DeepSeek e la Messages API per Claude, i due protocolli verso cui il model serving è convergente. Streaming, tool calling, structured output, prompt caching, input di immagini e reasoning funzionano tutti esattamente come in modalità nativa, quindi puntare un client esistente verso Cortex AI Gateway richiede solo un altro base URL e un token. Il supporto per l’OpenAI Responses API arriverà molto presto. L’esempio seguente mostra tutta la configurazione necessaria per impostare OpenCode con Cortex AI Gateway:
export PAT="<pat>"
export BASE_URL="<base_url>"
export OPENCODE_CONFIG_CONTENT='{
  "$schema": "https://opencode.ai/config.json",
  "model": "snowflake-cortex/openai-gpt-5.4",
  "small_model": "snowflake-cortex/openai-gpt-5.4",
  "provider": {
    "snowflake-cortex": {
      "options": {
        "baseURL": "${BASE_URL}",
        "account": "<ACCOUNT>.snowflakecomputing.com",
        "apiKey": "<PAT>",
        "headers": {
          "snow-agent-name": "opencode"
        }
      }
    }
  }
}'
Il controllo degli accessi utilizza il framework di controllo degli accessi basato sui ruoli (RBAC) già esistente di Snowflake. Un amministratore può configurare quali modelli sono disponibili tramite il gateway, assicurandosi che siano accessibili solo quelli approvati dall’organizzazione.
Per semplificare ulteriormente l’uso dei coding agent con Cortex AI Gateway, Snowflake CLI sarà in grado di occuparsi della configurazione del traffico affinché passi attraverso il gateway. Basta un unico comando per leggere le credenziali dalla connessione Snowflake attiva, inserirle nella configurazione del coding agent e avviare il coding agent con il traffico instradato tramite Cortex AI Gateway. Ad esempio, avviare OpenCode con Snowflake CLI è ora semplice come eseguire snow ai opencode.
Routing dinamico tra modelli in Cortex AI Gateway: scegli il modello giusto per ogni attività
La maggior parte dei team ha scelto un unico modello frontier per tutto, un approccio ragionevole per iniziare ma costoso da scalare. Una grande parte dei passaggi eseguiti dagli agenti AI consiste in modifiche di file, formattazione e ricerche che un modello più economico gestisce con la stessa qualità e precisione.
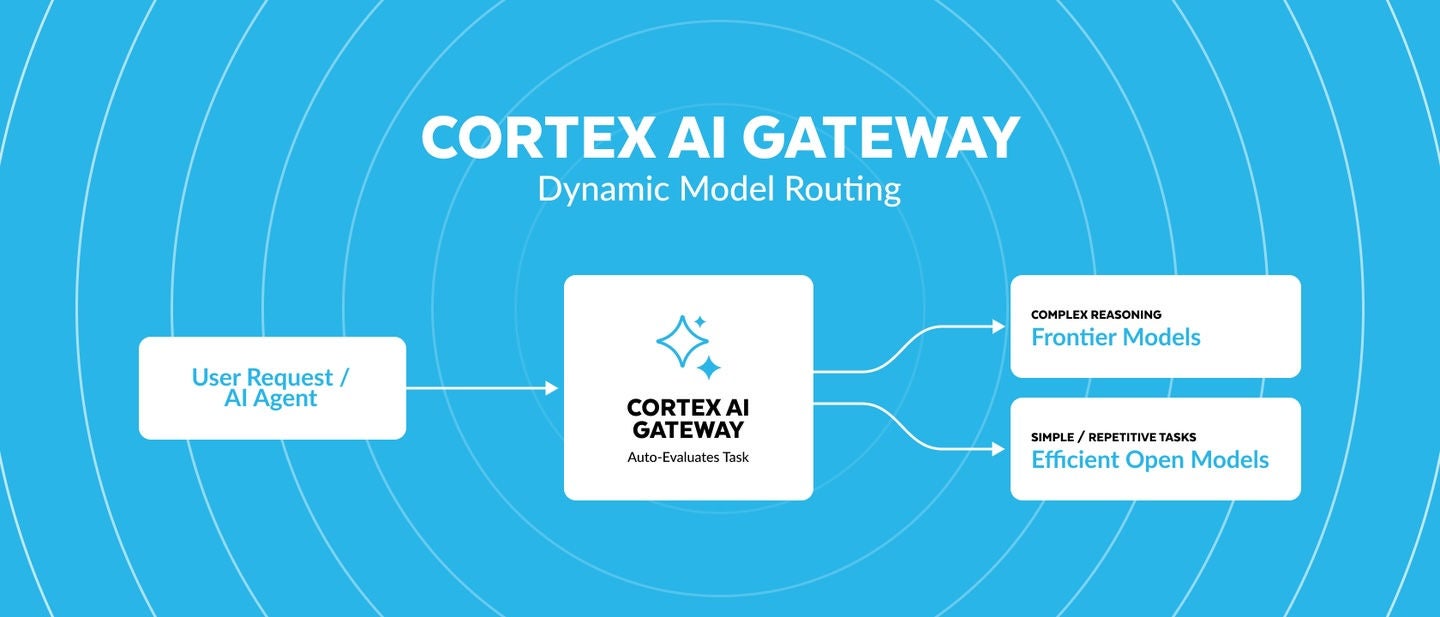
Il routing dinamico tra modelli, disponibile a breve in private preview tramite Cortex AI Gateway, seleziona il modello più economico (tra quelli disponibili) in grado di completare con sicurezza l’attività a ogni passaggio dell’esecuzione dell’agente AI. È stato ottimizzato dal team di ricerca Snowflake, quindi il lavoro a minore complessità e ripetitivo viene affidato a modelli efficienti, mentre il lavoro che richiede un reasoning più approfondito viene affidato a modelli frontier. In una valutazione interna, ha completato un workload di pipeline dbt con un’efficienza dei token fino a 3 volte superiore rispetto a un approccio basato solo su modelli frontier a qualità comparabile e, in un test di coding separato, i team di engineering hanno mantenuto un throughput delle pull request costante utilizzando circa il 25% in meno di token.1 Questi risultati possono tradursi in reali risparmi sui costi per le enterprise.
Il routing è governato esattamente come la selezione manuale dei modelli. Vengono utilizzati solo modelli approvati, le impostazioni di data residency esistenti vengono rispettate e ogni decisione di routing viene registrata, in modo che un team di compliance possa vedere quale modello ha gestito quale richiesta. Poiché il routing risiede in Cortex AI Gateway e non in ciascuna applicazione, Snowflake può aggiornare le decisioni al variare del pricing e delle prestazioni dei modelli, senza che le configurazioni degli agenti AI debbano mai cambiare.
Anche il lato dei modelli open source conta in questo caso. Valutato su ADE-bench utilizzando Snowflake CoCo come harness per agenti AI, DeepSeek-V4-Flash ottiene un punteggio del 74,4%,2 superando il miglior modello proprietario testato. GLM-5.3 arriverà presto in private preview, ma il suo predecessore GLM-5.2 ha ottenuto un punteggio del 66% su ADE-bench2 con il footprint di token più basso tra tutti i modelli del benchmark,2 esattamente il profilo richiesto da un workload ad alto volume. Snowflake fornisce questi modelli all’interno del perimetro sicuro Snowflake, quindi l’inferenza avviene vicino ai dati governati, nello stesso ambito di RBAC e audit trail che già li copre.
Scopri di più sul routing dinamico tra modelli.
Governance di MCP e strumenti: controlla cosa possono fare i tuoi agenti AI
Nel momento in cui un agente AI può chiamare strumenti, diventa un attore all’interno dell’enterprise, e MCP ha reso tutto questo estremamente semplice. Ogni server MCP non gestito installato da un dipendente è un nuovo percorso di accesso ai sistemi di produzione, gestito da qualcosa che decide a runtime cosa fare con l’accesso di cui dispone. Si tratta di shadow IT, con la differenza che il software non autorizzato può leggere database di produzione e modificare record in applicazioni SaaS enterprise.
Un API gateway si chiede se un client è autorizzato a raggiungere un endpoint. Un tool gateway deve rispondere a una domanda diversa: Questo agente AI è autorizzato a eseguire questa chiamata allo strumento, per conto di questo utente, in questo momento? Dopo l’acquisizione di Natoma da parte di Snowflake, Tools in Cortex AI Gateway risponde a questa domanda. Ora in private preview, viene fornito con un catalogo curato di oltre 100 server MCP, ciascuno con OAuth già gestito, il che contribuisce a eliminare la proliferazione di server MCP.
Gli amministratori possono scegliere tra abilitare strumenti specifici, tutti gli strumenti attualmente pubblicati oppure tutti gli strumenti attuali e futuri. Gli strumenti non abilitati non sono visibili al client e non possono essere invocati, quindi una funzionalità negata di norma non viene mai esposta, invece di fallire al momento della chiamata. Le chiamate agli strumenti possono essere registrate, in modo che l’intera sequenza di un agente AI generata da un singolo prompt si presenti come una sequenza coerente. Le chiamate agli strumenti generano inoltre span nella stessa trace table dell’inferenza, in modo che un’unica trace copra sia il reasoning che le azioni.
Questo audit trail rappresenta la difesa contro gli attacchi specifici di questo livello. Tool poisoning, tool shadowing e rug pull, in cui un server approvato aggiorna silenziosamente la definizione di uno strumento rendendola dannosa e i client recepiscono automaticamente la modifica, sono per progettazione invisibili agli utenti finali. Non sono invece invisibili a un sistema che registra ogni definizione di strumento e ogni chiamata.
Osservabilità: visualizza ogni agent trace in un unico posto
Chiedi alle organizzazioni quali agenti AI sono in esecuzione sui loro sistemi, e la risposta onesta nella maggior parte dei casi arriva da un foglio di calcolo di agenti AI non aggiornato. Questo è confermato dai risultati di un sondaggio che abbiamo condotto, in cui circa un cliente su tre intervistato utilizzava dashboard interne personalizzate per l’osservabilità degli agenti AI. Un sondaggio condotto da Cloud Security Alliance ha rilevato che, nell’ultimo anno, l'82% delle organizzazioni ha scoperto almeno un agente AI o workflow autonomo di cui i team di sicurezza o IT non erano precedentemente a conoscenza. Inoltre, le organizzazioni con un elevato utilizzo di shadow AI hanno registrato un costo medio delle violazioni di 5,39 milioni di dollari, con incidenti di shadow AI che hanno interessato il 43% delle organizzazioni colpite, secondo il Cost of a Data Breach Report 2026.
La risposta tipica è strumentare ogni client, un approccio che fallisce per il motivo evidente che non è possibile strumentare ciò che non si conosce. Cortex AI Gateway segue un’altra strada e rende l’osservabilità una proprietà del livello di serving. Una chiamata a un modello o a uno strumento MCP che attraversa il gateway, sia che provenga da un agente AI in esecuzione localmente sul laptop di uno sviluppatore sia da un cluster Kubernetes remoto, viene registrata come span OpenTelemetry in Snowflake. Questo offre una visibilità completa sull’esecuzione su runtime di terze parti, senza modificare il codice dell’agente AI.
Questi span confluiscono nella AGENT_TRACE_TABLE utilizzando le convenzioni semantiche OpenTelemetry per l’AI generativa. Ogni record contiene il modello richiesto, i token di input e output, le letture e scritture della cache, la durata, il codice di stato, i server e gli strumenti MCP, e il client che ha effettuato la chiamata, fino alla relativa versione e sessione. Prompt, risposte e input/output delle chiamate agli strumenti vengono acquisiti solo quando un amministratore attiva la raccolta dei payload e, in tal caso, quel testo risiede all’interno di Snowflake sotto il controllo degli accessi già in uso dall’organizzazione. Poiché la telemetria confluisce direttamente in tabelle di eventi di proprietà del cliente, come AGENT_TRACE_TABLE, rimane strettamente all’interno del perimetro di sicurezza Snowflake.
Cortex AI Gateway accetta inoltre trace OTLP lato client presso il proprio endpoint. La visibilità su trace sia lato server che lato client offre il livello di introspezione di cui ha bisogno qualsiasi leader nell’osservabilità agentica.
Utilizzare CoCo rende l’analisi della telemetria in AGENT_TRACE_TABLE un’operazione eseguibile con un solo prompt. L’esempio seguente mostra come individuare i cali nel cache hit rate e identificare opportunità per ridurre i costi dei modelli.
Sicurezza e guardrail: proteggi le superfici più critiche
L’Agentic AI ha ampliato la superficie di attacco in un modo autenticamente nuovo, e la prova più evidente arriva dagli incidenti che hanno fatto notizia negli ultimi mesi.
La conclusione facile da trarre da questi incidenti: I guardrail sono essenziali per uno stack AI sicuro. Devono trovarsi al confine che l’agente AI deve attraversare, non all’interno dell’agente AI stesso, perché è proprio il giudizio dell’agente AI a essere il punto debole.
Snowflake Cortex AI Guardrails offrono già protezione in runtime contro tentativi di prompt injection e jailbreak su CoCo, Snowflake CoWork e Cortex Agents. Analizzano gli output degli strumenti alla ricerca di prompt injection indirette che tentano di sovrascrivere le istruzioni di sistema, individuano i tentativi di bypassare i limiti di sicurezza dei modelli e identificano in tempo reale pattern di attacco mai visti prima.
Cortex AI Gateway porterà presto questa infrastruttura al traffico del gateway. Estende la protezione dalle superfici AI proprietarie Snowflake a qualsiasi agente AI e harness di terze parti instradato tramite il gateway, riducendo al minimo la superficie di attacco esposta.
Consulta la documentazione di Cortex AI Guardrails per maggiori dettagli.
Governance dei costi: fai contare ogni dollaro investito nell’AI
Nel 2026 la spesa in AI ha fatto saltare molti budget, ma il problema reale non è la stravaganza, bensì previsioni poco accurate. A questo si è affiancato il tokenmaxxing, la pratica di considerare il volume di token come indicatore di produttività. Alcune aziende hanno pubblicato classifiche interne che alla fine hanno chiuso, perché gli utenti cercavano di arrivare in cima a queste classifiche spendendo eccessivamente in AI. È diventato presto evidente che un utilizzo maggiore di token non si traduce generalmente in un ritorno sull’investimento più elevato.
I controlli dei costi Snowflake già esistenti si estendono ora a Cortex AI Gateway, nel tentativo di contrastare questo fenomeno.
I budget offrono controlli consolidati di governance dei costi e sono ora disponibili per qualsiasi traffico AI instradato tramite Cortex AI Gateway. Il livello di controllo dipende in sostanza dall’amministratore. I budget possono essere impostati a livello di gateway per mantenere un approccio granulare, oppure tramite tag di risorse e utenti per suddividere i controlli dei costi in base a qualsiasi dimensione necessaria. Che sia per dipartimento, ruolo, centro di costo, ID utente, agente AI o applicazione, Cortex AI Gateway garantisce visibilità e controllo dei costi su tutti questi aspetti.
Le quote per utente permettono di impostare limiti mensili e, facoltativamente, giornalieri per ogni singolo utente, applicando blocchi nel giro di pochi minuti.
Il traffico del gateway viene registrato in AI_GATEWAY_USAGE_HISTORY, con i crediti suddivisi per modello e un ID di richiesta collegato direttamente a AGENT_TRACE_TABLE. Questo apre una visibilità granulare su quali conversazioni degli agenti AI, workflow, task, richieste al modello e chiamate agli strumenti hanno causato una spesa fuori controllo. CoCo è un ottimo modo per esplorare facilmente i dati di trace e comprendere i costi dell’AI.
Scopri di più sulla governance dei costi AI.
Come iniziare a usare Cortex AI Gateway
Snowflake si impegna a rendere l’AI sicura ed economica per le aziende, e Cortex AI Gateway è il punto di partenza. Provalo di persona: Collega un client a Cortex AI Gateway e osserva le trace, inizia a implementare controlli granulari dei costi oppure analizza le tendenze di utilizzo dei modelli.
Cortex AI Gateway è disponibile in public preview nelle regioni commerciali AWS.3 Consulta la nostra documentazione su Cortex AI Gateway per saperne di più sulle sue funzionalità e caratteristiche e su come iniziare.
Questo contenuto contiene dichiarazioni previsionali, anche in merito alle nostre future offerte di prodotto, e non rappresenta un impegno a fornire alcuna offerta di prodotto. I risultati e le offerte effettivi possono differire e sono soggetti a rischi e incertezze noti e sconosciuti. Fai riferimento al nostro più recente modulo 10‑Q per ulteriori informazioni.
1 I risultati su efficienza dei token e ADE-bench si basano su test interni Snowflake; metodologia e condizioni disponibili su richiesta, e i risultati individuali possono variare in base al workload e alla configurazione. https://www.snowflake.com/it/blog/dynamic-model-routing-open-models-cortex-ai/
2 Il punteggio di efficienza si basa su test interni effettuati con ADE-bench, un framework creato da dbt per valutare gli agenti AI su task reali di analisi dei dati e data engineering.
3 Disponibile solo per gli account nelle regioni commerciali Amazon Web Services (AWS), escluse Asia Pacifico (Nuova Zelanda), Asia Pacifico (Malesia) ed Europa (Spagna).