基礎ガイド
リアルタイム分析とは:仕組み・バッチ処理との違い・活用例
リアルタイム分析(リアルタイムアナリティクス)とは、イベントの発生直後にデータを処理・分析し、データの鮮度が保たれているうちに人やアプリケーション、AIエージェントが行動できるよう結果を届ける分析ワークロードの総称です。ただし、すべての用途で1秒未満の応答が求められるわけではありません。本ガイドでは、バッチ処理との違いや活用例から、アーキテクチャ、サービングレイヤーの選び方まで体系的に解説します。
リアルタイム分析の定義
リアルタイム分析とは、データの鮮度が保たれているうちに適切なアクションを起こせるよう、最新データを人、アプリケーション、または自動化システムへ迅速に届ける分析ワークロード全般を指す総称です。
リアルタイム分析は、レイテンシーの短縮を競うものとして捉えられがちです。しかし、あらゆるワークロードで1秒未満の超低遅延が求められるわけではありません。また、クエリの実行速度も考慮すべき要素の1つに過ぎず、元のデータ自体が古かったり、ピーク時の高い同時実行性によって性能が低下したり、下流側の処理遅延によって意思決定に間に合わなくなったりするリスクも存在します。
本質的な論点は、新たなデータがシステムに取り込まれてから、人、アプリケーション、あるいはAIエージェントがその結果を利用するまでのアナリティクスパイプライン全体が、対象ワークロードの要件に見合う速度で処理を完了できるかどうかにあります。したがって、リアルタイム分析を実務的に捉える際には、単なる処理速度の追求にとどまらず、実用に足るデータ鮮度と信頼性を安定して維持できるアーキテクチャ全体に着目することが不可欠です。
リアルタイム分析とは:データ鮮度とレイテンシーの考え方
リアルタイム分析とは、イベントの発生とほぼ同時に、あるいはその直後にデータを処理・分析し、人やシステムへ最新の状況を提示する仕組みです。その大きな特徴は、同一のクエリ環境において、発生したばかりの最新イベントと過去の蓄積データを統合して分析できる点にあります。たとえば不正検知モデルでは、直前の取引データ単体を見るのではなく、過去数か月にわたるアカウントの利用履歴と照らし合わせることで、疑わしい挙動を検知します。求められるレイテンシーの水準は、ワークロードの要件によって大きく異なります。不正検知のようにミリ秒から秒単位の判定が求められるケースもあれば、在庫管理ダッシュボードのように数分間隔の更新頻度で十分に実務上の役割を果たすケースもあります。
一連の処理パイプラインは、一般的に次のステージで構成されており、
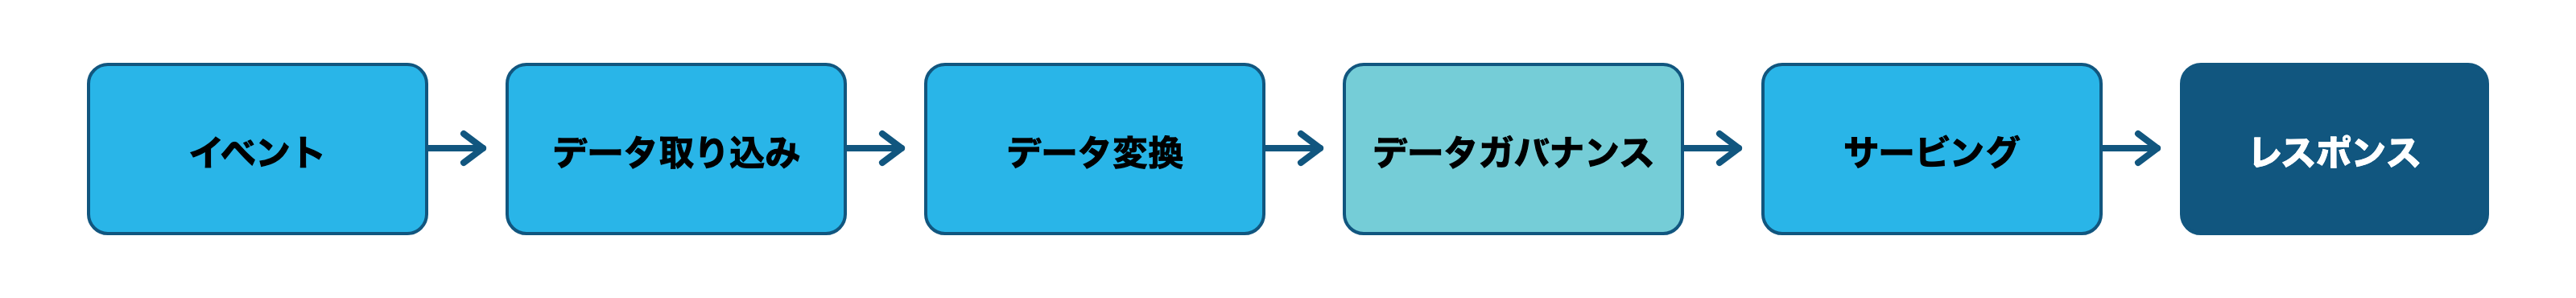
各ステージの所要時間が全体のレイテンシーに影響を与えます。
- データの取り込み:発生したイベントやソースシステム側の変更データが、分析環境へどれだけ速やかに投入されるかを左右します。
- データ変換:取り込まれた生データを、分析に適した形式へと加工・整形します。
- データガバナンス:ビジネス定義、アクセス制御、セキュリティポリシーなどを、低遅延パイプライン全体にわたって一貫して適用します。
- サービングレイヤー:データを利用するアプリケーションやエンドユーザーの要求水準に合わせた応答速度でクエリ結果を返し、情報の価値が損なわれないタイミングで結果を届けます。
こうしたパイプライン全体の流れを俯瞰すると、なぜクエリの応答速度単体ではシステムが実際にリアルタイムで稼働しているかを判断できないのかが明確になります。たとえば、ダッシュボードが200ミリ秒という高速で結果を返していたとしても、参照しているデータ自体が数分前のものであればリアルタイムとは言えません。逆に、テーブル側が途切れなく最新状態に更新されていても、下流のアプリケーション側の応答が追いつかなければ、別の形で遅延問題が生じます。
このように多様なレイテンシーを正しく評価するために、着目すべき3つの指標が存在します。
その1つ目がデータの鮮度です。これは、分析に利用できるデータが、大元のイベント発生やソースシステムの更新からどれだけ遅れて届いているかを表します。たとえば、ある取引が10:00:00に発生し、分析環境でクエリ可能になるのが10:00:08だとすれば、分析クエリを実行する前の段階ですでにデータには8秒の遅延が生じていることになります。
2つ目の指標であるクエリレイテンシーは、必要なデータがサービングレイヤーで参照可能になってから、クエリが結果を返すまでの所要時間を表します。特定のレコードを抽出する選択的ルックアップであれば短時間で応答しますが、大規模な過去ログ全体を対象とするような広範な集計処理では、相応の実行時間を要する場合があります。
そして3つ目が、エンドツーエンドの意思決定レイテンシーです。これは、イベントの発生からデータの取り込み、分析処理、そして人やシステムが最終的なアクションを起こすまでに要した全体の経過時間を評価します。アーキテクチャの設計によっては、これらの各フェーズは順次実行されるだけでなく、一部が並行して処理されるケースもあります。
これら3つの指標を多角的に把握することで、ボトルネックとなっている遅延の根本要因を特定しやすくなります。特にニアリアルタイムのワークロードにおいては、許容可能なラグをチーム内で明確に合意しておくことが重要です。たとえば「新規レコードは発生から5分以内に分析環境へ反映させる」といった具体的なサービス基準(SLA)を設けることで、アーキテクト、アプリケーション開発チーム、そしてビジネスユーザーの三者が、共通の目標に基づいてシステム設計を進められます。
ストリーミング、ニアリアルタイム、バッチ処理の違い
リアルタイム分析とは、低遅延で分析結果を届けるアプローチ全般を指す包括的な概念です。ストリーミング分析とニアリアルタイム分析は、いずれもリアルタイム分析の枠組みに含まれますが、データがシステムへ取り込まれる経路や、転送中(インフライト)にデータ変換処理を施すかどうかに違いがあります。
ストリーミング分析では、データは途切れることなく継続的に取り込まれ、必要に応じてサービングレイヤーへ格納される前の転送途中で加工・集計されたうえで、低遅延クエリの対象となります。これに対し、従来のバッチ分析は、データの鮮度が最優先の要件ではないワークロードに適したアプローチです。
| 処理パターン | 仕組み | 一般的なデータ鮮度 | 主なトレードオフ |
|---|---|---|---|
| ストリーミング | イベントを継続的に取り込み、必要に応じてサービングレイヤーへ格納される前の転送途中で加工・集計処理を実行 | ミリ秒〜秒単位 | 運用管理の複雑化およびインフラコストの増加 |
| ニアリアルタイム | 蓄積された差分データを高頻度なマイクロバッチなどで反復処理 | 秒〜分単位 | 一定のデータ鮮度遅延が生じる一方、コストとシステム運用の複雑さは中程度に抑制 |
| バッチ | スケジュール設定された個別ジョブに基づき、まとまった単位でデータを一括処理 | 数分〜数日、またはそれ以上 | データの鮮度が直近のバッチ実行時点に制限される |
これらはあくまで一般的な目安であり、厳密に線引きされた境界ではありません。実務における本質的な違いは、データがパイプラインを流れる形態にあります。すなわち、継続的なストリームか、短間隔のマイクロバッチか、あるいは定期的なスケジュールジョブかという点です。これがデータ鮮度を左右する要因となります。
一方で、クエリの応答速度を決定づけるのはサービングレイヤーの性能です。リアルタイム分析を成立させるには、用途に見合う十分なデータ鮮度と、要求水準を満たすクエリ速度の両立が求められます。そのため、どの処理パターンを採用すべきかは、クエリをいかに速く返すかではなく、どの水準のデータ鮮度が求められているかを基準に判断します。仮にバッチ処理でロードされたデータであっても、サービングレイヤーが高速に応答し、かつワークロード側がバッチ実行間隔に伴う遅延を許容できるのであれば、十分にリアルタイム分析の基盤として機能します。

リアルタイム分析の活用例:ビジネス価値を生む4つの領域
レイテンシー低減への投資が妥当とされるのは、分析結果の到着を待つことによって、組織が本来果たすべき迅速なアクションを阻害されてしまうケースに限られます。目指すべき具体的なレイテンシー基準はユースケースごとに異なりますが、判断基準となる本質的な問いは共通しています。それは、早期に対応することで得られる事業価値は、レイテンシーを短縮するために投じるコストを上回るかという視点です。
損失の防止:不正検知・予知保全・セキュリティ監視
リアルタイム分析は、損失が表面化する前の段階で先手を打つアプローチを可能にします。不正検知においては、決済処理が承認される前の段階でトランザクションを評価することで、疑わしい取引を完了前に停止する制御が可能になります。製造業や保全業務では、設備から取得したテレメトリデータを監視し、温度、振動、圧力などの異常値をいち早く検知することで、設備停止へ発展する前に点検や予防保守を自動で促します。また、セキュリティ運用では、認証ログ、エンドポイントの挙動、ネットワーク通信イベントを迅速に相関分析し、不審なアクティビティによる被害が拡大する前に影響範囲を隔離します。
機会の最大化:パーソナライゼーションとダイナミックプライシング
パーソナライゼーション、レコメンデーション、および最適な次の提案の提示においては、直前の行動ログが次に提示すべきコンテンツの精度を左右します。たとえばEC・小売企業では、同一セッション内におけるユーザーの閲覧行動と、商品の在庫状況や過去の購買履歴を組み合わせてレコメンド内容を動的に更新します。同様にダイナミックプライシング(価格最適化)システムであれば、リアルタイムな需要動向や在庫残数の変化に応じて提示価格を柔軟に最適化します。
オペレーションの改善:サプライチェーンとコンタクトセンター
業務現場における意思決定では、軌道修正やリカバリーが可能な時間的猶予があるうちに、状況の変化を的確に捉えられるかどうかが成否を分けます。サプライチェーンでは、在庫推移、出荷ステータス、サプライヤーの最新状況を需要予測やリスク評価モデルへ迅速に反映させることで、欠品を防ぐ在庫の再配分、配送ルートの変更、突発的な輸送障害への迅速な対応を支援します。コンタクトセンターにおいては、通話音声のリアルタイム文字起こしや応対履歴データを活用し、会話の最中に顧客の意図や感情を解析します。これにより、通話が終了する前の段階で、オペレーターに対して次に案内すべき最適な回答やトークスクリプトを提示できます。こうしたリアルタイムな対応パターンは、サービスレベル(SLA)の維持管理、マーケティングキャンペーンのリアルタイム最適化、その他さまざまな現場オペレーションの改善にも広く応用されています。
プロダクト価値の向上:顧客向けアプリケーションとAPI
ダッシュボードやAPI、組み込み型の分析機能を通じて、エンドユーザーや顧客へ分析結果を直接提供するプロダクトも増えています。こうしたケースでは、データの鮮度やクエリの応答性能そのものが、プロダクトの品質やユーザー体験(UX)を決定づける要素となります。たとえば、顧客向けアプリケーションで直近のアカウント利用状況や稼働ステータス、利用実績の推移を表示したり、API経由で最新の分析データを外部システムや顧客の業務ワークフローへ連携したりする設計がこれに該当します。
リアルタイム分析導入時の課題
リアルタイム分析には、運用面とコスト面の課題もあります。ストリーミング基盤や専用のサービングレイヤーを追加するほど、監視すべきシステムと障害点が増え、インフラコストも膨らみます。また、遅延到達や重複したイベントを適切に処理しなければ、高速であっても誤った結果を返しかねません。そのため、導入前に必要なデータ鮮度を見極め、レイテンシー短縮のコストに見合う価値があるかを判断することが重要です。
リアルタイム分析のアーキテクチャと処理の流れ
新たなイベントの発生から分析結果へ反映されるまでに許容される所要時間を明確に定義できれば、エンドツーエンドの処理パイプライン全体を俯瞰し、どのステージに遅延(レイテンシー)が蓄積しているかを特定できるようになります。
一般的な処理フローは次のステップで構成されます。
イベントの発生・変更データの検知:業務イベントの発生、またはソースシステムにおける更新データを生成またはキャプチャします。
データの取り込み:検知した変更データを分析基盤へ取り込み、またはレプリケーションを実行します。
検証・データ拡充・変換:要件に応じてデータの整合性を検証し、必要な属性情報を付加したうえで、分析用フォーマットへと変換・整形します。
サービングレイヤーへのデータ展開:処理済みのデータをサービングレイヤーへ格納し、低遅延で照会可能な状態に整えます。
分析クエリ・ルール・モデルの実行:分析用SQLクエリ、ビジネスルール、あるいは機械学習モデルを実行します。
分析結果の配信:導き出されたインサイトを、エンドユーザー、外部アプリケーション、自動化ワークフロー、またはAIエージェントへと届けます。
アクションの実行:ユースケースの要件に基づき、アラート通知や自動制御などの具体的なアクションへつなげます。
継続的な監視:これら一連のパイプライン全体にわたり、データの鮮度、レイテンシー、計算結果の正確性、および障害の発生状況を継続してモニタリングします。
ただし、これらの各ステージが常に直列に実行されるとは限りません。ストリームプロセッサが取り込みと並行してデータ変換を実行したり、下流の集計処理が増分で走ったり、アプリケーション側がイベント間で状態を保持し続けたりする構成も一般的です。最終的に重要となるのは、全体の所要時間であるエンドツーエンドのレイテンシーと、そこに影響を与える各ステージのレイテンシーおよびそのばらつきです。
たとえば、不正検知のワークロードにおいて許容される最大応答時間が10秒間だと仮定します。もしソースシステムからデータが分析環境へ取り込まれ、クエリ可能な状態になるまでに恒常的に6秒を要しているとすれば、分析クエリを実行する前の段階で、許容時間の過半がすでに消費されていることになります。したがって、各ステージのレイテンシーを個別に計測し、単純な平均値だけでなくp50、p95、p99(パーセンタイル値)に着目して評価することが不可欠です。これにより、実際の商用本番環境において、どの処理に遅延のボトルネックが蓄積しているかを正確に浮き彫りにできます。
各ステージのレイテンシーを計測することで処理時間の内訳は把握できますが、本番環境での実際の挙動を踏まえると、さらに別の制約条件を考慮しなければなりません。たとえば、軽負荷の検証環境では良好に見えるクエリ性能も、本番ピーク時の高い同時実行性の下では低下するリスクがあります。また、取り込み時のイベントスループットが高いからといって、下流側のデータ鮮度が維持される保証はありません。
さらにデータパイプラインには、後続の分析結果の整合性を損なうことなく、ストリーミングデータ特有の不規則な挙動へ柔軟に対処できる耐性が求められます。具体的には、イベントデータの遅延到達や順序の乱れ、配信到達の成否が不明な際にアプリケーション側から行われる再送処理、さらにはネットワーク寸断に伴うデータの欠落や重複といった事象を前提とした設計が欠かせません。採用する技術要素に応じて、エンジニアリングチームはリプレイ機構、重複排除、べき等な書き込み、オフセット管理、そしてイベント時間に基づく処理などを組み合わせ、下流データの整合性を維持します。
また、データガバナンスもアーキテクチャ設計を左右する重要な要素です。最新データを別のサービング専用システムへ同期・移行させれば、クエリの応答性能は向上するかもしれません。しかしその反面、アクセス制御ポリシー、指標のビジネスロジック、データリネージの定義を別の場所で二重に再実装する必要性が生じます。
システムの規模が拡大するにつれ、こうしたガバナンスの二重管理コストは肥大化していきます。Snowflakeのインタラクティブ分析担当プリンシパルプロダクトマネージャーであるWill Xuは、次のように指摘しています。「データがセキュアな単一環境を離れ、外部の別システムで変換処理されるたびに、セキュリティルールを再設定することになります。そして『双方の設定が整合していること』を祈るような運用に陥るのです。5つのツールを継ぎ接ぎして構築されたパイプラインには、そのまま5つの潜在的な障害点が存在します。上流側の些細な調整が原因で、下流のダッシュボードがいつの間にか破損してしまうリスクを常に抱えることになるのです」
最新のイベントデータと蓄積された過去データを同一の統合ガバナンスモデルの下で一元管理することは、アクセス権限の抜け漏れ、指標定義の不整合、そしてデータリネージの断絶といったリスクを最小限に抑える鍵となります。
クイックヒント
クエリレイヤーの応答速度だけでなく、パイプライン全体の主要な境界ごとにレイテンシーを計測することが重要です。p50、p95、p99を追跡することで、遅延のボトルネックがデータの取り込み、データ変換、サービングレイヤー、あるいは下流側のアプリケーション応答のどこに生じているかを正確に特定できます。
低遅延データパイプラインの設計と構築
最新データを分析環境へ投入するアプローチには、いくつかのパターンが存在します。特定のイベントストリームを直接受信するワークロードもあれば、変更データキャプチャやレプリケーション機構を活用し、基幹系・運用システム側で発生したレコードの挿入、更新、削除の差分ログを連携させる構成もあります。
新たなイベントデータやデータベースの更新ログが分析基盤に到達した際、低遅延パイプラインにおいては、求められる分析結果を導き出すために不可欠な最小限の処理や加工のみを実行する設計が推奨されます。ソースデータの一部のみに変更が生じた場合、増分処理を取り入れることで、データ全体の不要な再計算コストを抑制できます。ただし、増分処理を採用したからといって、必ずしも1イベントごとの完全なストリーミング処理を意味するわけではありません。定義されたデータ鮮度の目標基準(SLA)や定期的なスケジュールに基づき、適切な間隔でマイクロバッチ的に更新をかけるアプローチも有効な選択肢となります。
多くのワークロードでは、発生した最新イベント単体だけでなく、過去データのコンテキストとの照合が欠かせません。決済金額、センサーの計測値、ユーザーの行動ログなどは、過去の行動履歴、あらかじめ確立された基準値、あるいはガバナンス管理された統一ビジネスロジックと突き合わせて初めて、ビジネス上の実質的な意味や示唆を持ちます。
ワークロード要件に応じたサービングレイヤーの選定
データの事前準備が整った後、エンドユーザーやアプリケーションが結果をどれだけ迅速に取得できるかを決定づけるのがサービングレイヤーの設計です。最適なアーキテクチャの選定は、次のようなワークロードの特性によって左右されます。
- どのようなクエリパターンを実行するのか
- ピーク時にどれほどの同時リクエストが発生するのか
- 参照・結合すべき過去データがどの規模で存在するのか
- エンドユーザー体験や連携先システムが要求する応答レイテンシーの水準はどの程度か
したがって、個別の要素技術や製品スペックを比較検討する前に、まずこれらの要件を体系的にマッピングすることが有効なアプローチとなります。
| 要件 | 確認すべきポイント |
|---|---|
| データ鮮度のSLA | 新規に取り込まれたデータや変換済みのデータは、どの程度の時間内にクエリ可能になるべきか |
| クエリのパターンと選択性 | クエリの実行特性は、キー指定による高選択性なポイントルックアップ、大規模データセットに対する集計処理、あるいはその双方の組み合わせのいずれに該当するか |
読み取り/書き込みパターン |
ワークロードの主体は、分析用途の読み取り処理、高頻度な更新処理、あるいはその双方が混在する構成か |
| 同時実行性とテールレイテンシー(外れ値の遅延) | ピーク時に同時アクセスするユーザー数やアプリケーション数はどの規模で、許容される応答時間の基準(p95/p99)は何ミリ秒(または何秒)か |
| 履歴データのコンテキスト | 参照が必要なデータは直近の最新ステータスのみか、それとも過去数か月から数年間にわたる履歴データとの突き合わせや比較が求められるか |
| トランザクションの一貫性 | 分析クエリの実行と並行して、厳密な一貫性(強整合性)を担保した読み書き処理が求められるか |
| ガバナンスとセキュリティ | 他の分析基盤や全社システムで適用されているアクセス制御ポリシーやビジネスロジックの定義を、サービングレイヤーでもそのまま一貫して適用可能か |
| 可用性と障害復旧 | サービングレイヤーで応答遅延やサービス停止が発生した場合、業務やエンドユーザーにどのような影響が生じるか |
| 運用管理の負荷 | インフラのプロビジョニング、性能チューニング、監視、定期メンテナンスにおいて、チームにどれほどの運用工数が発生するか |
| コスト | 通常時の定常トラフィックと、高負荷なピーク時それぞれの条件下で、インフラおよび運用の総コストはどの水準に見積もられるか |
なかでもテールレイテンシーには、特別な注意を払う必要があります。たとえば、平均クエリ応答時間が300ミリ秒と良好に見えても、特定のリクエストでp99が恒常的に3秒に達していれば、その遅延を被るユーザーの体感品質を測る指標としては不十分です。インタラクティブなアプリケーションにおいては、本番ピーク時の高負荷下で生じるこうした一部の遅延リクエストこそが、ユーザー体験全体を決定づける要因となります。
インメモリ処理やキャッシュ機構の導入は、特定のアクセスパターンにおいてデータ取得のレイテンシーを短縮する有効な手段です。ただし、これらは処理パイプライン全体の遅延を根本から解消するわけではありません。キャッシュを利用する場合でも、データ鮮度の管理方針や適切な無効化(インバリデーション)ロジックの設計が不可欠です。もし大元からの更新データの到達が遅ければ、いくらキャッシュによって高速な読み取りを実現したところで、古いデータを効率よく返し続けているにすぎない状態に陥ってしまいます。
アーキテクチャによっては、イベント転送、ストリーム処理、分析サービング、キャッシュ、プレゼンテーションの各工程に別々のシステムを組み合わせることでこの課題に対処するケースもあります。しかし、ツールを追加するたびに固有の障害モードやガバナンスの境界線、運用オーバーヘッドが持ち込まれます。そのため、データパイプラインのより多くの領域を単一の統合プラットフォームへ集約することが、システムの複雑性と運用リスクの双方を低減させる現実的な解決策となります。
よくある落とし穴
典型的な失敗例として、ピーク時の高い同時実行性やテールレイテンシーを考慮せず、平均クエリ応答速度の最適化ばかりに注力してしまう点が挙げられます。軽負荷の検証段階では良好なレスポンスを示していたサービングレイヤーであっても、本番環境で数百から数千のリクエストが集中した際には、まったく異なる挙動を示すケースは少なくありません。
インタラクティブ分析とリアルタイムダッシュボードの設計
データがサービングレイヤーへ格納された後、次に検討すべき論点は、エンドユーザーや連携アプリケーションがそのデータをどのように活用するかという点です。ダッシュボード、顧客向けアプリケーション、外部API、さらには対話型インターフェースに至るまで、いずれも同一の低遅延アーキテクチャ上で稼働できますが、それぞれが求める応答性能や同時実行性の要件は大きく異なります。
自然言語検索や対話型アナリティクスを含むインタラクティブ分析では、通常時の想定負荷だけでなく、ピーク需要時を見据えた同時実行数を前提に、許容可能な応答時間を定義しておくことが重要です。開発環境における軽負荷テストで良好なパフォーマンスを示していたとしても、本番環境で数百から数千のユーザーやアプリケーションから一斉にリクエストが集中した際には、挙動が一変するケースも珍しくありません。
クエリの実行パターンも、レイテンシーの予測しやすさ(安定性)を大きく左右します。一般に、条件を絞り込んだ選択性の高いリクエストは、大量データをフルスキャンするような探索的で非定型な処理に比べて、安定した応答速度を維持しやすい傾向があります。計算負荷の高いクエリをどうしても実行する必要がある場合は、利用側のアプリケーションにおいて、非同期処理への切り替え、集計粒度を粗くしたサマリーの先行返却、あるいは処理に時間を要する旨の明確なステータス表示といったフォールバック(代替策)をあらかじめ設計しておくことが有効です。
また、データの鮮度そのものをエンドユーザーが直感的に把握できるように可視化することも欠かせません。たとえば画面上に「◯◯時点のデータ」といったタイムスタンプを表示することで、鮮度が意思決定を左右する運用ダッシュボードにおいて、ユーザーが提示された数値を誤解なく解釈できるようになります。外部システムと連携するアプリケーションやAPIであれば、下流のプログラムが鮮度状態を自動判定できるよう、レスポンスのメタデータとしてデータ更新時刻を付与して返却する設計も一般的です。
SnowflakeのWill Xuは、この点について次のように述べています。「刻々と動くライブな数値と、確定した最終値を混同してはいけません。取引時間中に変動し続ける株価と同様に、ライブの数値には現時点の速報値であることが一目でわかるフラグを付与すべきです。一方で、監査対象となる終値のような確定値は厳密に扱わなければなりません。迅速な初動のために現場へリアルタイムな速報データを届ける一方で、データの信頼性を担保するために確定値の境界を固定することが重要です」
また、こうした多様な利用インターフェースを横断しても、ガバナンス管理されたビジネス定義の整合性が維持されていなければなりません。売上、アクティブ顧客数、粗利益といった重要指標は、BIダッシュボード、組み込みアプリケーション、あるいは自然言語によるAI回答のどこで参照されようとも、常に同一の計算ロジックに基づいた同じ数値を指し示す必要があります。さらに、アクセス制御ポリシーやデータリネージの情報も、データが各サービングレイヤーや利用インターフェースへ展開されるプロセスにおいて、途切れることなく一貫して引き継がれる設計が求められます。
リアルタイムデータによる予測分析
予測分析の運用においては、複数の異なるタイミング要件を管理する必要があります。具体的には、モデルへ投入する入力データの鮮度、予測値の生成に要する時間、そして予測が出力されてから後続のアクションが実行されるまでの所要時間を個別に把握しなければなりません。
- 特徴量の鮮度:モデルに入力される特徴量がどの程度最新の状態を反映しているかを示す指標です。
- 推論レイテンシー:入力データを受け取ったモデルが予測結果を出力するまでに要する時間を指します。
- アクションレイテンシー:予測結果が出力されてから、システムや担当者が実際のアクションを起こすまでの所要時間を示します。
これら3つの処理フェーズは、それぞれ異なる間隔やタイミングで実行されるのが一般的です。ワークロードによっては、イベントが発生するたびにモデルがリアルタイムに推論を行うオンラインスコアリングを採用するケースがあります。一方で、最新の特徴量が更新されるタイミングに合わせて、数分間隔で予測結果を再計算するアプローチもあります。また、日常的なイベントの大半はそのまま受け流し、特定の条件を満たす重要な変化を検知したときだけ推論を実行するイベントトリガー型推論も有効な選択肢です。どのパターンが最適かは、生成された予測結果の有効性がどれほどの時間維持されるかによって決まります。
なお、特徴量の鮮度を高めたとしても、モデルの継続的な品質管理や運用統制を省略できるわけではありません。モデルのドリフト、正解データの遅延到達、予測結果が次の入力データへ影響を与えるフィードバックループ、さらには取り込みデータの分布変化といった機械学習運用(MLOps)特有の課題への対応も不可欠です。
レコメンデーションとAIエージェントへの活用
レコメンデーションエンジン、各種業務アプリケーション、そしてAIエージェントにおいて、最新データの存在は選択肢の順位付けや最適なアクションの決定、回答生成に用いられるコンテキストの精度を大きく左右します。たとえばレコメンデーション機能では、同一セッション内における足元の閲覧行動に加えて、過去の購買履歴、リアルタイムな在庫状況、ユーザーの嗜好データを組み合わせて提示内容を最適化します。イベントの検知によって直近のユーザー行動を捉え、特徴量の更新によって関連コンテキストへ反映し、推論ロジックが最適な提案を選び出し、その後のユーザー反応をフィードバックデータとして蓄積していくというサイクルが回ります。
エンタープライズ領域のデータを扱うAIエージェントでは、取得したコンテキスト情報が要求されたタスクの遂行に足る鮮度を満たしているかどうかを自律的に検証できる仕組みが求められます。同時に、アクセス制御ポリシーが維持されていること、そして参照先のデータが古い場合や取得できない場合に備えて、あらかじめ想定されたフォールバック処理が稼働し、その挙動がモニタリング可能であることも欠かせません。
こうしたワークロードにおいて、データの鮮度は、システムがすでに活用している既存のコンテキストと正しく結合できて初めて価値を発揮します。レコメンデーションエンジンが直近の行動ログを過去の購買履歴と掛け合わせて活用するように、AIエージェントもまた、最新の運用データだけでなく、ガバナンス管理された全社共通のビジネスロジックやアクセス権限と一体的に処理することが前提となります。
リアルタイム分析基盤としてSnowflakeが選ばれる理由
リアルタイム分析の本質は、単にイベントデータを高速に取り込むことだけに留まりません。刻々と変化するライブデータを、信頼性の高い意思決定や優れた顧客体験へと変えることにこそ価値があります。Snowflakeは、リアルタイム分析のライフサイクル全体を、相互に連携し高度にガバナンス管理された単一プラットフォーム上で統合します。
Snowpipe Streamingを活用することで、アプリケーションから発生したデータ行をSnowflakeのテーブルへ直接書き込むことが可能です。テーブルあたり最大20GB/秒(非圧縮時)のスループットに対応し、5秒程度の低レイテンシーを実現しながら、データ取り込み量に応じた分かりやすい従量課金体系で利用できます。名前付きチャネルを利用すると、各チャネル内で送信された順序通りのデータ格納が維持されます。さらに、組み込みのオフセットトークンを活用することで、システム障害や再起動が発生した場合でも、データの重複や欠落のない厳密に1回(exactly-once)の配信を実現できます。一方、Elastic Channels(エラスティックチャネル)は、数千規模のデバイスやマイクロサービスから単一テーブルへのストリーミング書き込みを可能にします。自動スケーリングを備えた共通エンドポイントを介してデータが取り込まれるため、運用側は単一の接続窓口を管理するだけで済みます。
データ変換においては、動的テーブル(ダイナミックテーブル)を活用することで、後続のダッシュボード、連携アプリケーション、エンドユーザーが必要とする分析に最適化されたテーブルを定義できます。設定されたリフレッシュモードやクエリ操作の種別に応じて、全データの再集計を行わず、変更差分の行のみを処理することが可能です。
低遅延なクエリサービングが求められる領域では、インタラクティブ分析が機能します。これは、低レイテンシーかつ高い同時実行性が要求される分析ワークロードに特化して設計されたインタラクティブウェアハウスを活用し、高速な応答を実現します。インタラクティブウェアハウスは、標準テーブル、動的テーブル、インタラクティブテーブル、そしてApache Icebergテーブルにネイティブ対応しています。
Snowflakeを採用することで、企業は個別のリアルタイム専用データスタックを別途構築したり、サイロ化したサービングレイヤーへデータを二重転送したりする必要がなくなります。統合された単一のガバナンス環境下で、データの取り込みから分析用テーブルへの加工、さらには実用的なインサイトの創出に至るまでのライフサイクル全体を完結できます。リアルタイムなイベントデータが過去のコンテキストや全社共通のガバナンスと分断されることなく連携し続けるため、運用の複雑性を抑制し、インフラコストの最適化を図りながら、イベント発生からインサイト獲得、具体的なアクションの実行までのサイクルを円滑に進めることが可能になります。
ワークロードからの逆算によるアーキテクチャ設計
実効性の高いリアルタイムアーキテクチャを構築するには、対象のワークロードが最新データに対して何を求めているのかを出発点とする必要があります。求められているのは刻々と更新されるライブ画面の表示か、現場担当者による意思決定か、アプリケーションの即時応答か、あるいは自動化されたアクションのトリガーなのかを明確にします。この要件が定まることで、発生したイベントをどの程度の時間内に照会可能とすべきか、データ提供前にどの規模のデータ変換または整形が必要か、サービングレイヤーが維持すべきクエリレイテンシーの水準はどれほどか、そしてp95やp99といったテールレイテンシーのばらつきをどの範囲まで許容できるかを具体的に割り出すことができます。
アーキテクチャ全体は、現場が求める最新の状況把握、意思決定、あるいはシステム応答を支えるのに十分なスピードでデータを流通させるよう設計されるべきです。
重要なポイント
目指すべきレイテンシーの適正値は、ワークロードの性質によって決まります。リアルタイムを一律の絶対速度として捉えるのではなく、そのユースケースが本当に必要としているデータ鮮度、クエリ性能、同時実行数、および応答時間を見極めたうえで設計することが不可欠です。
よくある質問
リアルタイム分析に関するよくある質問に、Snowflakeのエキスパートが回答します。
リアルタイム分析とバッチ処理の違いは何ですか?
バッチ処理は、スケジュールに沿ってデータをまとめて処理する方式で、データの鮮度は直近の実行時点までに限られます。リアルタイム分析は、データの発生直後から数秒〜数分以内に分析結果を届けます。ただし、すべてのワークロードにリアルタイム処理が必要なわけではありません。在庫ダッシュボードのように数分間隔の更新で十分な用途もあれば、不正検知のようにミリ秒から秒単位の判定が求められる用途もあります。必要なデータ鮮度に応じて処理方式を選ぶことが重要です。
リアルタイム分析とストリーミング分析の違いは何ですか?
リアルタイム分析は、最新データを低遅延で届ける分析アプローチ全般を指す総称で、ストリーミング分析はその一形態です。ストリーミング分析ではイベントを継続的に取り込み、多くの場合は転送中にデータを加工します。一方、ニアリアルタイム処理や高速なサービングレイヤーを組み合わせたバッチ処理でも、ワークロードが求める鮮度を満たせばリアルタイム分析として機能します。
リアルタイム分析にはどのようなメリットがありますか?
不正取引や設備の故障の予兆を、損失が出る前に検知できます。閲覧中のユーザーに合わせて提案を最適化したり、サプライチェーンやコンタクトセンターで状況が変わった時点で対応したりすることも可能です。ただし、レイテンシーを短縮するためのコストを上回る事業価値があるかどうかを、ユースケースごとに見極める必要があります。
リアルタイム分析において、遅延到達、重複、順序の乱れが発生したイベントにはどのように対処すべきですか?
リアルタイム分析基盤では、イベント時間に基づく処理、ウォーターマーク(遅延データの確定基準)、重複排除、べき等な書き込み、そしてリプレイ機構といった技術を用いて対処します。こうした制御を組み込むことで、ネットワーク瞬断や再送によってイベントが遅れて届いたり、複数回送信されたり、発生順と異なる順序で到着したりした場合でも、後続の集計結果や分析データの整合性を維持できます。
リアルタイム分析システムにおけるエンドツーエンドのレイテンシーとデータ鮮度は、どのように計測しますか?
イベントの発生、取り込み、データ変換、クエリ可能な状態への到達、そして最終的な分析結果の配信といった、パイプラインの主要なステージごとにタイムスタンプを記録して計測します。その際、単純な平均値だけでなく、データ鮮度や計算結果の正確性と並行して p50、p95、p99(パーセンタイル値)を追跡することが重要です。これにより、平常時の標準的な処理性能だけでなく、本番高負荷時に発生する遅延の傾向まで正確に把握できます。
アナリティクス関連リソース
アナリティクスに関するトピック
アナリティクスのあらゆる側面を深く掘り下げます。
