基礎ガイド
AIアナリティクス(AI分析)とは:仕組み・メリット・活用方法
AIアナリティクス(AI分析)とは、機械学習や生成AIを活用して、データの準備、パターンの特定、結果の予測、質問への回答、意思決定の支援といった分析業務を行うことです。現在、AIは予測やデータ準備から、自然言語によるクエリ対応、自律的な調査に至るまで、アナリティクスのワークフロー全体を支援しています。本ガイドでは、その仕組みと活用方法を解説します。
AIアナリティクス(分析)の定義
AIアナリティクスは、データの準備、パターンの特定、結果の予測、質問への回答、意思決定の支援といった分析業務に機械学習や生成AIを適用するものです。
アナリティクスには、より多様なビジネス上の問いや分析への対応が求められており、その有効な手段としてAIの活用が急速に進んでいます。ビジネスおよびテクノロジーのリーダー2,050人を対象とした2026年のSnowflake主催Omdia調査では、データアナリティクスチームの59%が生成AIやエージェントを活用していると回答しました。
実際の活用形態は多岐にわたります。アナリストによるクエリ生成、非構造化データの分類や要約、将来予測、調査すべきパターンの特定などを幅広く支援します。また、自然言語インターフェースによってビジネスユーザーが直感的にデータを探索できる一方、エージェントは一連の調査において複数の分析プロセスを自律的に処理できます。
AIアナリティクス(AI分析)とは
AIアナリティクスとは、データの準備、パターン検出、予測、自然言語によるクエリ実行、インサイトの抽出、意思決定支援に至るまで、アナリティクスのライフサイクル全体で機械学習(ML)、生成AI、エージェント型AIを活用することを指します。
- 機械学習(ML):過去のデータからパターンを学習し、予測、分類、異常検知を行います。
- 生成AI:自然言語での質問をクエリに変換したり、分析結果の要約や、テキスト・画像などの非構造化データの処理を行ったりします。
- エージェント型AI:複数のツールやデータソースを組み合わせ、多段階の調査を自律的に進めます。
その適用範囲は、従来の高度なアナリティクスで一般的だった機械学習による予測業務の枠を大きく超えて広がっています。言語モデルやマルチモーダルモデルの進化により、構造化データへの柔軟なクエリ実行に加え、ドキュメント、テキスト、画像、音声といった多様な非構造化データの分析も可能になりました。
こうした領域の拡大に伴い、アナリティクスの現場で実務担当者に求められる役割やスキルも変化しています。AIがクエリ生成、予測、分類、解釈を幅広く担うようになるにつれ、アナリストがあらゆる分析成果物を手作業で作成する工数は削減されます。その結果、指標の計算ロジック、テーブル間の関連性、モデルのターゲット、ビジネスルール、評価基準の定義といった、より本質的な業務に時間を充てられるようになります。また、AIの出力結果を検証し、本来の用途に即しているかを判断することも不可欠な役割となります。Snowflakeの金融サービス担当AI責任者であるJohn Heislerは次のように述べています。「重要なのは、人間の判断をAIに置き換えることではなく、人間の判断をより適切な領域へと配分することです」
こうした取り組みの多くは、ユーザーインターフェースの裏側で進められます。たとえば、アップロードされた抽出データを処理するAIアシスタントは手元のレコードのみを分析します。それに対してエンタープライズアナリティクスでは、最新のソースデータ、アクセス制御ルール、ビジネス定義、データリネージ、データセット間の関連性など、プラットフォーム側で一元管理されたコンテキストとの連携が欠かせません。分析ワークフローにおいてAIが担う領域が広がるほど、こうした基盤となる設計や定義の選択が、ユーザーの得るアウトプットの質に直結するようになります。
AIドリブンBIとインタラクティブアナリティクスによって、チームのデータ探索方法がどのように変化しているかをご覧ください。
AIアナリティクスのメリット
AIアナリティクスの実践的な価値の多くは、分析に付随する反復作業を削減しつつ、基盤となるデータをより多様なアプローチで活用できるようにする点にあります。
定常的な分析への迅速なアクセス
自然言語インターフェースは、期間比較や地域ごとの指標フィルタリング、差異要因の調査といった頻出の要求に対して、ビジネスの問いから回答を得るまでのリードタイムを大幅に短縮します。あらゆる質問をアナリストに依頼してクエリの作成やレポート構築を待つ必要はなく、ビジネスユーザー自らが直接データを探索し、新たな知見が得られた場合もそのまま続けて深掘りできます。
より付加価値の高い業務へのリソース集中
定常的なリクエスト対応から解放されることで、アナリストは専門知識が求められる領域へリソースを集中できます。これには、指標やテーブル間の関連性定義、曖昧な結果の調査、分析モデルの開発、そして分析結果が意思決定の根拠として適切に機能しているかの検証といった、高度な判断を要する業務が含まれます。
分析に利用できるデータタイプの拡充
生成AIにより、分析ワークフローに取り込めるデータの種類が大幅に広がります。テキスト、ドキュメント、画像などの非構造化データを分類・要約し、構造化データと統合して扱えるため、従来は個別処理や膨大な手作業での確認を要していた情報の分析もスムーズに行えるようになります。
プロアクティブな分析への転換
AIは、分析や調査の着眼点そのものを能動的なアプローチへと変えます。異常検知、将来予測、インサイトの自動抽出を活用することで、担当者が課題を意識して能動的に問いを立てる前に、通常とは異なる兆候や新たなトレンドを検知できます。たとえばサイバーセキュリティ領域では、アイデンティティ、エンドポイント、クラウドの各アクティビティをAIが横断的に相関分析し、単一のイベント監視では見落とされがちな一連の不審な挙動を検知してアラートを出すことが可能です。
こうしたメリットを享受できるかどうかは、AIの出力結果が実用に耐えうる信頼性を備えているかにかかっています。不適切なテーブル結合に基づくもっともらしい説明や、的外れなターゲットを基準にした予測、鮮度の低いデータに基づく自動インサイトなどは、誤った判断をより早く下してしまう原因になりかねません。ワークフローの自動化が進むなかで価値を創出するには、データの正確性、適切な評価、そして明確なビジネス定義の確立が不可欠です。

AIアナリティクスの活用方法:分析ワークフローの各段階
AIは、ビジネスの問いに応じたクエリ生成から、データ準備、パターンの抽出、分析結果の共有に至るまで、アナリティクスワークフローのあらゆる局面で導入できます。実際にどの機能を活用するかは、個々のタスク内容や出力結果の用途によって異なります。
自然言語・対話型アナリティクス
自然言語アナリティクスを活用することで、ユーザーは日常のビジネス表現を用いてデータを照会でき、システム側がそれをクエリや分析処理へと自動的に変換します。
シンプルな要求であれば、必要な処理はごく限定的です。たとえば「月別の売上を表示して」というリクエストの場合、事前に定義された売上指標と、適切な時間軸が揃っていれば対応できます。一方、ビジネスの現場における問いの多くは、コンテキストに大きく依存します。たとえば、「エンタープライズの契約更新状況はどうか?」という質問だけでは、分析に必要な条件が具体的に定義されていません。システム側では、どのアカウントをエンタープライズとみなすのか、何を更新として定義するのか、どの指標で実績を測るのか、そしてどの期間を比較対象とするのかを正確に把握しておく必要があります。従来は、アナリスト自身がクエリを作成する前にこうした曖昧さを自ら解消していました。自然言語システムを活用する場合も同様に、システムが処理できる形式でこうしたビジネスコンテキストをあらかじめ整備しておくことが求められます。
さらに、対話型アナリティクスでは、ユーザーとの一連のやり取りを通じて調査を段階的に深掘りしていくことが可能です。たとえば、ユーザーが「最も変化が大きかった地域はどこか?」と質問し、続けて「複数年契約の顧客のみに絞り込むとどうなるか?」と尋ねた場合でも、システムは対象の指標や母集団、直前の分析条件を維持したまま処理を継続します。ここで重要となるのが、ガバナンスが適用されたセマンティックコンテキストの存在です。セマンティックモデルが確実に機能することで、ビジネスユーザーは柔軟な対話形式で探索を進められる一方、アナリティクスチームは基盤となるビジネス定義やリレーションの一貫性を維持できます。
AIによるデータ準備
AIは、生データを実務で使える形へ加工する際に発生する定型作業を軽減します。構造化データに対しては、データ変換処理の提案、異なるデータソース間におけるフィールドのマッピング、欠損値や不整合の検出、分析前のデータ標準化に必要なSQLやコードの自動生成などを支援します。
さらに生成AIの活用により、テーブル形式(行や列)にとどまらない多様な情報もデータパイプラインへ組み込めるようになります。具体的には、ドキュメントからのエンティティや属性の抽出、サポートチケットなどのテキスト分類、非構造化データの一部分をフィールド化して構造化データと統合した分析を可能にします。
ただし、誤った前提やデータの抜け漏れは後続の分析全体へ波及するリスクを伴うため、AIが処理した成果物に対しては、アナリスト自身による継続的な検証が不可欠です。
インサイトの自動抽出
インサイトの自動抽出システムは、データを継続的にスキャンして変化や特異なパターン、異常値を検知し、都度手動でクエリを実行することなく重要な兆候をアラートで通知します。たとえば、数百もの指標を追跡しているプロダクトアナリストに対し、「新アプリのリリース後、Androidユーザーの有料プランへの転換率(CVR)が急減している」といった事象を通知することで、チームは調査すべき具体的な課題に迅速に着手できます。
AIが抽出したインサイトは調査の起点として効果を発揮しますが、要因を特定するプロセスには引き続きアナリストの知見が欠かせません。この点は、AIが分析結果に付随する要約や解説テキストまで生成するケースにおいて、一段と重要性を増します。システムは数値の変動箇所を特定し、仮説として考えられる要因を提示することは可能ですが、提示された根拠がどの結論を正当に裏付けているのかを最終的に見極めるのは、実務担当者やビジネスエキスパートの判断です。
AIによるデータ可視化とAI搭載ダッシュボード
AIを活用したデータ可視化は、実用的なグラフやチャートを作成するプロセスを効率化します。分析のたびに手作業でフィールドやグラフの種類、フィルター条件を指定する代わりに、「製品ごとのサポート問い合わせ件数を比較して」と指示するだけで、AIが最適なビジュアルを提示します。さらに、「エンタープライズ顧客のみに絞り込む」「問い合わせカテゴリ別の内訳に分解する」といった追加の指示を自然言語で重ねることで、柔軟にビジュアルを調整できます。
ただし、システムがデータを正確に表現するグラフ形式を選び、適切なスケールや集約ロジックを用い、データ本来の関係性を歪めて提示しないよう担保するためには、人間による確認と評価が欠かせません。
AI搭載ダッシュボードは、組織内で合意された重要業績評価指標(KPI)や推移トレンドの定常的な可視化と、AIによる直感的な探索機能を融合させたものです。新たなダッシュボード画面の改修や作成をアナリストに依頼することなく、ユーザー自らが数値の変動について自然言語で問いかけたり、別の切り口で内訳を展開したり、特筆すべき動向の要約をその場で取得したりできます。これにより、ダッシュボードが共通の指標を軸とした分析基盤を担保しつつ、AIがその背後にある要因を深掘りするための柔軟な手段を現場のユーザーへ提供します。
レポーティングの自動化
AIを活用したレポーティングでは、算出された指標データと、要約や解説テキストを組み合わせて提示できます。たとえば月次レポートの場合、ガバナンスが確保された共通ロジックから売上、粗利益率、パイプラインなどの各指標を抽出し、生成AIを活用して数値の大きな変動要因に関する考察のドラフトを作成することが可能です。
定例レポートは同一の関係者向けに定期的に作成されるケースが多いため、報告サイクルのたびに解説文を一から書き起こす負担を軽減できます。基盤となる指標データが更新されると、システム側で変動箇所を特定して初動の分析コメントを作成し、レビューや配信に向けた定期レポートの形へまとめます。
AIアナリティクスの仕組み:ガバナンスが確保されたデータとの連携
AIアナリティクスにおける各ワークロードは、データの利用形態がそれぞれ異なります。たとえば、自然言語によるクエリ処理では、ビジネスの問いを正確にSQLなどの処理へ変換するために十分なセマンティックコンテキストが求められます。一方で予測モデルの場合は、過去の実績データや特徴量の定義、評価基準への依存度がより高くなります。また、ドキュメントを対象とする生成AIでは、関連情報の検索や事実に基づいた回答生成(グラウンディング)に関して固有の要件が存在します。
自然言語アナリティクスに求められるビジネスコンテキスト
たとえば「解約の兆候を示している顧客アカウントはどれか」という質問を受けた際、システムはそのリクエストを実行可能なクエリへと変換します。その際システム側には、組織におけるアクティブアカウントの定義や、どのような行動が解約シグナルに該当するのか、どのテーブルに関連データが存在し、それらがどう関連付けられているのか、さらにはどのフィルター条件や対象期間を適用すべきかといった情報が求められます。
セマンティックレイヤーを介してこうした定義やリレーションをあらかじめ明示しておくことで、自然言語によるリクエストに対しても、組織全体で統一された信頼性の高い分析ロジックを適用できます。また、検証済みのクエリや承認されたサンプルを登録しておくことで、頻出の問い合わせに対する精度向上を図ることも可能です。これにより、分析チームは生成されたSQLが意図どおりの結果を返すかどうかを検証できます。
予測分析を左右するデータ、目的変数、評価基準
予測分析において機械学習モデルは、過去の実績データから統計的な相関関係を学習し、そのパターンをもとに将来の予測値、分類結果、スコアなどを算出します。その信頼性は、解決したい課題をどのデータで適切に表現するか、目的変数をどう定義するか、そして予測を誤った際のビジネスインパクトが評価指標に正しく反映されているかといった設計判断に大きく左右されます。
予測分析の領域でもデータアクセス権限、データリネージ、再現性の担保といったガバナンス管理は重要ですが、自然言語クエリのようにセマンティックな指標定義だけでワークロード全体を統制できるわけではありません。
生成AIの回答精度を担保するエビデンス
生成AIでは多くの場合、回答を出力する前の検索プロセスを通じて、関連する参照情報をモデルのコンテキストへ取り込みます。システム側はまず適切なドキュメントや該当箇所を特定したうえで、元の参照情報に含まれない不要な主張を混入させることなく、回答を支える十分なエビデンスをモデルへ渡す設計が求められます。
したがって、出力結果の品質はモデル自体の性能だけで決まるものではありません。検索処理によって最も関連性の高いエビデンスが抽出できているか、重要な前提条件やコンテキストが抜け落ちていないか、そして生成された回答が与えられたソースを忠実に反映しているかを検証することが不可欠です。このようにアプローチを整理することで、分析チームは「システムが適切な情報を検索できたか」と「モデルがその情報を正確に活用できたか」という、ワークフローにおける両方のプロセスを評価できます。
AIシステムへのデータ展開と一貫したガバナンスの維持
どのような分析アプローチを採用する場合であっても、AI導入を機に同一のエンタープライズデータに対して個別のルールを設けるべきではありません。対話型インターフェース経由でのデータ照会、モデルの学習やスコアリングへのデータ活用、あるいはAI搭載アプリケーションへのデータ連携など、いずれの利用形態においても、既存のアクセス権限ポリシー、データ分類、データリネージ、各種ガバナンス統制がそのまま適用される運用が求められます。
具体的な統制手法はワークロードごとに異なるものの、本質的な原則は共通しています。すなわち、組織が従来の分析業務で活用してきたガバナンス基準やビジネスコンテキストと同一の基盤上で稼働させてこそ、AIはその価値を発揮します。
クイックヒント
現場のユーザーが実際に投げかけるビジネスの問いを起点とし、曖昧な専門用語や指標の定義、テーブル間の関連性をシステム側で正しく解釈できるだけの情報がセマンティックレイヤーに整っているかを検証します。
拡張アナリティクスとの違いと人による検証
拡張アナリティクスは、AIアナリティクスと混同されやすい言葉です。AIアナリティクスが分析のあらゆる工程にAIを活用する取り組み全般を指すのに対し、拡張アナリティクスは、アナリストやビジネスユーザーの分析作業をAIで補助・自動化することに焦点を当てた考え方です。
クエリのドラフト作成、データ変換処理の提案、異常パターンの検知、適切なビジュアルの推奨、解説テキストの作成など、かつてアナリストが手作業で対応していた定常タスクにAIが関与する領域は拡大を続けています。こうしたAI主導のワークフローは、AIや機械学習を活用して分析プロセス全体の効率化を図る拡張アナリティクスの枠組みに位置付けられます。
アナリティクスチームにとって実務上の重要な論点は、AIが支援する各ワークフローに対して、どの程度の人間による検証やレビューを介在させるかという点です。
- データ準備:データ変換ロジックや集計粒度の確認が欠かせません。
- クエリ生成:セマンティック定義および生成されたSQLの妥当性検証が不可欠です。
- インサイトの自動抽出:背景となる統計的コンテキストを踏まえた解釈が求められます。
- 解説テキストの生成:要約元のエビデンスとの整合性を担保することが重要です。
このように、拡張アナリティクスは定常的なデータ処理の工数を削減しつつ、前提条件の誤りが意思決定に大きな影響を及ぼす要所には、専門家による判断を的確に介在させます。
よくある落とし穴
検知されたパターンを、そのまま原因や背景の説明と同一視してしまうケースが見受けられます。AIが特定セグメントにおける指標の変動を高精度で検出できたとしても、「なぜその変化が生じたのか」という根本的な要因を突き止めるには、追加の検証や多角的な分析が不可欠です。
複雑な分析を自律化するエージェント型アナリティクス
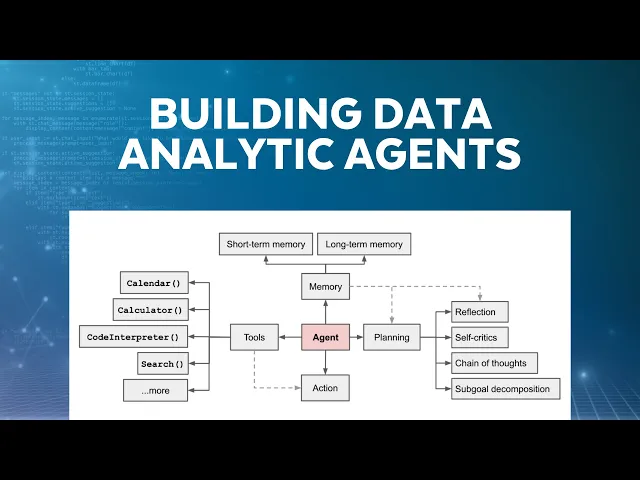
エージェント型アナリティクスは、複数のプロセス、分析ツール、多様なデータタイプ、あるいは分析途中の判断を伴うような高度な調査で役立ちます。エージェントはモデルを通じてユーザーのリクエストを解釈し、認可されたツール群から適切なものを選択して、ステップ間で情報を引き継ぎながら、中間結果に応じて後続の処理を自律的に調整します。
たとえば、顧客の契約更新率の低下を調査しているビジネスユーザーが、「特定地域でどのような変化が生じているか」を尋ねたとします。この場合、エージェントは更新状況やプロダクトの利用ログデータへ照会をかけ、影響を受けているアカウントを過去実績と比較したうえで、関連するサポートチケットや通話記録などのテキスト情報を検索し、それらの結果を統合して想定要因の深掘り調査まで進めます。これにより、ユーザーが個々の分析ステップを手動で設計・実行することなく、構造化データから得られる定量指標と、非構造化データから抽出した定性的な根拠を包括的にまとめた分析結果を取得できます。
エージェントが文脈や状態を保持できる特性は、調査の進め方を根本から変えます。たとえば、最初のクエリ実行によって「製品の利用頻度が落ちている顧客層に契約更新の減少が集中している」と判明した場合、エージェントは都度ゼロから分析をやり直すことなく、その分析結果を保持したまま次の調査ステップへと引き継ぎます。そこから「対象顧客が利用を停止した具体的な機能は何か」、あるいは「同時期にサポートへの問い合わせ傾向に変化はなかったか」といった詳細な追跡調査に移行できます。
また、エージェント型のワークフローは、分析の進捗や判明した事実に応じて柔軟に処理を分岐させることが可能です。従来の固定的なデータパイプラインは常に同一の処理手順をたどりますが、エージェントであれば、プロダクトの定着度に課題が見つかれば関連する利用動向データを掘り下げ、顧客関係性に要因があればアカウント対応履歴を参照し、十分な根拠が得られない段階ではそれ以上の探索を打ち切るといった自律的な判断を下せます。このように、前の分析結果を踏まえて次のアクションを判断していくような探索型の分析業務において、エージェントはとりわけ高い効果を発揮します。
SnowflakeでAIアナリティクスを推進する理由
Snowflakeは、AIアナリティクスのワークフローが必要とするガバナンスの確保されたエンタープライズデータとビジネスコンテキストを、AIの実行基盤と同一環境に統合します。具体的には、セマンティックビューを用いて指標、分析軸、関連性をSnowflake上で直接定義できる一方、Snowflake Horizonカタログがアクセス制御ポリシー、データ分類、データリネージをはじめとする包括的なガバナンス機能を提供します。さらにCortex Agentsは、整備されたセマンティック定義を参照して自然言語の問いを構造化データ用のSQLへと変換し、非構造化データの検索結果や各種外部ツールと組み合わせた高度な分析を実行します。
また、Cortex AI関数を活用することで生成AIの処理をSQL内で直接呼び出すことができ、Snowflake MLは予測モデリングの構築と運用を強力に支援します。加えてSnowflake CoWorkは、Cortex Agentsや連携ツールを組み合わせたマルチステップ分析のための直感的な協業インターフェースを提供します。このように共通基盤上で完結できるため、個別の分析ツールや用途ごとにビジネス定義やガバナンス設定を都度再構築する手間をかけず、あらゆるデータに対してAIを適用することが可能です。
AIに委ねる分析業務の見極め
AIの進化により、アナリティクスチームは組織全体へ迅速にインサイトを届けるための多様なアプローチを手に入れています。ビジネスユーザーはSQLを書くことなく自然言語でデータを照会でき、アナリストはAIが前処理を施したデータや自動検知された異常値を起点に分析を始められ、エージェントは複数のツールやデータソースを横断して自律的に調査を進めることが可能です。
ここで実務上の重要な論点となるのが、各ワークフローのどのプロセスをどこまでAIに委任するかという見極めです。あるステップは人間の介入を最小限に抑えて自動実行できますが、別のステップでは、分析結果を意思決定に反映させる前提として、事前に定義された指標、制限されたツールの利用範囲、あるいは専門家によるレビューが不可欠となります。AIが担う分析業務の領域が広がるなかで、こうした委任の境界線をどこに引くかを設計すること自体が、データ分析の設計そのものにおいて中核的な役割を占めるようになっています。
重要なポイント
AIアナリティクスを活用することで、分析チームは手作業の工数を比例的に増大させることなく、より多様なビジネス上の問い、マルチモーダルなデータタイプ、複雑なマルチステップ調査へと対応範囲を拡張できます。分析ワークフローの多くがAIへ委任されていくにつれ、アナリストや実務担当者が果たすべき役割は、定型的なクエリ作成から、AIシステムが依拠するデータ基盤、ビジネスロジック、そしてガバナンスと検証の基準を精緻に定義することへとシフトしていきます。
よくある質問
AIアナリティクスに関するよくある質問に、Snowflakeのエキスパートが回答します。
AIアナリティクスを始めるには何から取り組むべきですか?
まずは、現場のユーザーが実際に投げかけるビジネスの問いを洗い出し、その問いに正しく答えるために必要な指標の定義やテーブル間の関連性が整っているかを確認することから始めるのが効果的です。AIの出力の信頼性は、参照するデータとビジネス定義の品質に左右されるため、セマンティックレイヤーやデータガバナンスの整備が、導入の前提になります。
AIアナリティクスと従来のデータアナリティクスの違いは何ですか?
AIアナリティクスは、従来のBIや分析基盤を土台としつつ、機械学習(ML)や生成AIをワークフローへ統合することで、分析の進め方とユーザー体験を進化させたものです。AIアナリティクスは、これまでのデータ分析環境を完全に置き換えるものではありません。既存の分析手法やBIダッシュボードと共存しながら、将来予測、クエリ自動生成、非構造化データの解析、インサイトの自動抽出、対話型のデータ探索といった特定プロセスの実行手法を変革します。
AIアナリティクスを導入してもデータアナリストは必要ですか?
はい、引き続きデータアナリストの存在は不可欠です。AIは、定型的なクエリの生成や初動の要約作成、頻出する定常的な問い合わせへの対応など、反復的な分析作業の工数を削減します。一方で、曖昧なビジネス課題の構造化、評価指標の厳密な定義と妥当性検証、予期しない異常値の要因特定、代替仮説の検証、そしてエビデンスが意思決定を正しく裏付けているかの最終判断は、依然としてデータアナリストが担うべき領域です。
自然言語を活用したセルフサービス分析が全社的に広がるほど、AIシステムが参照するビジネスコンテキストの整備や、組織全体の分析品質を維持するアナリストの役割は一段と重要性を増します。
AIアナリティクスと拡張アナリティクスの違いは何ですか?
AIアナリティクスは、機械学習、生成AI、エージェント型AIなどを、分析のあらゆる工程に活用する取り組み全般を指します。一方、拡張アナリティクスは、クエリの作成、異常の検知、可視化の提案など、アナリストやビジネスユーザーの分析作業をAIで補助・自動化することに焦点を当てた考え方で、AIアナリティクスの一部と位置付けられます。
AIアナリティクスは非構造化データも扱えますか?
はい、扱えます。テキスト、ドキュメント、画像、音声、動画などの非構造化データも直接分析対象として活用できます。生成AIやマルチモーダルAIの活用により、従来のリレーショナルデータベースでは扱いにくかった多様な非構造化コンテンツから、重要情報の抽出、分類、要約といった分析処理を柔軟に実行できます。
さらに、抽出・構造化したそれらのデータを、顧客データ、購買トランザクションログ、製品マスターといった既存の構造化テーブルと結合して分析することが可能です。たとえば、「解約リスクの高い顧客セグメントの特定(構造化データ)」と「直近のサポート問い合わせ内容や営業商談メモの傾向分析(非構造化データ)」を組み合わせることで、多角的かつ解像度の高いインサイトを導き出せます。
予測分析と処方的分析の違いは何ですか?
予測分析が「将来何が起こり得るか」を算出するのに対し、処方的分析は「目的達成のために次にどのような行動を取るべきか」を具体的に提示します。たとえば、将来の製品需要を推計するのは予測分析に該当します。一方、その需要予測値に加えて現在の在庫状況、サプライヤーのリードタイム、調達コストなどを総合的に勘案し、最適な発注数量を算出して推奨するアプローチが処方的分析にあたります。
アナリティクス関連リソース
アナリティクスに関するトピック
アナリティクスのあらゆる側面を深く掘り下げます。
ビジネスインテリジェンス戦略
データ・テクノロジー・プロセス・人材リソースを連携させ、組織がBIを収集・管理・活用する方法を最適化することで、戦略的目標の達成と情報に基づく意思決定の推進を実現します。
