
ストリーミング分析とは:仕組み・活用例・必要性の見極め方
ストリーミング分析とは、IoTセンサーや決済、Webアクセスなどから継続的に発生するデータをストリーミングで取り込み、必要に応じて転送中(移動中)に処理したうえで、低レイテンシーで結果を届ける分析手法です。ただし、すべてのリアルタイムワークロードにストリーミング分析が必要なわけではありません。本ガイドでは、仕組みやリアルタイム分析との違いから、導入すべきケースの見極め方まで解説します。
ストリーミング分析の定義
ストリーミング分析はリアルタイム分析の一部であり、データを継続的に取り込み、データ提供を担うサービングレイヤーに格納される前に必要に応じて転送中に処理します。ストリーミング取り込み、ストリーム処理、低レイテンシーなデータ配信を組み合わせることで、新しいイベントの到着に合わせて結果を更新できます。他のリアルタイム分析パターンよりも、データの鮮度や処理に関してより厳格な要件が伴います。
リアルタイム分析の要件は、5秒、30秒、あるいは1分といったレイテンシーの目標値から検討されることが多くあります。しかし、結果がどれほど迅速に届く必要があるかを把握しているだけでは、ストリーミング分析が必要かどうかは判断できません。
ユーザーにとって最新に見えるダッシュボードの裏側では、転送中のイベントを継続的に変換するストリーム処理が稼働している場合もあれば、直近にロードされたデータに対する高速なクエリが実行されている場合もあります。後者で要件を満たせるのであれば、ストリーミング分析の複雑さや、それに伴うアーキテクチャへの高い要求を進んで引き受ける理由はありません。
この判断を的確に行うには、次の3つの問いに答えることが有効です。
- 結果の価値が損なわれるまでに、どれだけの時間的猶予があるか
- データを活用できるようにするために、変換やエンリッチメント(情報の付加)が必要か
- その変換は転送中のイベントに対して継続的に行う必要があるか、それともデータが格納された後でも問題ないか
1つ目の問いへの答えによって、データの鮮度に関する目標が明確になります。2つ目と3つ目の問いへの答えからは、ストリーミング分析の技術構成のうち実際にどこまでの構成が必要かを判断できます。これには、ストリーミング取り込み単体で十分なケースから、ストリーミング取り込みに加えてストリーム処理まで必要となるケースまでが含まれます。
ストリーミング分析とは:ストリーミング取り込みとストリーム処理
ストリーミング分析とは、意思決定やアクションにつなげるために、データを継続的に取り込み、サービングレイヤーへ可能な限り迅速に届くよう、必要に応じて転送中に処理を行う一連の手法です。ストリーミング分析のワークロードによっては、新しいイベントが取り込まれる際にシステム側で状態を保持し、結果を更新し続ける処理(ストリーム処理)が求められる場合もあります。一方で、データを迅速にクエリできるサービングレイヤーに対し、高速かつ信頼性の高い取り込みを行うだけで十分なケースもあります。
ストリーミング分析は、より広範なイベントドリブンなアーキテクチャの一部に位置づけられるため、どのコンポーネントがどの役割を担っているのかを正確に把握しておくことが重要です。
ストリーミング取り込み(ストリーミングインジェスト)は、イベントが分析環境に入るための経路となります。Kafkaなどのプラットフォームが生成元と利用先の間でタイムスタンプ付きのイベントを転送する一方、直接書き込みAPIや変更データキャプチャ(CDC)が基幹・業務システムからデータを取り込みます。ここでは、確実かつ迅速にデータを届けることに重点が置かれます。
ストリーム処理は、その計算やデータ加工を担う層です。Apache FlinkやSpark Structured Streamingなどのエンジンが、そうしたデータストリームに対するウィンドウ集計、状態を保持した結合(ステートフル結合)、フィルタリング、情報の付加を実行する仕組みを提供します。
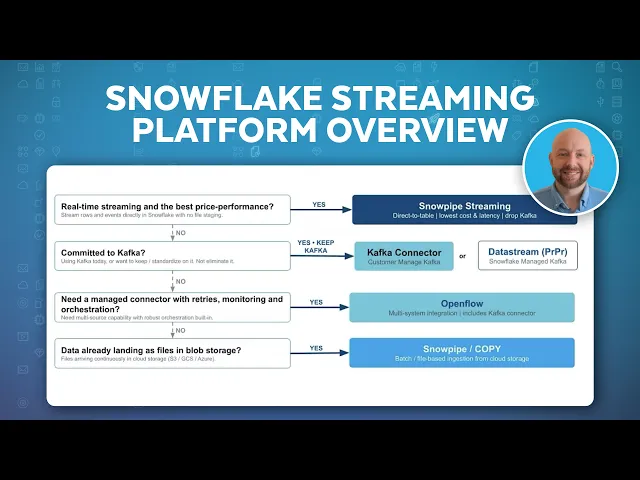
大量の継続的なデータをストリーミングしてほぼリアルタイムのインサイトを獲得できる、Snowpipe Streamingの概要を動画でご覧ください。
ストリーミング分析とリアルタイム分析の違い
ストリーミング分析とリアルタイム分析はひとまとめに語られがちですが、両者は同じものではありません。
リアルタイム分析は、より包括的な概念を指す総称です。定められた時間枠の中で意思決定やアクションにつなげられるよう、データや結果に十分な鮮度があり、クエリが十分に高速であることが求められます。その鮮度は、ストリーミング取り込み、マイクロバッチでのロード、CDCによるレプリケーション、あるいはそれらの組み合わせによって実現され、通常、クエリは最新のデータと過去の履歴データを組み合わせて実行されます。
ストリーミング分析は、リアルタイム分析の一部です。サービングレイヤーへ到達する前に、データをどのように処理すべきかについて、より厳格な要件が伴います。具体的には、到着したイベントをその都度処理し、多くの場合、一連のイベントや時間枠、その発生順序(シーケンス)全体で状態を保持するという、より明確な処理モデルが適用されます。蓄積された保存データではなく、転送中のデータに対して処理が行われるため、データの鮮度や変換に関する要件はさらに厳しくなります。
たとえば、5秒前にロードされたデータに対してインタラクティブクエリ(画面操作に応じて実行される検索・集計)を実行し、1秒未満で結果が返ってくるケースを考えてみます。ビジネス側で求められるデータの鮮度が10秒以内であれば、このアーキテクチャでもリアルタイム要件を十分に満たせます。常時稼働するストリーミングクエリを用意する必要はありません。
今度は、逆のケースを考えてみます。パイプラインが集計値を継続的に更新しているものの、それを表示するダッシュボードは1時間に1回しか確認されないとします。処理自体はストリーミングで行われていても、それによって得られる鮮度の高さから組織が享受できる価値はごくわずかです。
ストリーミング分析がリアルタイム分析と並列の関係にあるのではなく、より包括的なリアルタイム分析という枠組みの一部に位置づけられるのは、まさにこうした理由によります。ストリーム処理は、リアルタイム分析で求められる鮮度を実現する一手段にすぎず、唯一の方法ではありません。また、状態管理やイベントの順序保証、配信保証といった面で設計の複雑さが増す要因にもなります。
この違いは、実際に構築すべきアーキテクチャの内容に直接影響します。鮮度に関する要件は、データが利用可能になるまでの早さや、クエリの応答速度に対する制約を定めます。一方でストリーム処理の要件とは、分析結果に影響を与える状態や順序、タイミングの整合性を含め、流れ続けるイベントストリームを処理基盤そのものが常に把握し続けなければならないことを意味します。
ワークロードによっては、新しくロードされたデータに対して定期的にクエリを実行するだけで十分な場合もあります。一方で、イベントの発生順序や移動時間枠、ストリームの進行に伴って蓄積される状態に依存するワークロードも存在します。

ストリーム処理の結果を正しく読むための3つの概念
アーキテクチャにストリーム処理を取り入れる際、設計思想における最も大きな変化の1つとなるのが、データの入力が完了する自然な区切りが存在しないという点です。
たとえば先週の売上テーブルに対してクエリを実行する場合、集計の対象範囲は明確であり、どのレコードを計算に含めるべきかも一目瞭然です。しかし、流れ続けるデータストリームを扱う場合は、どのイベントを計算に含めるか、遅延して到着するデータをどの程度待機するか、あるいはイベントの再試行によって重複配信が発生した際にどう対処するかといった境界条件を、自ら明示的に定義しなければなりません。
ウィンドウ(時間枠)の種類:タンブリング・スライディング・セッション
ストリーム処理では多くの場合、絶え間なく流れるデータストリームを分析可能な単位に区切る仕組みが必要となります。その役割を果たすのがウィンドウ(時間枠)です。
- タンブリングウィンドウ(固定時間枠)は、重複のない一定の期間ごとにデータを区切ります。たとえば、10:00から10:05までのトランザクション量を計算し、続いて10:05から10:10までの新しい枠で計算を開始するといった形です。
- スライディングウィンドウ(スライド時間枠)は、対象期間が一部重複します。たとえば「直近10分間のトランザクション」を1分ごとに再計算したい場合、新しく作成される時間枠には直前の枠に含まれていたイベントの一部が引き継がれます。
- 一方、セッションウィンドウは仕組みが異なり、時計の決まった時間で区切るのではなく、一連のアクティビティの継続期間に応じてイベントをまとめます。
つまり、「1,240件のトランザクション」といったストリーミングで算出された数値は、それ単体では意味をなしません。そのトランザクションがどの期間やセッションで発生したものなのかという文脈を把握して、初めて成立します。
イベント時刻と処理時刻のずれとウォーターマーク
イベント時刻とは、トランザクションなどの事象が実際に発生した時刻です。一方、処理時刻とは、分析システムがそのデータを処理した時刻を指します。この2つのタイムスタンプには、ずれが生じることが珍しくありません。
たとえば、10:04:58に発生したトランザクションが、ネットワークの遅延や上流システムでの再試行などによって、分析パイプラインに到達したのが10:06だったと仮定します。イベント時刻を基準にすると、このトランザクションは本来10:00〜10:05の時間枠に含まれます。しかし処理時刻を基準にした場合、その時間枠の集計はすでに締め切られています。
こうしたずれに対応するために不可欠となるのが、ウォーターマーク(到着遅延の許容基準)や遅延データの処理ルールです。ウォーターマークとは、イベント時刻がどこまで進行したかをシステムが推測した指標であり、特定の時間枠の計算結果を出力してよいかを判断するために用いられます。一方、遅延ルールは、その締め切り以降に到着したイベントをどのように扱うかを定めます。待機時間を長く設定すれば、遅れて届いたデータ(遅延データ)をより多く拾い上げられますが、結果の確定は遅くなります。逆に、時間枠を早く締め切れば、より鮮度の高い結果を得られる反面、遅延データによって結果の再更新や個別処理が必要になる可能性が高くなります。
Snowflakeのインタラクティブ分析担当プリンシパルプロダクトマネージャーであるWill Xuは、この許容範囲をビジネス上の意思決定そのものに基づいて設定することを推奨しています。「各チームは、対象のワークロードにおいて遅延データの到着を許容できる最大のウィンドウを決める必要があります。一般的には、この時間枠は4時間程度に設定されます。許容する時間枠を広げるほど、インフラストラクチャのコストは増加します。これは設計の初期段階で判断しておくべき、ビジネス上の意思決定です」
配信保証:At-least-onceとExactly-once
分析結果に不確実性をもたらす要因は、データの遅延到着だけではありません。処理の再試行もまた、大きな要因の1つです。分散システムはその性質上、ネットワークの切断やプロセスの再起動、データの再送信が避けられません。その結果、一見すると些細に思える疑問が、分析結果の正確性に重大な影響を及ぼすことになります。それは、「このイベントは、すでに処理済みだろうか?」という疑問です。
At-least-once(最低1回)配信では、データの欠落を防ぐことが最優先されるため、利用先が同じイベントを重複して受信する可能性があります。そのため、後続の処理側で重複を許容する設計が不可欠となり、一般的には、何度繰り返し実行しても結果が変わらない「べき等(べきとう)な操作」によって対処します。
一方、Exactly-once(厳密に1回)配信は、再試行が発生した場合でも、各イベントが最終的な結果に1回分だけ正しく反映される状態を目指すものです。これを実現するには、通常、イベントの生成、処理、保存を担うシステム全体で密接な連携を行う必要があります。
分析結果を確認する側の視点に立てば、こうしたインフラストラクチャの複雑な仕組みは、すべて画面上に表示される1つの数値に集約されます。しかし、その数値がどのような前提や保証に基づいて算出されたのかを、データパイプラインのブラックボックスにしておくべきではありません。ストリーミングによって得られた指標をもとにビジネス上の判断を下すのであれば、どの時間枠で集計されたのか、遅れて届いたデータはどのように処理されたのか、そしてどのような配信保証に基づいているのかを、各チームが正確に把握しておく必要があります。
さらに、後からデータのずれを突き合わせて修正するための照合ルールも欠かせません。10:05の時点で参照したストリーム処理の数値(速報値)は、遅れて届いたデータがシステムへ反映された後に実行されるバッチ処理の結果(確定値)と異なる場合があります。どちらの数値を信頼できる唯一の情報源(SSoT)として扱うのか、また生じた差異をどのように突き合わせて修正するのかを、あらかじめ定めておく必要があります。
クイックヒント
指標を定義する際は、対象の時間枠(ウィンドウ)、遅延データの処理ルール、そして適用されている配信保証をセットでドキュメント化しておくことが重要です。その数値にどの範囲のデータが含まれており、後からどのような変動が生じ得るのかをデータ利用者が把握できていれば、ストリーミングで算出された数値に対する信頼性は大きく向上します。
ストリーミング分析の活用例と投資が見合うケース
一部のワークロードでは、極めて短い時間枠の中での迅速な意思決定が不可欠となります。たとえば、決済時の不正検知または承認、Web広告のリアルタイム入札、特定の産業機器制御システムなどでは、ミリ秒単位での即応が求められます。こうした場合、トランザクションの処理時間内に判断を下せるよう、判定処理はアプリケーションやストリーム処理の経路に直接組み込まれるのが一般的です。
しかし、企業における一般的なアナリティクスユースケースの大半は、ここまでの厳しい制約を必要としていません。転送中のデータに対して常時処理を行い続けなくても、ニアリアルタイム分析で十分に対応できるケースが多くを占めます。たとえば運用チームであれば、担当者が現場で介入できるよう、未処理案件の滞留を数分以内に把握したい場合があります。あるいは物流業務であれば、配送ルートの変更が間に合う段階で配送トラブルを検知する必要があるかもしれません。また自動化プロセスにおいても、次のアクションを判断する手前で直近の稼働状況データが求められるケースがあります。こうした場面では、数秒から数分単位のデータ鮮度が、現場の業務において具体的かつ実用的な価値を生み出します。
ストリーミング分析の代表的なユースケース
業界別に見ると、金融では不正送金やクレジットカードの不正利用をリアルタイムに検知する用途、IoT・製造業では工場設備のセンサーデータを監視して故障の予兆を捉える予知保全、Web・マーケティングではユーザーの行動イベントを即時に集計してレコメンドや配信内容を最適化する用途が代表的です。
定期処理やマイクロバッチ処理で十分なケース
バッチ処理が今日に至るまで広く使われ続けているのには、相応の理由があります。あらかじめ定めた間隔で、範囲が明確に区切られたデータセットを対象に実行されるため、万が一障害やトラブルが発生した際にも、原因の調査、再実行、テストを行う処理単位が極めて明確です。
マイクロバッチ処理はこの実行間隔を短縮し、数秒から数分ごとにまとまった単位でデータを処理する手法です。ワークロードの特性によっては、このアプローチだけで業務上求められるデータ鮮度を十分に満たせることが少なくありません。
たとえば物流ダッシュボードにおいて、5分ごとの画面更新で業務要件を十分に満たせるのであれば、到着するイベントごとにリアルタイムで状態を保持し続けたとしても、意思決定の質が向上するとは限りません。この場合は、ニアリアルタイム分析を採用する方が適しています。しかし、一連の事象が起きているまさにその最中に発生順序を検知しなければならない場合や、5分待つことで現場の対応が間に合わなくなる場合には、ストリーム処理を導入する明確な理由となります。
そのため多くのチームでは、パイプラインの全工程を無理に1つの処理モデルへ揃えるのではなく、バッチ処理とストリーム処理を適材適所で組み合わせて運用しています。
低レイテンシー化のコストと要件別の処理方式
バッチとストリーミングの使い分けを取り入れることで、費用対効果のより実用的な判断基準が得られます。一般に、レイテンシー(処理の遅延時間)を短縮しようとするほど、処理の実行頻度を高め、運用の許容基準をより厳しく保つ必要があります。その結果、ワークロードに求められる監視、障害対応、データの突き合わせの手間に加え、コンピュートコストも増加しやすくなります。そうした継続的な運用コストと、データがより早く届くことで、意思決定の成果が実際にどれだけ向上するのかというビジネス価値とを、天秤にかけて比較検討することが重要です。
要件の違いによって求められるアプローチがどう変わるのか、具体的な例を見てみます。
- 不正利用の検知と承認(ミリ秒単位):トランザクションの処理時間内、あるいはストリーム処理の経路内に判定ロジックを直接組み込み、ミリ秒単位で判断を下します。
- 運用上の異常検知(数秒〜数分単位):現場の担当者や自動化ワークフローが対応に要する猶予時間に応じて、数秒から数分単位の鮮度で検知を行います。
- 在庫および受発注や配送の監視(数分単位):多くの場合、数分単位の更新で十分であり、差分データのみを処理する増分処理や短い間隔のマイクロバッチで要件を満たせます。
- 経営陣・役員向けレポート(1時間単位〜日次):後続の別業務でより早いデータ更新が求められない限り、通常は1時間単位または日次での集計で対応可能です。
よくある落とし穴
典型的な失敗例として挙げられるのが、ストリーミング分析を行うすべてのワークロードに、ストリーム処理基盤が不可欠だと思い込んでしまうことです。実際には、多くのワークロードで求められているのはストリーミング取り込みと高速なクエリ実行レイヤーだけであり、時間枠(ウィンドウ)の設計も、状態管理も、遅延許容の基準(ウォーターマーク)も必要ありません。ストリーム処理を追加すべきなのは、データが転送されているその最中に、加工や変換、情報の付加、重複排除を行う必要があるケースに限られます。取り込んだ生データがそのまますぐに分析クエリを実行できる状態であれば、無理にストリーム処理を挟む必要はありません。
Snowflakeで実現するストリーミング分析
Snowflakeは、データの取り込み、ストリーム処理、そして低レイテンシーでのデータ活用まで、ストリーミング分析の一連のプロセスを、ガバナンスの効いた単一のプラットフォーム上でサポートします。そのため、個別のストリーミングインフラ環境を別途構築する必要がありません。
Snowflakeにおけるストリーミング分析のプロセスは大きく3つの段階に分かれており、それぞれに特化した機能が用意されています。
ストリーミング取り込みでは、イベントデータが発生すると同時に、直接Snowflake内へ取り込みます。一時保存用のステージングファイルや中間のクラウドストレージを介在させる必要がありません。これには、Snowpipe StreamingによるAPI経由の直接取り込みやSnowflake Kafkaコネクタ、さらには基幹・業務データベースからの変更データキャプチャ(CDC)などが含まれます。
ストリーム処理では、データがエンドユーザーや外部システムからサービングレイヤーに到達する前の、転送・移動中の段階で、データの加工や変換、情報の付加、構造の整形を行います。具体的には、重複データの排除、マスタ情報(ディメンションテーブル)との結合、時間枠ごとの集計、さらにはCDC処理などが含まれます。これらは従来、Apache Flinkのような外部の独立したストリーム処理エンジンを別途導入しなければ実現できなかった処理です。
低レイテンシーでのデータ配信により、処理されたデータを、業務ワークロードで求められるスピードでクエリ・参照できるようにします。特にインタラクティブ分析の領域では、1秒未満の応答速度と、多数のユーザーやシステムからの同時アクセスに耐えうるクエリ処理を強力に支援します。
これら3つのプロセス(取り込み・処理・配信)はすべてSnowflake内部で直接実行されるため、取り込まれたすべてのデータ行に対して、すでにプラットフォーム側で設定されているデータガバナンス、アクセス権限管理、およびデータリネージが自動的に適用されます。安全性を確保したりデータのずれを突き合わせたりするために、個別のストリーミング基盤を維持する必要はありません。
ストリーミングは要件に応じて選ぶ設計上の選択肢
リアルタイム分析の導入が検討され始めると、継続的なデータ取り込み、転送中のデータ処理、専用インフラの構築といった本格的なストリーミング分析へ飛びついてしまいがちです。しかし、リアルタイム分析とはあくまで上位概念であり、ストリーミング分析はその実現手段の1つにすぎません。実際のところ、多くのリアルタイム要件は、転送中のデータを処理する複雑なアーキテクチャを一切導入しなくても、高頻度で更新されるデータに対して高速なクエリを実行するだけで十分に対応できます。
まずは、対象のワークロードで求められている要件の整理から着手します。具体的には、「データにどの程度の鮮度が求められるのか」「活用する手前で加工や変換が必要なのか」、そして「その変換はデータが転送されている最中に行わなければならないのか」といった点を見極めることが重要です。これらの問いに対する答えをもとに、ストリーミング分析のどの要素をアーキテクチャに組み込むべきかを判断します。そうすることで、ストリーミング本来のパフォーマンスを必要な箇所で享受しながら、運用管理やデータ照合にかかる工数や可動パーツを抑えることができます。
重要なポイント
テクノロジーありきではなく、まずは業務ワークロードの要件から出発しましょう。データに求められる鮮度はどの程度か、転送中の加工や変換が本当に不可欠か、そしてデータを利用するアプリケーションやユーザーが必要とするクエリ応答速度はどれくらいかを定義します。その上で導き出された要件を満たすために必要なストリーミング分析スタックの要素だけを導入します。
よくある質問
ストリーミング分析に関するよくある質問に、Snowflakeのエキスパートが回答します。
ストリーミングデータとは何ですか?
ストリーミングデータとは、IoTセンサー、決済システム、Webサイトのアクセスログ、アプリケーションのイベントなどから途切れることなく継続的に生成されるデータです。一定間隔でまとめて処理するバッチデータとは異なり、発生した順に1件ずつ、または小さな単位で次々と届くのが特徴です。ストリーミング分析は、こうしたデータを到着に合わせて取り込み、低レイテンシーで分析結果を届けます。
ストリーミング分析とリアルタイム分析は同じものですか?
いいえ、同じではありません。ストリーミング分析は、リアルタイム分析という大きな枠組みの中に含まれる一部の手法です。
リアルタイム分析とは、迅速な意思決定や即座のアクションを行うために、データや分析結果が十分な鮮度を保っている状態全般を指す総称です。そのデータ鮮度は、ストリーミングによる取り込みだけでなく、マイクロバッチ処理や、それらを組み合わせたハイブリッドな手法によっても実現できます。これに対してストリーミング分析は、発生したデータを継続的に取り込み、サービングレイヤーに格納される前の転送中の段階で必要に応じて加工や変換を行い、低レイテンシーなクエリを可能にする具体的な手法を指します。
ストリーミング分析はどのような場面で活用されていますか?
代表的なのは、決済の不正検知や承認、Web広告のリアルタイム入札など、ミリ秒から秒単位の判断が求められる場面です。製造業では設備のセンサーデータを監視して故障の予兆を検知する予知保全に、ECやメディアでは閲覧行動に応じたレコメンドに活用されています。いずれも、データが届いてから判断するまでの猶予が短く、転送中のデータを処理する必要があるケースです。
バッチ処理ではなくストリーミング分析を採用すべきなのはどのようなケースですか?
数秒単位のデータ鮮度が求められる場合や、データが格納される前の転送中に加工や変換、重複排除を行う必要がある場合に、ストリーミング分析を採用すべきです。一方で、定期的な更新やマイクロバッチでも業務上の意思決定に間に合うのであれば、ニアリアルタイム分析を選択する方がシステム構成をシンプルに保ち、インフラおよび運用コストを大幅に抑えることができます。
ストリーミング分析にはどのようなツールが使われますか?
ストリーミング取り込みにはApache KafkaやAmazon Kinesis、ストリーム処理にはApache FlinkやSpark Structured Streamingなどが広く使われています。Snowflakeでは、Snowpipe StreamingやKafkaコネクタによる取り込み、動的テーブルによる増分処理、インタラクティブ分析による低レイテンシーのクエリまでを単一のプラットフォーム上で実行できるため、個別のストリーミング基盤を組み合わせる必要がありません。
アナリティクス関連リソース
アナリティクスに関するトピック
アナリティクスのあらゆる側面を深く掘り下げます。
