基礎ガイド
アナリティクスとは:データを意思決定に活かす仕組みと4つの分類
アナリティクスとは、データを体系的に活用してパフォーマンスを把握し、変化の要因を究明し、将来の結果を予測したうえで、意思決定を最適化するプロセスです。今日のアナリティクスは、ダッシュボードやレポートの枠を超え、予測モデル、リアルタイム処理、さらには自然言語でデータに問いかける対話型インターフェースにまで広がっています。本ガイドでは、4つの分類からAI分析まで体系的に解説します。
アナリティクスの定義
アナリティクスとは、パフォーマンスの可視化や変化要因の分析、将来結果の予測、そしてビジネスにおける意思決定の最適化を目的とした、データの体系的な活用を指します。
アナリティクスは以前から、組織の意思決定を支える根拠として活用されてきました。近年はAIの普及を背景に、ビジネスを前進させるうえでアナリティクスが果たす役割はますます大きくなっています。
今日のアナリティクスは、従来のダッシュボードや定期レポートの枠組みを大きく超えて進化を遂げました。現在では、予測モデルやリアルタイム分析に加え、自然言語でデータに問いかけられる対話型インターフェースなども活用可能になっています。
企業はすでにこうした先進機能を実務に取り入れています。実際、Snowflakeが協賛した2026年Omdia社の調査によると、データアナリティクスチームの59%がすでに生成AIを活用していると回答しています。その一方で、回答者の96%は生成AIの実用化において依然として深刻な課題に直面していると回答しました。
この2つの数字のギャップは、現代のアナリティクスに関する重要な事実を物語っています。データを扱う新たな手法はインサイトの取得を迅速化、かつ民主化しますが、それによって強固なデータ基盤の必要性が薄れるわけではありません。信頼性の高い回答を得るには、データの信頼性、ビジネス定義の一貫性、データ更新のリアルタイム性、そして意思決定の目的に応じた最適な分析アプローチが引き続き不可欠です。
アナリティクスの活用範囲が広がり続ける中、多様な分析ワークロードから実用的なインサイトを導き出すには、ツールを共有データ、ビジネスコンテキスト、そしてデータガバナンスへとしっかりと統合することが重要課題となっています。
アナリティクスとは
アナリティクス(Analytics)とは、データを活用してパフォーマンスを測定し、変化の要因を究明し、将来の結果を予測したうえで、最適な意思決定へと導くプロセスです。英語では分析論、解析論と訳されます。これには、データの準備やモデリング、各種分析手法の適用、そしてレポートやダッシュボード、アプリケーションといったインターフェースを介した分析結果の提供など、一連の継続的な運用作業が含まれます。
最適な分析アプローチは、何を明らかにしたいのか、そしてどれほど迅速に判断が求められているかによって異なります。たとえば、記述的分析や診断的分析は、過去のパフォーマンスの把握や変化が生じた原因の調査に有効です。一方、予測的分析や処方的分析は、将来の結果を予測し、選択可能なアクションの影響度を評価するのに役立ちます。ビジネスインテリジェンス(BI)は、定義済みの指標を継続的にモニタリング、探索する手段を提供するのに対し、リアルタイム分析は、より高いデータ即時性が求められる意思決定を支えます。
ビジネス上の問いを、AIを活用したアナリティクスインターフェースで探索するケースが増えています。自然言語によるクエリ、自動生成される説明、対話形式でのフォローアップにより、ユーザーはより簡単かつ柔軟に分析を進められます。
チームはさまざまなアナリティクスのアプローチを活用して、パフォーマンスの推移を追跡し、状況の変化に応じて新たな問いを調査し、その結果を業務上および戦略上の意思決定に活かしています。
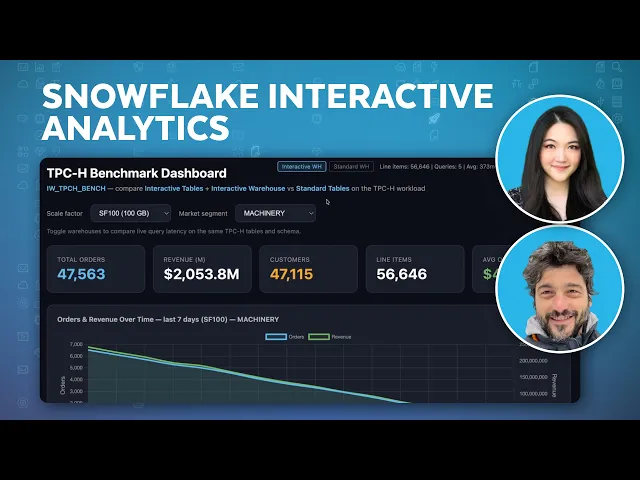
Snowflakeインタラクティブアナリティクスが、API、アプリ、AIエージェント向けのリアルタイムアナリティクスをどのように実現するのか、ライブデモでご覧ください。
アナリティクスとデータ分析の違い
アナリティクスとデータ分析という言葉はほぼ同義で使われることが多く、実務者の間でも明確な線引きがなされているわけではありません。しかし一般的には、データ分析が特定の個別作業を指すのに対し、アナリティクスはその作業を組織全体で継続的かつ一貫して実行できるようにする、より広範な仕組みや組織能力を意味します。
- データ分析とは、特定の問いに回答するためにデータを詳細に調べる作業そのものを指します。たとえば、アナリストが前四半期に顧客離反が増加した要因を分析したり、施策ごとのコンバージョン率を比較したり、最も利益率が低下した製品を特定したりする行為がこれに当たります。
- 一方のアナリティクスには、そうした分析作業を再現可能かつ持続可能なものにするためのシステム、プロセス、そして運用プラクティス全体が含まれます。具体的には、情報を供給するデータパイプライン、集計の一貫性を保つ指標の定義、課題を究明するための分析手法、ユーザーが結果にアクセスするためのツール群、そしてこれらを長期にわたって運用するために必要なデータガバナンスまでが含まれます。
レポーティングは、特にビジネスインテリジェンス領域においてアナリティクスと重なる部分があります。ただし、レポーティングの主な目的は定義済みの指標や実績データを提示することにあります。一方のアナリティクスは、そこからさらに一歩踏み込み、原因の究明、事象の解釈、将来の予測、そして意思決定の支援までを包括的にカバーします。実際の運用においては、ダッシュボード上に分析機能が組み込まれていたり、アナリティクスのワークフローの成果物としてレポートや可視化画面が作成されたりするように、両者は密接に連携しています。
アナリティクスの4つの分類:記述的・診断的・予測的・処方的

一般的によく使われるフレームワークでは、分析の目的に応じて、アナリティクスを4つの分類に整理しています。
- 記述的分析(Descriptive Analytics)は、過去に生じた事実や現象を集約する手法です。売上レポート、Webサイトのトラフィック推移、在庫水準、過去の顧客アクティビティ履歴などがこの分類に該当します。
- 診断的分析(Diagnostic Analytics)は、観察された結果に対して、なぜそれが起きたのかという要因や背景を究明する手法です。たとえば、売上の低下が確認された際、アナリストは地域、製品、顧客コホートごとにデータをセグメントし、どの部分で変化が生じたのか、何が主な要因であったのかを特定します。
- 予測的分析(Predictive Analytics)は、過去の履歴データに統計手法や機械学習を組み合わせることで、将来の需要、離反リスク、機器の障害発生といった事象を予測する手法です。
- 処方的分析(Prescriptive Analytics)は、事業目標や制約条件、予想される影響度を踏まえたうえで、取るべき最適なアクションを評価する手法です。このプロセスでは、最適化モデルやシミュレーション、意思決定ルールなどが活用されます。
これら4つの分類すべてにおいて、信頼性の高いデータと一貫したビジネス定義の確立が、確かな分析を行うための前提基盤となります。
アナリティクスの仕組み:ワークフローの5つのステージ
アナリティクスは、ユーザーがBIツールを立ち上げたりSQLクエリを記述したりする前の段階から始まっています。最初に行うべき重要タスクは、どのような課題に回答を出す必要があるのか、そしてその答えがビジネスの意思決定にどう影響を与えるのかを定義することです。
実務におけるワークフローは、通常、相互に連携する以下の5つのステージで構成されます。
- 目的の明確化:分析によって支援すべき課題、意思決定、または目指すべき成果を定義します。たとえば、「なぜ売上が減少しているのか?」という抽象的な問いは、「特定の市場における前年比の売上減少は、販売個数の低下、価格改定、それともプロダクトミックスの変化のどれに起因しているのか?」という具体的な検証課題へと落とし込まれます。この目的の設定によって、参照すべきデータ範囲、必要とされるデータの鮮度、そして意思決定において許容される不確実性が決定されます。
- 関連データの収集:分析の目的に応じて、必要な情報には構造化テーブル、半構造化データ(JSONなど)、あるいはドキュメントやサポートの対話ログといった非構造化データが含まれる場合があります。また、採用するデータソースによって、データの更新頻度、完全性、そしてアクセス制御の要件も変わってきます。
- データの準備と前処理:収集したデータソースは、クレンジング、データ変換、結合、妥当性検証といったデータ処理プロセスを経て、分析可能な形式へと整えられます。この段階では、各カラムにアナリストが意図しているデータ値が正しく入っているかを事前に検証しておくことも不可欠です。
- 分析と結果の解釈:アナリストは、クエリ実行、統計解析、データの可視化、モデル構築などの分析手法を適用し、得られた結果をビジネスの文脈に照らして解釈します。この際、定義や抽出対象の母集団、前提条件が曖昧なままだと、たとえ計算結果自体は数学的に正しくとも、誤った解釈に陥るリスクが生じます。
- 分析結果のアクション・意思決定への紐付け:分析の目的には、目の前の運用上の判断に活用されるものもあれば、中長期の計画立案、仮説の精緻化、あるいは特定の選択肢の絞り込みに貢献するものもあります。いずれにせよ、分析結果は単なる出力にとどまらず、実際のビジネスアクションへと確実につながる出口を持っていなければなりません。
実際の分析作業は、一方通行ではなく、これらのステージを何度もループしながら進んでいくのが一般的です。予想外の分析結果が得られれば、アナリストはソースデータに立ち戻って再確認したり、指標の定義を見直したり、あるいはより焦点を絞った問いへと再設定したりします。そして、新たな意思決定によって新たなデータが生成され、それが次の分析サイクルの入力データとなっていくのです。
Snowflakeのアナリティクス担当プロダクトマネジメント責任者であるJosh Klahrは、次のように述べています。「最終的にアナリティクスがもたらす価値とは、意思決定のスピードの向上と、組織全体のアライメントが確保されることに集約されます。その価値が真に発揮されているかどうかの試金石は、部門横断のチームが『誰のデータが正しいか』という議論に時間を費やすのをやめ、合意された共通のビジネスロジックに基づいて意思決定を行うことに時間を割けているかどうかにあります」

最終的にアナリティクスがもたらす価値とは、意思決定のスピードの向上と、組織全体のアライメントが確保されることに集約されます。その価値が真に発揮されているかどうかの試金石は、部門横断のチームが『誰のデータが正しいか』という議論に時間を費やすのをやめ、合意された共通のビジネスロジックに基づいて意思決定を行うことに時間を割けているかどうかにあります
Josh Klahr
Snowflakeのアナリティクス担当プロダクトマネジメント責任者
アナリティクスにデータ品質とセマンティックレイヤーが欠かせない理由
分析結果の精度や信頼性は、その基盤となるデータの品質に直接依存します。たとえクエリやモデルが設計通り正確に動作していたとしても、レコードの欠損、データの鮮度不足、IDの不整合、不適切なフィールドマッピングなどが存在すれば、分析結果から導き出される結論の妥当性は大きく損なわれます。
そのためデータチームでは、通常、以下のような複数の評価軸に基づいてデータ品質を検証します。
- 正確性:データ値が、背景にある事実や対象物を正しく反映しているか
- 完全性:分析に必要なデータ値やレコードが欠落なく揃っているか
- 一貫性:異なるシステムやデータセット間において、数値や定義などの同一の情報が矛盾なく一致しているか
- 鮮度:データが、その意思決定で求められるリアルタイム性を満たしているか
- 妥当性:データ値が、あらかじめ定義された形式、許容範囲、ビジネスルールに準拠しているか
- 一意性:重複レコードの存在によって、集計件数やその他の計算結果に歪みが生じていないか
データ品質のルールを定義する前に、チームはまず現状のデータをプロファイリングし、データの分布、欠損値の割合、フォーマット、およびデータ間の関連性を把握したうえで、ユースケースに応じた許容水準を決める必要があります。たとえば、四半期ごとの財務計画であれば許容されるデータの更新頻度でも、不正検知のユースケースでは実用に耐えません。
ただし、データの品質を高めるだけで分析の一貫性が保証されるわけではありません。たとえば、完璧にクレンジングされた正確なデータを扱っていたとしても、年間経常収益(ARR)の計算定義が異なれば、チームごとに報告される収益の数値にズレが生じます。あるダッシュボードではアップセルを即座に売上へ反映する一方で、別のダッシュボードでは契約開始日まで反映を保留し、さらに別のダッシュボードでは特定の製品カテゴリを除外して集計する、といった違いが生まれてしまうのです。合意された統一的な定義が存在しなければ、これら3つの計算手法はいずれも技術的には間違いではないものの、同一のビジネス上の問いに対してそれぞれ異なる数値を提示するという事態に陥ってしまいます。
こうした課題を解決するのがセマンティックレイヤーです。SnowflakeのプリンシパルソフトウェアエンジニアであるRajhans Samdaniは、次のように解説しています。「セマンティックモデルとは、BIダッシュボードとAIエージェントが、全く同一のビジネスロジックに基づいてデータ処理を実行できるようにするための共有インターフェースです」
指標の定義やエンティティ間のリレーションシップ、その他のセマンティックコンテキストが整うことで、アナリスト、ダッシュボード、アプリケーション、そしてAIシステムに至るまで、すべての利用者が同一のロジックと共通の解釈に基づいて基盤データを扱えるようになります。
セマンティックレイヤーは、自然言語による検索・操作インターフェースにおいてとりわけ重要な役割を果たします。定義の一貫性が欠如している場合、システムは誤った(あるいは乖離した)回答を大規模かつ高速に拡散してしまい、どこに原因があるのかを特定することすら極めて困難になります。対話型システムやAIエージェントを介してデータにアクセスするユーザーが増加する中で、セマンティック(意味論)の一貫性を保つことは、組織の運用面においてかつてないほど重要な意味を持つようになっています。
よくある落とし穴
「技術的に正しい計算処理を行っていれば、おのずと有用な回答が得られる」と思い込んでしまうケースがあります。たとえ2つのチームが同一のデータに対して正確なロジックを適用していたとしても、ビジネス用語や指標の定義が異なれば、最終的に得られる分析結果は矛盾したものになってしまいます。
ビジネスインテリジェンス:組織全体を支えるレポーティングとダッシュボード
ビジネスインテリジェンスは、アナリティクスという広範な領域において、主にレポーティング、ダッシュボード、データの可視化、および定常的なビジネス指標へのアクセスを担う分野です。
BI環境の導入により、たとえば財務チームには月次の収益ダッシュボードを、営業リーダーにはパイプラインの進捗指標を、運用チームには在庫傾向の追跡環境をそれぞれ提供できるようになります。こうした確認作業は定期的に発生するため、あらかじめ基盤となる指標やデータモデルを事前に定義しておくのが一般的です。これにより、ビジネスユーザーは分析を毎回一から作り直すことなく、常に一貫した基準でパフォーマンスを可視化できます。
大規模言語モデル(LLM)や生成AIの台頭により、分析データを探索・クエリするための新たなアプローチが可能になりました。従来のフィルター操作やダッシュボードの閲覧にとどまらず、自然言語での質問入力、グラフの自動生成、対話型の追加質問などを通じて、より直感的にビジネスデータを活用できるようになっています。
リアルタイム分析:データ発生と同時に即時活用する
リアルタイム分析(リアルタイムアナリティクス)は、イベントが発生してから分析結果として可視化されるまでのレイテンシー(ミリ秒、秒、分単位)という軸で語られるのが一般的です。しかし、特定のユースケースにおいてリアルタイム分析が本当に必要か、また目指すべき適切なレイテンシー目標はどの程度かという点は、その分析結果がどのような意思決定に活用されるかによって左右されます。仮に、5分前のデータに基づく判断と5秒前のデータに基づく判断の結果が変わらないのであれば、それ以上にレイテンシーを短縮しても実質的なビジネス価値はほとんど生まれません。
一方で、より高いデータのリアルタイム性が求められるケースでは、継続的に更新されるデータストリーミング、低レイテンシーなストリーム処理、そして新規レコードのデータ取り込みと並行してクエリを高速処理できる高度なデータインフラストラクチャが不可欠となります。
リアルタイム分析を実現するには、レイテンシーとコンカレンシーの両方を適切に制御する必要があります。つまり、データを分析レイヤーへ迅速に届けるだけでなく、膨大な数のユーザーやアプリケーションが絶えず変動するデータに対して同時にクエリを実行しても、レスポンス遅延を引き起こさない設計が求められます。
一方で、数時間あるいは数日前のデータであっても意思決定に支障をきたさないワークロードであれば、従来のバッチ処理を採用する方がシステム構成をシンプルに保て、運用コストも低く抑えられます。
AI分析(AIアナリティクス):定型分析から対話型の探索へ
従来のセルフサービスアナリティクスは、ガバナンスが確保されたダッシュボード、ドラッグ&ドロップによるデータ探索、フィルター機能、アドホッククエリなどを提供することで、現場のビジネスユーザー自身が直接データ分析を行える環境を整えてきました。そして今日のAIは、ユーザーが普段使っている自然言語で問いを投げかけ、そのまま対話形式で深く分析を進められるようにすることで、セルフサービスの可能性を大幅に拡大させています。
こうした一連の体験は、生成AIによるText-to-SQL(自然言語からSQLへの自動変換)、分析結果の解説文生成、対話型の追加クエリ機能などによって実現されています。一方で、機械学習(ML)は、将来予測や選択可能なアクションの影響評価といった、予測的分析や処方的分析を支えるエンジンとしての役割を果たしています。
AIは、データ内のパターン検出、分析結果の自動解説、要約の作成といった作業においてもアナリストを強力に支援します。こうした機能群は拡張分析(Augmented Analytics:拡張アナリティクス)と総称されます。
分析のプロセスが、固定化されたメニュー操作から、AIによるクエリの自動生成やマルチステップの高度なワークフローへと進化するにつれ、出力される結果をビジネス本来の定義と齟齬なく整合させ続ける役割は、セマンティックコンテキストとデータガバナンスが主として担うことになります。
Klahrは次のように強調します。「対話型AIの導入によって、データチームの役割は『ダッシュボードやレポートをデザインすること』から『コンテキスト(文脈とビジネス定義)を管理すること』へと本質的にシフトします。システム側がユーザーの意図を正確に汲み取り、提示された問いに対して適切なビジネス定義と分析ルールを正しく適用できなければならないからです」
業界別のアナリティクス活用
業界ごとの違いが最も大きく現れるのは、採用する分析手法そのものというよりも、アナリティクスが置かれているビジネスコンテキストです。具体的には、分析対象となるデータ構造、意思決定に求められるデータ鮮度、そしてデータの取り扱いを規定するガバナンスや法規制上の制約などに主要な差となって表れます。
| 業界 | アナリティクスの活用方法 |
|---|---|
| 小売 | 小売業界では、需要予測、在庫管理、価格戦略、プロモーション効果、顧客行動、サプライチェーンの最適化など多岐にわたる分析が行われます。商品の補充計画のような意思決定であればバッチ処理で十分対応できますが、Eコマースにおけるリアルタイムな在庫可視性などの現場運用では、はるかに高いデータの即時性が求められます。 |
| 医療、ヘルスケア | 医療機関では、診療・患者ケアの業務運用、医療リソース(病床やスタッフなど)の稼働状況、臨床研究データ、および財務パフォーマンスなどの分析が行われます。この分野では、厳格なプライバシー保護、セキュリティ、およびデータガバナンスの要件に基づき、基盤データに「誰が」「どのような目的で」アクセスできるかが厳格に管理されます。 |
| 金融サービス | 金融機関は、リスク管理、不正検知と防止、顧客の取引行動分析、ポートフォリオ分析、および規制当局への報告にアナリティクスを活用しています。膨大なトランザクションの処理や、一刻を争う意思決定が求められるため、データのリアルタイム性とアクセス集中に耐えるコンカレンシーに対して非常に高度な要件が課されます。 |
| 製造 | 製造業では、生産工程、製造設備(IoT)、サプライチェーン、品質管理、および財務データを相互に統合させています。これにより、操業状況のリアルタイムモニタリング、需要予測、さらには設備の停止や製品不良の発生につながる要因の特定や予兆検知を実現しています。 |
アナリティクスツールとデータプラットフォーム
アナリティクス環境を構築および運用するには、生データの取り込みから最終的な分析結果の出力に至るデータライフサイクル全体にわたり、複数の機能が必要となります。データは、取り込みと変換、ストレージでの保持とコンピュートによる処理を経て、一貫したビジネス定義(セマンティックレイヤー)に基づき正しく解釈され、用途やワークロードに応じた最適なインターフェースを介して利用可能にならなければなりません。
アナリティクスプラットフォームにおいて特に重要となる主要機能には、以下のようなコンポーネントが含まれます。
- ストレージとコンピュート:分析の対象となる構造化データ、半構造化データ(JSONなど)、および非構造化データを保持および処理するための基盤機能です。
- データの取り込みと変換:多様なソースシステムから分析環境へデータを段階的に取り込み、可視化やモデル構築に適した形式へ前処理・変換を行う機能です。
- セマンティックおよびメトリクス機能:組織全体で共有されるビジネス概念、集計指標、およびデータ間のリレーションシップを定義して一元管理します。
- BIと可視化:各種ダッシュボードの作成、定常的なレポーティング、および直感的なインタラクティブ探索を支援します。
- ノートブックおよび開発環境:PythonやSQLを用いた高度な統計解析、機械学習(ML)モデル構築、アドホックで柔軟なカスタム分析ワークフローを実行・共有します。
- 対話型インターフェース:ユーザーが日常の自然言語で問いを入力し、対話形式で追加質問を重ねながら深掘り調査を行えるようにします。
これらの機能は、同一のAIデータプラットフォーム上で一挙に提供されることが理想的です。単一のプラットフォーム上で、ガバナンスの効いた同一データに対して多角的な分析ワークロードを実行できれば、システム間でデータを移動させるたびに発生していたデータの重複コピー、不要なデータパイプライン、そして個別実装されていたビジネスロジックの再構築を大幅に削減できます。
データプラットフォームには、データ、定義、ガバナンスの一貫性を全社レベルで維持しつつ、多様なコンピュート要件、レイテンシー目標、および高コンカレンシーの需要に柔軟に対応できる拡張性が求められます。
アナリティクス活用の第一歩
アナリティクス機能を組織に確立するプロセスにおいて真に重要なのは、固定化された一般的な成熟度モデルに機械的に従うことではなく、いくつかの基礎的な意思決定を正しい順序で下していくことです。具体的には、データチームは「どの課題に対応するのか」「基礎となる指標はどのように定義されるのか」「その意思決定にはどの程度のデータリアルタイム性と処理能力が必要か」、そして「最終的にユーザーがどのような形で分析結果にアクセスするのか」を明確に整理しておく必要があります。
- 意思決定とそれを支える指標の特定:ビジネス現場で回答が求められる課題、それに直結する評価指標、そしてその基礎データがビジネスの変化をどの程度の頻度・スピードで反映すべきかを明確にします。定常的なパフォーマンスレポート、需要予測モデル、現場の即時判断など、用途によって分析環境に求められる要件は大きく異なります。
- 重要な指標の早期定義:売上高、解約率、アクティブ顧客数などの重要指標の定義がチームやワークフローごとに揺らぎや相違があると、ダッシュボードやAIモデル、対話型インターフェースを増やせば増やすほど、後から数値の不一致をすり合わせる調整作業が爆発的に増加してしまいます。また、指標ごとに責任者を明確化しておくことで、ビジネス環境の変化に伴う定義の変更も長期的に無理なく管理できるようになります。
- ワークロードに応じたデータ要件と処理能力の最適化:定常的なBIレポートであればスケジュールの定期更新で十分対応できますが、現場の運用アナリティクスでは、リアルタイムなストリーム処理とよりシビアな低レイテンシーが求められます。また、予測ワークロードでは、分析対象となる履歴データの期間と網羅性、特徴量のデータクオリティ、および過去のデータパターンが現在のビジネス状況に当てはまるかといった独自の要件も考慮する必要があります。
- 働き方に応じた分析アクセス環境の拡張:ガバナンスの効いたセルフサービスBIは現場のビジネスユーザーによる定期的なデータ探索を支え、ノートブックや高度な開発環境はデータサイエンティストなどの専門的な分析作業に寄与します。そして対話型AIインターフェースは、ユーザーが普段の言葉で自然に問いを投げかける新たなアプローチを提供します。こうした多彩なアクセス手段は、各自が独自にデータや定義を作り直すのではなく、全社共通でガバナンスが確保されたデータとビジネスコンテキストを一元的に参照してこそ、最大の価値を発揮します。
- データアクセス環境の拡張と並行したリテラシー向上およびガバナンス強化:ビジネスユーザーが正しくデータを活用するには、各指標が意味する内容、集計対象となるデータの範囲、そして分析結果に含まれる前提条件や不確実性を的確に把握するための十分なコンテキストが不可欠です。これに対しデータガバナンスは、アクセス権限、データオーナーシップ、指標定義の一元管理、およびデータの追跡可能性における適切な制御機能を提供します。
これらの基盤機能を導入する順序は組織の優先順位によって異なります。しかし、どのような順序であれ、データとビジネスコンテキストを全社レベルで一元的に共有し続けることで、新たな分析ユースケースやワークロードを拡張する際にも、既存のデータインフラや計算ロジックを再構築する手間を最小限に抑えることが可能になります。
クイックヒント
まずは「どのような意思決定を下すべきか」というゴールから着手し、そこから逆算して、必要な指標、データ鮮度、そして最適な分析手法を特定していきます。このプロセスを徹底することで、テクノロジーやツールの選定が手段目的化することなく、真のビジネス要件に常に直結した状態を維持できます。
Snowflakeが実現するモダンアナリティクス
Snowflakeは、統合されガバナンスが確保された単一のデータプラットフォーム上で、あらゆる分析ワークロードをサポートします。これにより、組織の各チームはユースケースごとに個別のデータ環境を構築・維持・手動連携することなく、BI、リアルタイム分析、機械学習、そしてAIを活用した高度なデータ探索を共通の基盤上で統合的に実行できます。
BIやインタラクティブなデータ分析においては、同一の基盤データに対して膨大な数のユーザーが同時にアクセスしても処理速度が低下しないよう、柔軟で弾力的なコンピュートリソースと優れた高コンカレンシーを提供します。また、リアルタイム分析や運用アナリティクスでは連続的に更新、ストリーミングされるデータをそのまま活用できるほか、データサイエンスや機械学習のワークフローにおいても、特徴量エンジニアリング、モデル実験、そして本番デプロイに至るライフサイクル全体で同一のセキュアなガバナンス基盤を利用可能です。
さらに、これらの多様なワークロード全体にセマンティック機能が統合されることで、組織共通のビジネス定義と一貫したコンテキストが提供されます。集計指標、分析軸、およびデータ間のリレーションシップを一元的に管理することで、ダッシュボード、各種アプリケーション、AI支援インターフェースに至るまで、ロジックを個別に再構築や二重定義することなく、組織全体で全く同一のビジネス定義を矛盾なく共有できるようになります。
さらに、Snowflake Cortex AIはこのガバナンス基盤を自然言語による対話型・生成AIアナリティクスへと拡張し、Snowflake Horizonはデータ、アプリケーション、そしてAIモデル全体にわたり、統合的なガバナンス、セキュリティ、データ検索、およびコンプライアンス制御を一貫して適用します。これにより、多様なワークロードがそれぞれに最適な処理性能やUI/UXを活用しながらも、全社共通のデータとガバナンス基盤に常にしっかりと接続された、理想的なアナリティクス環境が実現します。
アナリティクスが拓く未来と次のステージ
今後のビジネスユーザーは、目の前の分析結果がどのデータパイプライン、機械学習モデル、あるいはBIツールによって出力されたものかを意識することなく、定常的な基本指標の確認から、アドホックな原因調査、将来予測、そして対話型のAIクエリへと、シームレスに行き来できる体験を当然のように求めるようになります。こうした変化は、データプラットフォームに対する要求水準を一段上のレベルへと引き上げます。これはつまり、指標やロジックの定義がデータとともに移動し、ガバナンスがあらゆるワークロードに漏れなく追従し、そしてデータのリアルタイム性が意思決定の重要度に常に最適化されている状態を実現しなければならないということです。
重要なポイント
現代においてアナリティクスが真の成果を発揮するのは、ユースケースごとにデータパイプライン、重複コピー、個別のビジネスロジックを再構築するのではなく、多種多様なワークロードが、ガバナンスの確保された共通のデータ基盤を一元的に参照するときです。
よくある質問
アナリティクスに関するよくある質問に、Snowflakeのエキスパートがお答えします。
アナリティクスと分析の違いは何ですか?
データ分析とは、特定の問いや課題に答えるためにデータを調査、検証する個別のアクションを指します。一方、アナリティクスとは、データ、プロセス、AI/統計モデル、ツール、およびデータガバナンスを包括的に組み合わせ、継続的かつ組織的に分析結果を生み出すためのより広範な領域および体系的な運用能力を意味します。なお、実務の現場では両者の用語が同義として扱われることも少なくありません。
Googleアナリティクスとの違いは何ですか?
Googleアナリティクスは、Webサイトやアプリのアクセス解析に特化したツールの固有名称です。本ガイドで扱うアナリティクスは、BIや予測分析を含む、組織全体のデータ活用の仕組みを指します。
レポーティングとアナリティクスの違いは何ですか?
レポーティングは、主に過去に発生した実績や定義済みの数値指標を、定期レポートやダッシュボードを通じて可視化する手法的側面を指します。これに対し、アナリティクスは単なる実績報告にとどまらず、原因の究明、将来の予測、処方策の提示、および意思決定支援までを含みます。なお両者は密接に関連しており、ダッシュボード内で深いデータ探索を行うケースや、アナリティクスのプロセスが最終的にレポート出力として帰着するケースなど、実務上は柔軟に連携して機能します。
リアルタイム分析が必要ですか?それともバッチ処理で十分ですか?
判断の基準となるのは、意思決定に求められるデータのリアルタイム性です。不正検知や現場の緊急オペレーションのように、分析結果の遅延によって意思決定の有効性が損なわれるユースケースでは、リアルタイム処理(またはニアリアルタイム処理)を採用するのが適切です。一方、数時間あるいは数日前のデータであっても意思決定に支障がない場合は、システム構成がシンプルでコストを低く抑えられるバッチ処理を選択するのが一般的です。
4つの分析手法(記述・診断・予測・処方)のうち、どれから始めるべきですか?
多くの組織において、まずは記述的分析(Descriptive Analytics)から着手するのが実用的なアプローチとなります。過去の実績を把握し、主要な評価指標を確立することが、その後の高度な分析の基礎となるためです。ただし、最適な着地点はユースケースによって異なります。たとえば、明確な需要予測の課題がある場合は、早い段階で予測的分析(Predictive Analytics)へ投資する選択肢もあります。いずれの分析手法から始める場合であっても、データの品質確保と安定した指標定義の整備が成功の前提条件となります。
アナリティクスとビジネスインテリジェンス(BI)は同じ意味ですか?
いいえ、同一ではありません。ビジネスインテリジェンス(BI)は、アナリティクスという広範な領域の一部であり、主にレポーティング、ダッシュボード、データの可視化、および定常的なビジネス指標へのアクセスを担います。一方、アナリティクスはより広いスコープを持ち、BIに加えて原因の究明、予測的・処方的分析、リアルタイム分析、およびAIを活用したデータ探索のワークフローまでを網羅します。
データ分析やアナリティクスを行うにはプログラミング(コード記述)が必要ですか?
必ずしもプログラミングは必須ではありません。多くの一般的な分析タスクは、SQL、BIツール、ノーコードのGUI(グラフィカルインターフェース)操作で対応できます。ただし、統計解析、高度な予測モデルの構築、機械学習(ML)の適用といった領域では、PythonやRなどのプログラミング言語が重要な役割を果たします。
また近年では、対話型アナリティクスや生成AIの発展により、自然言語による問い合わせ(Text-to-SQLなど)で分析を進められる範囲が急速に広がっています。ただし、こうしたAIによる対話の精度や信頼性は、その基盤にあるデータモデル、指標の定義、およびデータガバナンスの品質に直接依存します。
アナリティクス関連資料を見る
アナリティクスのトピックを見る
アナリティクスのあらゆる側面を詳しく解説
