Modelli di machine learning: tipologie, funzionamento e criteri di scelta
Scopri come sono classificati i modelli di machine learning in base all’approccio di apprendimento, ai task e all’architettura, e come valutare il modello più adatto ai tuoi dati e requisiti.
MODELLI ML: LA DEFINIZIONE
I modelli di machine learning sono sistemi computazionali che utilizzano le relazioni apprese dai dati per formulare previsioni, identificare pattern o generare output in base a nuovi input.
Se oggi chiedessimo a qualcuno di citare un modello di machine learning, probabilmente menzionerebbe ChatGPT o un altro large language model (LLM). Eppure, la maggior parte delle organizzazioni continua a utilizzare ogni giorno molti altri tipi di modelli per supportare previsioni, punteggi di rischio, raccomandazioni, rilevamento delle anomalie e altre previsioni circoscritte. Una singola impresa può eseguire decine o centinaia di modelli basati su fondamenti matematici completamente diversi.
Uno può essere una regressione lineare con pochi coefficienti, un altro un ensemble con gradient boosting addestrato su milioni di record e un altro ancora un foundation model contenente miliardi di parametri. Le diverse famiglie di modelli formulano ipotesi diverse sui dati, apprendono tipi differenti di relazioni e impongono requisiti diversi per training, inferenza e interpretazione.
Queste differenze non sono puramente accademiche. Determinano quali problemi può risolvere un modello, quanti dati richiede, come è possibile valutarne gli output e se soddisfa i requisiti del task in questione.
Il modello più potente non è sempre la scelta migliore. Un modello più piccolo o specializzato può produrre risultati comparabili con costi inferiori, prestazioni più rapide o una valutazione più semplice. Come scrive Kyle Schmaus di Snowflake, “La difficoltà consiste nel determinare quando i modelli di frontiera sono davvero necessari e quando alternative ottimizzate possono ottenere lo stesso risultato”. Per questo motivo, le imprese devono poter scegliere con flessibilità tra diverse famiglie di modelli. In pratica, ciò significa gestire un portafoglio di modelli selezionati per task, tipi di dati e requisiti prestazionali diversi.
Che cos’è un modello di machine learning?
Un modello di machine learning è una rappresentazione addestrata di pattern o relazioni presenti nei dati. Riceve un input, applica i parametri appresi durante il training e produce un output, come un valore previsto, una probabilità di classe, una sequenza generata o l’assegnazione a un gruppo.
Il modello è distinto dall’algoritmo utilizzato per crearlo. L’algoritmo determina come avviene l’apprendimento, mentre il modello contiene i parametri e la struttura appresi dai dati.
Ad esempio, un algoritmo ad albero decisionale cerca i valori delle feature che suddividono gli esempi di training in gruppi sempre più utili. L’albero addestrato, incluse le feature selezionate, le soglie di suddivisione e i valori delle foglie, costituisce il modello. Un’altra esecuzione dello stesso algoritmo su dati diversi può produrre un albero differente.
Questa distinzione separa anche il training dall’inferenza. Durante il training, l’algoritmo di apprendimento modifica i parametri del modello per ridurre un errore o migliorare un altro obiettivo. Durante l’inferenza, il modello addestrato applica tali parametri a nuovi dati. Un modello che stima il rischio di guasto delle apparecchiature potrebbe apprendere dai dati storici dei sensori e dai registri di manutenzione, per poi eseguire l’inferenza ogni ora all’arrivo di nuove letture.
I parametri assumono forme diverse a seconda della famiglia di modelli. Nella regressione lineare includono il coefficiente assegnato a ciascuna feature di input. Un albero memorizza regole di suddivisione e valori di previsione. Una rete neurale può contenere milioni o miliardi di pesi distribuiti tra diversi livelli. Qualunque sia la loro struttura, questi valori appresi costituiscono gran parte di ciò che il modello conserva dal training.
Un modello in produzione include in genere molto più dei soli parametri appresi. Può inoltre pacchettizzare logica di pre-elaborazione, schemi di input previsti, etichette di classe, informazioni sulle dipendenze e metadati necessari per riprodurre le previsioni in modo affidabile.
Guarda Tuhin Ghosh di Coinbase spiegare come le funzionalità Snowflake ML semplificano l’erogazione del machine learning su vasta scala da parte di Coinbase:
Come funzionano i modelli di machine learning
Un tipico workflow di machine learning inizia con un data set contenente osservazioni pertinenti al task. Ogni osservazione è rappresentata mediante feature, ossia le variabili di input disponibili per il modello. Nell’apprendimento supervisionato, i dati includono anche un’etichetta o un valore target che rappresenta l’output desiderato. Ad esempio, un data set sul rischio di credito potrebbe contenere feature che descrivono reddito, cronologia dei pagamenti e debito esistente, insieme a un’etichetta che indica se una persona che in precedenza aveva richiesto un prestito lo ha rimborsato.
Prima dell’inizio del training, in genere si puliscono e trasformano i dati, si creano feature utili e si suddividono gli esempi disponibili in set di training, validazione e test. Queste partizioni hanno scopi diversi: il set di training addestra il modello, il set di validazione supporta la selezione del modello e degli iperparametri e il set di test fornisce una stima finale utilizzando dati che non hanno orientato lo sviluppo.
L’algoritmo di training elabora quindi gli esempi attraverso il modello e ne confronta l’output con il risultato desiderato. Una funzione di perdita converte la differenza in un valore numerico. L’ottimizzazione modifica i parametri per ridurre tale perdita, anche se l’esatto processo di addestramento varia notevolmente tra le famiglie di modelli. Un modello lineare può stimare i coefficienti mediante una soluzione analitica o un’ottimizzazione iterativa, mentre una rete neurale in genere calcola i gradienti e li propaga all’indietro attraverso i propri livelli.
Vengono inoltre impostati gli iperparametri, che controllano il processo di apprendimento o la struttura del modello anziché essere appresi direttamente dagli esempi di training. Questi possono includere la profondità massima di un albero, il numero di alberi in una foresta casuale (random forest), una penalità di regolarizzazione o il tasso di apprendimento utilizzato per aggiornare i pesi della rete neurale.
Una volta addestrato, il modello viene valutato su dati tenuti da parte. La metrica pertinente dipende dal task e dalle conseguenze dei relativi errori. L’accuratezza può essere utile quando le classi sono ragionevolmente bilanciate e i costi dei diversi errori sono simili, mentre precisione, richiamo, calibrazione o area sotto la curva possono descrivere meglio altri sistemi. I task di regressione possono utilizzare l’errore assoluto medio, la radice dell’errore quadratico medio o una funzione di costo specifica del dominio. La selezione della metrica fa parte della definizione del problema: due modelli possono cambiare posizione in classifica se valutati in base a misure diverse.
L’obiettivo è la generalizzazione, ossia le prestazioni su nuovi esempi tratti dalle condizioni che il modello dovrebbe incontrare. Un modello può adattarsi perfettamente ai dati di training senza apprendere relazioni applicabili oltre tali dati, producendo risultati insoddisfacenti in produzione. Questo divario spiega perché la valutazione deve utilizzare esempi esclusi dall’addestramento e perché le prestazioni in produzione richiedono comunque un monitoraggio dopo il deployment.
La qualità del modello è limitata anche dalle informazioni disponibili nei dati. Variabili mancanti, misurazioni incoerenti, etichette inesatte e campioni non rappresentativi possono indurre il modello ad apprendere relazioni che non si verificano in produzione. Algoritmi diversi tollerano in modo differente rumore, valori anomali e valori mancanti, ma nessun modello può recuperare un segnale che i dati non hanno mai acquisito.
Come classificare i modelli di machine learning
Non esiste un unico elenco definitivo delle tipologie di modelli di machine learning, perché è possibile raggruppare i modelli secondo diverse dimensioni: approccio di apprendimento, task e famiglia di modelli.
Una random forest, ad esempio, è una famiglia di modelli basati su alberi. In genere utilizza l’apprendimento supervisionato e può eseguire sia la classificazione sia la regressione. Mantenere separate queste dimensioni facilita la comprensione delle relazioni tra i modelli.
Per approccio di apprendimento
Gli approcci di apprendimento differiscono in base al tipo di feedback disponibile durante il training. Alcuni modelli apprendono da esempi etichettati, mentre altri individuano strutture nei dati non etichettati, ricavano i target dai dati stessi o migliorano grazie alle ricompense ricevute da un ambiente.
- L’apprendimento supervisionato addestra un modello usando esempi che contengono sia gli input sia i valori target noti. Supporta task come classificazione, regressione e ranking.
- L’apprendimento non supervisionato opera senza etichette target predefinite. Il modello individua invece strutture negli input, ad esempio raggruppando osservazioni simili, stimando una distribuzione dei dati o apprendendo una rappresentazione a dimensionalità ridotta.
- L’apprendimento semi-supervisionato combina un insieme più piccolo di esempi etichettati con un insieme più ampio di dati non etichettati. È utile quando gli input sono numerosi, ma l’etichettatura da parte di esperti è costosa o richiede molto tempo.
- L’apprendimento auto-supervisionato ricava i target del training dai dati stessi. Un modello linguistico può imparare a prevedere i token mancanti o successivi, mentre un modello di immagini può apprendere ricostruendo regioni mascherate o confrontando viste trasformate della stessa immagine. Questo approccio supporta gran parte del preaddestramento utilizzato per i foundation model moderni.
- L’apprendimento per rinforzo addestra un agente attraverso le interazioni con un ambiente. Anziché apprendere da un’etichetta fissa per ciascun esempio, l’agente riceve ricompense associate alle azioni e apprende una strategia volta a massimizzare la ricompensa cumulativa.
Le spiegazioni introduttive definiscono talvolta l’apprendimento supervisionato, non supervisionato, semi-supervisionato e per rinforzo come i “quattro tipi di machine learning”. Questa rimane una risposta generale utile, purché siano presentati come approcci di apprendimento e non come quattro categorie esaustive di modelli.
Per task
I modelli possono essere raggruppati anche in base al tipo di output che producono. La stessa famiglia può supportare diversi task, tra cui classificazione, regressione, clustering, ranking, previsione e generazione.
- La classificazione assegna un input a una o più categorie. Un modello può classificare una transazione come legittima o potenzialmente fraudolenta, identificare un oggetto in un’immagine o instradare una richiesta di assistenza verso la coda corretta.
- I modelli di regressione prevedono un valore numerico continuo, come la domanda, la temperatura o il tempo di consegna.
- Il clustering raggruppa le osservazioni in base a una misura di similarità, senza ricorrere a etichette di categoria predefinite.
- Il ranking ordina i possibili risultati, come nella ricerca, nei sistemi di raccomandazione o nell’assegnazione delle priorità ai lead.
- La previsione stima i valori futuri tenendo conto dell’ordine temporale e di pattern come la stagionalità.
- La generazione produce nuovi contenuti o output strutturati, tra cui testo, immagini, audio, codice e rappresentazioni molecolari.
Altri task includono il rilevamento delle anomalie, la riduzione della dimensionalità, l’apprendimento delle rappresentazioni e il controllo. Un singolo modello può inoltre supportare diversi task, in particolare quando è stato preaddestrato su un ampio insieme di dati.
Per famiglia di modelli
Una famiglia di modelli descrive la struttura con cui il modello rappresenta le relazioni. Queste categorie possono sovrapporsi. Un autoencoder, ad esempio, è sia un’architettura di rete neurale sia un modello di riduzione della dimensionalità, mentre un transformer è un’architettura di rete neurale utilizzata da molti foundation model. La famiglia fornisce indicazioni sulla meccanica, sulle ipotesi e sul profilo computazionale del modello, ma non definisce completamente il task che il modello deve svolgere.
Famiglie comuni di modelli di machine learning
Le famiglie seguenti comprendono molti dei modelli utilizzati nel machine learning applicato. Sono rappresentative, ma non esaustive, e molte includono algoritmi che supportano più di un task.
Modelli lineari
I modelli lineari calcolano un output a partire da una combinazione ponderata delle feature di input. Nella regressione lineare, l’output è un valore continuo. La regressione logistica applica una formulazione analoga per stimare la probabilità di una classe.
Si supponga che un modello stimi il tempo di consegna in base alla lunghezza del percorso, al volume degli ordini e al workload del magazzino. Un modello lineare assegna un coefficiente a ogni feature, che rappresenta la variazione del tempo di consegna previsto al variare di quella feature, a parità delle altre.
Questa struttura rende i modelli lineari utili come baseline. Si addestrano rapidamente, operano in modo efficiente durante l’inferenza ed evidenziano relazioni che è possibile esaminare. I metodi di regolarizzazione come ridge, lasso ed elastic net vincolano i coefficienti, riducendo potenzialmente l’overfitting e, in alcuni casi, semplificando l’insieme di feature.
Tuttavia, la stessa struttura costituisce anche un limite. Un modello lineare di base non può rappresentare una relazione curva o un’interazione, a meno che questi termini non siano forniti come feature. Quando la relazione sottostante è fortemente non lineare, un modello lineare può incorrere in underfitting anche se configurato correttamente.
Alberi decisionali
Un albero decisionale rappresenta una previsione come una sequenza di suddivisioni basate sulle feature. In ogni nodo interno, il modello valuta una condizione, come il superamento di una soglia appresa da parte del saldo di un conto. Il percorso attraverso queste condizioni conduce a una foglia contenente una classe, una probabilità o un valore numerico previsto.
Gli alberi possono rappresentare relazioni e interazioni non lineari senza che sia necessario specificarle in anticipo. Possono inoltre gestire diversi tipi di feature e, in genere, richiedono meno operazioni di riscalamento o normalizzazione rispetto ai metodi lineari e basati sulla distanza.
Un albero di piccole dimensioni è relativamente facile da esaminare, perché una previsione può essere ricostruita attraverso un insieme finito di regole. Tuttavia, l’interpretabilità diminuisce quando l’albero diventa più profondo e sviluppa numerose diramazioni. Anche i singoli alberi possono essere instabili. Una variazione modesta nei dati di training può modificare una suddivisione iniziale e produrre una struttura sostanzialmente diversa. Limitare la profondità, richiedere più esempi per ogni foglia o potare l’albero addestrato può ridurre l’overfitting, sebbene questi controlli possano anche impedire al modello di rappresentare complessità utili.
Modelli ensemble ad albero
I metodi ensemble combinano più modelli affinché la previsione aggregata sia più accurata o stabile rispetto al risultato di un singolo modello componente. Due degli approcci basati su alberi più comuni sono le random forest e il gradient boosting.
Una random forest addestra numerosi alberi decisionali usando campioni diversi delle osservazioni e sottoinsiemi casuali delle feature candidate. Per la classificazione, la foresta combina le previsioni degli alberi mediante voto di maggioranza o calcolando la media delle probabilità di classe previste. Per la regressione, calcola la media delle loro previsioni numeriche. Poiché gli alberi non commettono tutti gli stessi errori, l’aggregazione riduce generalmente la varianza associata a un singolo albero addestrato.
Gli alberi con gradient boosting vengono costruiti in sequenza. Ogni nuovo albero si concentra sulla correzione degli errori residui dell’ensemble corrente. Implementazioni come XGBoost, LightGBM e CatBoost introducono ottimizzazioni e controlli differenti, ma utilizzano tutte il boosting anziché la costruzione più indipendente degli alberi tipica di una foresta casuale.
Gli ensemble di alberi offrono spesso buone prestazioni sui dati tabulari strutturati, in cui le osservazioni sono disposte in righe e le feature in colonne. I compromessi includono artefatti di modello più grandi, costi aggiuntivi di training o inferenza e una minore interpretabilità diretta rispetto a un albero di piccole dimensioni. Le misure dell’importanza delle feature e i metodi di spiegazione post hoc possono evidenziare alcuni aspetti del loro comportamento, ma non trasformano l’ensemble in un semplice insieme di regole.
Macchine a vettori di supporto
Una macchina a vettori di supporto (SVM) apprende un confine che separa le classi massimizzando il margine tra tale confine e gli esempi di training più vicini. Questi esempi vicini, noti come vettori di supporto, determinano il confine decisionale appreso.
Quando le classi non possono essere separate da una linea retta o da un iperpiano piatto, una funzione kernel può rappresentare relazioni non lineari attraverso le similarità tra le osservazioni. La regressione a vettori di supporto applica meccanismi analoghi alla previsione continua.
Le SVM possono offrire buone prestazioni su dati di dimensioni moderate e ad alta dimensionalità, in particolare quando le feature forniscono già una rappresentazione utile. Un esempio tradizionale è la classificazione del testo basata su feature sparse di parole o token.
Il metodo diventa meno pratico all’aumentare del numero di esempi di training, soprattutto con kernel non lineari. I risultati dipendono inoltre dal riscalamento delle feature e da scelte come il kernel, l’intensità della regolarizzazione e i parametri del kernel. Poiché il confine appreso è definito mediante vettori di supporto anziché da un breve elenco di coefficienti o da un percorso decisionale, la spiegazione di una singola previsione può richiedere ulteriori analisi.
Modelli dei vicini più prossimi
I metodi dei vicini più prossimi formulano previsioni a partire dagli esempi di training più simili a un nuovo input. Un classificatore k-nearest neighbors identifica un numero prestabilito degli esempi di training più simili e assegna una classe in base ai loro voti. Per la regressione, può calcolare la media dei rispettivi valori target.
Questo viene talvolta definito un approccio di lazy learning, perché l’addestramento comporta una stima dei parametri relativamente limitata. Il modello conserva invece gli esempi di riferimento e svolge gran parte del lavoro durante l’inferenza.
Il metodo è facile da comprendere e può rappresentare confini decisionali irregolari, ma il suo comportamento dipende dalla definizione della distanza. Le feature misurate su scale molto diverse possono alterare la similarità se non vengono standardizzate, mentre le dimensioni irrilevanti possono far apparire distanti esempi realmente simili.
Anche l’inferenza può diventare costosa con l’aumentare dei dati di riferimento. Le tecniche di indicizzazione e ricerca approssimata dei vicini riducono il costo della ricerca, ma i modelli basati sui vicini più prossimi impongono comunque requisiti di archiviazione e latenza diversi rispetto a un modello lineare compatto o a un albero decisionale.
Modelli probabilistici
I modelli probabilistici rappresentano le relazioni mediante distribuzioni di probabilità. Anziché produrre solo una classe o una stima numerica, possono calcolare la probabilità di più risultati o rappresentare l’incertezza nelle variabili nascoste.
I classificatori Naive Bayes stimano una classe in base alla probabilità condizionata delle feature osservate, adottando un’ipotesi di indipendenza che rende efficiente l’addestramento. I modelli di mistura gaussiana descrivono i dati come una combinazione di distribuzioni di probabilità e sono spesso utilizzati per il clustering o la stima della densità. Le reti bayesiane rappresentano le relazioni condizionali tra variabili, mentre i modelli di Markov nascosti rappresentano sequenze i cui stati sottostanti non sono osservabili direttamente.
Questi modelli sono utili quando l’incertezza è parte integrante del problema anziché un risultato accessorio. Una previsione probabilistica, ad esempio, può stimare una distribuzione della domanda possibile anziché un singolo valore puntuale.
Le ipotesi alla base di questi modelli possono renderli efficienti dal punto di vista computazionale e interpretabili, ma le prestazioni dipendono dalla capacità di tali ipotesi di descrivere ragionevolmente i dati. Una struttura delle dipendenze semplificata potrebbe non cogliere relazioni importanti, mentre un modello probabilistico più espressivo può risultare difficile da stimare.
Modelli di clustering
I modelli di clustering individuano gruppi di osservazioni simili senza essere addestrati su etichette di classe note. Poiché nessuna singola definizione di cluster è adatta a ogni data set, metodi diversi ricercano tipi di struttura differenti.
K-means assegna le osservazioni a un numero specificato di cluster, ciascuno rappresentato da un centroide appreso. Offre i risultati migliori quando la distanza da un centroide rappresenta in modo significativo l’appartenenza e i cluster hanno forme e scale sostanzialmente compatibili.
Il clustering gerarchico combina o divide ripetutamente i gruppi per creare una struttura annidata. È possibile esaminare questa gerarchia a diversi livelli anziché scegliere fin dall’inizio un unico raggruppamento piatto.
I metodi basati sulla densità, tra cui DBSCAN, identificano le regioni contenenti osservazioni ravvicinate e possono contrassegnare come rumore i punti isolati. Ciò consente di individuare forme dei cluster che i metodi basati sui centroidi potrebbero non rilevare, anche se il risultato dipende dalle soglie di densità.
I cluster non hanno un significato aziendale intrinseco. Dopo l’addestramento, è necessario esaminare le feature e gli esempi associati a ciascun gruppo, verificare la stabilità del pattern e stabilire se supporta l’analisi o il workflow previsto.
Modelli di riduzione della dimensionalità
La riduzione della dimensionalità rappresenta i dati mediante un numero inferiore di variabili, preservando determinati aspetti della loro struttura. La rappresentazione risultante può supportare la visualizzazione, la riduzione del rumore, la compressione o l’addestramento di modelli downstream.
L’analisi delle componenti principali (PCA) apprende nuovi assi che acquisiscono quantità progressivamente inferiori della variabilità nell’input. Poiché le componenti sono combinazioni ponderate delle feature originali, la PCA può condensare misurazioni correlate in uno spazio delle feature più piccolo.
Altri metodi preservano proprietà differenti. Alcuni privilegiano gli intorni locali per la visualizzazione, mentre gli autoencoder utilizzano una rete neurale per comprimere un input in una rappresentazione a dimensionalità inferiore e ricostruirlo.
Ridurre il numero di feature può diminuire i costi di archiviazione e calcolo o eliminare il rumore, ma può anche comportare la perdita di informazioni. Le componenti apprese possono essere più difficili da spiegare rispetto alle variabili originali e una rappresentazione che preserva la varianza complessiva potrebbe non mantenere le distinzioni più importanti per il task di previsione.
Reti neurali
Una rete neurale è costituita da livelli che trasformano un input mediante pesi appresi e funzioni non lineari. Durante l’addestramento, la rete produce un output, calcola una funzione di perdita e propaga all’indietro i gradienti affinché un ottimizzatore possa aggiornarne i parametri.
Architetture diverse impongono strutture adatte a tipi di dati differenti:
- Le reti feedforward trasmettono le informazioni attraverso una sequenza di livelli e supportano task generali di classificazione e regressione.
- Le reti neurali convoluzionali applicano filtri appresi agli input spaziali e sono comunemente utilizzate per le immagini.
- Le reti neurali ricorrenti mantengono lo stato lungo le sequenze, anche se oggi i transformer gestiscono molti task un tempo affidati alle architetture ricorrenti.
- I transformer utilizzano meccanismi di attenzione per modellare le relazioni tra gli elementi di una sequenza o di un’altra rappresentazione tokenizzata.
- Gli autoencoder apprendono rappresentazioni compresse ricostruendo i propri input.
- Le reti neurali a grafo scambiano informazioni tra nodi connessi per modellare strutture relazionali.
Le reti neurali possono apprendere funzioni complesse e, con dati sufficienti, ricavare rappresentazioni utili da immagini, audio, testo e altri input ad alta dimensionalità. Questa flessibilità comporta spesso requisiti più elevati in termini di dati e capacità di calcolo, un tuning più approfondito e un’interpretabilità meno diretta rispetto ai modelli più semplici.
L’architettura, da sola, non determina la qualità. La costruzione dei dati, la definizione dell’obiettivo, l’ottimizzazione, la regolarizzazione e la valutazione influiscono sulla capacità di una rete neurale di generalizzare oltre gli esempi di addestramento.
Modelli di serie temporali
I modelli di serie temporali tengono conto dell’ordine in cui si verificano le osservazioni. Un sistema di previsione potrebbe dover rappresentare trend, pattern stagionali ricorrenti, effetti ritardati e variabili esterne che cambiano nel tempo.
I modelli statistici come il modello autoregressivo integrato a media mobile utilizzano valori passati e pattern dei residui per stimare osservazioni future. I metodi di livellamento esponenziale modellano componenti come livello, trend e stagionalità. Gli ensemble di alberi possono utilizzare feature progettate basate su ritardi e finestre mobili, mentre le reti ricorrenti e i transformer possono apprendere rappresentazioni temporali dalle sequenze.
La selezione di un modello di serie temporali richiede spesso di bilanciare accuratezza, interpretabilità e costo computazionale. Schmaus spiega: “I metodi classici, come ARIMA e il livellamento esponenziale, sono rapidi da addestrare, altamente efficienti e facili da interpretare, mentre i metodi neurali possono offrire una maggiore accuratezza e integrare input esogeni e non linearità, a scapito però dell’efficienza di addestramento e inferenza”.
Anche la valutazione deve preservare l’ordine temporale. Una suddivisione casuale tra set di addestramento e test può introdurre nell’addestramento informazioni sul futuro e produrre un risultato irrealisticamente favorevole. Si utilizzano invece set di controllo basati sul tempo o finestre di valutazione mobili, che rispecchiano più fedelmente il modo in cui saranno generate le previsioni.
Foundation model
Un foundation model viene addestrato su un ampio insieme di dati, in genere su larga scala, e supporta l’adattamento a numerosi task downstream. La categoria comprende gli LLM e i modelli addestrati per immagini, audio, sequenze biologiche e altre modalità.
La maggior parte dei foundation model utilizza reti neurali e preaddestramento auto-supervisionato. Anziché raccogliere per ogni esempio un’etichetta distinta creata da una persona, il processo di addestramento ricava gli obiettivi dai dati, come prevedere un token mancante o allineare rappresentazioni correlate di immagini e testo.
Dopo il preaddestramento, il modello può essere adattato mediante prompting, retrieval, fine‑tuning o ulteriori livelli specifici per il task. Questo riutilizzo lo distingue da un modello addestrato esclusivamente per un singolo task di previsione circoscritto.
Tra gli esempi figurano LLM come GPT, Claude, Llama e Mistral, oltre a modelli multimodali come Gemini e Qwen2.5-VL. La categoria comprende anche modelli per la generazione di immagini come Stable Diffusion e FLUX, modelli vocali come Whisper e foundation model biologici come ESM. Sebbene supportino task molto diversi, questi modelli condividono un ampio preaddestramento seguito dall’adattamento alle applicazioni downstream mediante prompting, retrieval, fine‑tuning o ulteriore addestramento.
L’ERRORE COMUNE
Spesso si presume che un foundation model più grande produca automaticamente il risultato migliore, ma in realtà un modello più piccolo o specifico per il task può offrire una qualità comparabile con latenza, costi e complessità di valutazione inferiori.
Come scegliere il modello di machine learning più adatto
La selezione del modello è un processo empirico. Le diverse famiglie formulano ipotesi differenti sui dati e comportano compromessi diversi, quindi in genere si confrontano più candidati prima di scegliere quello più adatto al task e ai requisiti operativi.
Definire il task e i criteri di valutazione
Innanzitutto, stabilire se l’output è una classe, un valore numerico, un ranking, un cluster, una previsione o un risultato generato. Occorre quindi identificare come verrà utilizzato l’output.
In un sistema di screening medico, ad esempio, non rilevare un caso positivo ha un costo molto diverso rispetto a sottoporre un caso aggiuntivo a verifica. Nella previsione della domanda, una sottostima può essere più costosa di una sovrastima della stessa entità. La metrica di valutazione deve riflettere queste conseguenze, anziché limitarsi a seguire le convenzioni del task.
Esaminare i dati disponibili
La dimensione del campione, i tipi di feature, la sparsità, la qualità delle etichette e la struttura temporale restringono il numero di candidati praticabili.
Gli ensemble di alberi spesso offrono baseline solide per dati strutturati che contengono relazioni eterogenee tra le feature. I modelli lineari funzionano bene quando la relazione è approssimativamente lineare o la trasparenza è importante. Le SVM possono essere adatte a dati di dimensioni moderate e ad alta dimensionalità, mentre le reti neurali vengono spesso prese in considerazione quando sono disponibili grandi quantità di dati non strutturati o ad alta dimensionalità.
Si tratta tuttavia di punti di partenza, non di regole di selezione. In un benchmark condotto su 176 data set tabulari, le prestazioni relative delle reti neurali e degli alberi con gradient boosting variavano in base a caratteristiche come le distribuzioni delle feature e, talvolta, un tuning moderato incideva più della scelta tra le due famiglie.
Definire subito i vincoli operativi
Un modello che ottiene la migliore metrica offline potrebbe comunque non essere adatto al relativo ambiente di produzione. Potrebbe essere necessario limitare:
- Tempo di addestramento e costo dell’infrastruttura
- Latenza di inferenza
- Memoria e dimensioni del modello
- Frequenza e costo del riaddestramento
- Dipendenze hardware
- Requisiti di spiegabilità
- Volume e andamento delle richieste di previsione
I compromessi operativi spesso determinano quale modello rappresenta la scelta migliore. Un modello basato sui vicini più prossimi può richiedere poco addestramento ma trasferire una parte maggiore del costo all’inferenza, mentre un ensemble può migliorare le prestazioni predittive a scapito della latenza e della memoria. Un modello lineare più semplice può quindi essere più facile da sottoporre ad audit, distribuire e riaddestrare, anche quando un candidato più complesso ottiene un punteggio leggermente migliore.
Stabilire una baseline semplice
Una baseline indica se la maggiore complessità produce un miglioramento significativo. Per la regressione, si può iniziare prevedendo la media storica e poi addestrando un modello lineare. Per la classificazione, è possibile confrontare una regola della classe maggioritaria, la regressione logistica e un albero decisionale poco profondo prima di aggiungere ensemble o reti neurali.
La baseline serve anche a testare la pipeline. Risultati inaspettatamente validi possono rivelare problemi di data leakage, mentre risultati inaspettatamente scarsi possono evidenziare problemi nelle etichette, nelle join, nella costruzione delle feature o nella valutazione.
Confrontare i modelli in condizioni coerenti
I modelli candidati devono usare gli stessi partizionamenti dei dati e la stessa procedura di valutazione. Il tuning degli iperparametri deve avvenire senza consultare il set di test finale, perché decisioni ripetute basate sulle prestazioni dei test trasformano tale set in un’ulteriore fonte di feedback per l’addestramento.
La convalida incrociata consente di stimare come variano le prestazioni tra diversi sottoinsiemi di dati, soprattutto quando il campione disponibile è limitato. I dati dipendenti dal tempo richiedono suddivisioni che preservino l’ordine cronologico.
Il confronto tra modelli deve considerare anche la variabilità. Un punteggio medio leggermente superiore potrebbe non essere significativo se i risultati variano notevolmente tra fold, seed o finestre temporali.
CONSIGLIO RAPIDO
Usa le stesse suddivisioni dei dati, le stesse fasi di pre-elaborazione e le stesse metriche di valutazione per ogni modello candidato. In caso contrario, le differenze nell’esperimento potrebbero essere scambiate per differenze nella qualità dei modelli.
Bilanciare underfitting e overfitting
Un modello in underfitting è troppo vincolato per rilevare relazioni importanti. Un modello in overfitting apprende pattern specifici del campione di addestramento e produce risultati meno affidabili sui nuovi dati.
Questo fenomeno viene spesso descritto attraverso il compromesso bias-varianza. Gli stimatori con bias elevato tendono ad applicare semplificazioni sistematiche, mentre quelli con varianza elevata reagiscono fortemente ai cambiamenti nel set di addestramento. La famiglia del modello, gli iperparametri, la regolarizzazione e il volume dei dati di addestramento influiscono su questo equilibrio.
L’obiettivo non è selezionare il modello più flessibile, ma trovare una flessibilità sufficiente a rappresentare il segnale utile senza adattarsi al rumore o generare costi operativi che il miglioramento non può giustificare.
Testare nelle condizioni di produzione previste
Prima del deployment, la valutazione deve includere le condizioni che il modello probabilmente incontrerà: campi mancanti, nuove categorie, feature disponibili in ritardo, volumi insoliti e variazioni nella distribuzione degli input.
È necessario testare anche il percorso di serving. La pre-elaborazione applicata durante l’addestramento deve essere riprodotta durante l’inferenza, le definizioni delle feature devono rimanere coerenti e la latenza deve essere misurata lungo l’intero percorso della richiesta, non soltanto per il calcolo del modello.
Dopo il lancio, la selezione rimane provvisoria. Una volta esposto ai dati di produzione, il monitoraggio può indicare se input, previsioni e risultati sono ancora simili alle condizioni in cui il modello è stato valutato.
Limiti dei modelli di machine learning
Un modello di machine learning codifica i pattern presenti nei dati di addestramento. Non stabilisce autonomamente se tali pattern siano completi, causali o appropriati per la decisione da prendere.
Rappresentazione incompleta
I dati di addestramento sono un campione di osservazioni passate prodotte dai sistemi e dai processi esistenti. Possono omettere popolazioni rilevanti, condizioni rare o variabili che non sono state registrate. Un modello addestrato su tale campione può ottenere buoni risultati su un sottoinsieme escluso dall’addestramento, pur rimanendo inaffidabile in contesti scarsamente rappresentati nei dati di origine.
Overfitting e variazione della distribuzione
Anche un modello valutato con attenzione può incontrare dati di produzione diversi da quelli di addestramento. Il comportamento della clientela cambia, i sensori vengono sostituiti, le definizioni a monte vengono riviste e i nuovi prodotti modificano la distribuzione delle feature. Alcune variazioni riducono le prestazioni complessive, mentre altre interessano soltanto una determinata popolazione o condizione operativa. Per questo motivo, il monitoraggio aggregato può non rilevare un degrado circoscritto.
Bias nei dati e nelle etichette
Le etichette storiche riflettono il modo in cui le decisioni precedenti sono state prese e misurate. Se alcuni gruppi hanno ricevuto meno opportunità, un follow-up meno completo o sono stati sottoposti a criteri di revisione diversi, l’etichetta risultante può codificare tali differenze.
Il bias nei dati può derivare anche dal campionamento, dai valori mancanti, dalle variabili proxy e dalla scelta dell’obiettivo di ottimizzazione. La mitigazione richiede di esaminare come sono stati prodotti i dati, valutare i risultati nei gruppi pertinenti e verificare in che modo gli output del modello influenzano la successiva raccolta dei dati.
Interpretabilità limitata
La facilità con cui è possibile esaminare il funzionamento varia da un modello all’altro. I coefficienti lineari e gli alberi decisionali di piccole dimensioni offrono rappresentazioni relativamente dirette, mentre gli ensemble di grandi dimensioni e le reti neurali distribuiscono una previsione tra molti componenti interagenti.
I metodi di spiegazione post hoc possono stimare l’influenza delle feature o descrivere il comportamento locale, ma anche tali spiegazioni si basano su presupposti e presentano limiti. Il livello di interpretabilità richiesto dipende dalla decisione, dal pubblico e dai requisiti di governance applicabili.
Correlazione senza causalità
I modelli predittivi spesso sfruttano correlazioni che migliorano le stime senza identificare il meccanismo che le ha prodotte. Una feature può avere un’elevata capacità predittiva perché funge da proxy per un’altra variabile o perché un precedente processo aziendale ha creato la relazione.
Questo può bastare per alcuni task di forecasting, ma è meno utile quando l’organizzazione vuole sapere quale intervento cambierà il risultato. Le domande causali richiedono disegni di studio e presupposti che vanno oltre la modellazione predittiva standard.
Costi di manutenzione
Un modello è collegato a pipeline di dati, logica delle feature, infrastruttura di serving e definizioni aziendali. Le modifiche a uno qualsiasi di questi componenti possono influenzarne il comportamento. È necessario conservare il contesto di addestramento, gestire le versioni degli artefatti del modello, monitorarne il comportamento in produzione e stabilire quando esaminare, riaddestrare o ritirare un modello. L’onere operativo aumenta quando un’organizzazione gestisce molti modelli con responsabili, dipendenze e pianificazioni di aggiornamento differenti.
Creare ed eseguire modelli di machine learning su Snowflake
Lo sviluppo dei modelli richiede preparazione dei dati, sperimentazione, capacità di calcolo, gestione delle versioni e inferenza. Quando queste fasi sono distribuite tra ambienti non connessi, è necessario riprodurre set di dati e logica delle feature, trasferire gli artefatti tra sistemi e ricostruire quali input hanno prodotto una determinata versione del modello.
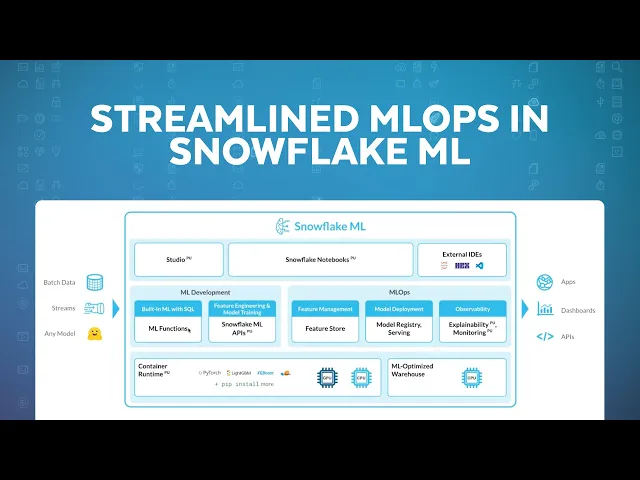
Snowflake ML supporta queste fasi insieme ai dati aziendali governati. Le funzionalità Snowflake consentono di preparare le feature, addestrare i modelli, confrontare gli esperimenti, registrare le versioni dei modelli, eseguire l’inferenza e monitorare il comportamento in produzione.
Snowpark offre API DataFrame per eseguire query ed elaborare dati in Snowflake con Python, Java o Scala. Nei workflow di machine learning in Python, è possibile creare trasformazioni e lavorare con i dati Snowflake senza prima esportare l’intero set di addestramento in un sistema di elaborazione separato.
Per i workload che richiedono librerie specializzate, CPU o GPU, Snowflake Container Runtime offre ambienti preconfigurati e personalizzabili per la sperimentazione, l’addestramento dei modelli, il tuning degli iperparametri e l’inferenza batch. Gli ambienti sono sottoposti a controllo delle versioni, così è possibile vincolare un workload a un runtime specifico e pianificare la migrazione a versioni successive.
Dopo l’addestramento, un modello può essere registrato in Snowflake Model Registry con i relativi metadati e le relative versioni. Il registro supporta tipi di modelli comuni, tra cui scikit-learn, XGBoost, LightGBM, CatBoost, PyTorch, TensorFlow, Keras, modelli MLflow e pipeline Hugging Face, oltre a tipi di modelli personalizzati tramite l’interfaccia CustomModel.
I modelli registrati possono eseguire l’inferenza batch in un virtual warehouse Snowflake oppure usare Snowpark Container Services per i workload che richiedono caratteristiche diverse di capacità di calcolo. Snowflake supporta anche servizi gestiti di inferenza in tempo reale con endpoint HTTP dedicati per app interattive a bassa latenza.
Conservare le versioni e i metadati dei modelli nell’ambiente governato offre anche una visione più chiara di ciò che genera le previsioni. I controlli degli accessi possono determinare chi gestisce o richiama un modello, mentre le metriche e i metadati archiviati supportano il confronto e la gestione del ciclo di vita. Il modello rimane una parte del sistema di produzione, ma è più facile preservarne il rapporto con dati, capacità di calcolo e governance quando questi componenti operano attraverso una piattaforma condivisa.
Selezionare i modelli con sicurezza
I modelli di machine learning differiscono nel modo in cui rappresentano le relazioni, nei dati con cui funzionano meglio e nei compromessi che introducono. Questa diversità è parte integrante del modo in cui il machine learning aziendale si sviluppa nella pratica. Le organizzazioni devono poter valutare famiglie diverse, selezionare il modello adatto a ciascun task e supportare un portfolio capace di evolvere al variare dei dati, dei requisiti e dei metodi disponibili.
IN SINTESI
Il machine learning aziendale raramente si basa su un’unica famiglia di modelli. Richiede un portfolio di modelli selezionati, valutati e gestiti per dati, task e vincoli di produzione differenti.
Domande frequenti
Le risposte degli esperti Snowflake alle domande più comuni sui modelli di machine learning.
Qual è la differenza tra un modello di machine learning e un algoritmo?
Un algoritmo di machine learning è la procedura usata per apprendere pattern dai dati. Il modello è l’artefatto addestrato prodotto da tale procedura e include parametri appresi come coefficienti, regole di suddivisione o pesi delle reti neurali.
Quali sono i principali tipi di modelli di machine learning?
I modelli possono essere classificati in diversi modi. Gli approcci di apprendimento includono l’apprendimento supervisionato, non supervisionato, semi-supervisionato, auto-supervisionato e per rinforzo. Le famiglie di modelli più comuni includono modelli lineari, alberi decisionali, ensemble di alberi, macchine a vettori di supporto, modelli dei vicini più prossimi, modelli probabilistici e reti neurali.
Come si usano i modelli di machine learning in produzione?
Un modello addestrato viene distribuito insieme alla logica di pre-elaborazione e alle dipendenze necessarie per l’inferenza, quindi integrato in un workflow batch, un’applicazione o un endpoint di serving. I sistemi di produzione gestiscono anche le versioni dei modelli, gli accessi, gli schemi di input, il monitoraggio delle prestazioni e le decisioni su riaddestramento o ritiro.
ChatGPT è un modello di machine learning?
ChatGPT è un modello di machine learning: più precisamente è un large language model (LLM), un tipo di foundation model addestrato per prevedere e generare testo. È una delle numerose famiglie esistenti; la maggior parte dei carichi di lavoro aziendali usa tuttora modelli più piccoli e specifici per attività, come modelli lineari, alberi decisionali ed ensemble con gradient boosting.
Esplora le risorse sull’AI
Esplora i temi dell’AI
Approfondimenti su ogni aspetto dell’intelligenza artificiale
