4 settembre 2026/Lettura: 9 minAI e ML
Pipeline di dati riproducibili: CoCo, l’agente AI di coding Snowflake


I contenuti spazzatura generati dall'AI sono ovunque. E per qualche motivo la gente si stupisce ancora del fatto che qualcuno sia riuscito a scrivere un semplice prompt in linguaggio naturale e ad aspettare che l’agente AI di coding sfornasse quantità enormi di codice o testo. Gli strumenti di intelligenza artificiale generativa per il coding sono il futuro e stanno trasformando completamente il panorama del software e del data engineering. Ma il fatto che gli agenti AI di coding possano generare una quantità di codice praticamente infinita non è così interessante.
Quello che conta, invece, è come i data engineer professionisti dovrebbero pensare a questi strumenti e utilizzarli. Chiunque può far produrre un risultato a un agente AI: non è certo un’impresa. Ciò che distingue un data engineer professionista da tutti gli altri è la capacità di utilizzare strumenti di AI per ottenere risultati ripetibili e di alta qualità. È questo l’obiettivo di questo articolo: condividere le best practice emergenti per il data engineering con i coding agent, in particolare con Snowflake CoCo.
In questo articolo troverai quattro best practice per il data engineering professionale assistito dall’AI, i motivi per cui CoCo supera gli agenti AI generici per il coding su Snowflake e come sviluppare skill e plugin che rendono riproducibili i workflow del tuo team.
Best practice per il data engineering con gli agenti AI di coding
Prima di passare alla configurazione, ci sono alcune best practice generali da menzionare:
- Inizia in piccolo e itera a partire dagli errori: resisti alla tentazione di complicare eccessivamente le cose fin dall’inizio. Esegui i prompt, osserva dove l’agente AI sbaglia, poi aggiungi una regola.
- Considera che il modello è già intelligente: i modelli frontier più recenti sono addestrati su dati aggiornati e sono in grado di svolgere la maggior parte dei task di data engineering. In genere devi solo dire al modello ciò che non può inferire da solo.
- Usa la concisione come un vincolo: la finestra di contesto è fissa e condivisa durante la sessione. Metti in discussione ogni frase: l’agente AI ne ha davvero bisogno?
- Fai della riproducibilità l’obiettivo: istruzioni, skill e strumenti trasformano le competenze individuali in risultati ripetibili e di alta qualità.
Ce ne sono altre due che meritano un’attenzione particolare, perché stiamo già osservando persone utilizzare i coding agent in modi che creano problemi reali.
Innanzitutto, gli agenti AI non sostituiscono gli strumenti di data engineering enterprise. Gli agenti AI per il coding possono aiutare i data engineer a progettare, sviluppare e monitorare le pipeline di dati, ma in produzione si dovrebbero utilizzare strumenti dedicati: dbt per la trasformazione e strumenti DCM, come schemachange, Flyway o Terraform, per il deployment. Utilizzare gli agenti AI per eseguire attività direttamente in produzione senza strumenti consolidati introduce fragilità.
In secondo luogo, e strettamente correlato: gli agenti AI non dovrebbero apportare modifiche direttamente in produzione. Anche con istruzioni chiare, gli agenti AI generano contenuti in modo dinamico durante l’esecuzione, il che significa che l’output è non deterministico. Consentire a processi non deterministici di agire direttamente in un ambiente di produzione è sempre stata una pratica sbagliata. Aggiungere l’AI non cambia le cose.
Perché CoCo per i data engineer Snowflake
Gli LLM frontier sono già molto efficaci per la maggior parte dei task di data engineering. Molti strumenti di coding AI che li utilizzano sono davvero utili. Ma per i data engineer che lavorano con Snowflake, CoCo è la scelta migliore. Ecco perché:
- L’inferenza viene eseguita all’interno del perimetro di sicurezza Snowflake: l’LLM viene distribuito ed eseguito all’interno dell’infrastruttura Snowflake, invece di essere instradato verso un provider AI di terze parti, e i tuoi dati vengono elaborati secondo i controlli di governance e le policy di classificazione dei dati Snowflake.
- Integrazione nativa con Snowflake: CoCo può leggere i tuoi schemi, le tabelle, la configurazione del warehouse e la cronologia delle query già dal primo prompt.
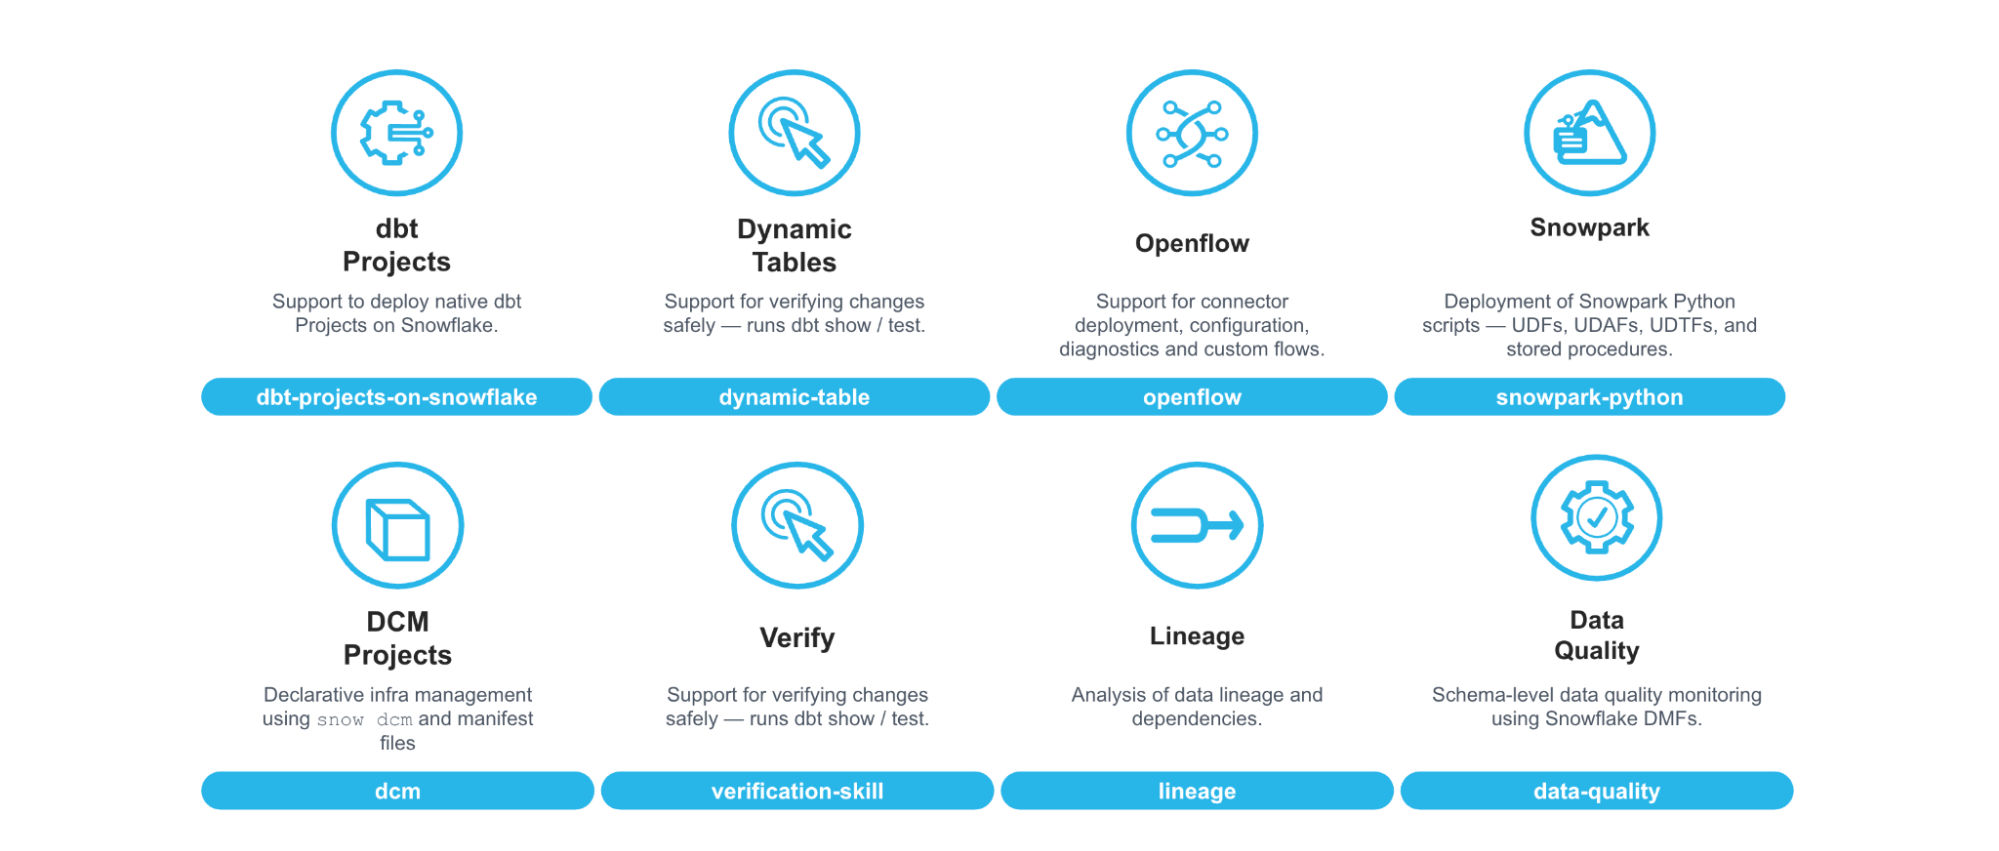
- Un ampio set di skill integrate per i workflow nativi di Snowflake: Dynamic Tables, Snowpipe Streaming, Snowflake Openflow, migrazione da Spark, dbt, Snowpark, machine learning, DCM e altro ancora si caricano automaticamente quando il prompt corrisponde al dominio.
- Flessibilità di scelta dei modelli: scegli tra i migliori modelli frontier, inclusi i principali modelli open source e altro ancora, in base al task.
Come accedere a CoCo: CLI, Desktop e Snowsight
CoCo funziona in tre ambienti. La CLI è uno strumento a riga di comando pensato per gli engineer che lavorano principalmente da terminale. Desktop è un IDE completo basato su VS Code, ideale per chi vuole avere il proprio repository locale e gli strumenti del sistema operativo insieme all’intelligenza nativa di Snowflake. CoCo in Snowsight non richiede installazione; è la scelta giusta per gli engineer che vogliono avviare task di lunga durata nel cloud Snowflake e ritrovare il lavoro completato. Tutti e tre condividono gran parte delle stesse funzionalità.
Puoi installare CoCo CLI su:
- macOS o Linux (incluso WSL):
curl -LsS https://ai.snowflake.com/static/cc-scripts/install.sh | sh
- Windows (nativo, PowerShell):
irm https://ai.snowflake.com/static/cc-scripts/install.ps1 | iex
Scarica CoCo Desktop da ai.snowflake.com. Accedi a CoCo in Snowsight direttamente dalla barra di navigazione a sinistra: non è richiesta alcuna installazione.
Una volta connesso, CoCo utilizza la tua connessione Snowflake esistente. Esegui /status per verificare che funzioni, poi fai la tua prima domanda:
What databases do I have access to?Come sviluppare workflow riproducibili con le skill e i plugin di CoCo
Con una serie di prompt occasionali, chiunque può far produrre un risultato a un agente AI. Ma questi risultati variano notevolmente da un’attività o una persona all’altra. I data engineer professionisti non si limitano a risolvere i problemi uno alla volta: codificano le soluzioni.
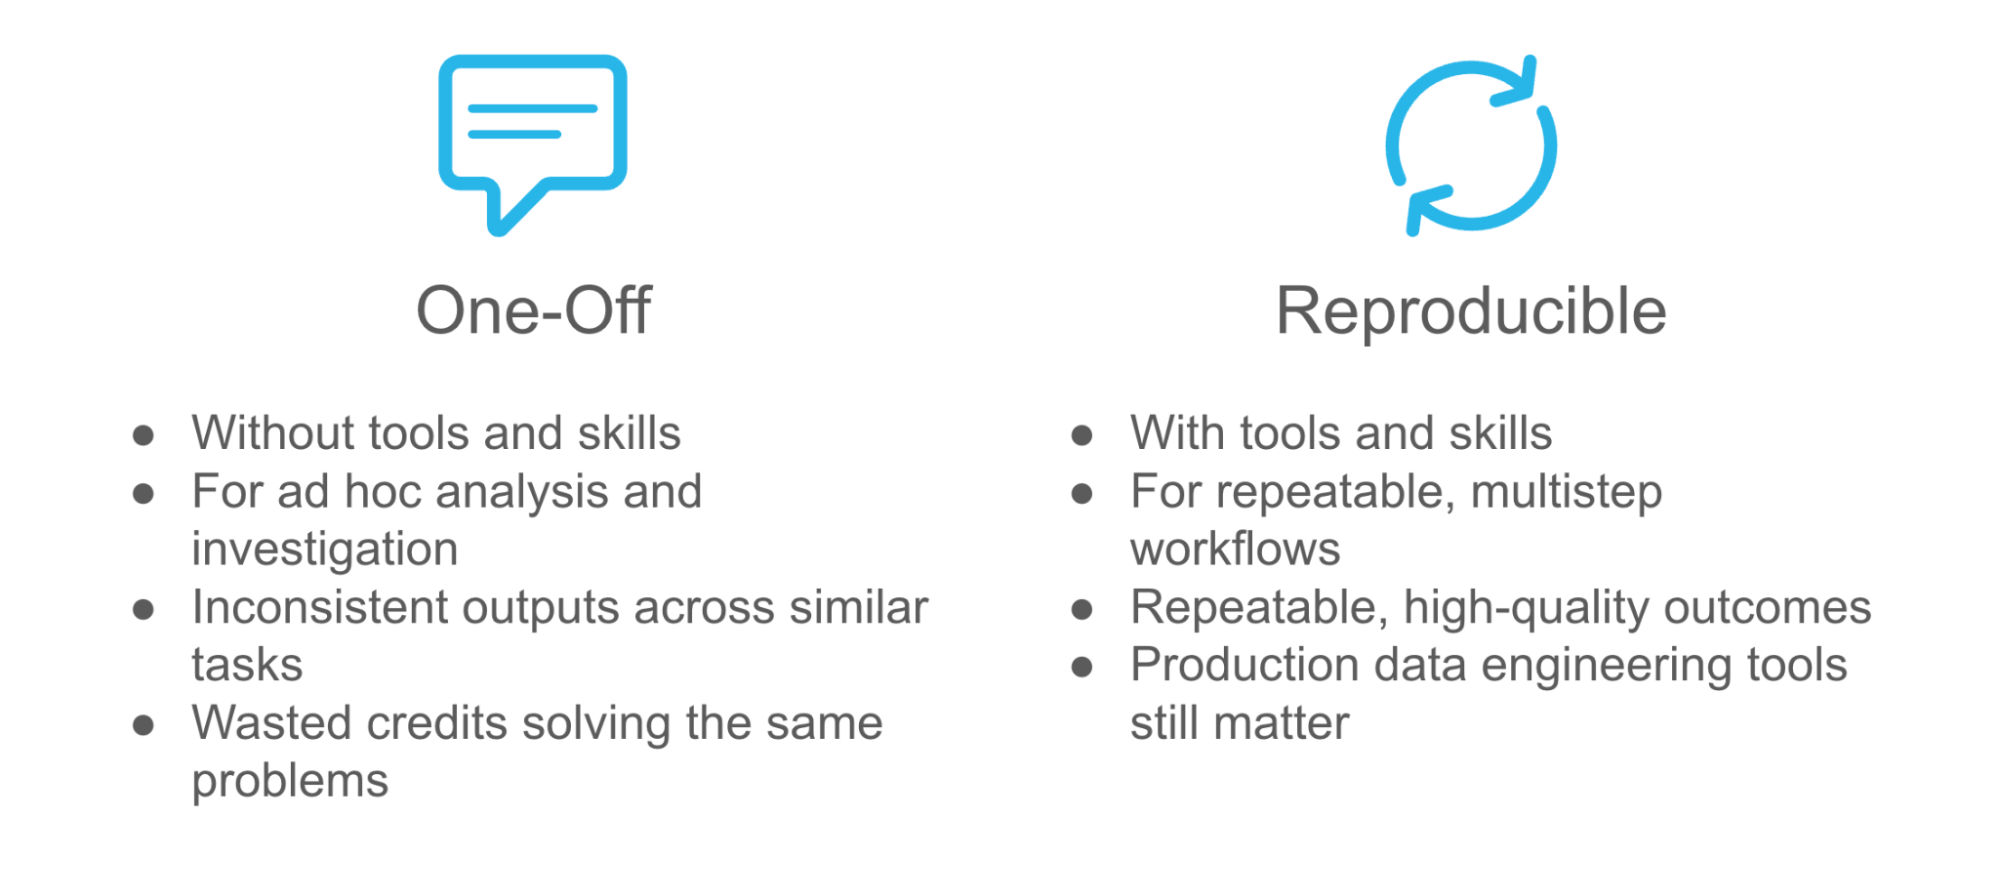
Sono emersi diversi standard per aiutare i data engineer a codificare soluzioni riproducibili:
- AGENTS.md: convenzioni a livello di repository, comandi e struttura del progetto che non cambiano da una sessione all’altra
- Skill: file markdown che inseriscono istruzioni e conoscenze specifiche del dominio in una sessione
- Subagenti: definizioni personalizzate di agenti AI per task specializzati e autonomi
- Comandi slash: comandi di progetto invocati dal prompt della CLI di CoCo
- Hook: hook del ciclo di vita che vengono eseguiti su eventi come PreToolUse o UserPromptSubmit
- Server MCP: server Model Context Protocol, che espongono strumenti esterni all’agente AI
Le sezioni seguenti trattano skill e plugin, gli aspetti più importanti per iniziare.
Agent skill
Le Skill implementano workflow ripetibili e multifase. Sono composte da istruzioni, script e strumenti, e sono supportate dalla maggior parte degli agenti AI di coding. Lo standard open è documentato su agentskills.io:
“Le Agent Skills sono un formato open e leggero per estendere le funzionalità degli agenti AI con conoscenze e workflow specializzati. Essenzialmente, una skill è una cartella che contiene un file SKILL.md. Questo file include metadati (come minimo, nome e descrizione) e istruzioni che indicano a un agente AI come eseguire un task specifico. Le skill possono inoltre includere script, materiali di riferimento, template e altre risorse.”
Una cosa fondamentale da ricordare quando si sviluppano le skill: Il modello è già intelligente. Generalmente devi sono fornirgli le informazioni che non può inferire. Per dbt, non devi insegnare al modello cosa sia dbt o come sviluppare un progetto: il modello lo sa già. Quello che racchiudi in una skill è qualsiasi processo ripetibile specifico del tuo team: i passaggi esatti da seguire per sviluppare e testare un progetto dbt, le tue convenzioni di naming o la tua strategia di partizionamento.
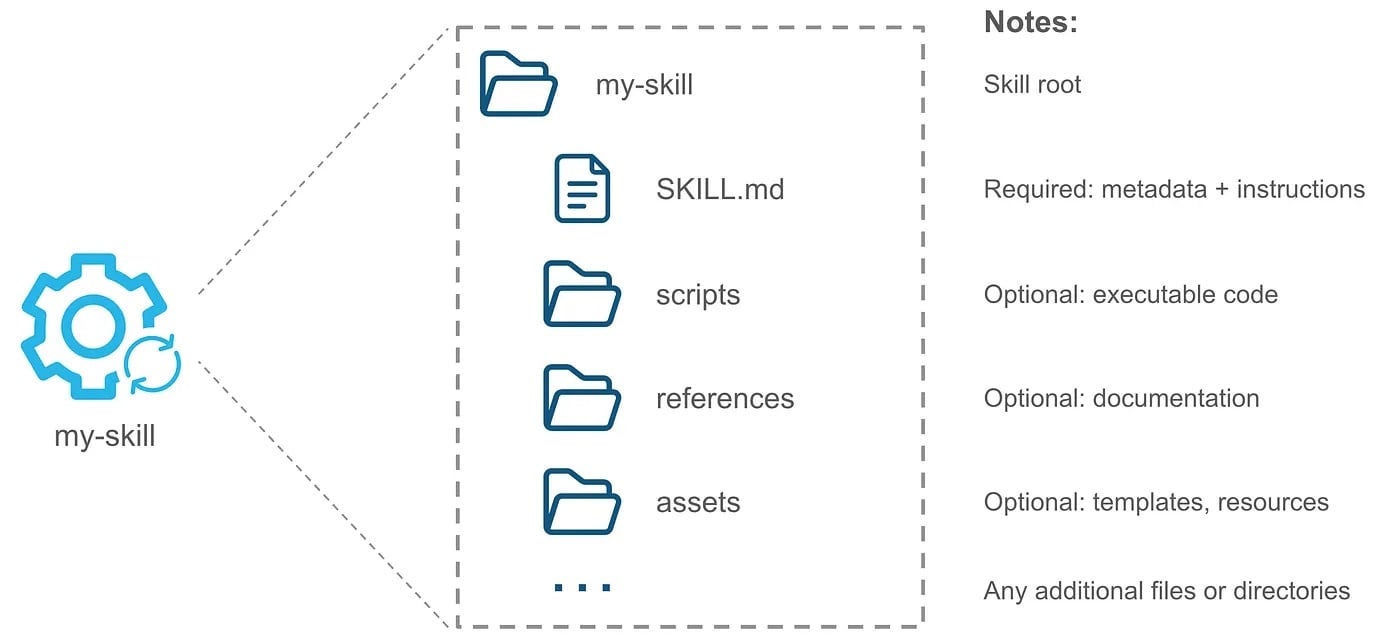
Le skill sono definite in linguaggio naturale tramite file Markdown. Le istruzioni principali si trovano in un file SKILL.md. Come minimo, una skill è una cartella con questo unico file, ma la vera potenza deriva dal raggruppare script riutilizzabili in una cartella /scripts, il che rende una skill coerente e riproducibile.
Il file SKILL.md inizia con un front matter YAML, seguito da istruzioni in Markdown. Sono obbligatori solo name e description; il modello utilizza la descrizione per decidere quando invocare la skill. Ecco un esempio minimo:
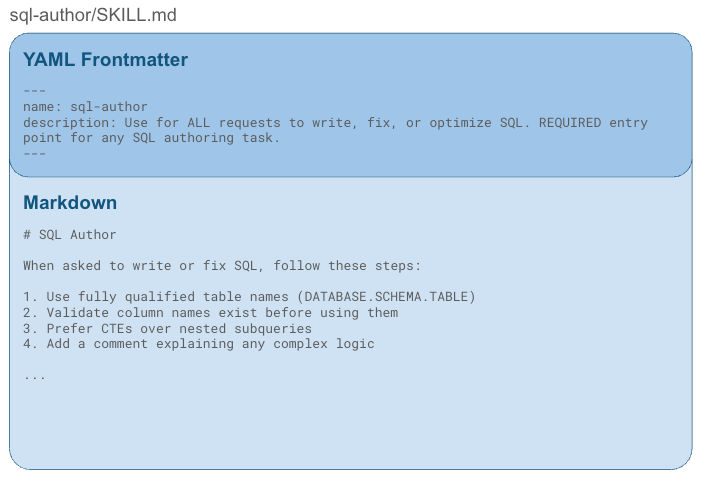
Se il team dispone di conoscenze istituzionali che i nuovi ingegneri impiegano settimane ad assimilare, una skill può codificarle e renderle disponibili a CoCo per ogni sessione. Le skill sono un open standard implementato dalla maggior parte degli agenti AI di coding. Gestire il loro ciclo di vita (controllo delle versioni, deployment e aggiornamenti) è l’ambito in cui entrano in gioco i plugin.
Plugin CoCo
Il data engineering professionale richiede pratiche SDLC altrettanto professionali, e gestire le skill singolarmente è più difficile di quanto sembri. I plugin risolvono il problema con un’unità di packaging e deployment più ricca, che raggruppa skill, subagenti, comandi slash, hook e server MCP in un’unica unità gestita.
I plugin sono un’unità di packaging e deployment migliore rispetto alle sole skill perché sono:
- Dotati di controllo delle versioni: il manifest ha un campo versione; le sole skill no.
- Validabili in CI: “cortex plugin validate” offre un controllo formale prima del rilascio.
- In un’unica unità installabile: “cortex plugin install” è un unico comando; le skill richiedono “cortex skill add” per ciascuna skill.
- Aggiornabili: “cortex plugin update” recupera l’ultima versione dalla fonte registrata.
- Raggruppabili: un plugin racchiude skill, hook, server MCP e subagenti come un’unica funzionalità coerente.
- In grado di sfruttare il tracciamento del registro: i plugin installati vengono registrati in registry.json con fonte, orario di installazione e stato attivo.
Un plugin è una directory autonoma con un file manifest in un percorso noto:
my-plugin/
├── .cortex-plugin/
│   ├── plugin.json          # manifest (required)
│   └── activation.md
├── skills/
│   └── my-skill/SKILL.md
├── commands/
│   └── my-command.md
├── agents/
│   └── my-agent.md
├── hooks/hooks.json
└── .mcp.json
Il file chiave è plugin.json:
{
  "name": "data-engineering",
  "description": "Skills, hooks, and MCP servers for Snowflake data engineering",
  "version": "1.0.0",
  "author": { "name": "Data Platform Team" },
  "skills": ["./skills"],
  "agents": ["./agents"],
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [
          { "type": "command", "command": "bash hooks/validate-bash.sh" }
        ]
      }
    ]
  },
  "mcpServers": {
    "internal-api": {
      "type": "http",
      "url": "https://internal.example.com/mcp"
    }
  }
}
Il Plugins Catalog Snowflake consente di distribuire plugin nel registro integrato Snowflake, favorendo condivisione e discovery in tutta l’organizzazione con governance e controllo degli accessi nativi.
La riproducibilità è quello che fa la differenza tra i professionisti e chi si limita a digitare prompt. In un mondo AI-native, i data engineer più efficaci saranno quelli che codificano le conoscenze istituzionali in skill, plugin e standard che rendono più capace l’intero team, non solo loro stessi.
Inizia subito
Se sei un data engineer e non usi ancora regolarmente gli agenti AI di coding, non aspettare. Inizia con la documentazione di Snowflake CoCo e i quickstart introduttivi per CoCo CLI e Desktop, che illustrano installazione, prime query, gestione delle sessioni e altro ancora usando esempi Snowflake reali.
Se hai già i tuoi agenti AI di coding ma lavori ancora perlopiù con prompt isolati, inizia a creare skill e plugin con l’aiuto di questa guida quickstart. È lì che i risultati iniziano a moltiplicarsi.