4 sept. 2026/Lecture : 10 minIA et ML
Créer des pipelines de données reproductibles avec CoCo, l’agent de codage IA de Snowflake
La bouillie générée par l’IA est partout. Et pourtant, certains s’émerveillent encore de voir quelqu’un saisir un simple prompt en langage naturel, puis attendre que l’agent de codage IA produise une avalanche de code ou de texte. Les outils de codage basés sur l’IA générative représentent l’avenir et transforment en profondeur le développement logiciel et le data engineering. Mais la capacité des agents de codage IA à générer une quantité quasi illimitée de code n’a rien de très intéressant.
La vraie question, c’est de savoir comment les data engineers doivent appréhender et utiliser ces outils dans un cadre professionnel. N’importe qui peut demander à un agent d’IA de produire un résultat. Ce n’est pas un exploit. Ce qui distingue un data engineer professionnel, c’est sa capacité à utiliser les outils d’IA pour obtenir des résultats reproductibles et de qualité. C’est précisément l’objectif de cet article : présenter les bonnes pratiques émergentes du data engineering avec des agents de codage IA, en particulier avec Snowflake CoCo.
Vous découvrirez quatre bonnes pratiques pour professionnaliser le data engineering assisté par l’IA, comprendrez pourquoi CoCo surpasse les agents de codage génériques sur Snowflake et apprendrez à créer des compétences et des plugins qui rendent les workflows de votre équipe reproductibles.
Bonnes pratiques de data engineering avec les agents de codage IA
Avant d’aborder la configuration, commençons par quelques bonnes pratiques générales :
- Commencer simplement et tirer les leçons de vos échecs : résistez à la tentation de tout complexifier dès le départ. Lancez des prompts, repérez les erreurs de l’agent, puis ajoutez une règle.
- Garder à l’esprit que le modèle est déjà intelligent : les modèles de pointe récents sont entraînés sur des données actuelles et capables d’effectuer la plupart des tâches de data engineering. En général, il suffit d’indiquer au modèle ce qu’il ne peut pas déduire.
- Faire de la concision une contrainte absolue : la fenêtre de contexte est fixe et partagée pendant toute la session. Remettez chaque phrase en question : l’agent en a-t-il vraiment besoin ?
- Faire de la reproductibilité l’objectif prioritaire : les instructions, les compétences et les outils transforment l’expertise individuelle en résultats reproductibles et de qualité.
Deux autres bonnes pratiques méritent une attention particulière, car certaines utilisations actuelles des agents de codage posent déjà de sérieux problèmes.
Premièrement, les agents ne remplacent pas les outils de data engineering d’entreprise. Les agents de codage IA peuvent aider les data engineers à concevoir, créer et superviser des pipelines de données. Mais en production, ils doivent s’appuyer sur les outils prévus à cet effet : dbt pour la transformation, et des outils DCM comme schemachange, Flyway ou Terraform pour le déploiement. Confier directement des opérations en production à des agents, sans disposer d’outils stables que l’on sait efficaces, fragilise les systèmes.
Deuxièmement, et dans le même ordre d’idées : les agents ne doivent pas modifier directement les environnements de production. Même avec des instructions claires, les agents génèrent du contenu dynamiquement pendant leur exécution. Le résultat est donc non déterministe. Laisser des processus non déterministes intervenir directement dans un environnement de production a toujours été une mauvaise pratique. L’ajout de l’IA n’y change rien.
Pourquoi choisir CoCo pour les data engineers Snowflake
Les LLM de pointe sont déjà très efficaces pour la plupart des tâches de data engineering. La majorité des outils de codage IA qui les exploitent sont réellement utiles. Mais pour les data engineers qui travaillent avec Snowflake, CoCo constitue le meilleur choix. Voici pourquoi :
- L’inférence s’exécute dans le périmètre de sécurité de Snowflake : le LLM est déployé et exécuté au sein de l’infrastructure Snowflake, sans passer par un fournisseur d’IA tiers. Vos données sont traitées conformément aux contrôles de gouvernance et aux politiques de classification des données de Snowflake.
- Intégration native à Snowflake : dès le premier prompt, CoCo peut lire vos schémas, vos tables, la configuration de vos warehouses et l’historique de vos requêtes.
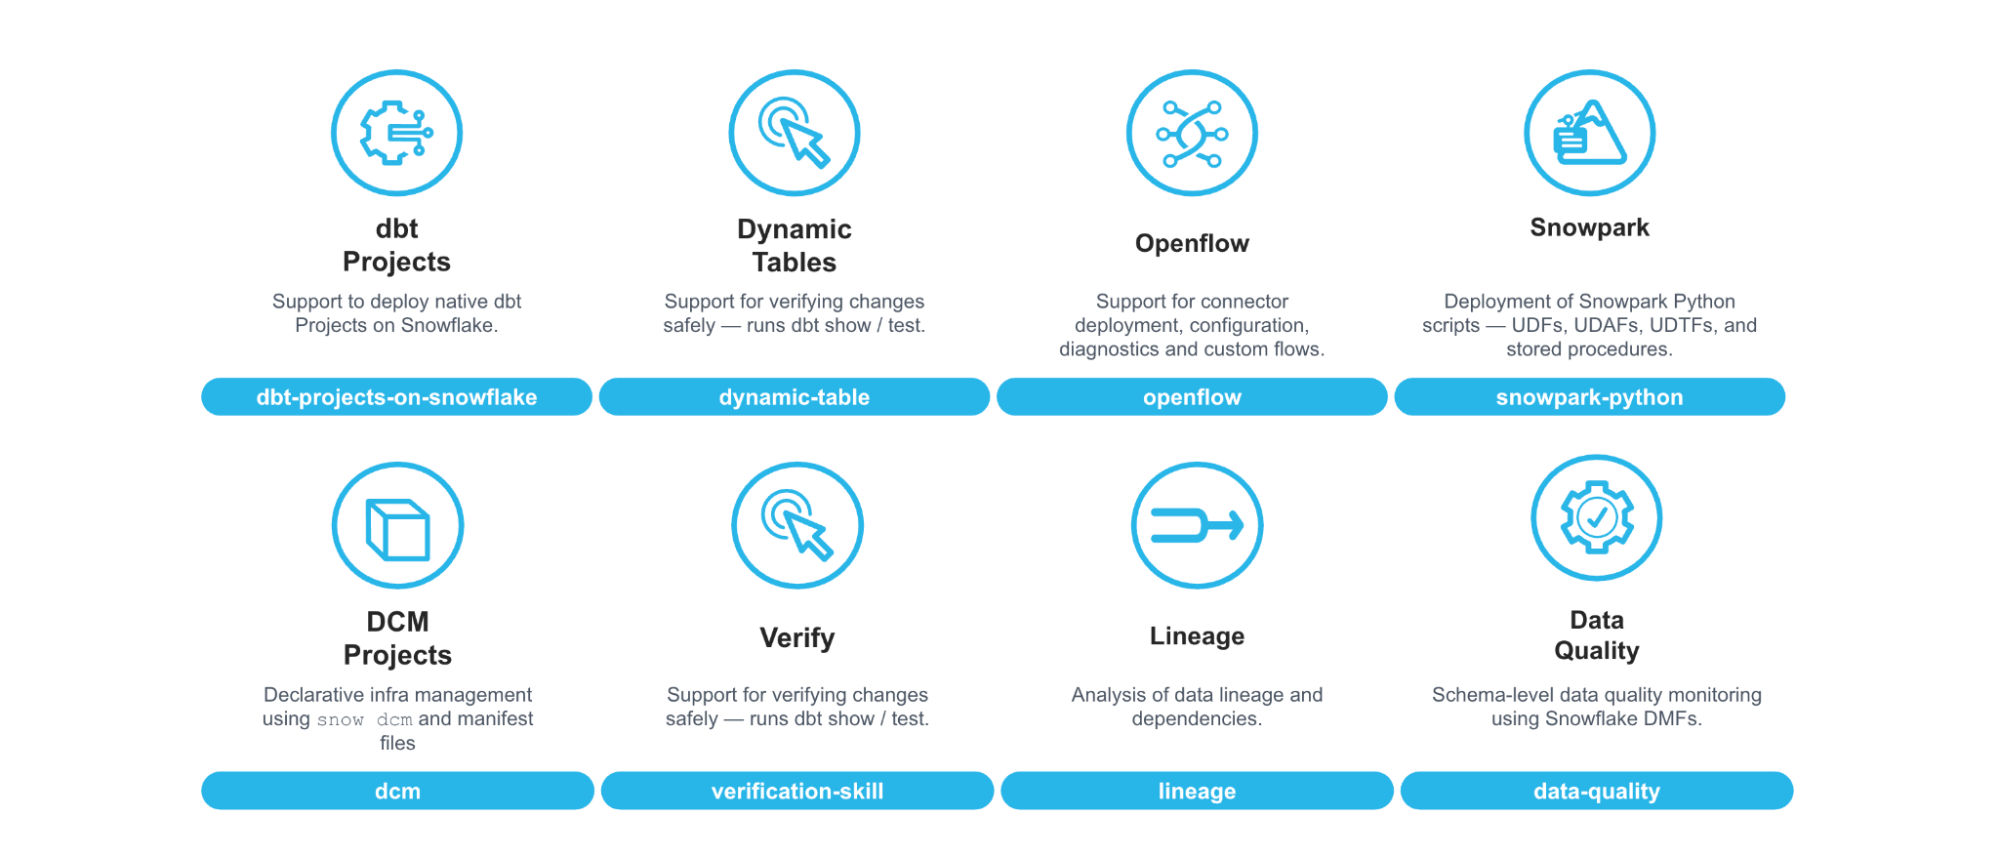
- Un vaste ensemble de compétences intégrées pour les workflows natifs Snowflake : Dynamic Tables, Snowpipe Streaming, Snowflake Openflow, la migration Spark, dbt, Snowpark, le machine learning, la DCM et bien d’autres se chargent automatiquement lorsque votre prompt correspond à leur domaine.
- Flexibilité des modèles : choisissez parmi les meilleurs modèles de pointe, notamment des modèles open source de référence, selon la tâche à accomplir.
Comment accéder à CoCo : CLI, Desktop et Snowsight
CoCo fonctionne dans trois environnements. La CLI est un outil en ligne de commande destiné aux ingénieurs qui travaillent principalement dans un terminal. Desktop est un IDE complet basé sur VS Code. C’est la solution idéale pour celles et ceux qui souhaitent associer leur dépôt local et les outils de leur système d’exploitation à l’intelligence native de Snowflake. CoCo dans Snowsight ne nécessite aucune installation. C’est le choix idéal pour les ingénieurs qui souhaitent lancer des tâches longues dans le cloud Snowflake et revenir une fois le travail terminé. Les trois environnements proposent l’essentiel des mêmes fonctionnalités.
Pour installer CoCo CLI, utilisez la commande suivante :
- macOS ou Linux, y compris WSL :
curl -LsS https://ai.snowflake.com/static/cc-scripts/install.sh | sh
- Windows, en natif avec PowerShell :
irm https://ai.snowflake.com/static/cc-scripts/install.ps1 | iex
Téléchargez CoCo Desktop à l’adresse ai.snowflake.com. Accédez directement à CoCo dans Snowsight depuis la barre de navigation de gauche. Aucune installation n’est requise.
Une fois connecté, CoCo utilise votre connexion Snowflake existante. Exécutez /status pour vérifier que tout fonctionne, puis posez votre première question :
What databases do I have access to?Créer des workflows reproductibles avec les compétences et plugins CoCo
Avec une série de prompts ponctuels, n’importe qui peut demander à un agent d’IA de produire un résultat. Mais les résultats varient considérablement d’une tâche ou d’une personne à l’autre. Les data engineers professionnels ne se contentent pas de résoudre les problèmes un par un. Ils formalisent les solutions.
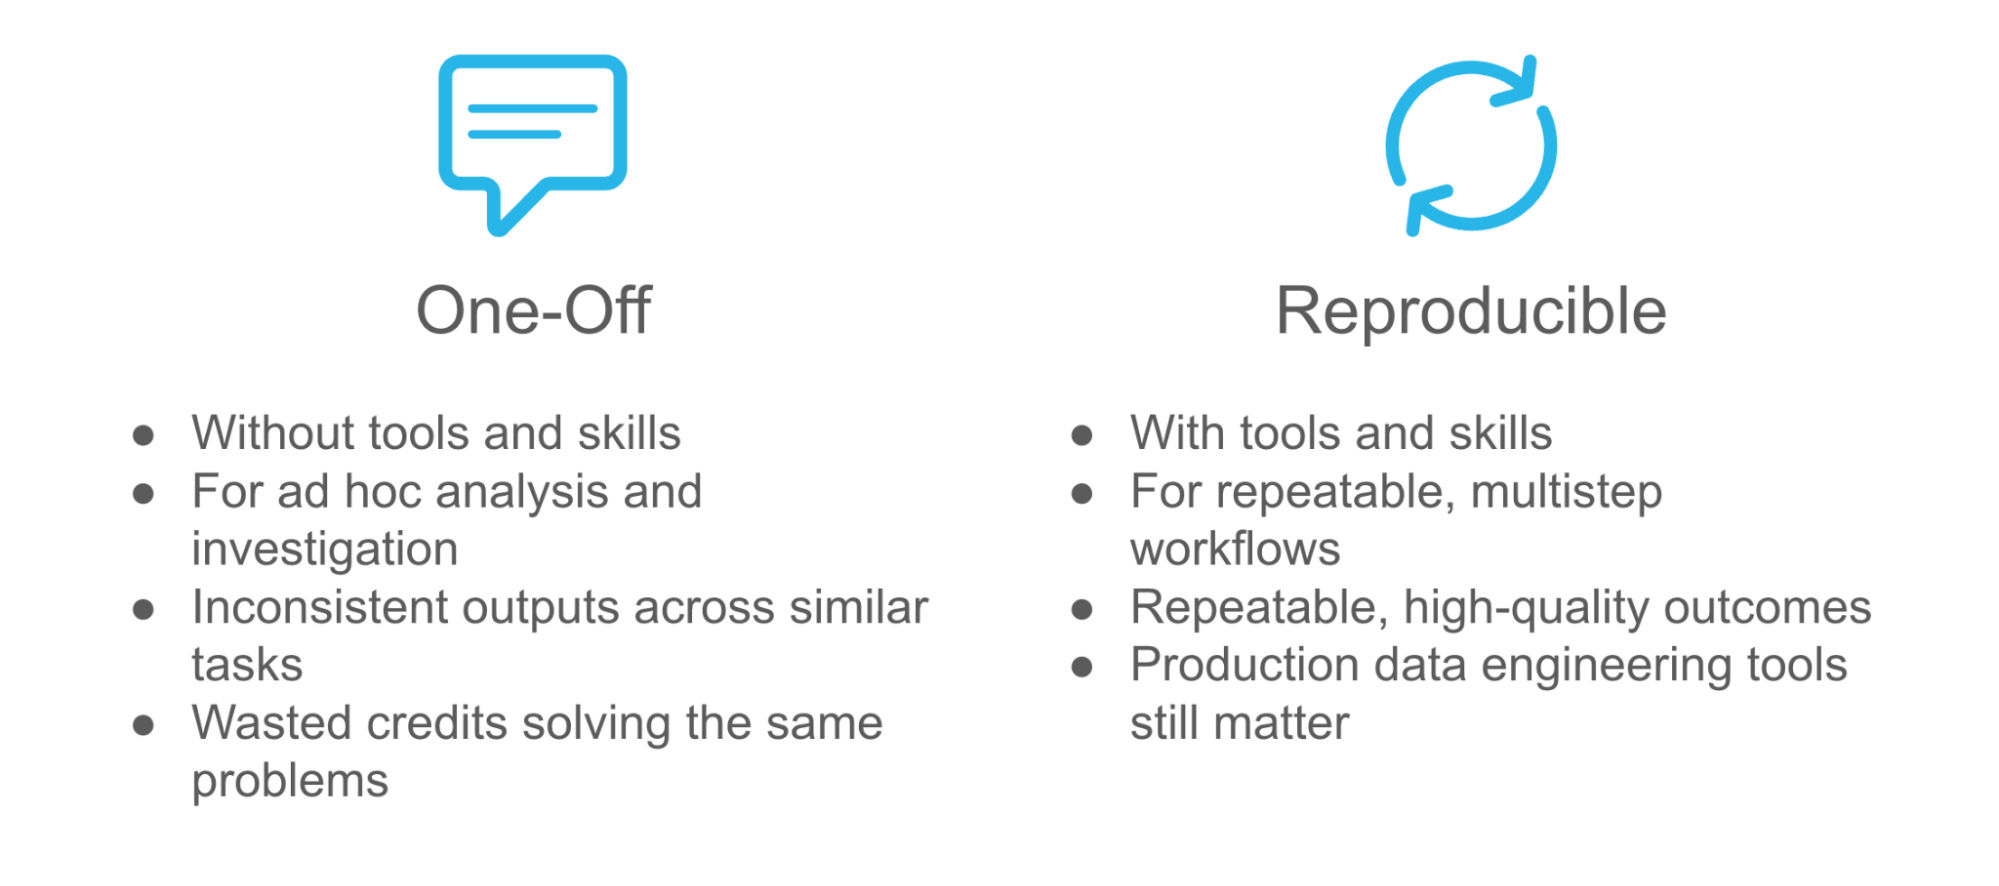
Plusieurs standards ont émergé pour aider les data engineers à formaliser des solutions reproductibles :
- AGENTS.md: Des conventions, commandes et structures de projet définies au niveau du dépôt, qui restent identiques d’une session à l’autre
- Compétences : des fichiers Markdown qui injectent dans une session des instructions et des connaissances propres à un domaine
- Sous-agents : des définitions d’agents personnalisées pour des tâches spécialisées et autonomes
- Commandes slash : des commandes propres au projet, appelées depuis le prompt de CoCo CLI
- Hooks : des hooks de cycle de vie exécutés lors d’événements tels que PreToolUse ou UserPromptSubmit
- Serveurs MCP : des serveurs Model Context Protocol qui donnent à l’agent accès à des outils externes
Les sections suivantes portent sur les compétences et les plugins, les deux éléments les plus importants pour débuter.
Compétences des agents
Les compétences permettent de mettre en œuvre des workflows reproductibles en plusieurs étapes. Elles combinent des instructions, des scripts et des outils, et sont prises en charge par la plupart des agents de codage IA. Le standard ouvert est documenté à l’adresse agentskills.io :
« Les compétences des agents constituent un format ouvert et léger permettant d’étendre les capacités des agents d’IA grâce à des connaissances et des workflows spécialisés. Une compétence est essentiellement un dossier contenant un fichier SKILL.md. Ce fichier contient des métadonnées, au minimum un nom et une description, ainsi que des instructions expliquant à l’agent comment effectuer une tâche précise. Les compétences peuvent également regrouper des scripts, des documents de référence, des modèles et d’autres ressources. »
Un point essentiel à garder à l’esprit lors de la création de compétences : le modèle est déjà intelligent. En général, il suffit de lui indiquer ce qu’il ne peut pas déduire. Avec dbt, inutile d’expliquer au modèle ce qu’est dbt ou comment créer un projet. Il le sait déjà. Une compétence doit formaliser tout processus reproductible propre à votre équipe : les étapes exactes à suivre pour créer et tester un projet dbt, vos conventions de nommage ou encore votre stratégie de partitionnement.
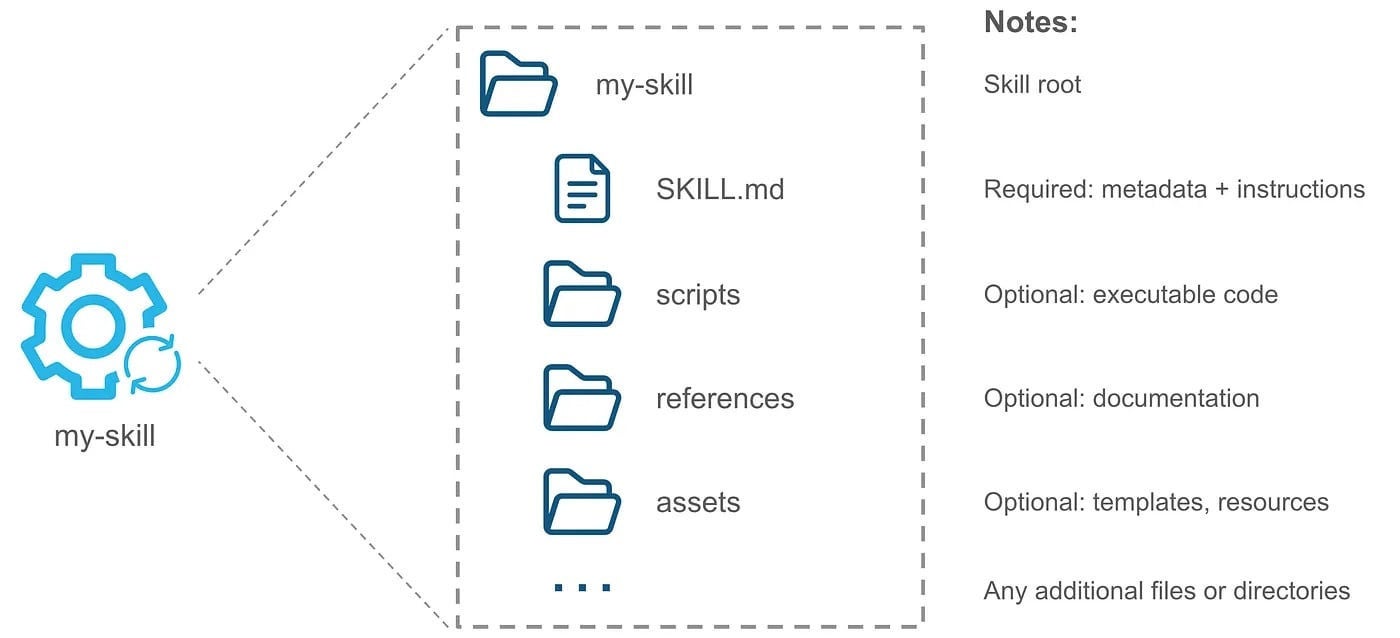
Les compétences sont définies en langage naturel dans des fichiers Markdown. Les instructions principales se trouvent dans un fichier SKILL.md. Au minimum, une compétence se compose d’un dossier contenant ce seul fichier. Mais toute sa puissance réside dans l’intégration de scripts réutilisables dans un dossier /scripts, qui la rendent homogène et reproductible.
Le fichier SKILL.md commence par un en-tête YAML, suivi d’instructions Markdown. Seuls name et description sont obligatoires. Le modèle s’appuie sur la description pour déterminer quand appeler la compétence. Voici un exemple minimal :
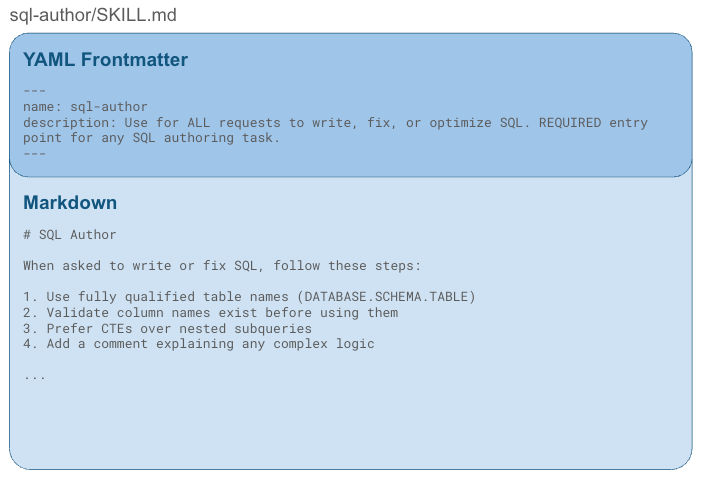
Si votre équipe possède un savoir institutionnel que les nouveaux ingénieurs mettent des semaines à assimiler, une skill peut l’encoder et le mettre à la disposition de CoCo à chaque session. Les skills sont un standard ouvert pris en charge par la plupart des agents de programmation basés sur l’intelligence artificielle. Les plugins interviennent pour gérer leur cycle de vie, notamment le versioning, le déploiement et les mises à jour.
Plugins CoCo
Un data engineering professionnel exige des pratiques rigoureuses de cycle de vie du développement logiciel (Software Development Life Cycle, SDLC). Or, gérer chaque skill séparément est plus complexe qu’il n’y paraît. Les plugins répondent à ce défi avec une unité de packaging et de déploiement plus complète, qui regroupe skills, sous-agents, commandes slash, hooks et serveurs MCP au sein d’un même ensemble administré.
Les plugins constituent une meilleure unité de packaging et de déploiement que les skills seules, car ils sont :
- Versionnés : le manifeste comporte un champ de version, contrairement aux skills seules.
- Validables dans la CI : « cortex plugin validate » effectue un contrôle formel avant le déploiement.
- Installables comme une seule unité : « cortex plugin install » ne nécessite qu’une commande, tandis que chaque skill doit être ajoutée séparément avec « cortex skill add ».
- Actualisables : « cortex plugin update » récupère la dernière version depuis la source enregistrée.
- Regroupables : un plugin réunit skills, hooks, serveurs MCP et sous-agents dans une fonctionnalité cohérente.
- Traçables dans le registre : les plugins installés sont consignés dans registry.json, avec leur source, leur date d’installation et leur statut actif.
Un plugin est un répertoire autonome contenant un fichier manifeste à un emplacement standard :
my-plugin/
├── .cortex-plugin/
│   ├── plugin.json          # manifest (required)
│   └── activation.md
├── skills/
│   └── my-skill/SKILL.md
├── commands/
│   └── my-command.md
├── agents/
│   └── my-agent.md
├── hooks/hooks.json
└── .mcp.json
Le fichier clé est plugin.json :
{
  "name": "data-engineering",
  "description": "Skills, hooks, and MCP servers for Snowflake data engineering",
  "version": "1.0.0",
  "author": { "name": "Data Platform Team" },
  "skills": ["./skills"],
  "agents": ["./agents"],
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [
          { "type": "command", "command": "bash hooks/validate-bash.sh" }
        ]
      }
    ]
  },
  "mcpServers": {
    "internal-api": {
      "type": "http",
      "url": "https://internal.example.com/mcp"
    }
  }
}
Le Plugins Catalog de Snowflake vous permet de déployer des plugins dans le registre intégré de Snowflake. Vous pouvez ainsi les partager et les découvrir dans toute votre organisation, avec une gouvernance et un contrôle des accès natifs.
La reproductibilité distingue les professionnels de ceux qui se contentent de saisir des prompts. Dans un monde nativement pensé pour l’IA, les data engineers qui feront la différence seront ceux qui encodent le savoir institutionnel dans des skills, des plugins et des standards. Leur objectif : renforcer les capacités de toute leur équipe, pas seulement les leurs.
Premiers pas
Si vous êtes data engineer et n’utilisez pas encore régulièrement d’agents de programmation basés sur l’IA, n’attendez plus. Commencez par la documentation de CoCo et les guides Quickstart de prise en main de CoCo CLI et de Desktop. À partir d’exemples Snowflake concrets, ils vous accompagnent dans l’installation, vos premières requêtes, la gestion des sessions et bien plus encore.
Si vous utilisez déjà des agents de programmation basés sur l’IA, mais travaillez encore surtout avec des prompts ponctuels, commencez à créer des skills et des plugins à l’aide de ce guide Quickstart. C’est là que les gains commencent à se cumuler.


