4. Sept. 2026/Lesezeit: 8 MinutenKI und ML
Erstellen Sie reproduzierbare Datenpipelines mit CoCo, Snowflakes KI-Coding-Agenten

KI-Slop ist allgegenwärtig. Und aus irgendeinem Grund sind die Leute immer noch beeindruckt, dass jemand einen einfachen Prompt in natürlicher Sprache schreiben und darauf warten konnte, dass der KI-Coding-Agent eine große Menge an Code oder Text ausspuckt. Coding-Tools mit generativer KI sind die Zukunft und verändern die Software- und Data-Engineering-Landschaft grundlegend. Aber die Tatsache, dass KI-Coding-Agenten im Grunde unendlich viel Code generieren können, ist gar nicht so interessant.
Was stattdessen zählt, ist, wie professionelle Data Engineers über diese Tools denken und sie nutzen sollten. Jede:r kann einen KI-Agenten dazu bringen, ein Ergebnis zu liefern – das ist keine Leistung. Was einen professionellen Data Engineer von allen anderen unterscheidet, ist die Fähigkeit, KI-Tools zu nutzen, um wiederholbare, qualitativ hochwertige Ergebnisse zu erzielen. Das ist das Ziel dieses Beitrags: aufkommende Best Practices für das Data Engineering mit KI-Coding-Agenten und insbesondere mit Snowflake CoCo zu teilen.
In diesem Beitrag finden Sie vier Best Practices für professionelles KI-gestütztes Data Engineering, die Gründe, warum CoCo generische Coding-Agenten für Snowflakeübertrifft , sowie Möglichkeiten zur Entwicklung von Skills und Plugins, die die Workflows Ihres Teams reproduzierbar machen.
Best Practices für das Data Engineering mit KI-Coding-Agenten
Es gibt einige allgemeine Best Practices, die erwähnt werden sollten, bevor wir uns mit der Einrichtung befassen:
- Fangen Sie klein an und iterieren Sie aus Fehlern: Widerstehen Sie dem Drang, Dinge im Vorfeld zu überentwickeln. Führen Sie Prompts aus, achten Sie darauf, was der Agent falsch macht, und fügen Sie dann eine Regel hinzu.
- Verstehen Sie, dass das Modell bereits intelligent ist: Aktuelle Frontier-Modelle sind mit aktuellen Daten trainiert und in der Lage, die meisten Data Engineering-Aufgaben zu bewältigen. Sie müssen dem Modell in der Regel nur mitteilen, was es nicht ableiten kann.
- Behandeln Sie Prägnanz als harte Einschränkung: Das Kontextfenster ist fest vorgegeben und wird während der Sitzung geteilt. Hinterfragen Sie jeden Satz: Braucht der Agent das wirklich?
- Machen Sie Reproduzierbarkeit zum Ziel: Anweisungen, Skills und Tools verwandeln individuelles Fachwissen in wiederholbare, qualitativ hochwertige Ergebnisse.
Es gibt zwei weitere, die besondere Aufmerksamkeit verdienen, da wir bereits sehen, dass Leute Coding-Agenten auf eine Weise nutzen, die echte Probleme verursacht.
Erstens: Agenten ersetzen keine Data-Engineering-Tools für Unternehmen. KI-Coding-Agenten können Data Engineers beim Entwerfen, Erstellen und Überwachen von Datenpipelines helfen – aber in der Produktion sollten sie die dafür entwickelten Tools verwenden: dbt für die Transformation und DCM-Tools wie schemachange, Flyway oder Terraform für das Deployment. Die Verwendung von Agenten zur direkten Ausführung von Aktivitäten in der Produktion ohne etablierte Tools führt zu Anfälligkeit.
Zweitens und eng damit verbunden: Agenten sollten keine Änderungen direkt in der Produktion vornehmen. Selbst bei klaren Anweisungen generieren Agenten während der Ausführung dynamisch Inhalte, was bedeutet, dass die Ausgabe nicht deterministisch ist. Es war schon immer eine schlechte Praxis, nicht deterministischen Prozessen zu erlauben, direkt in einer Produktionsumgebung zu agieren. Das Hinzufügen von KI ändert daran nichts.
Warum CoCo für Snowflake Data Engineers
Frontier-LLMs sind bereits sehr effektiv für die meisten Data-Engineering-Aufgaben. Die meisten KI-Coding-Tools, die diese LLMs nutzen, sind wirklich nützlich. Aber für Data Engineers, die mit Snowflake arbeiten, ist CoCo die beste Wahl. Hier ist der Grund:
- Die Inferenz läuft innerhalb des Snowflake-Sicherheitsbereichs: Das LLM wird innerhalb der Snowflake-Infrastruktur bereitgestellt und ausgeführt, anstatt an einen externen KI-Anbieter weitergeleitet zu werden, und Ihre Daten werden unter den Governance-Kontrollen und Datenklassifizierungsrichtlinien von Snowflake verarbeitet.
- Native Snowflake-Integration: CoCo kann Ihre Schemas, Tabellen, Warehouse-Konfiguration und den Abfrageverlauf ab dem ersten Prompt lesen.
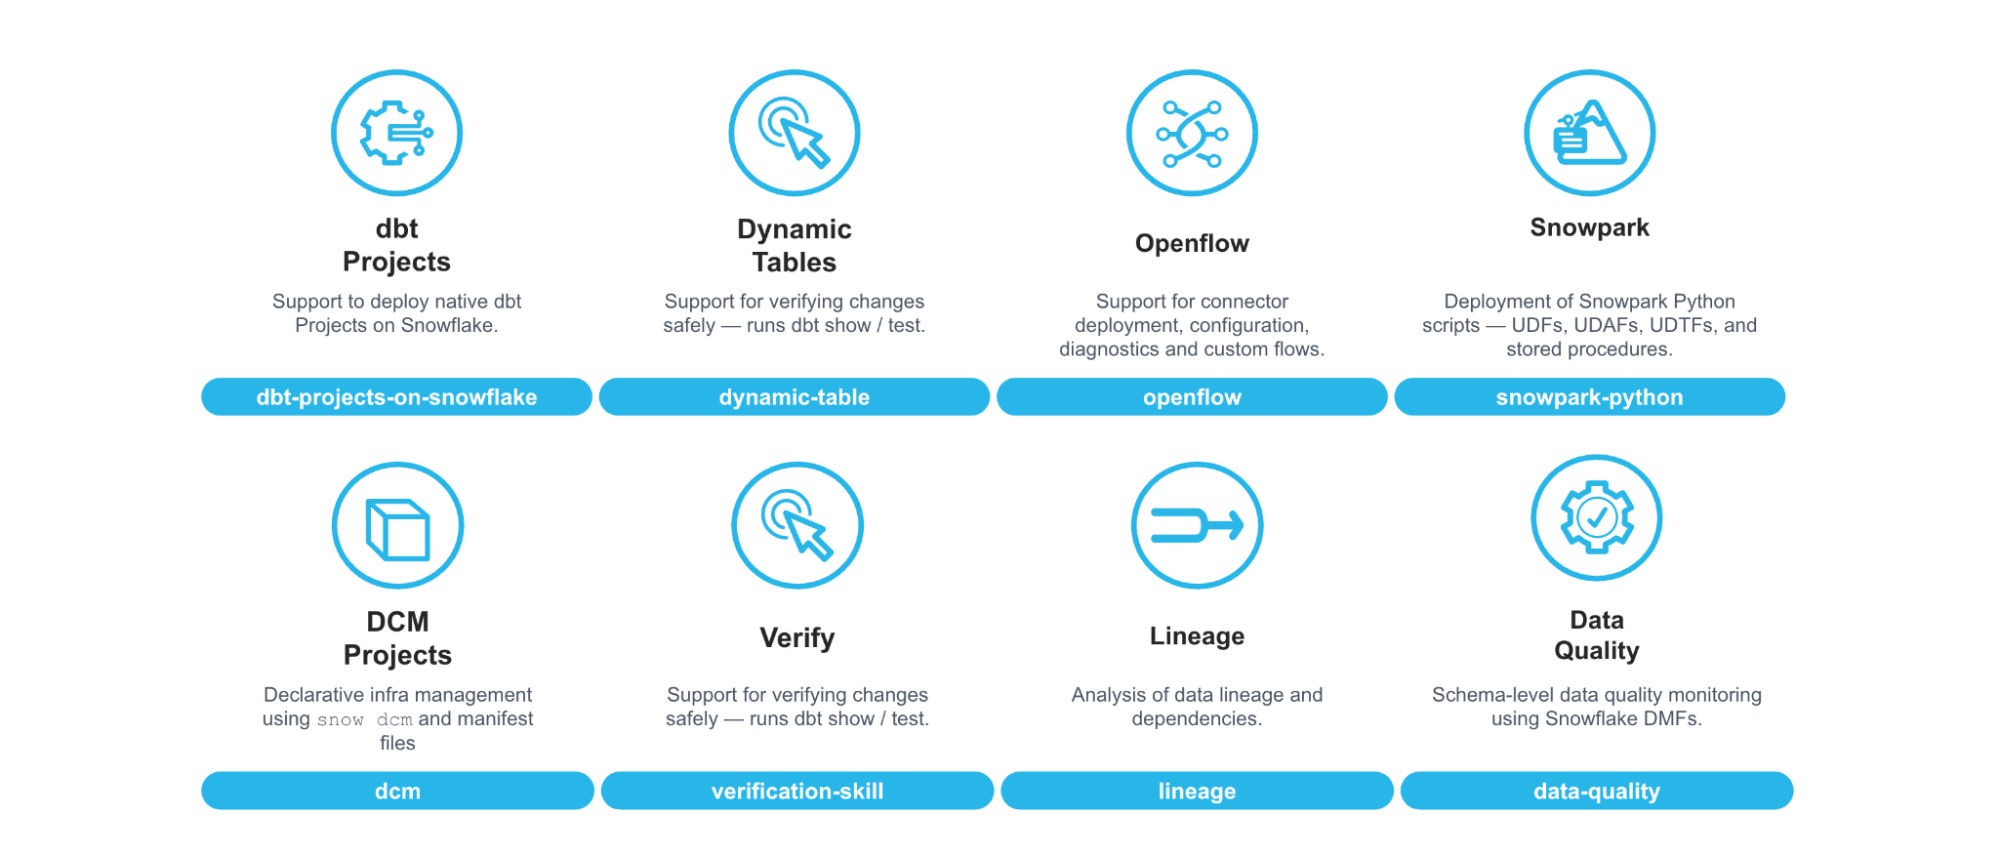
- Eine große Auswahl an integrierten Skills für native Snowflake-Workflows: Dynamic Tables, Snowpipe Streaming, Snowflake Openflow, Spark-Migration, dbt, Snowpark, maschinelles Lernen, DCM und mehr werden jeweils automatisch geladen, wenn Ihr Prompt mit der Domäne übereinstimmt.
- Modellflexibilität: Wählen Sie aus Top-Frontier-Modellen, einschließlich führender Open-Source-Modelle und mehr, die auf die Aufgabe abgestimmt sind.
So greifen Sie auf CoCo zu: CLI, Desktop und Snowsight
CoCo läuft in drei Umgebungen. Die CLI ist ein Befehlszeilentool für Terminal-native Engineers. Der Desktop ist eine vollständige VS-Code-basierte IDE – ideal für alle, die ihr lokales Repo und OS-Tooling neben der Snowflake-nativen Intelligence nutzen möchten. CoCo in Snowsight erfordert keine Installation; es ist die richtige Wahl für Engineers, die lang laufende Aufgaben in Snowflakes Cloud starten und zu abgeschlossener Arbeit zurückkehren möchten. Alle drei teilen sich größtenteils dieselbe Funktionalität.
Um die CoCo CLI zu installieren, verwenden Sie Folgendes:
- macOS oder Linux (einschließlich WSL):
curl -LsS https://ai.snowflake.com/static/cc-scripts/install.sh | sh
- Windows (nativ, PowerShell):
irm https://ai.snowflake.com/static/cc-scripts/install.ps1 | iex
Laden Sie CoCo Desktop unter ai.snowflake.com herunter. Greifen Sie direkt über die linke Navigation auf CoCo in Snowsight zu – keine Installation erforderlich.
Sobald die Verbindung hergestellt ist, verwendet CoCo Ihre bestehende Snowflake-Verbindung. Führen Sie /status aus, um zu bestätigen, dass es funktioniert, und stellen Sie dann Ihre erste Frage:
What databases do I have access to?So erstellen Sie reproduzierbare Workflows mit CoCo-Skills und -Plugins
Mit einer Reihe von einmaligen Prompts kann jede:r einen KI-Agenten dazu bringen, ein Ergebnis zu liefern. Aber diese Ergebnisse variieren stark von einer Aktivität oder Person zur nächsten. Professionelle Data Engineers lösen Probleme nicht nur einzeln – sie codieren Lösungen.
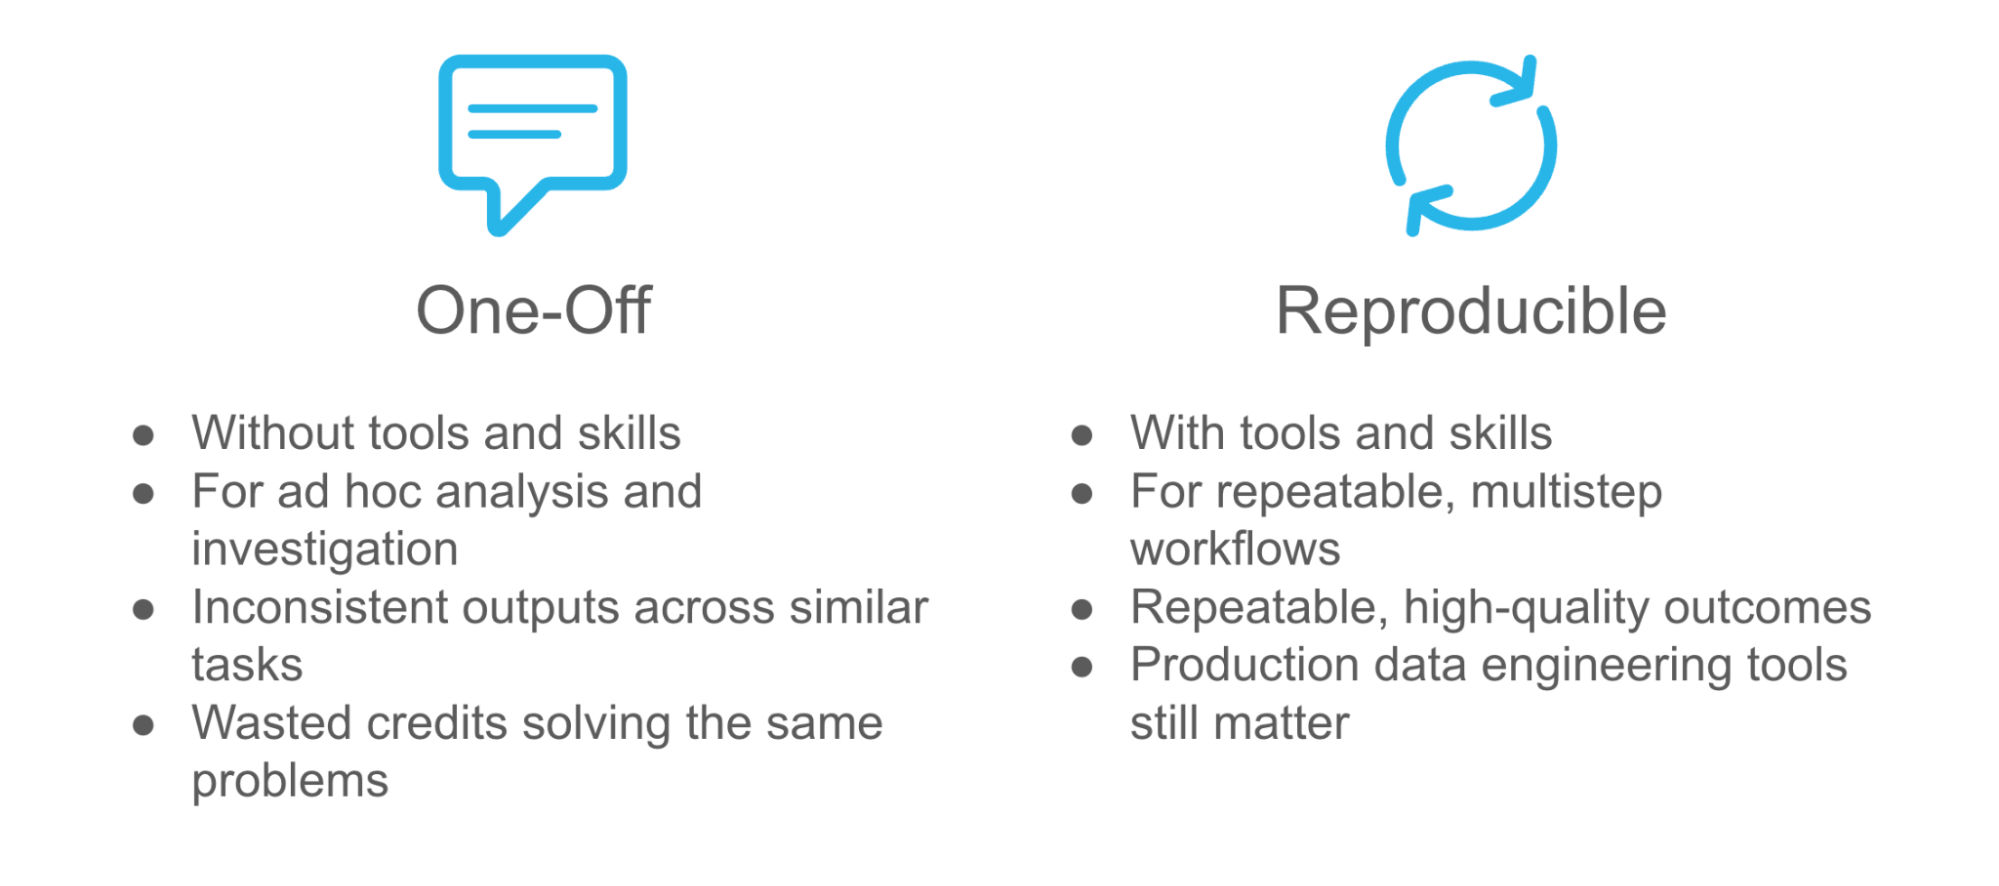
Es haben sich mehrere Standards herausgebildet, die Data Engineers dabei helfen, reproduzierbare Lösungen zu codieren:
- AGENTS.md: Konventionen auf Repo-Ebene, Befehle und Projektstrukturen, die sich von Sitzung zu Sitzung nicht ändern
- Skills: Markdown-Dateien, die domänenspezifische Anweisungen und Wissen in eine Sitzung einbringen
- Subagenten: Benutzerdefinierte Agentendefinitionen für spezialisierte, autonome Aufgaben
- Slash-Befehle: Befehle im Projektstil, die über den CoCo-CLI-Prompt aufgerufen werden
- Hooks: Lifecycle-Hooks, die bei Ereignissen wie PreToolUse oder UserPromptSubmit ausgeführt werden
- MCP-Server: Model-Context-Protocol-Server, die dem Agenten externe Tools zur Verfügung stellen
Die folgenden Abschnitte behandeln Skills und Plugins, die für die ersten Schritte am wichtigsten sind.
Agenten-Skills
Skills implementieren wiederholbare, mehrstufige Workflows. Sie bestehen aus Anweisungen sowie Skripten und Tools und werden von den meisten KI-Coding-Agenten unterstützt. Der offene Standard ist unter agentskills.io dokumentiert:
„Agenten-Skills sind ein leichtgewichtiges, offenes Format zur Erweiterung der Fähigkeiten von KI-Agenten um spezialisiertes Wissen und Workflows. Im Kern ist ein Skill ein Ordner, der eine SKILL.md-Datei enthält. Diese Datei enthält Metadaten (mindestens Name und Beschreibung) und Anweisungen, die einem Agenten mitteilen, wie er eine bestimmte Aufgabe ausführen soll. Skills können auch Skripte, Referenzmaterialien, Vorlagen und andere Ressourcen bündeln.“
Eine wichtige Sache, die Sie beim Erstellen von Skills beachten sollten: Das Modell ist bereits intelligent. Sie müssen ihm in der Regel nur mitteilen, was es nicht ableiten kann. Für dbt müssen Sie dem Modell nicht beibringen, was dbt ist oder wie man ein Projekt erstellt – das Modell weiß das bereits. Was Sie in einem Skill erfassen, ist jeder wiederholbare Prozess, der spezifisch für Ihr Team ist: die genauen Schritte, die beim Erstellen und Testen eines dbt-Projekts zu befolgen sind, Ihre Namenskonventionen oder Ihre Partitionierungsstrategie.
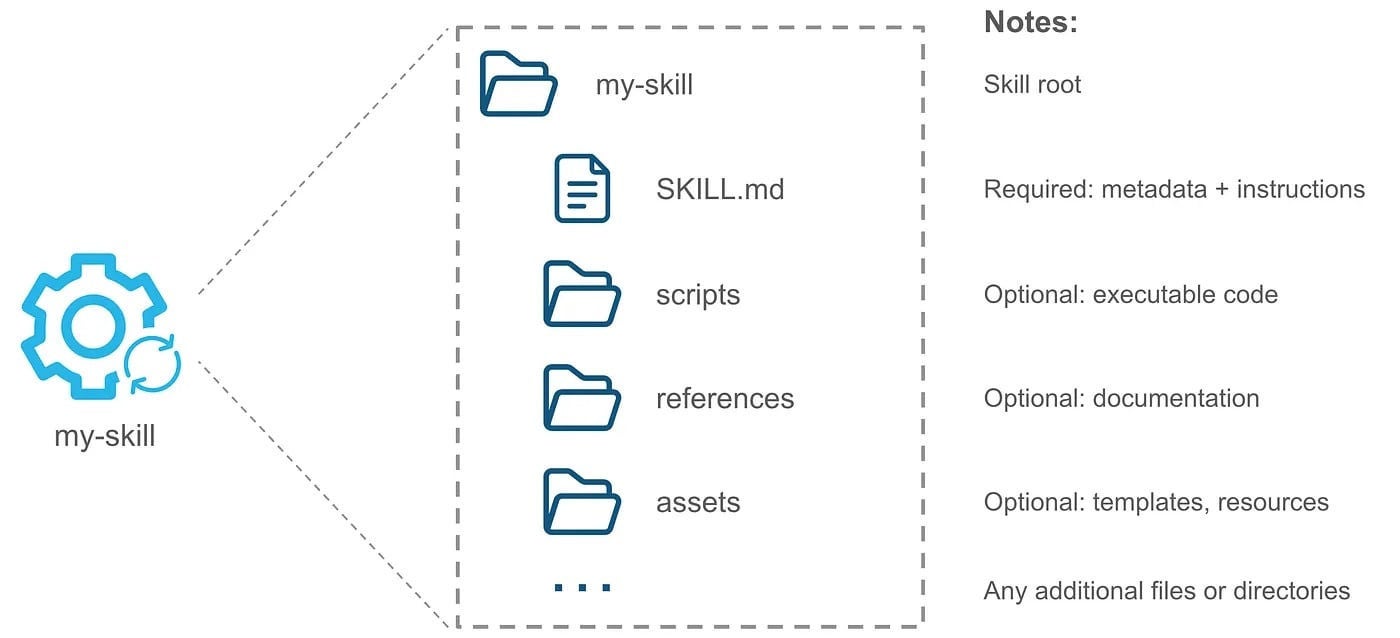
Skills werden in natürlicher Sprache über Markdown-Dateien definiert. Die Kernanweisungen befinden sich in einer SKILL.md-Datei. Mindestens ist ein Skill ein Ordner mit dieser einzigen Datei – aber die wahre Stärke liegt in der Bündelung wiederverwendbarer Skripte in einem /scripts-Ordner, was einen Skill konsistent und reproduzierbar macht.
Die SKILL.md-Datei beginnt mit YAML-Frontmatter, gefolgt von Markdown-Anweisungen. Nur name und description sind erforderlich; das Modell verwendet die Beschreibung, um zu entscheiden, wann der Skill aufgerufen werden soll. Hier ist ein minimales Beispiel:
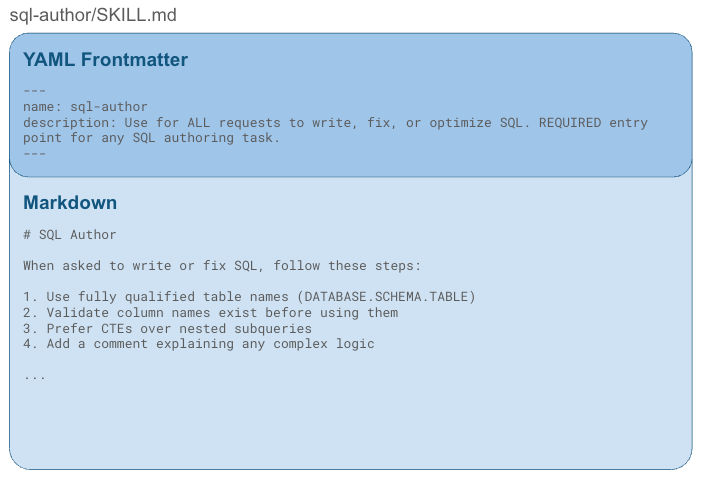
Wenn Ihr Team über institutionelles Wissen verfügt, für dessen Aneignung neue Engineers Wochen benötigen, kann ein Skill dieses Wissen kodieren und CoCo für jede Sitzung zur Verfügung stellen. Skills sind ein offener Standard, der von den meisten KI-Coding-Agenten implementiert wird. Die Verwaltung ihres Lebenszyklus – Versionierung, Bereitstellung und Updates – ist der Punkt, an dem Plugins ins Spiel kommen.
CoCo-Plugins
Professionelles Data Engineering erfordert professionelle SDLC-Praktiken, und die individuelle Verwaltung von Skills ist schwieriger, als es aussieht. Plugins lösen dieses Problem mit einer umfassenderen Paketierungs- und Bereitstellungseinheit, die Skills, Subagenten, Slash-Befehle, Hooks und MCP-Server in einer einzigen verwalteten Einheit bündelt.
Plugins sind eine bessere Paketierungs- und Bereitstellungseinheit als Skills allein, da Plugins Folgendes sind:
- Versioniert: Das Manifest verfügt über ein Versionsfeld; Skills allein nicht.
- In CI validierbar: „cortex plugin validate“ bietet Ihnen eine formale Prüfung vor der Auslieferung.
- In einer einzigen installierbaren Einheit: „cortex plugin install“ ist ein einziger Befehl; Skills erfordern „cortex skill add“ für jeden Skill.
- Aktualisierbar: „cortex plugin update“ ruft die neueste Version aus der registrierten Quelle ab.
- Bündelbar: Ein Plugin enthält Skills, Hooks, MCP-Server und Subagenten als kohärente Funktion.
- Fähig zur Nutzung von Registry-Tracking: Installierte Plugins werden in registry.json mit Quelle, Installationszeit und aktivem Status aufgezeichnet.
Ein Plugin ist ein in sich geschlossenes Verzeichnis mit einer Manifestdatei an einem bekannten Pfad:
my-plugin/
├── .cortex-plugin/
│   ├── plugin.json          # manifest (required)
│   └── activation.md
├── skills/
│   └── my-skill/SKILL.md
├── commands/
│   └── my-command.md
├── agents/
│   └── my-agent.md
├── hooks/hooks.json
└── .mcp.json
Die Schlüsseldatei ist plugin.json:
{
  "name": "data-engineering",
  "description": "Skills, hooks, and MCP servers for Snowflake data engineering",
  "version": "1.0.0",
  "author": { "name": "Data Platform Team" },
  "skills": ["./skills"],
  "agents": ["./agents"],
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [
          { "type": "command", "command": "bash hooks/validate-bash.sh" }
        ]
      }
    ]
  },
  "mcpServers": {
    "internal-api": {
      "type": "http",
      "url": "https://internal.example.com/mcp"
    }
  }
}
Mit dem Plugins Catalog von Snowflake können Sie Plugins in der integrierten Registry von Snowflake bereitstellen und so die Freigabe und Erkennung in Ihrem gesamten Unternehmen mit nativer Governance und Zugriffskontrolle ermöglichen.
Reproduzierbarkeit ist der Standard, der Profis von Prompt-Tippern unterscheidet. Die Data Engineers, die in einer KI-nativen Welt am wichtigsten sein werden, sind diejenigen, die institutionelles Wissen in Skills, Plugins und Standards kodieren, die ihr gesamtes Team fähiger machen, nicht nur sich selbst.
Jetzt entdecken
Wenn Sie Data Engineer sind und KI-Coding-Agenten noch nicht regelmäßig nutzen, sollten Sie nicht länger warten. Beginnen Sie mit der CoCo-Dokumentation und den Erste Schritte-Schnellstarts für CoCo CLI und Desktop – sie führen Sie anhand echter Snowflake-Beispiele durch die Installation, erste Abfragen, Sitzungsverwaltung und mehr.
Wenn Sie bereits KI-Coding-Agenten verwenden, aber immer noch einzelne Prompts ausführen, erstellen Sie mithilfe dieses Quickstart Guides Skills und Plugins. Dort liegen die Zinseszinseffekte.