3 novembre 2026/Lettura: 10 minAI e ML
Prendi il controllo dei tuoi modelli AI con Cortex Training

Ogni applicazione di AI in produzione genera milioni di punti dati preziosi sulla tua attività, tra cui preferenze dei clienti, modelli di utilizzo e risultati, ma la maggior parte delle aziende non li sfrutta mai. Molte si limitano a costruire agenti AI basati su modelli foundation chiusi, che possono essere costosi e privi di una comprensione approfondita della tua attività. Con i modelli open-weight sempre più competitivi rispetto ai modelli frontier, le aziende hanno l’opportunità di personalizzare l’AI utilizzando i propri dati e il proprio contesto. In passato questo richiedeva la gestione di infrastrutture GPU complesse e costose, oppure il ricorso ad API gestite che offrono una flessibilità e un controllo limitati.
Oggi siamo entusiasti di annunciare la public preview di Cortex Training, la soluzione serverless Snowflake per la personalizzazione e il deployment di LLM open-weight. Con Cortex Training, i team possono utilizzare framework di training familiari oppure creare loop di training personalizzati avanzati con API serverless di basso livello, tutto senza gestire le complessità del provisioning delle GPU, della pianificazione, del checkpointing e dell’esecuzione distribuita.
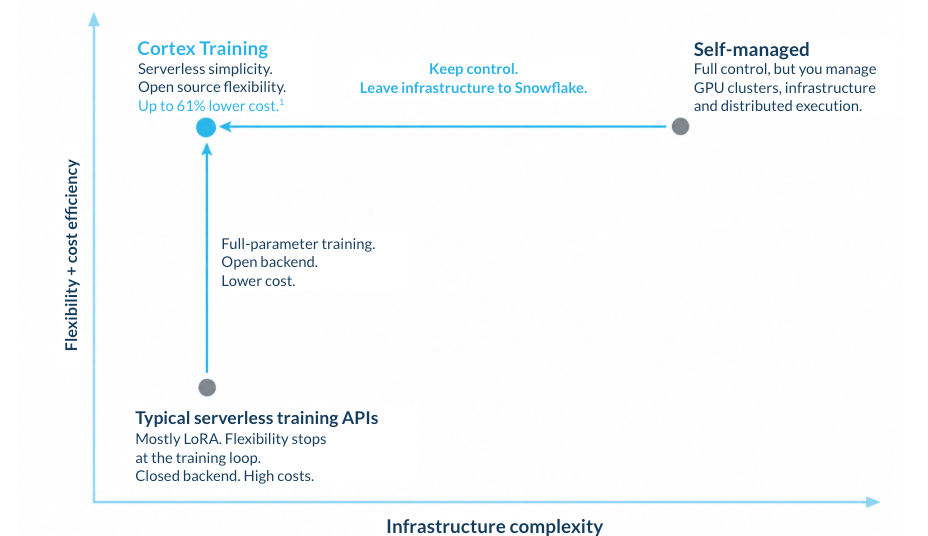
Cortex Training è costruito su un backend open source altamente personalizzabile e ottimizzato, che porta la flessibilità e l’efficienza di un complesso cluster di training bare-metal autogestito in un’esperienza serverless semplificata. I benchmark mostrano una riduzione dei costi fino al 61% rispetto alle soluzioni serverless concorrenti,[1] quindi i team non devono più rinunciare alla semplicità in cambio di flessibilità o efficienza dei costi nella personalizzazione e nel deployment dei modelli.
Con Cortex Training, i team possono utilizzare la piattaforma dati integrata Snowflake per curare facilmente set di dati pronti per il training e catturare trace e log degli agenti AI, creando un ciclo di feedback per la personalizzazione e il miglioramento dei modelli.
Perché le aziende hanno bisogno del post-training
I modelli open-weight pronti all’uso sono generici di default, ma possono essere altamente ottimizzati per il dominio, i dati proprietari, i casi d’uso e il budget di ogni azienda attraverso il post-training. I metodi di post-training come SFT e RL sono il modo in cui gli LLM imparano i comportamenti previsti e come prendere decisioni più accurate ed efficienti in termini di costi utilizzando il contesto specifico della tua organizzazione.
SFT insegna ai modelli il comportamento che ci si aspetta da loro. Utilizzando esempi di alta qualità, le aziende possono insegnare a un agente AI del servizio clienti come diagnosticare problemi, comunicare con i clienti, applicare politiche di escalation e seguire pattern di tool-calling e workflow consolidati. Invece di affidarsi al prompting per specificare ogni passaggio, il modello apprende dalle interazioni di esempio come ci si aspetta che venga svolto il lavoro.
RL insegna ai modelli come prendere decisioni migliori per raggiungere i risultati desiderati. A differenza di SFT, che apprende dalle dimostrazioni, RL ottimizza il comportamento attraverso il feedback su risultati misurabili, come la risoluzione dei problemi, la conformità alle policy, la latenza e i costi. Ad esempio, un agente AI del servizio clienti può imparare quando attivare un sistema di ticketing, chiamare un’API di fatturazione o effettuare l’escalation verso un operatore umano. Apprendendo dal feedback su molte traiettorie di interazione, può scoprire modi più efficaci per completare le attività, evitando chiamate agli strumenti e passaggi non necessari, bilanciando al contempo qualità, velocità e costi.
Presentiamo Cortex Training
Cortex Training è la soluzione serverless Snowflake per creare e distribuire modelli open-weight personalizzati. I team AI mantengono un controllo granulare su SFT, RL e loop di training personalizzati, mentre Snowflake gestisce l’infrastruttura GPU, permettendo agli sviluppatori di concentrarsi sul miglioramento dei modelli piuttosto che sulla gestione dei cluster.
Cortex Training è costruito su un backend open source altamente personalizzabile e ottimizzato, che porta la flessibilità e l’efficienza di complessi deployment bare-metal autogestiti in un’esperienza serverless semplificata. Supporta un’ampia gamma di famiglie di modelli open-weight, supervised fine-tuning (SFT) e reinforcement learning (RL) con training full-parameter o LoRA, e l’orchestrazione tramite framework open source popolari come SkyRL, Hugging Face TRL e veRL.
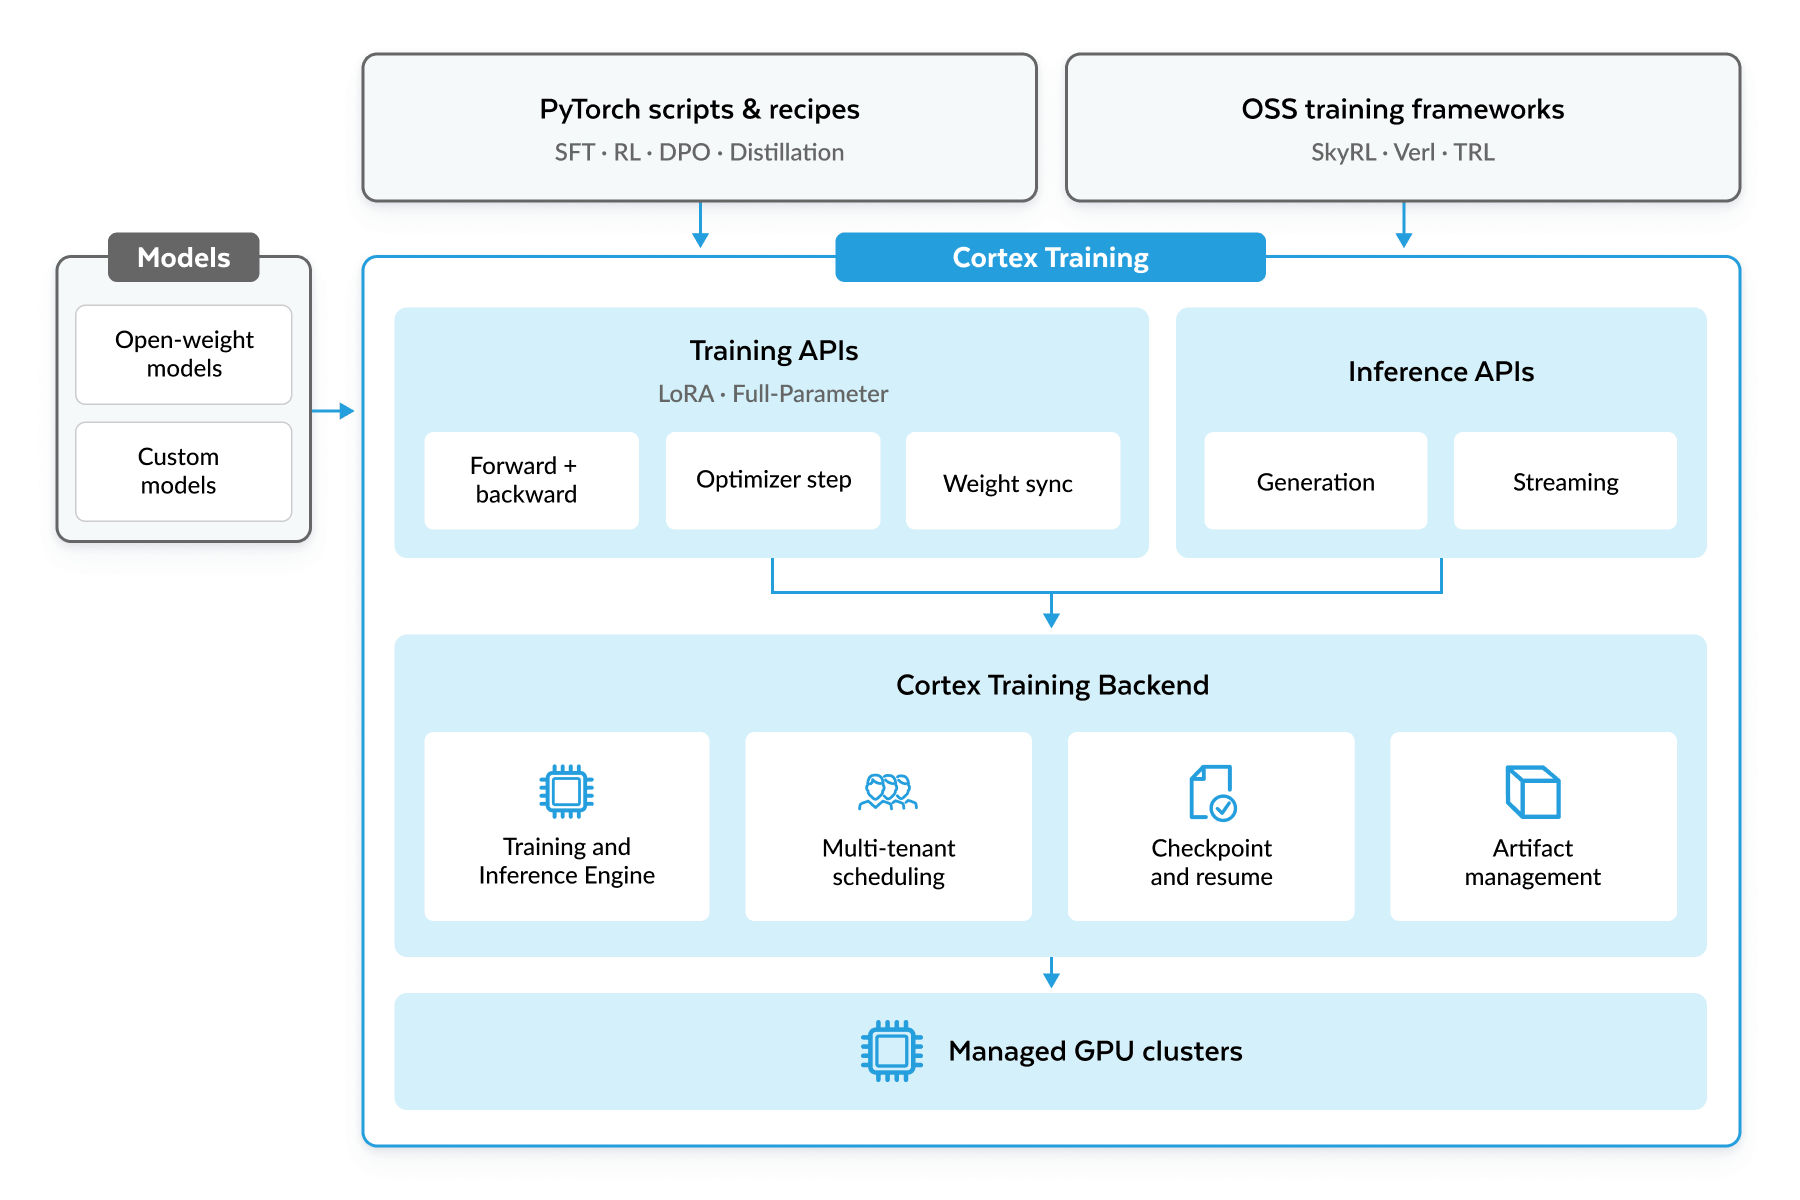
La piattaforma supporta l’intero ciclo di vita del modello: fare il benchmark dei principali modelli open-weight, personalizzarli con framework di training popolari o API di training serverless di basso livello, valutare e confrontare i checkpoint, e distribuirli tramite endpoint di inferenza compatibili con OpenAI. Questo crea un flywheel continuo in cui i dati di produzione e il feedback alimentano modelli sempre più capaci e specializzati.
Cortex Training estende i controlli di governance Snowflake a tutto il ciclo di vita del modello. I controlli di accesso basati sui ruoli regolano i dati di training, l’addestramento del modello, il deployment e l’inferenza, mentre i dati, i pesi del modello e lo stato dell’optimizer rimangono all’interno dell’ambiente gestito Snowflake.

In ResolveAI miglioriamo l’affidabilità del software affidando agli agenti AI SRE il percorso critico e assumendoci la responsabilità del risultato. Costruire SRE sovrumani in grado di analizzare e risolvere in autonomia i problemi in produzione richiede un addestramento su attività a lungo orizzonte, con job eseguiti su centinaia o anche più di mille GPU. Le API serverless di Cortex Training ci permettono di operare su questa scala senza dover gestire l’infrastruttura sottostante né ottimizzare i cluster. Inoltre, l’esperienza del team Snowflake in ambito di sistemi integra la nostra ricerca sull’AI, permettendoci di innovare rapidamente e di iterare fino a raggiungere i nostri obiettivi di prestazioni dei modelli.”
Sean Bell
Research Lead, ResolveAI
Concentrati sui modelli, non sull’infrastruttura GPU
Cortex Training fornisce API serverless che permettono ai team di concentrarsi sulla logica di training invece che sul provisioning e sulla gestione dell’infrastruttura GPU.
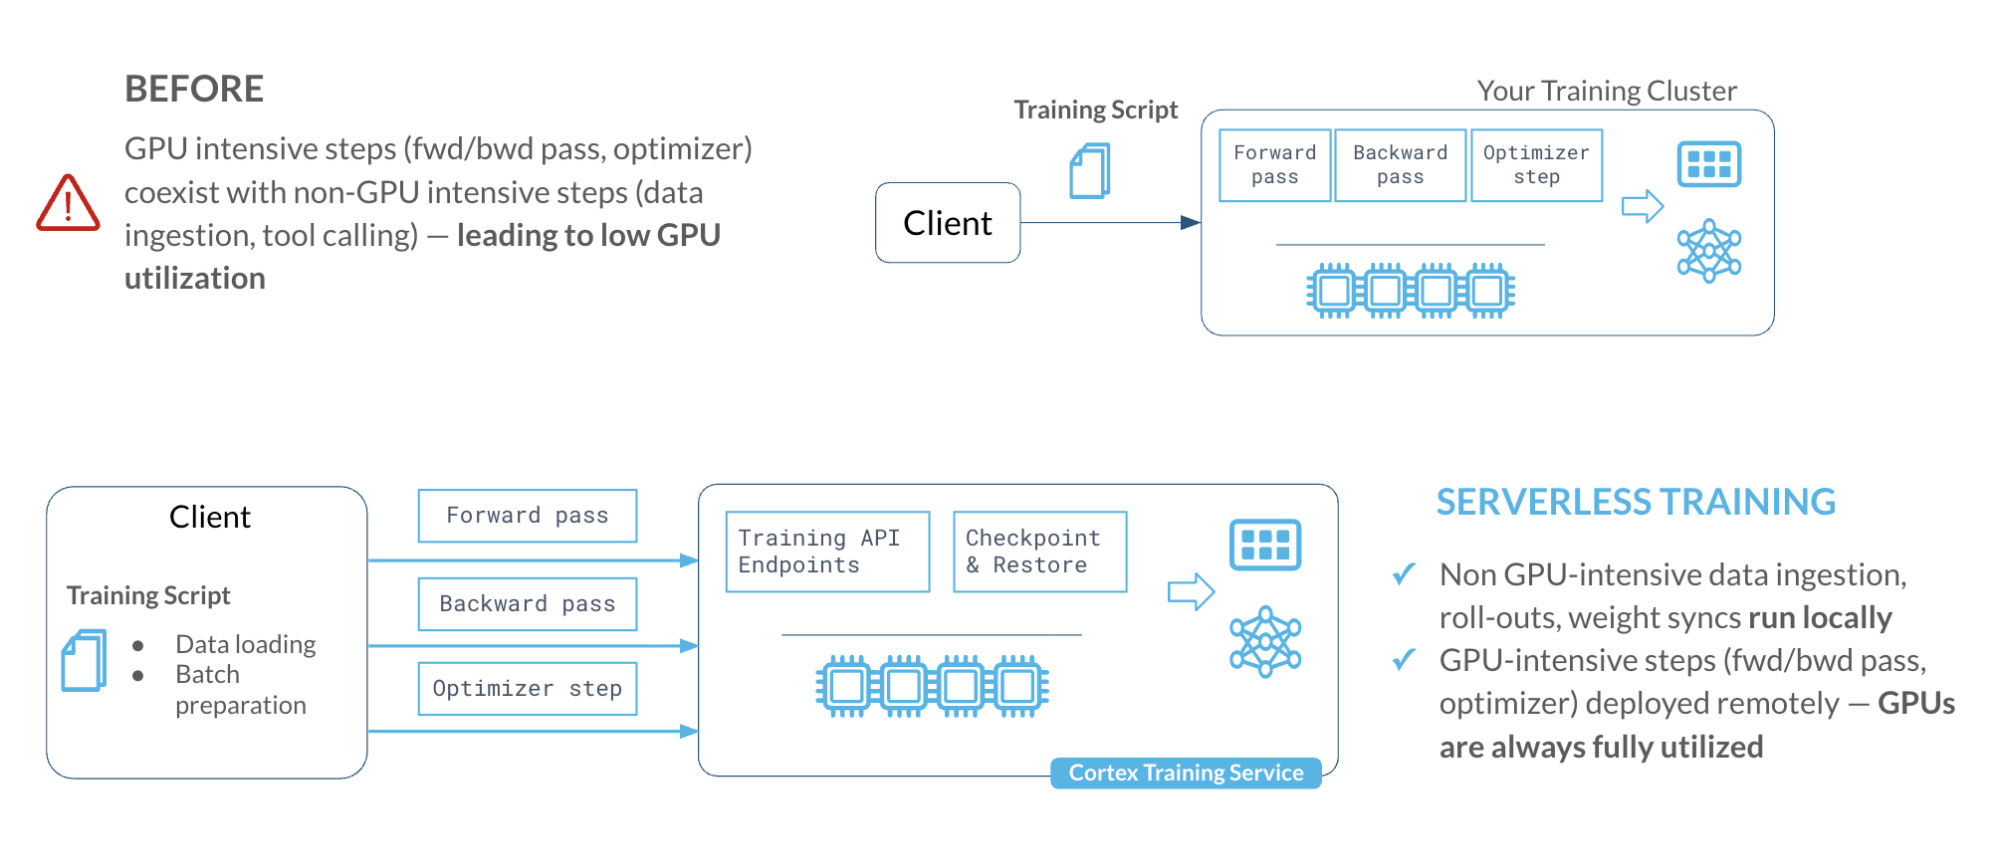
Il tuo script di training controlla il loop di training, mentre le API di Cortex Training gestiscono le operazioni GPU-intensive come i forward/backward pass, i passi dell’optimizer, la sincronizzazione dei pesi e la generazione. Tu definisci come apprende il modello; Snowflake gestisce le GPU, l’esecuzione distribuita, lo stato del modello e il checkpointing.
Attiva un circolo virtuoso di miglioramento dei modelli
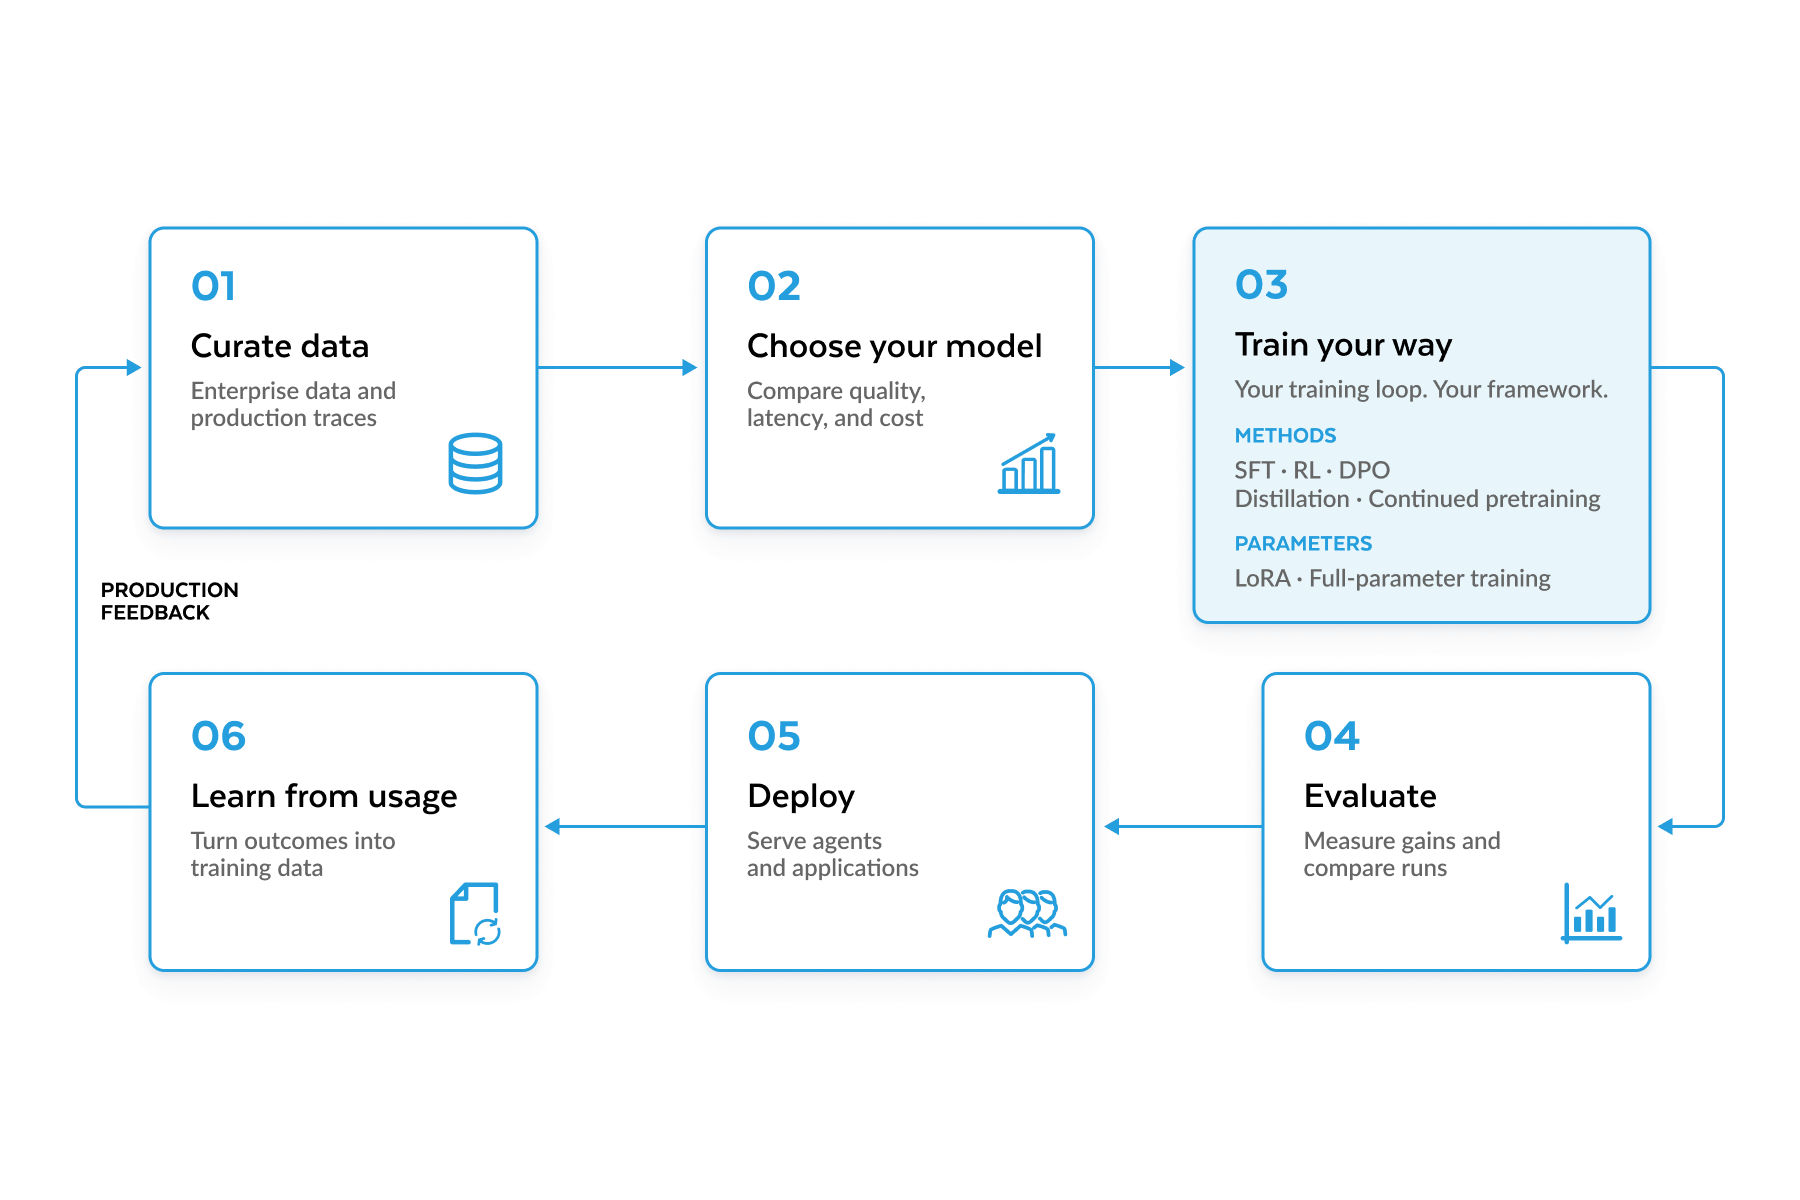
Snowflake abilita un flywheel di miglioramento dei modelli, dalla raccolta di trace e log degli agenti AI in produzione alla curatela dei dati di training, dalla personalizzazione dei modelli open-weight per le esigenze specifiche del business al deployment per le esigenze di inferenza.
Cura i tuoi dati
Una personalizzazione del modello efficace parte da dati di training di alta qualità. La piattaforma dati Snowflake permette ai team di pulire, filtrare, arricchire ed etichettare i dati aziendali, sia strutturati che non strutturati, trasformandoli in set di dati pronti per il training con Cortex AI Functions, SQL e Snowpark. Cortex AI Gateway aiuta a chiudere il ciclo di feedback tra gli agenti AI in produzione e il training dei modelli. I team possono catturare trace degli agenti AI, log e interazioni dei modelli per comprendere il comportamento degli agenti AI e identificare opportunità di miglioramento. Combinando questi segnali con i risultati applicativi e il feedback umano, i team possono curare set di dati di training di alto valore per SFT, ottimizzazione delle preferenze e RL, trasformando l’esperienza reale degli agenti AI in modelli in continuo miglioramento.
Esegui il benchmark e valuta il modello open-weight giusto
Inizia testando i modelli open-weight sul tuo workload prima di investire nella personalizzazione. Confronta i candidati sulle dimensioni che contano per la tua applicazione: qualità, latenza e costi. Cortex Training offre un ricco catalogo di modelli open-weight, tra cui famiglie come Qwen, GLM, Nemotron, Gemma e DeepSeek, con inferenza batch e streaming per facilitare il benchmarking dei modelli.
In OpenHands usiamo spesso l’RL per addestrare i modelli del nostro agente a gestire attività di programmazione quando un utente indica file o funzioni. In passato dovevamo gestire un nostro cluster di addestramento e dedicavamo da giorni a settimane alla gestione e al debugging del cluster. Con Snowflake Cortex Training possiamo dedicare il 100% del nostro tempo a esperimenti e addestramento. Inoltre, non abbiamo dovuto cambiare i nostri framework preferiti né rinunciare alla flessibilità.”
Jeff Ma and Parinthapat Pengpun
Ricercatori in OpenHands
Addestra e personalizza il modello a modo tuo
Una volta ottenuto un modello di base solido, adattalo utilizzando la strategia di training più adatta al tuo task. Cortex Training supporta modelli open-weight allo stato dell’arte (tra cui Qwen, Nemotron, Gemma, DeepSeek e altri) in una gamma di dimensioni di parametri. I team possono utilizzare il training LoRA o full-parameter per SFT, RL, direct preference optimization, distillation, continued pretraining e mid-training.
Cortex Training si integra con i framework di post-training più popolari, come Hugging Face TRL, PrimeRL, veRL e SkyRL, permettendo ai team che già li utilizzano di iniziare rapidamente. Si integra anche con piattaforme per agenti AI come OpenHands per addestrare modelli e interi harness per agenti AI. Oltre a queste integrazioni, le API serverless consentono la personalizzazione dei modelli guidata dagli agenti AI per i workload aziendali, riducendo la complessità del training e rendendo la personalizzazione accessibile anche senza competenze AI specializzate.
Per un maggiore controllo, i team ML più avanzati possono utilizzare API di livello inferiore per definire funzioni di loss personalizzate, architetture di modelli e loop di training. Ad esempio, Cortex Training fornisce API per generare rollout (risposte del modello o interazioni degli agenti), aggiornare i pesi del modello e sincronizzare tali pesi in tutto il sistema. Questi elementi costitutivi abilitano workflow RL che generano comportamenti in modo ripetuto, valutano i risultati e utilizzano tali risultati per migliorare il modello nel tempo.
Questa flessibilità si estende anche all’infrastruttura sottostante. Cortex Training è basato su Arctic Platform, un backend open source che offre agli utenti piena visibilità sul codice eseguito sulle GPU. I team più avanzati possono contribuire con PR e integrare tecniche e innovazioni emergenti dall’ampia community AI/ML nei propri workload di training.
Scopri i nostri esempi di Cortex Training per l’insieme completo di recipe, integrazioni e skill.
Nel team di modellazione di Snowflake AI Research sviluppiamo i nostri agenti di ingegneria del software, tra cui Arctic-SWE, su prime-rl, con Cortex Training come backend. Questo ci permette di sviluppare liberamente i nostri framework algoritmici e le nostre recipe sfruttando GPU serverless, con le dinamiche di addestramento necessarie per ottenere prestazioni SWE all’avanguardia, senza dover gestire il cluster.”
Boyi Liu
Senior Research Scientist, Snowflake AI Research
Valuta e itera
Il training ha valore solo se il nuovo modello è misurabilmente migliore. Cortex Training permette ai team di caricare i checkpoint addestrati per l’inferenza batch o di distribuirli dietro endpoint per la valutazione e il testing delle applicazioni. Puoi utilizzare Snowflake ML Experiments per monitorare le run di training, registrare metriche personalizzate, osservare le performance e confrontare le run tra i diversi esperimenti, ottenendo il pieno controllo sui dati catturati invece di affidarti al logging automatico. I checkpoint vengono salvati lato server, così i team possono riprendere il training o avviare nuovi esperimenti a partire da checkpoint precedenti.
Distribuisci ad agenti AI e applicazioni
Una volta che un modello raggiunge gli obiettivi di qualità e costo richiesti, i team possono distribuirlo per l’inferenza.
Cortex Training supporta endpoint di inferenza compatibili con OpenAI, basati su GPU dedicate, inclusa l’inferenza streaming per applicazioni e agenti AI interattivi e l’inferenza batch per esigenze non interattive.
Il ciclo di vita riparte quindi non appena le applicazioni in produzione generano nuove traiettorie, valutazioni e risultati: benchmark → training → generazione di rollout → valutazione → deployment e serving → apprendimento dalla produzione → nuovo training. È proprio questo ciclo che trasforma i dati aziendali e l’esperienza applicativa in modelli sempre più capaci e specializzati.
Efficienza dei costi grazie a una base open
Cortex Training fornisce configurazioni ottimizzate già pronte all’uso, mentre i team più avanzati possono ottimizzarle per workload specifici o contribuire con miglioramenti upstream. Poiché l’utilizzo viene fatturato in base al tempo di GPU, un training più rapido si traduce direttamente in costi più bassi.
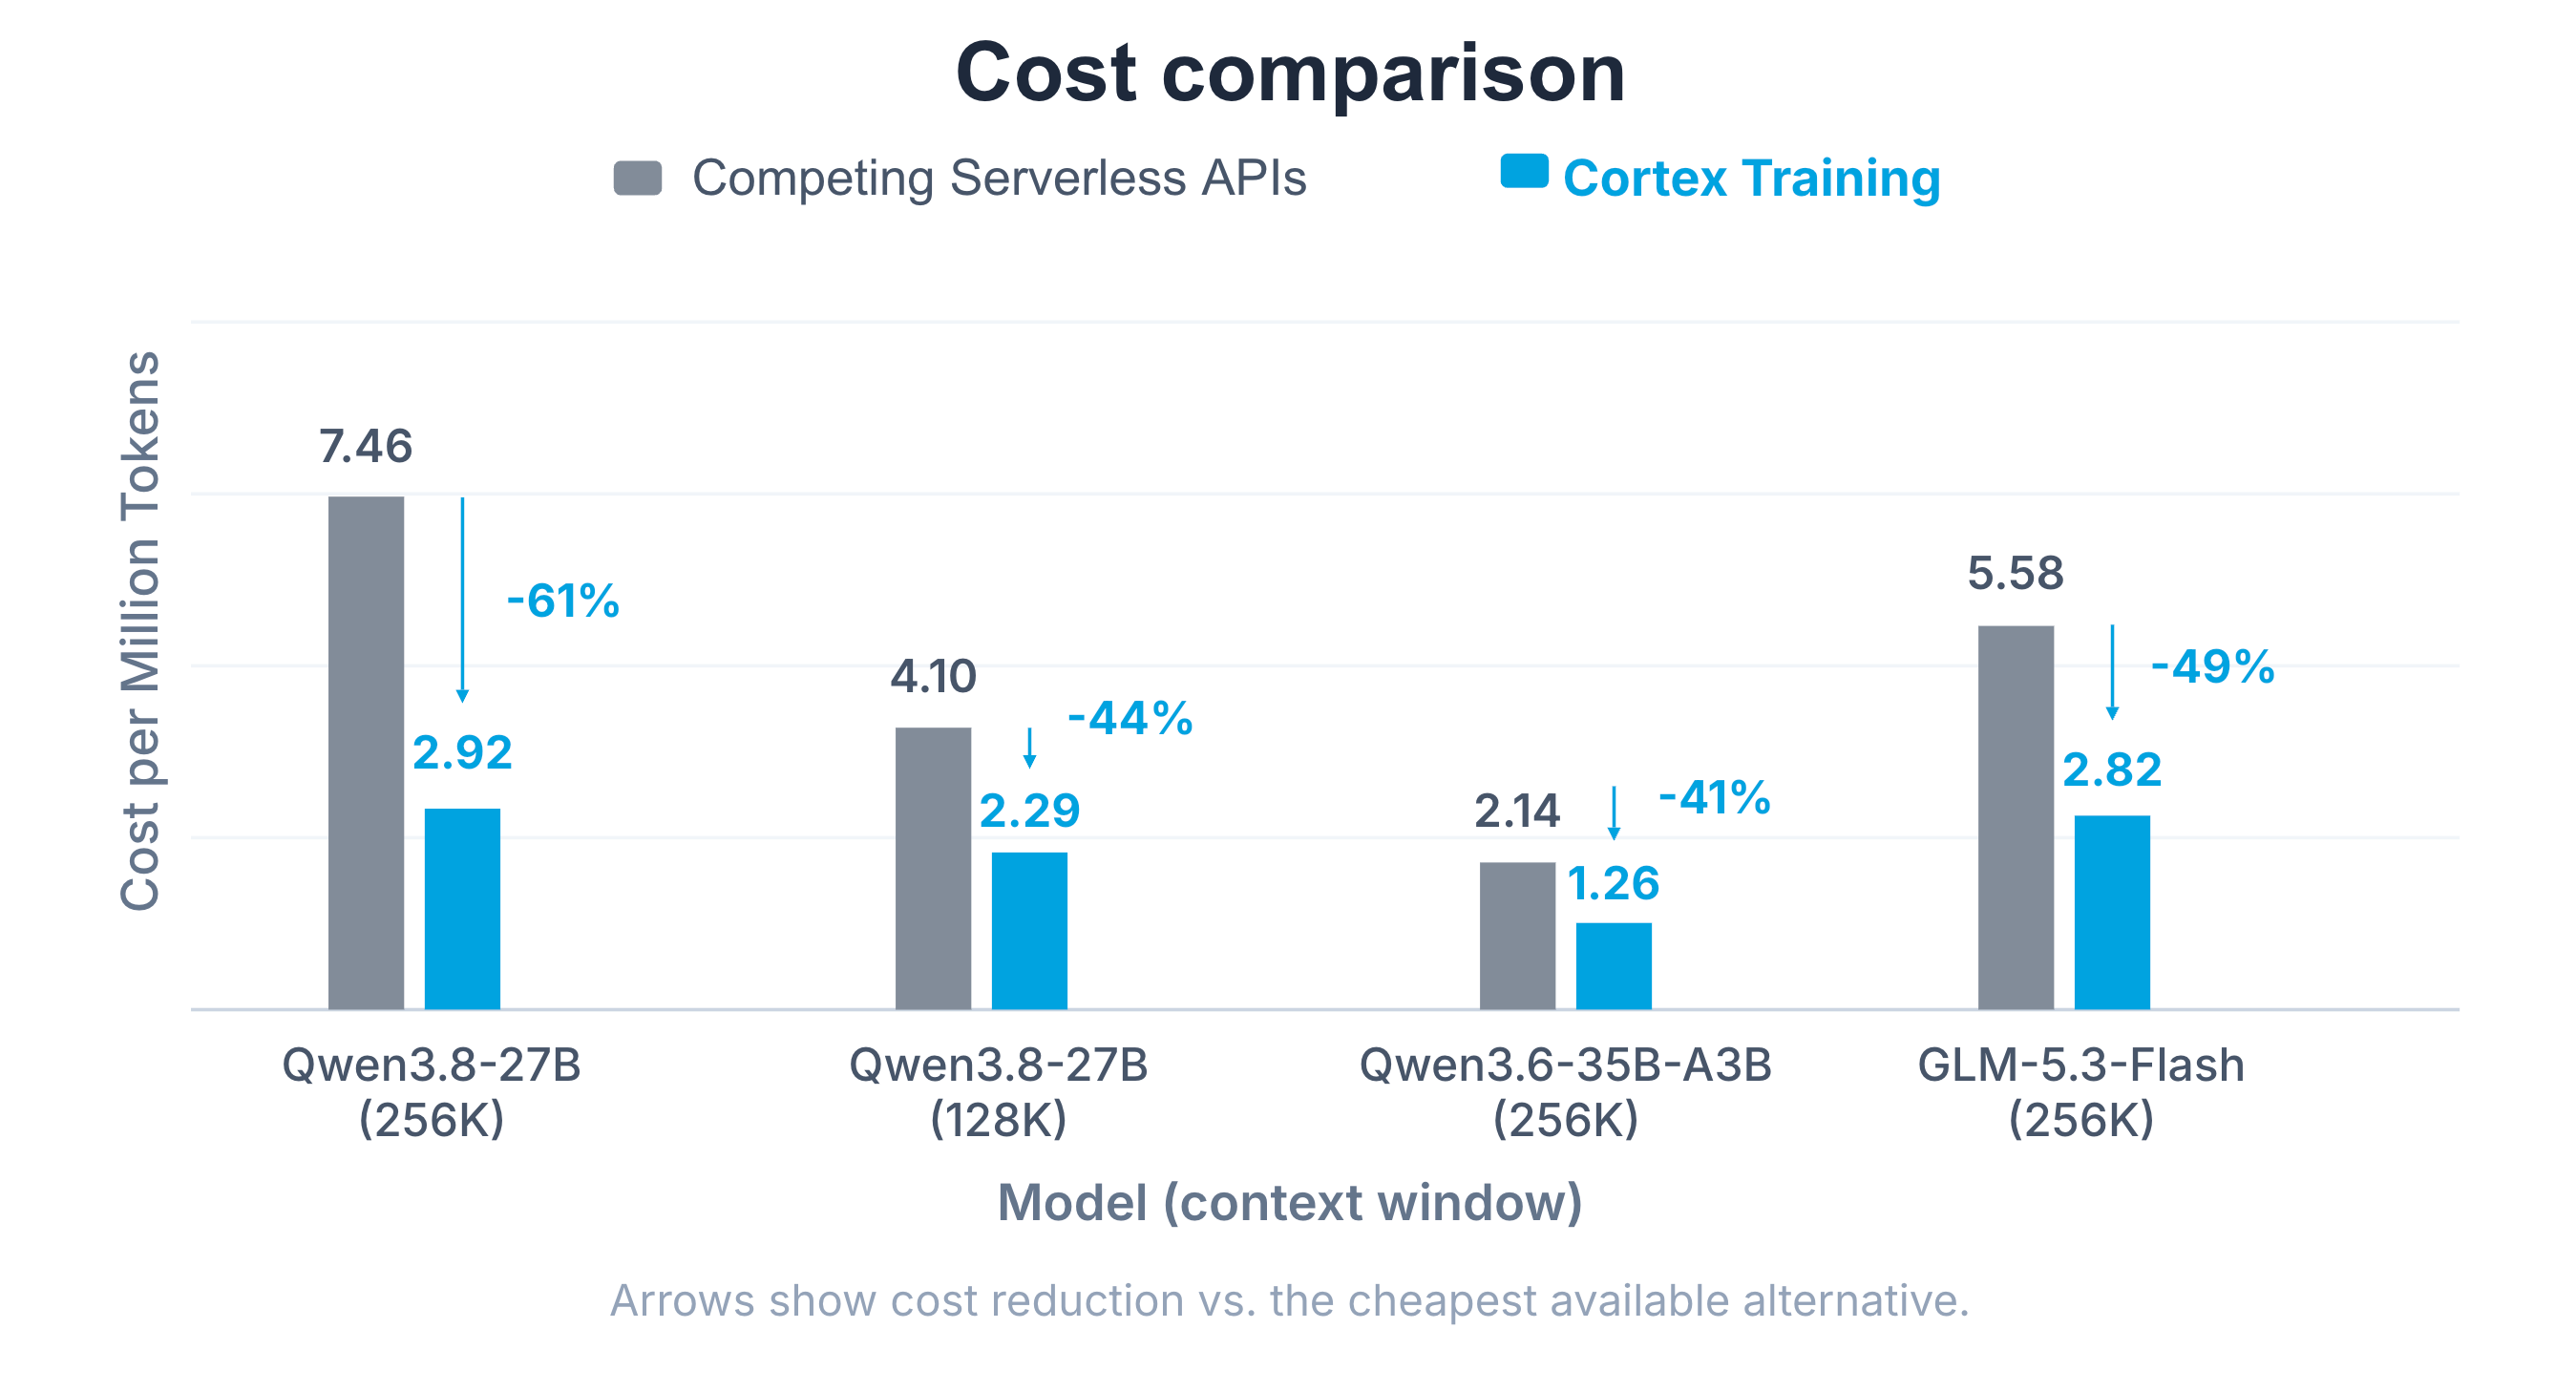
Rispetto ad altre API di training serverless, Cortex Training offre un’ottima efficienza dei costi per il training LoRA. Nei nostri benchmark, Cortex Training costa fino al 61% in meno rispetto ai prodotti API di training serverless concorrenti (Tinker e altri).[1]
Poetiq sta realizzando l’ottimizzatore più potente al mondo con un proprio approccio all’auto-miglioramento ricorsivo. Con Snowflake abbiamo iniziato il post-training del primo LLM al mondo specializzato nell’ottimizzazione. Cortex Training ci offre la semplicità d’uso e la flessibilità necessarie per gestire tutto ciò di cui abbiamo bisogno: dalla LoRA all’SFT, fino al post-training completo dei parametri con la nostra implementazione personalizzata di GRPO.”
Ian Fischer
Co-CEO, Poetiq
Inizia con il post-training degli LLM
- Per aiutarti a iniziare, abbiamo creato questo notebook quickstart facile da usare, che opera interamente all’interno del tuo account Snowflake esistente.
- Consulta il repository introduttivo oppure scegli una di queste recipe pronte all’uso.
- Per saperne di più su Cortex Training, consulta la documentazione o visita la pagina web.
- Contatta il tuo team account per assistenza o per consultarti con uno specialista AI su Snowflake.
- Metodologia di confronto dei costi: I prezzi delle soluzioni API serverless concorrenti si basano sui prezzi pubblicati il 22 ottobre 2026 sulle rispettive pagine web. Abbiamo eseguito workload di training LoRA SFT su Cortex Training con la lunghezza di contesto specificata nella figura 5, misurando il throughput per GPU H200. Abbiamo utilizzato il throughput (toks/sec) per calcolare il prezzo per milione di token per Cortex Training, utilizzando la formula (price_per_second / throughput) x 1M. ↩


