
Cada aplicación de inteligencia artificial (IA) en producción genera millones de datos valiosos sobre tu empresa, como preferencias de los clientes, patrones de uso y resultados, pero la mayoría de las empresas nunca los aprovechan. Muchas optan por crear agentes basados en modelos fundacionales cerrados que pueden resultar costosos y carecer de un conocimiento detallado de tu negocio. A medida que los modelos de pesos abiertos se vuelven cada vez más competitivos frente a los modelos de frontera, las empresas tienen la oportunidad de personalizar la IA con sus propios datos y contexto. Sin embargo, hasta ahora esto exigía gestionar una infraestructura de GPU compleja y costosa o recurrir a API gestionadas que ofrecen una flexibilidad y un control limitados.
Hoy nos complace anunciar la vista previa pública de Cortex Training, la solución serverless de Snowflake para personalizar e implementar LLM de pesos abiertos. Con Cortex Training, los equipos pueden utilizar marcos de entrenamiento conocidos o crear bucles de entrenamiento personalizados avanzados con API serverless de bajo nivel, todo ello sin gestionar las complejidades del aprovisionamiento de GPU, la programación, la creación de puntos de control y la ejecución distribuida.
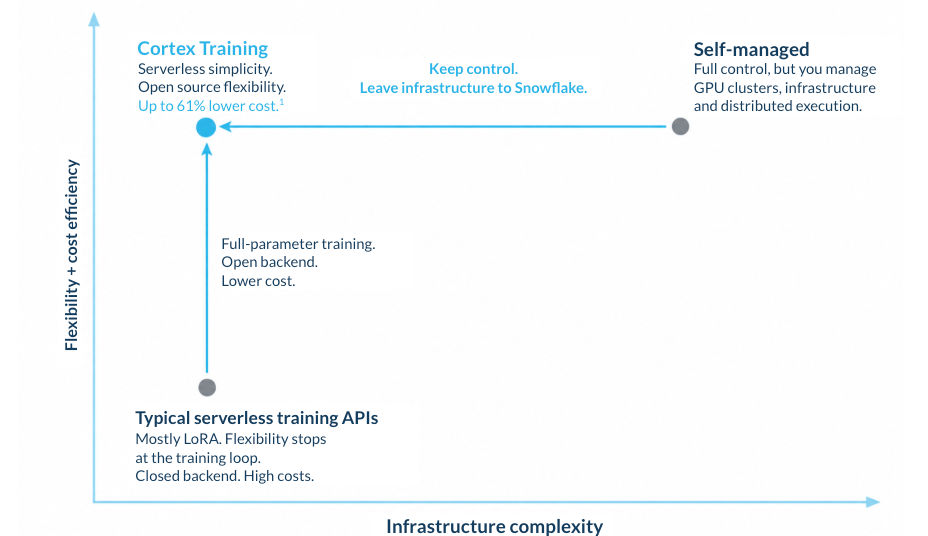
Cortex Training se ha creado sobre un back-end de código abierto altamente personalizable y optimizado para ofrecer la flexibilidad y eficiencia de un complejo clúster de entrenamiento autogestionado en servidores físicos dedicados, con la sencillez de una experiencia serverless simplificada. Las pruebas comparativas muestran un coste hasta un 61 % inferior al de otras soluciones serverless de la competencia,[1] por lo que los equipos ya no tienen que sacrificar la flexibilidad o la eficiencia de costes en favor de la simplicidad al personalizar e implementar modelos.
Con Cortex Training, los equipos pueden usar la plataforma de datos integrada de Snowflake para preparar fácilmente conjuntos de datos listos para el entrenamiento y capturar trazas y registros de agentes, lo que crea un ciclo de retroalimentación para personalizar y mejorar los modelos.
Por qué las empresas necesitan el posentrenamiento
Los modelos de pesos abiertos listos para usar son generalistas de forma predeterminada, pero el posentrenamiento permite optimizarlos en gran medida para el ámbito, los datos propios, los casos de uso y el presupuesto de cada empresa. Los métodos de posentrenamiento, como el ajuste fino supervisado (SFT) y el aprendizaje por refuerzo (RL), permiten que los LLM aprendan qué es un buen comportamiento y cómo tomar decisiones más precisas y rentables a partir del contexto específico de tu organización.
SFT enseña a los modelos lo que es un buen comportamiento. Mediante ejemplos de alta calidad, las empresas pueden enseñar a un agente de atención al cliente a diagnosticar problemas, comunicarse con los clientes, aplicar políticas de escalado y seguir patrones probados de llamadas a herramientas y flujos de trabajo. En lugar de depender de prompts que especifiquen cada paso, el modelo aprende de las interacciones satisfactorias cómo espera la empresa que se realice el trabajo.
RL enseña a los modelos a tomar mejores decisiones para lograr los resultados deseados. A diferencia de SFT, que aprende a partir de demostraciones, RL optimiza el comportamiento mediante comentarios sobre resultados medibles, como la resolución de problemas, el cumplimiento de políticas, la latencia y el coste. Por ejemplo, un agente de atención al cliente puede aprender cuándo usar un sistema de gestión de incidencias, llamar a una API de facturación o escalar el caso a una persona. Al aprender de los comentarios obtenidos en numerosas trayectorias de interacción, puede descubrir formas más eficaces de completar tareas, evitar pasos y llamadas a herramientas innecesarios y, al mismo tiempo, equilibrar la calidad, la velocidad y el coste.
Presentamos Cortex Training
Cortex Training es la solución serverless de Snowflake para crear e implementar modelos de pesos abiertos personalizados. Los equipos de IA mantienen un control pormenorizado sobre SFT, RL y los bucles de entrenamiento personalizados, mientras Snowflake gestiona la infraestructura de GPU para que los desarrolladores puedan centrarse en mejorar los modelos en lugar de operar clústeres.
Cortex Training se ha creado sobre un back-end de código abierto altamente personalizable y optimizado para ofrecer la flexibilidad y eficiencia de complejas implementaciones autogestionadas en servidores físicos, con la sencillez de una experiencia serverless simplificada. Admite una amplia variedad de familias de modelos de pesos abiertos, ajuste fino supervisado (SFT) y aprendizaje por refuerzo (RL) con entrenamiento de todos los parámetros o con LoRA, además de la orquestación mediante marcos populares de código abierto como SkyRL, Hugging Face TRL y veRL.
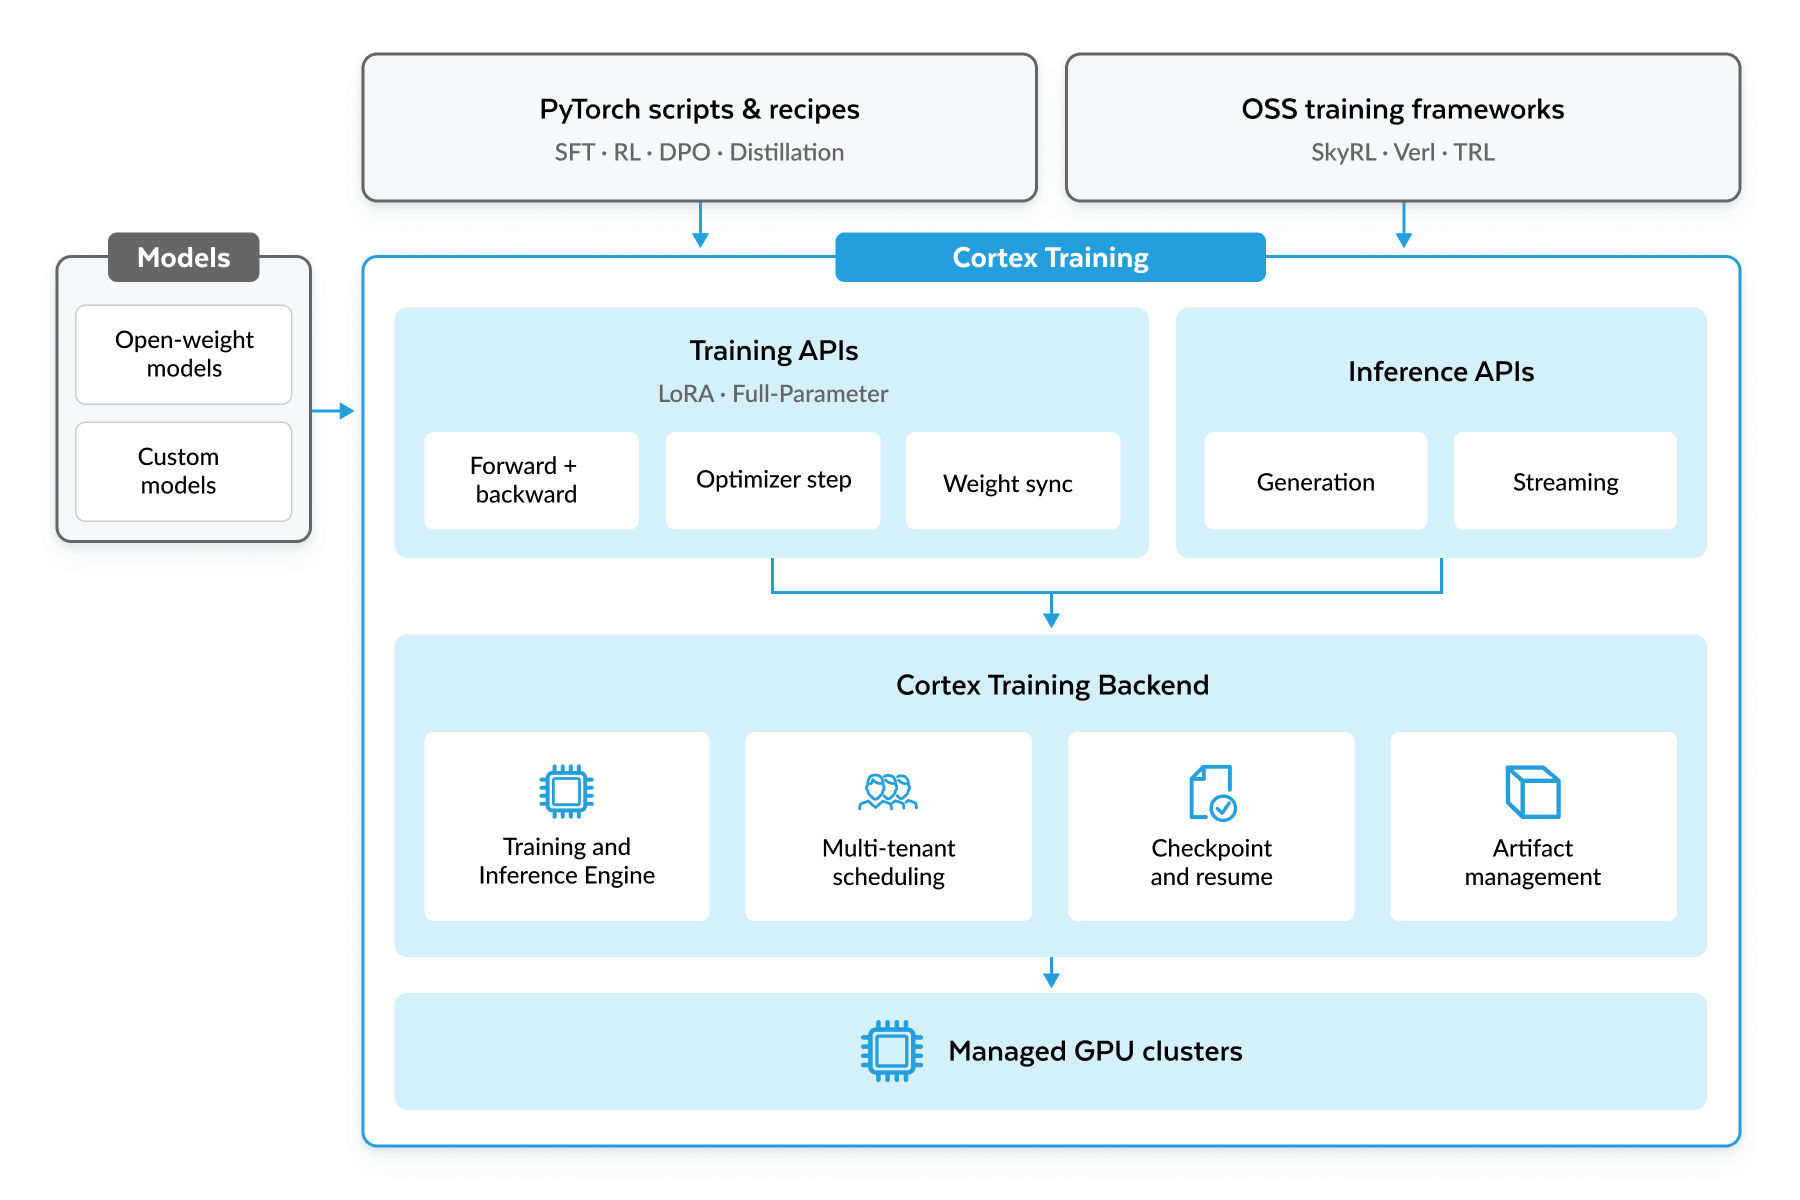
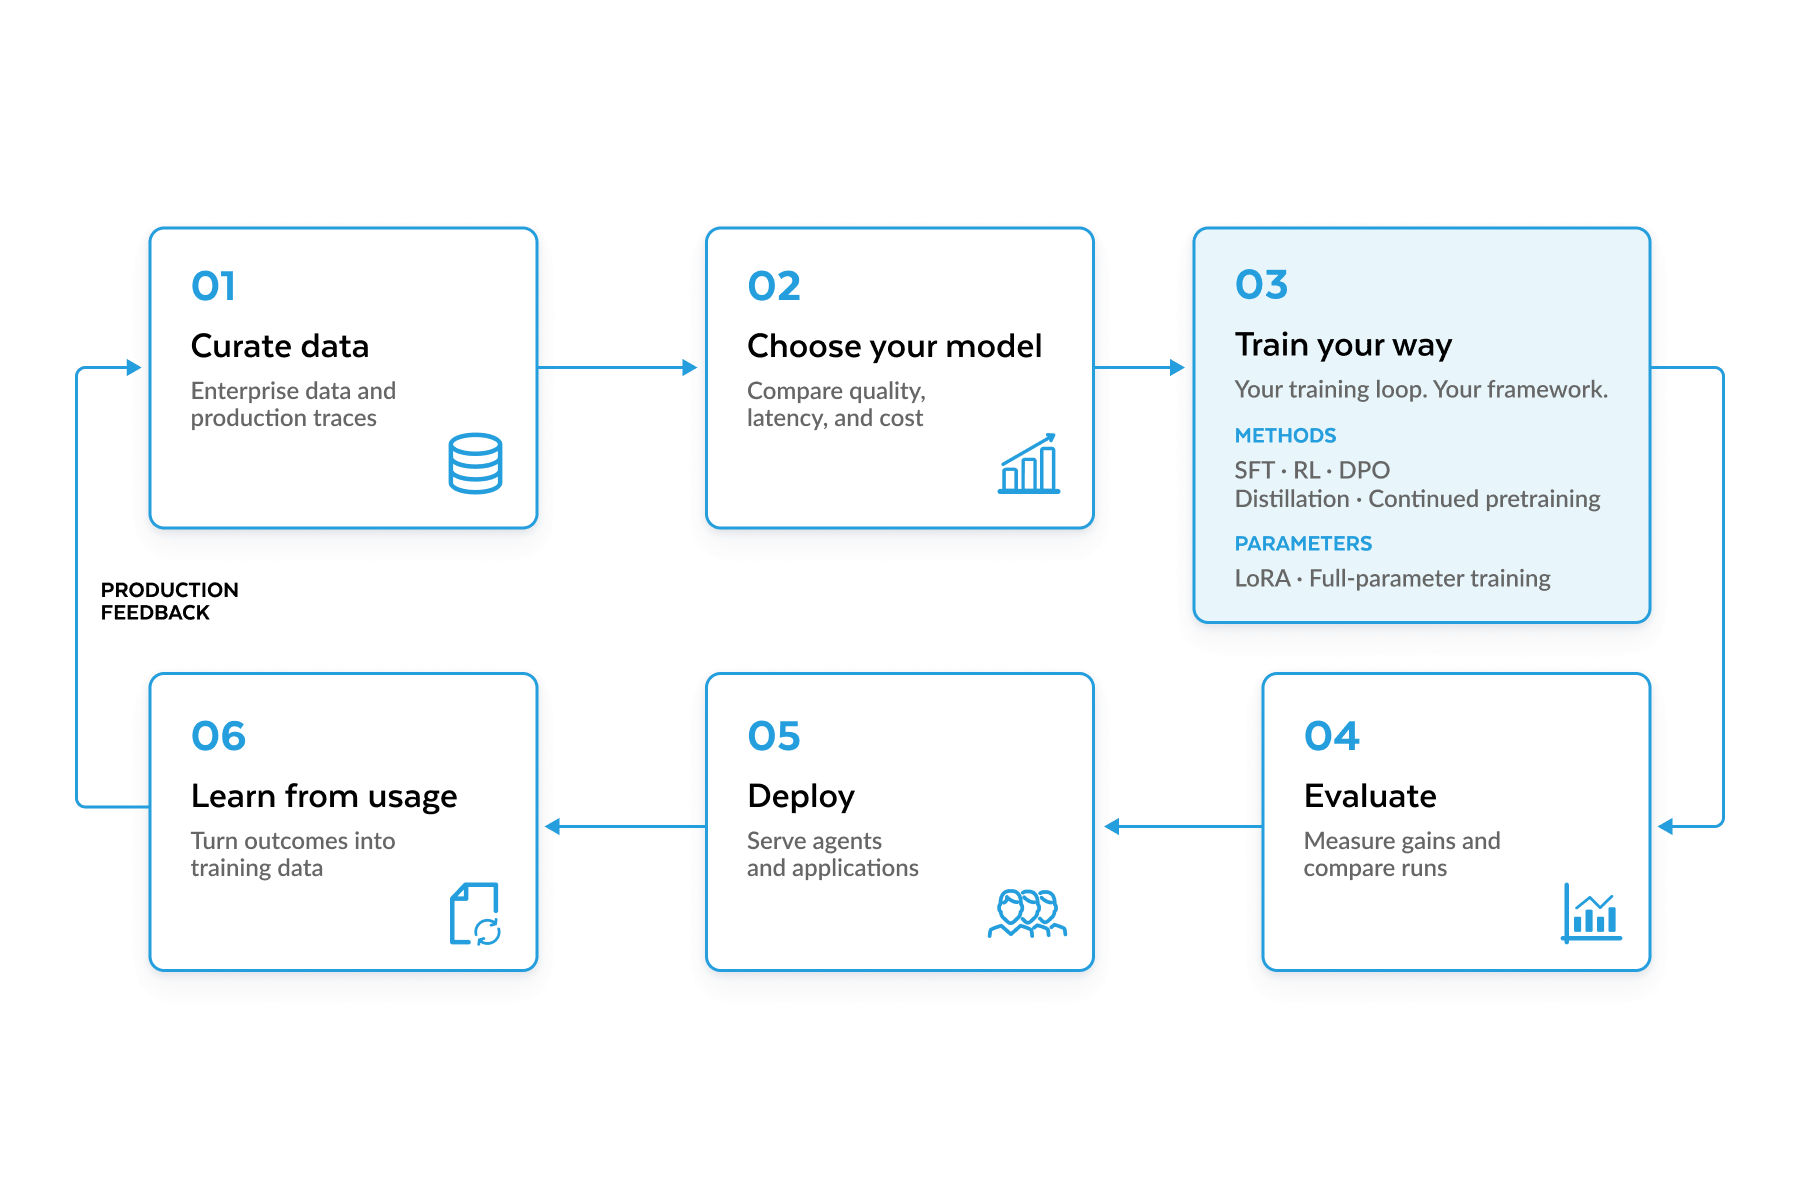
La plataforma abarca todo el ciclo de vida del modelo: realiza pruebas comparativas de los principales modelos de pesos abiertos, personalízalos con marcos de entrenamiento populares o API de entrenamiento serverless de bajo nivel, evalúa y compara puntos de control e impleméntalos mediante puntos de conexión de inferencia compatibles con OpenAI. Así se crea un ciclo virtuoso continuo en el que los datos de producción y los comentarios impulsan modelos cada vez más capaces y especializados.
Cortex Training extiende los controles de gobernanza de Snowflake a todo el ciclo de vida del modelo. Los controles de acceso basados en roles rigen los datos y procesos de entrenamiento de modelos, la implementación y la inferencia, mientras que los datos, los pesos de los modelos y el estado del optimizador permanecen en el entorno gestionado de Snowflake.

En ResolveAI, mejoramos la fiabilidad del software al situar agentes SRE de IA en la ruta crítica y asumir la responsabilidad de los resultados. Para crear SRE sobrehumanos que investiguen y resuelvan de forma autónoma los problemas en producción, es necesario entrenarlos en tareas de largo horizonte, con trabajos que se ejecutan en cientos de GPU, e incluso más de mil. Las API serverless de Cortex Training nos permiten operar a esta escala sin tener que gestionar la infraestructura subyacente ni optimizar los clústeres. Además, la experiencia en sistemas del equipo de Snowflake complementa nuestra investigación en IA, lo que nos permite innovar con rapidez e iterar hasta alcanzar nuestros objetivos de rendimiento de los modelos”.
Sean Bell
Research Lead, ResolveAI
Centrarse en los modelos, no en la infraestructura de GPU
Cortex Training proporciona API serverless para que los equipos puedan centrarse en la lógica de entrenamiento en lugar de aprovisionar y operar la infraestructura de GPU.
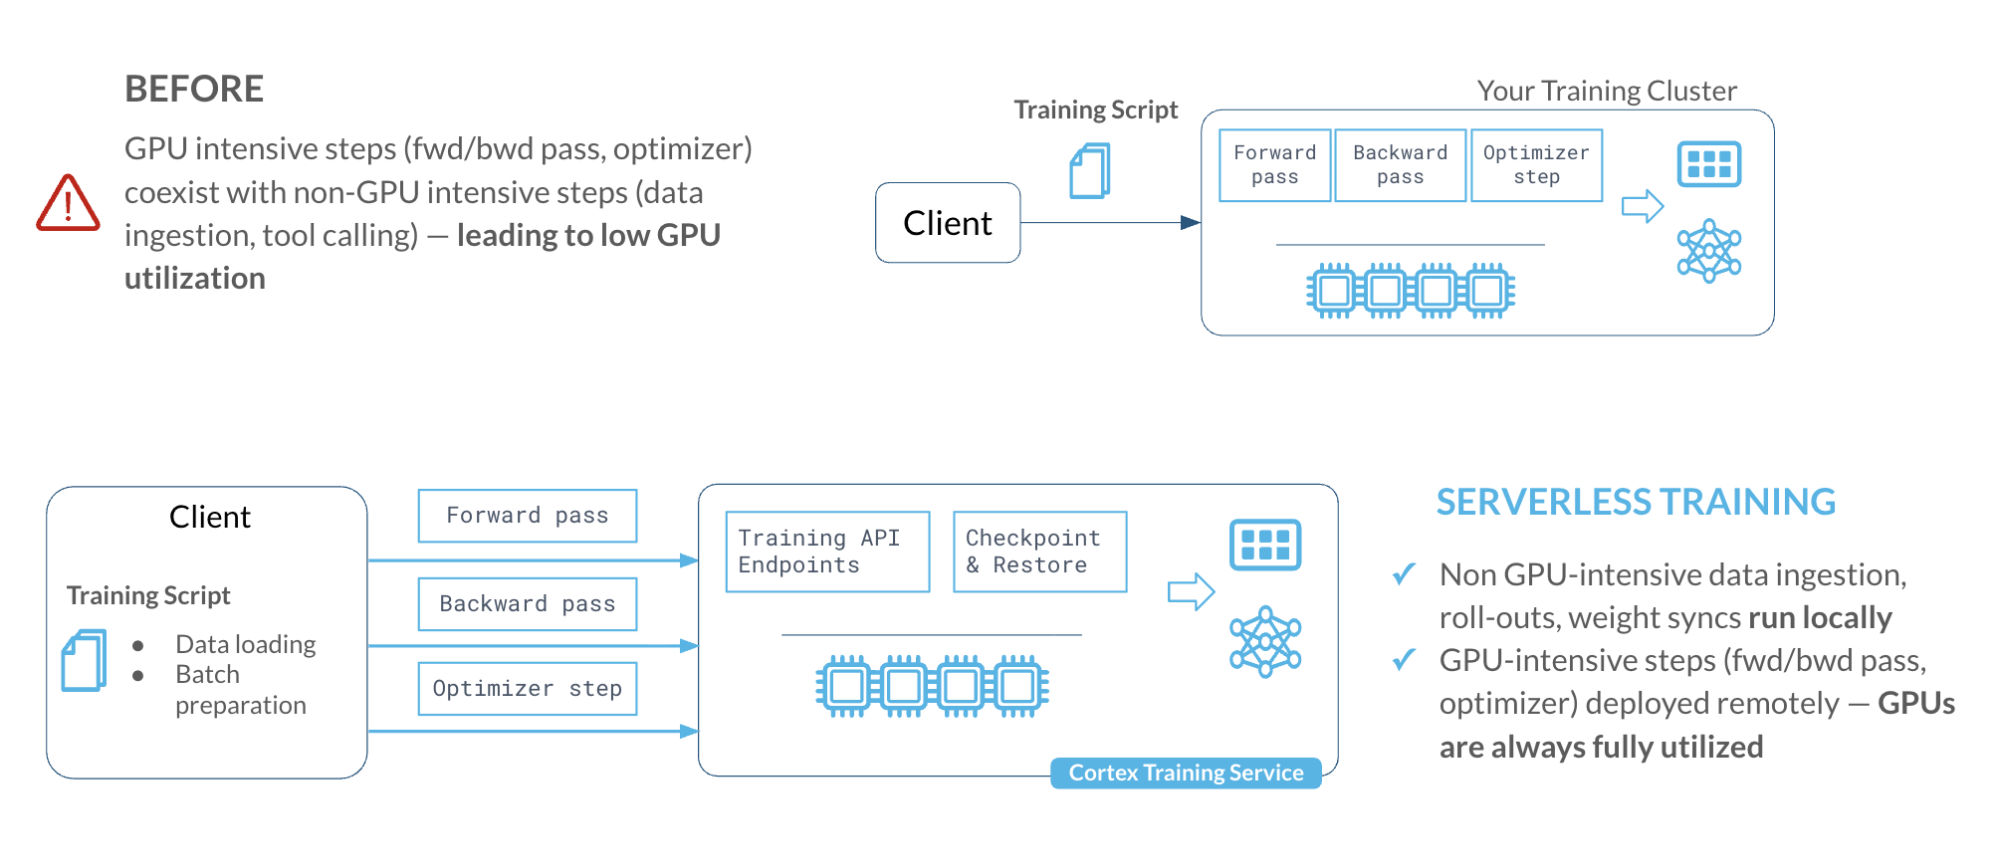
Tu script de entrenamiento controla el bucle de entrenamiento, mientras que las API de Cortex Training gestionan operaciones que más GPU consumen, como la propagación hacia delante y hacia atrás (forward/backward passes), los pasos del optimizador, la sincronización de pesos y la generación. Tú defines cómo aprende el modelo; Snowflake gestiona las GPU, la ejecución distribuida, el estado del modelo y la creación de puntos de control.
Activa el ciclo virtuoso de mejora de los modelos
Snowflake posibilita un ciclo virtuoso de mejora de los modelos: desde la captura de trazas y registros de agentes de IA en producción hasta la preparación de datos de entrenamiento, la personalización de modelos de pesos abiertos para necesidades empresariales específicas y su implementación para cubrir las necesidades de inferencia.
Prepara tus datos
Una personalización eficaz de los modelos comienza con datos de entrenamiento de alta calidad. La plataforma de datos de Snowflake permite a los equipos limpiar, filtrar, enriquecer y etiquetar datos empresariales, tanto estructurados como no estructurados, para convertirlos en conjuntos de datos listos para el entrenamiento mediante Cortex AI Functions, SQL y Snowpark. Cortex AI Gateway ayuda a cerrar el ciclo de retroalimentación entre los agentes de IA en producción y el entrenamiento de modelos. Los equipos pueden capturar trazas y registros de agentes de IA, así como interacciones con los modelos, para comprender el comportamiento de los agentes e identificar oportunidades de mejora. Al combinar estas señales con los resultados de las aplicaciones y los comentarios de personas, los equipos pueden preparar conjuntos de datos de entrenamiento de gran valor para SFT, optimización de preferencias y RL, y transformar así la experiencia real de los agentes en modelos que mejoran continuamente.
Compara y evalúa el modelo de pesos abiertos adecuado
Empieza probando modelos de pesos abiertos con tu workload antes de invertir en su personalización. Compara los candidatos en las dimensiones importantes para tu aplicación: calidad, latencia y coste. Cortex Training ofrece un amplio catálogo de modelos de pesos abiertos, incluidas familias como Qwen, GLM, Nemotron, Gemma y DeepSeek, con inferencia por lotes y en streaming para facilitar las pruebas comparativas de modelos.
En OpenHands, utilizamos con frecuencia el aprendizaje por refuerzo (RL) para entrenar los modelos de nuestro agente y que pueda gestionar tareas de programación cuando un usuario le indica determinados archivos o funciones. Antes teníamos que gestionar nuestro propio clúster de entrenamiento y dedicábamos entre días y semanas a su administración y depuración. Con Snowflake Cortex Training, hemos podido dedicar el 100 % de nuestro tiempo a la experimentación y el entrenamiento. Además, no hemos tenido que cambiar nuestros marcos preferidos ni renunciar a la flexibilidad”.
Jeff Ma and Parinthapat Pengpun
Researchers, OpenHands
Entrena y personaliza el modelo a tu manera con flexibilidad
Cuando dispongas de un modelo base sólido, adáptalo con la estrategia de entrenamiento que mejor se ajuste a tu tarea. Cortex Training admite modelos de pesos abiertos de última generación, como Qwen, Nemotron, Gemma y DeepSeek, entre otros, con distintos números de parámetros. Los equipos pueden usar LoRA o el entrenamiento de todos los parámetros para SFT, RL, optimización directa de preferencias, destilación, preentrenamiento continuado y entrenamiento intermedio.
Cortex Training se integra con marcos populares de posentrenamiento, como Hugging Face TRL, PrimeRL, veRL y SkyRL, para que los equipos que ya los utilizan puedan empezar a trabajar rápidamente. También se integra con plataformas de agentes como OpenHands para entrenar modelos y sistemas completos de agentes. Además de estas integraciones, las API serverless permiten personalizar modelos mediante agentes para workloads empresariales, lo que reduce la complejidad del entrenamiento y hace que la personalización sea accesible sin conocimientos especializados en IA.
Para obtener un mayor control, los equipos avanzados de aprendizaje automático (ML) pueden usar API de menor nivel para definir funciones de pérdida, arquitecturas de modelos y bucles de entrenamiento personalizados. Por ejemplo, Cortex Training proporciona API para generar rollouts (respuestas del modelo o interacciones de agentes), actualizar los pesos del modelo y sincronizar esos pesos en todo el sistema. Estos componentes permiten crear flujos de trabajo de RL que generan comportamientos, evalúan resultados y los utilizan de forma reiterada para mejorar el modelo con el tiempo.
Esta flexibilidad se extiende a la infraestructura subyacente. Cortex Training funciona con Arctic Platform, un back-end de código abierto que ofrece a los usuarios visibilidad completa del código que se ejecuta en las GPU. Los equipos avanzados pueden enviar solicitudes de incorporación de cambios e integrar técnicas e innovaciones emergentes de la comunidad general de IA y ML en sus workloads de entrenamiento.
Consulta nuestros ejemplos de Cortex Training para ver el conjunto completo de recetas, integraciones y skills.
En el equipo de modelado de Snowflake AI Research, creamos nuestros agentes de ingeniería de software, como Arctic-SWE, con prime-rl y con Cortex Training como backend. Esto nos permite desarrollar libremente nuestros propios marcos algorítmicos y recetas de entrenamiento sobre GPU serverless, y obtener así la dinámica de entrenamiento que necesitamos para lograr un rendimiento de vanguardia en tareas de ingeniería de software, sin tener que gestionar el clúster”.
Boyi Liu
Senior Research Scientist, Snowflake AI Research
Evalúa e itera
El entrenamiento solo aporta valor si el nuevo modelo es mejor de forma medible. Cortex Training permite a los equipos cargar puntos de control entrenados para la inferencia por lotes o implementarlos tras puntos de conexión para evaluar y probar aplicaciones. Puedes usar Snowflake ML Experiments para supervisar las ejecuciones de entrenamiento, registrar métricas personalizadas, observar el rendimiento y comparar ejecuciones entre experimentos. Así tendrás pleno control sobre los datos que se capturan, en lugar de depender del registro automático. Los puntos de control se conservan en el servidor para que los equipos puedan reanudar el entrenamiento o iniciar nuevos experimentos a partir de puntos de control anteriores.
Implementa en agentes y aplicaciones
Cuando un modelo alcanza los objetivos de calidad y coste requeridos, los equipos pueden implementarlo para la inferencia.
Cortex Training admite puntos de conexión de inferencia compatibles con OpenAI respaldados por GPU dedicadas, incluida la inferencia en streaming para aplicaciones y agentes interactivos y la inferencia por lotes para necesidades no interactivas.
El ciclo de vida vuelve a empezar cuando las aplicaciones en producción generan nuevas trayectorias, evaluaciones y resultados: comparar → entrenar → generar rollouts → evaluar → implementar y servir → aprender de la producción → volver a entrenar. Mediante este ciclo, los datos empresariales y la experiencia de las aplicaciones se convierten en modelos cada vez más capaces y especializados.
Eficiencia de costes gracias a una base abierta
Cortex Training ofrece configuraciones optimizadas listas para usar, mientras que los equipos avanzados pueden ajustarlas para workloads específicos o aportar mejoras al proyecto original. Como el uso se factura por tiempo de GPU, un entrenamiento más rápido se traduce directamente en costes más bajos.
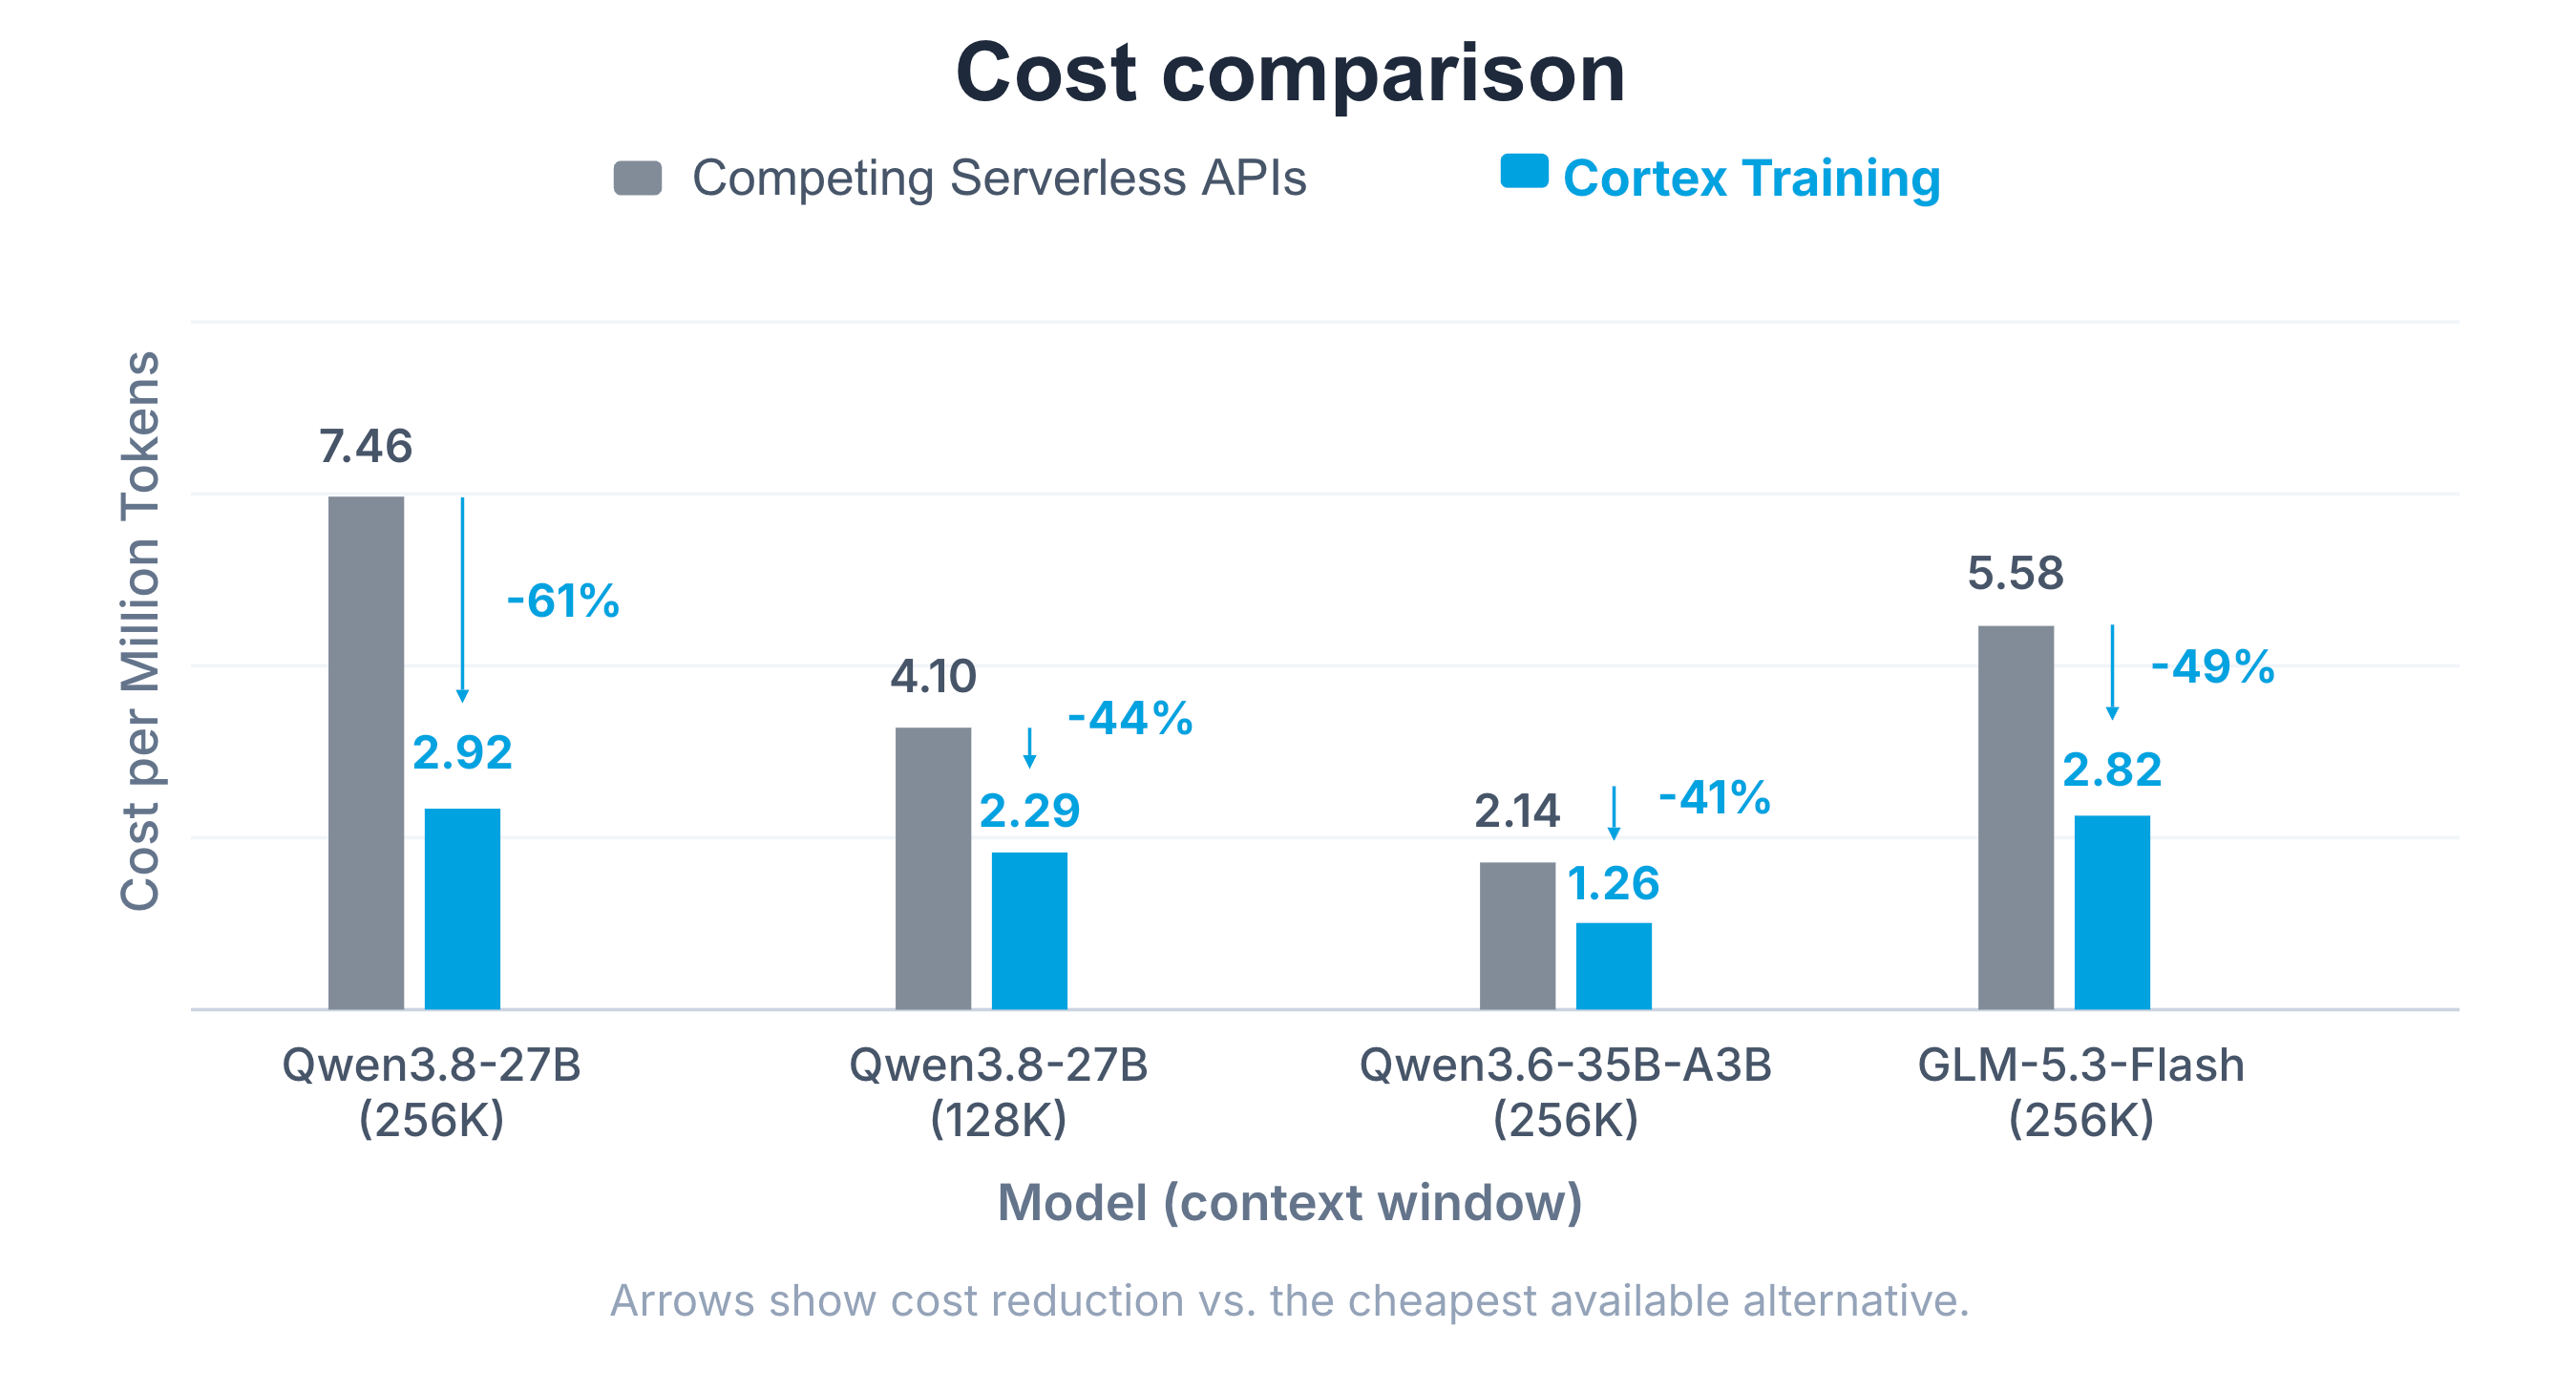
En comparación con otras API de entrenamiento serverless, Cortex Training ofrece una elevada eficiencia de costes para el entrenamiento con LoRA. En nuestras pruebas comparativas, Cortex Training tiene un coste hasta un 61 % inferior al de otros productos de API de entrenamiento serverless de la competencia, como Tinker.[1]
En Poetiq estamos creando el optimizador más potente del mundo con nuestro propio enfoque de automejora recursiva. Con Snowflake, hemos empezado a posentrenar el primer LLM del mundo especializado en optimización. Cortex Training nos ofrece la facilidad de uso y la flexibilidad necesarias para hacer todo lo que necesitamos, desde LoRA y SFT hasta el posentrenamiento de todos los parámetros con nuestra propia implementación de GRPO”.
Ian Fischer
Co-CEO, Poetiq
Empezar a usar el posentrenamiento de LLM
- Para ayudarte a empezar, hemos preparado este quickstart notebook fácil de usar que funciona íntegramente en tu cuenta de Snowflake actual.
- Consulta el repositorio de introducción o elige una de estas recetas listas para usar.
- Para obtener más información sobre Cortex Training, consulta la documentación o visita la página web.
- Ponte en contacto con los equipos responsables de tu cuenta para obtener ayuda o consultar con un especialista en IA de Snowflake.
- Metodología de comparación de costes: los precios de los productos de API serverless de la competencia se basan en los precios publicados en sus páginas web el 22 de octubre de 2026. Ejecutamos workloads de entrenamiento SFT con LoRA en Cortex Training con la longitud de contexto especificada en la figura 5 y medimos el rendimiento por GPU H200. Usamos el rendimiento (tokens/s) para calcular el precio por millón de tokens de Cortex Training mediante la fórmula (price_per_second / throughput) x 1M. ↩


