
本番環境のAIアプリケーションはすべて、お客様の好み、使用パターン、結果など、ビジネスに関する何百万もの貴重なデータポイントを生成しますが、ほとんどの企業はそれを活用していません。多くの企業は、コストがかかり、ビジネスの詳細な理解に欠ける可能性のあるクローズドな基盤モデルでエージェントを構築することをデフォルトとしています。オープンウェイトモデルがフロンティアモデルとの競争力を高めるにつれて、企業は独自のデータとコンテキストを使用してAIをカスタマイズする機会を得ています。しかし、そうするためには従来、複雑で高価なGPUインフラストラクチャを管理するか、柔軟性と制御が限られているマネージドAPIに依存する必要がありました。
本日、オープンウェイトLLMをカスタマイズおよび展開するためのSnowflakeのサーバーレスオファリングであるCortex Trainingのパブリックプレビューを発表できることを嬉しく思います。Cortex Trainingを使用すると、チームは使い慣れたトレーニングフレームワークを使用したり、低レベルのサーバーレスAPIを使用して高度なカスタムトレーニングループを構築したりできます。これらはすべて、GPUのプロビジョニング、スケジューリング、チェックポイント、分散実行の複雑さを管理することなく実行できます。
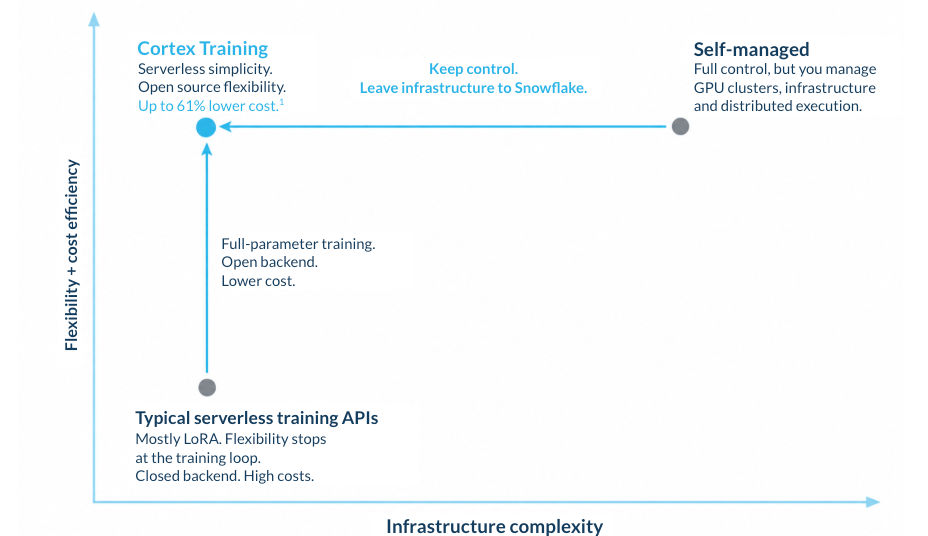
Cortex Trainingは、高度にカスタマイズ可能で最適化されたオープンソースバックエンド上に構築されており、複雑な自己管理型ベアメタルトレーニングクラスターの柔軟性と効率性を、簡素化されたサーバーレスエクスペリエンスにもたらします。ベンチマークによると、競合するサーバーレスオファリングよりもコストが最大61%低いため、[1]モデルをカスタマイズして展開する際に、チームはシンプルさと柔軟性やコスト効率をトレードオフする必要がなくなりました。
Cortex Trainingを使用すると、チームはSnowflakeの統合データプラットフォームを使用して、トレーニング可能なデータセットを簡単にキュレートし、エージェントのトレースとログをキャプチャして、モデルのカスタマイズと改善のためのフィードバックループを作成できます。
企業がポストトレーニングを必要とする理由
市販のオープンウェイトモデルはデフォルトでは一般的ですが、ポストトレーニングを通じて、各社のドメイン、専有データ、ユースケース、予算に合わせて高度に最適化できます。SFTやRLなどのポストトレーニング手法は、LLMが優れた動作とはどのようなものか、組織の特定のコンテキストを使用してより正確で費用対効果の高い意思決定を行う方法を学習する方法です。
SFTは、優れた動作とはどのようなものかをモデルに教えます。高品質の例を使用することで、企業はカスタマーサービスエージェントに、問題の診断、お客様とのコミュニケーション、エスカレーションポリシーの適用、実証済みのツール呼び出しとワークフローパターンの実行方法を教えることができます。すべてのステップを指定するためにプロンプトに依存するのではなく、モデルは成功したインタラクションから、企業がどのように作業を行うことを期待しているかを学習します。
RLは、望ましい結果を達成するためにより良い意思決定を行う方法をモデルに教えます。デモンストレーションから学習するSFTとは異なり、RLは、問題解決、ポリシーコンプライアンス、レイテンシー、コストなどの測定可能な結果に関するフィードバックを通じて動作を最適化します。たとえば、カスタマーサービスエージェントは、チケットシステムを呼び出すタイミング、請求APIを呼び出すタイミング、または人間にエスカレーションするタイミングを学習できます。多くのインタラクションの軌跡にわたるフィードバックから学習することで、品質、速度、コストのバランスを取りながら、不要なツールの呼び出しや手順を回避し、タスクを完了するためのより効果的な方法を発見できます。
Cortex Trainingの紹介
Cortex Trainingは、カスタマイズされたオープンウェイトモデルを構築および展開するためのSnowflakeのサーバーレスオファリングです。AIチームはSFT、RL、カスタムトレーニングループをきめ細かく制御できますが、SnowflakeはGPUインフラストラクチャを管理するため、開発者はクラスターの運用ではなくモデルの改善に集中できます。
Cortex Trainingは、高度にカスタマイズ可能で最適化されたオープンソースバックエンド上に構築されており、複雑な自己管理型ベアメタル展開の柔軟性と効率性を、簡素化されたサーバーレスエクスペリエンスにもたらします。幅広いオープンウェイトモデルファミリー、フルパラメータまたはLoRAトレーニングによる教師ありファインチューニング(SFT)と強化学習(RL)、およびSkyRL、Hugging Face TRL、veRLなどの一般的なオープンソースフレームワークによるオーケストレーションをサポートしています。
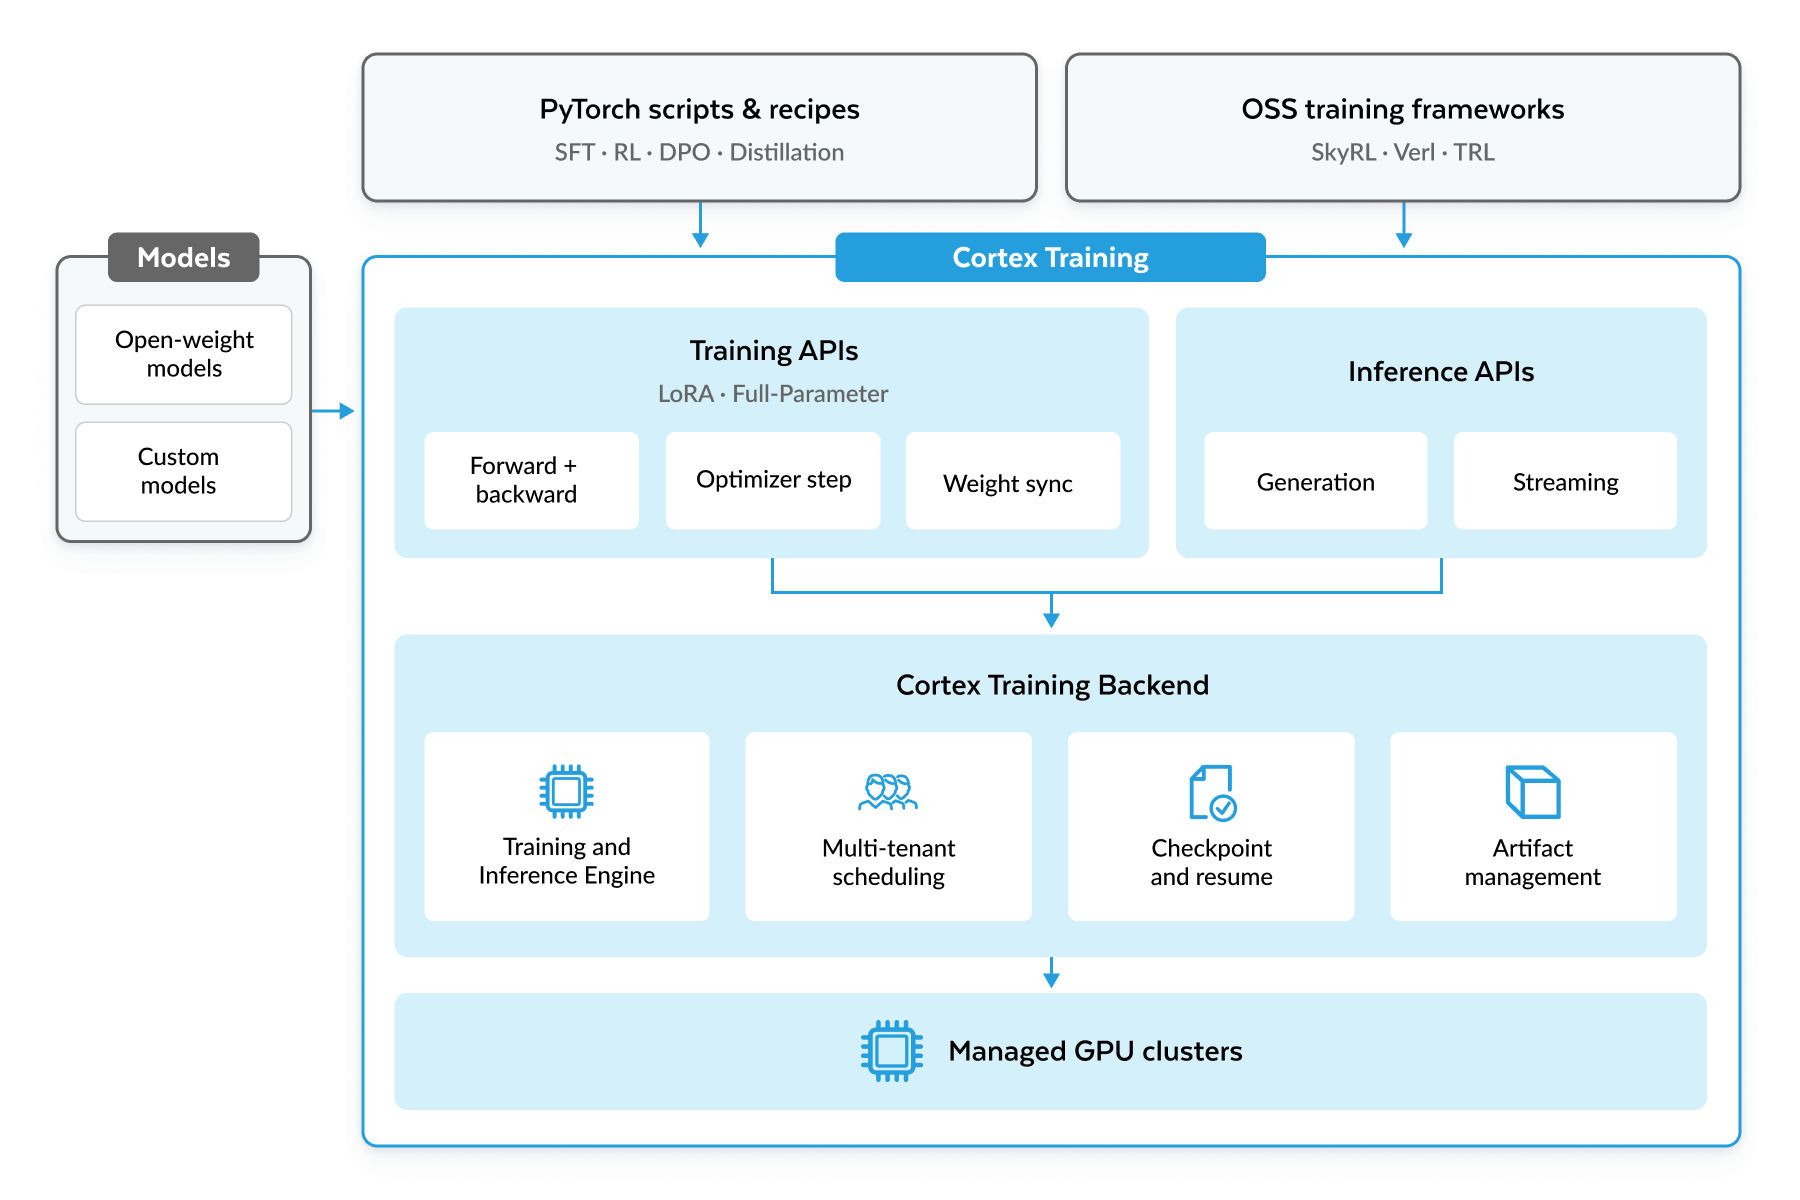
このプラットフォームは、モデルのライフサイクル全体をサポートします。主要なオープンウェイトモデルをベンチマークし、一般的なトレーニングフレームワークまたは低レベルのサーバーレストレーニングAPIを使用してカスタマイズし、チェックポイントを評価および比較し、OpenAI互換の推論エンドポイントを通じて展開します。これにより、本番データとフィードバックがますます有能で専門的なモデルを推進する継続的なフライホイールが作成されます。
Cortex Trainingは、モデルのライフサイクル全体にSnowflakeのガバナンス制御を拡張します。ロールベースのアクセス制御は、トレーニングデータ、モデルトレーニング、展開、推論を管理し、データ、モデルの重み、オプティマイザーの状態はSnowflakeのマネージド環境内に保持されます。

ResolveAIでは、AI SREエージェントをクリティカルパス(中枢プロセス)に組み込み、障害対応の結果にまで責任を持つことで、ソフトウェアの信頼性を向上させています。本番環境のトラブルを自律的に調査・解決する「超人的なSRE」を構築するには、長期・多段階の複合タスク(ロングホライズン・タスク)を対象に、数百から1,000基以上のGPUを稼働させたモデル学習が不可欠です。Snowflake Cortex TrainingのサーバーレスAPIを活用することで、基盤インフラの管理やクラスタの最適化に煩わされることなく、この規模でのモデルトレーニング運用を実現できています。さらに、Snowflakeチームの高度なシステム専門知識が当社のAI研究を補完してくれるため、迅速にイノベーションを推進し、モデルの性能目標に向けた反復改善(イテレーション)を加速させることが可能です。
Sean Bell
Research Lead, ResolveAI
GPUインフラストラクチャではなくモデルに集中する
Cortex TrainingはサーバーレスAPIを提供するため、チームはGPUインフラストラクチャのプロビジョニングと運用ではなく、トレーニングロジックに集中できます。
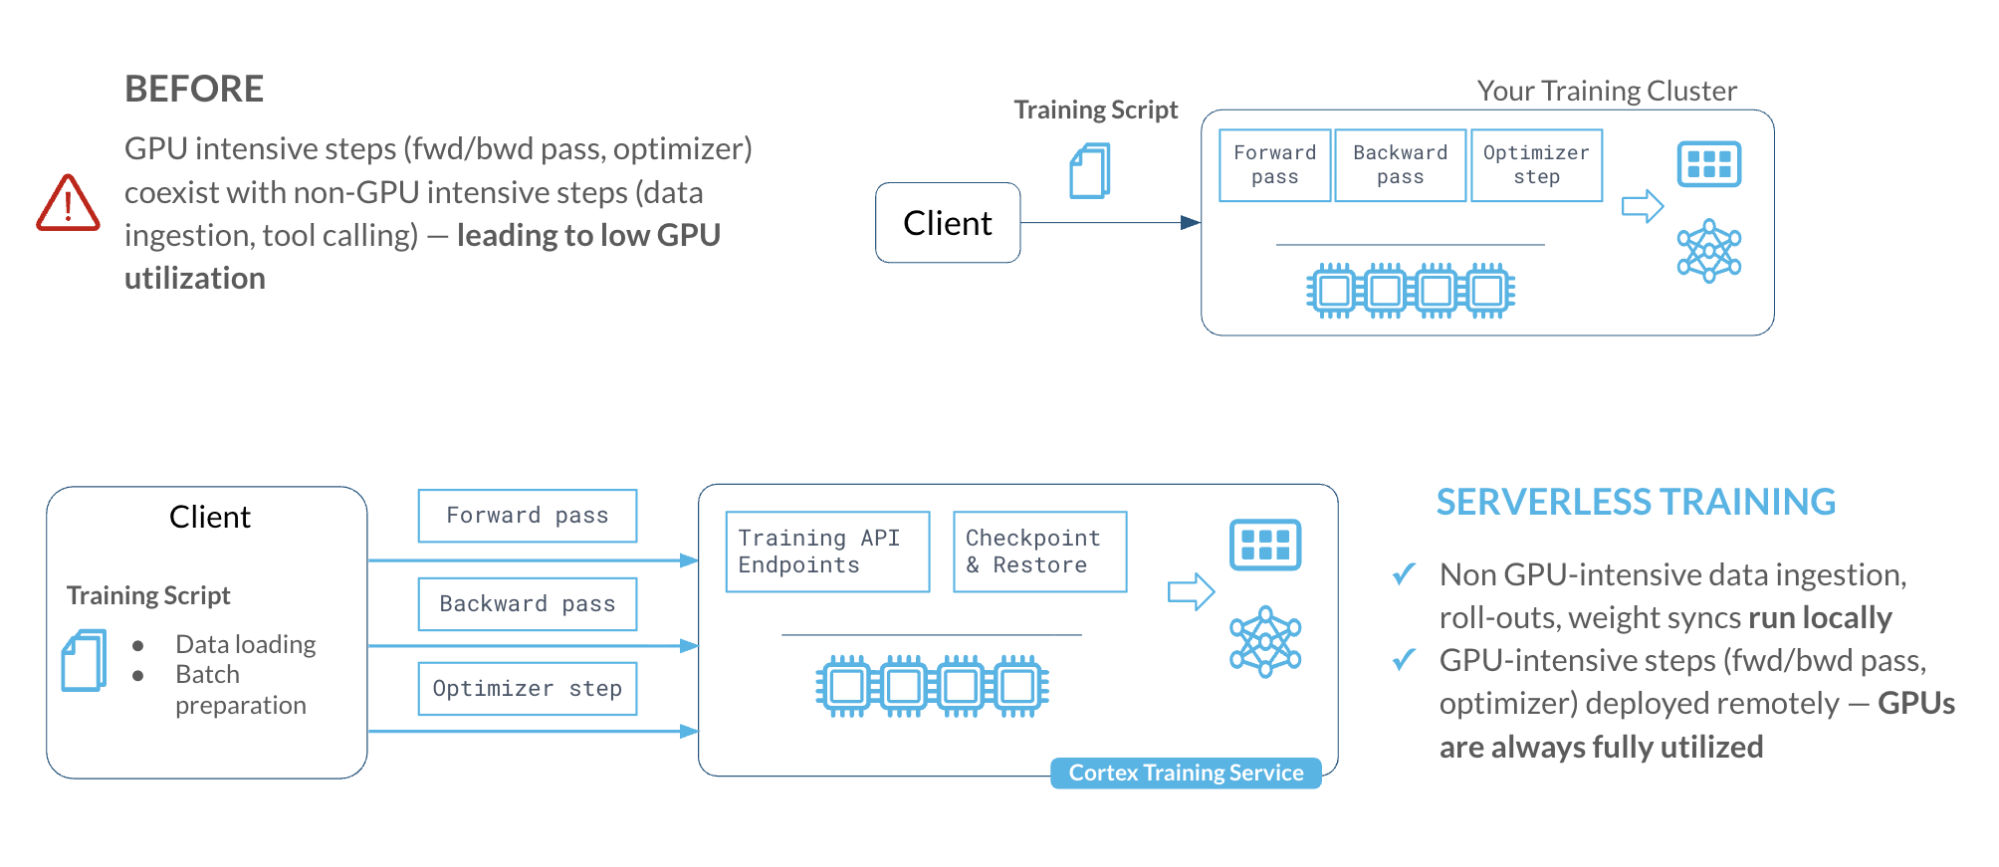
トレーニングスクリプトはトレーニングループを制御し、Cortex Training APIは、フォワード/バックワードパス、オプティマイザーステップ、重みの同期、生成などのGPUを多用する操作を処理します。モデルの学習方法はユーザーが定義し、SnowflakeはGPU、分散実行、モデルの状態、チェックポイントを管理します。
モデル改善のフライホイールを解き放つ
Snowflakeは、本番エージェントのトレースとログのキャプチャから、トレーニングデータのキュレーション、ビジネス固有のニーズに合わせたオープンウェイトモデルのカスタマイズ、推論ニーズに向けた展開まで、モデル改善のフライホイールを可能にします。
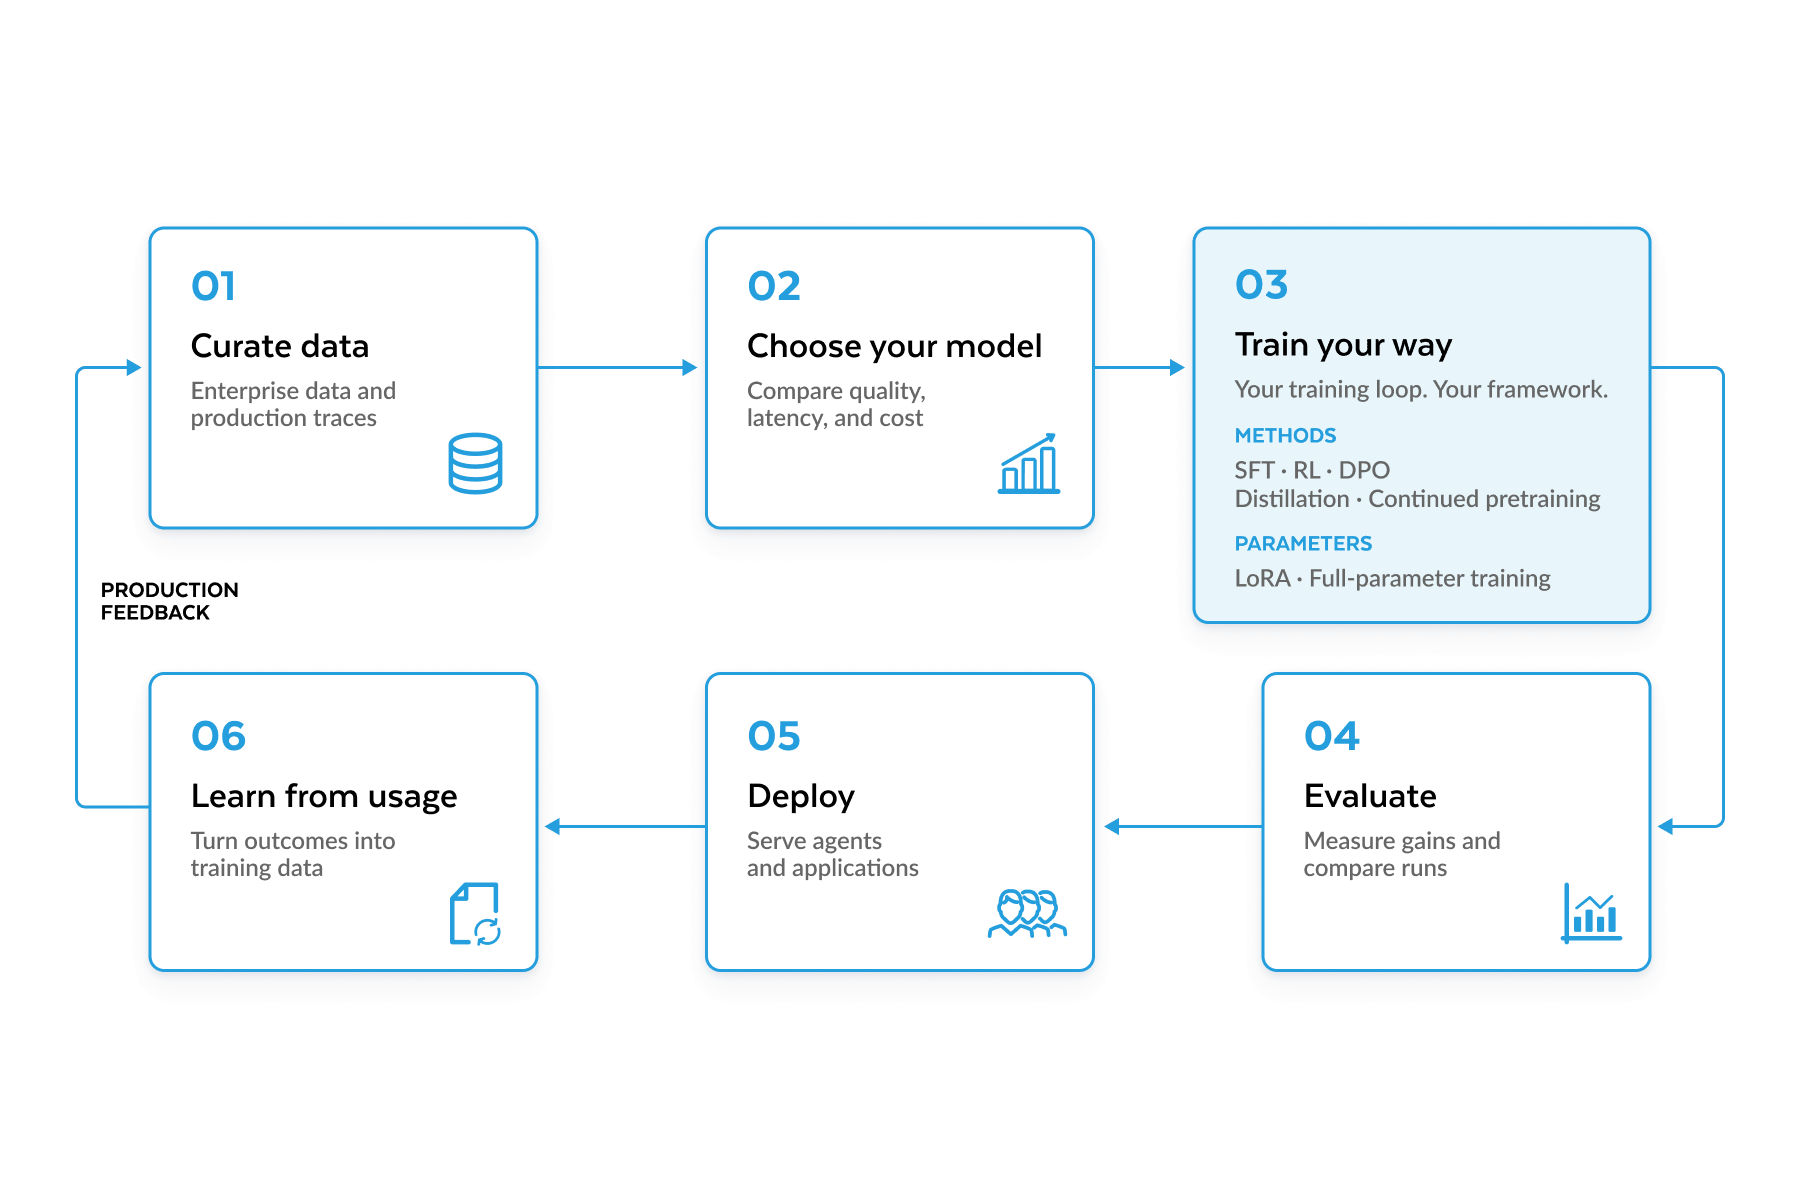
データをキュレートする
モデルのカスタマイズを成功させるには、高品質のトレーニングデータから始まります。Snowflakeのデータプラットフォームを使用すると、チームはCortex AI関数、SQL、Snowparkを使用して、構造化データと非構造化データの両方のエンタープライズデータをクリーンアップ、フィルタリング、強化、ラベル付けして、トレーニング可能なデータセットにすることができます。Cortex AIゲートウェイは、本番エージェントとモデルトレーニング間のフィードバックループを閉じるのに役立ちます。チームは、エージェントのトレース、ログ、モデルのインタラクションをキャプチャして、エージェントの動作を理解し、改善の機会を特定できます。これらのシグナルをアプリケーションの結果や人間のフィードバックと組み合わせることで、チームはSFT、選好の最適化、RLのための価値の高いトレーニングデータセットをキュレートし、現実世界のエージェントの経験を継続的に改善するモデルに変えることができます。
適切なオープンウェイトモデルのベンチマークと評価
カスタマイズに投資する前に、ワークロードに対してオープンウェイトモデルをテストすることから始めます。品質、レイテンシー、コストなど、アプリケーションにとって重要な側面で候補を比較します。Cortex Trainingは、Qwen、GLM、Nemotron、Gemma、DeepSeekなどのファミリーを含むオープンウェイトモデルの豊富なカタログを提供し、モデルのベンチマークを容易にするバッチおよびストリーミング推論を備えています。
OpenHandsでは、ユーザーが特定のファイルや関数を指定した際にエージェントがコーディングタスクを適切に処理できるよう、強化学習(RL)を頻繁に用いてモデルをトレーニングしています。以前は自前のトレーニングクラスタを自社で管理しなければならず、クラスタの保守やデバッグ作業だけに数日から数週間もの時間を費やしていました。Snowflake Cortex Trainingの導入により、私たちは作業時間の100%を実験とモデル学習だけに集中できるようになりました。その上、使い慣れた好みのフレームワークを変更する必要も、開発の柔軟性を妥協する必要も一切ありませんでした。
Jeff Ma and Parinthapat Pengpun
Researchers, OpenHands
独自の方法でモデルを柔軟にトレーニングおよびカスタマイズする
強力なベースモデルができたら、タスクに最適なトレーニング戦略を使用して適応させます。Cortex Trainingは、Qwen、Nemotron、Gemma、DeepSeekなど、さまざまなパラメータサイズの最先端のオープンウェイトモデルをサポートしています。チームは、SFT、RL、直接選好の最適化、蒸留、継続的な事前トレーニング、中間トレーニングにLoRAまたはフルパラメータトレーニングを使用できます。
Cortex Trainingは、Hugging Face TRL、PrimeRL、veRL、SkyRLなどの一般的なポストトレーニングフレームワークと統合されているため、これらのフレームワークをすでに使用しているチームはすぐにオンボードできます。また、OpenHandsなどのエージェントプラットフォームと統合して、モデルとエージェントハーネス全体をトレーニングすることもできます。これらの統合を超えて、サーバーレスAPIはエンタープライズワークロード向けのエージェント主導のモデルのカスタマイズを可能にし、トレーニングの複雑さを軽減し、専門的なAIの専門知識がなくてもカスタマイズにアクセスできるようにします。
より高度な制御のために、高度なMLチームは低レベルのAPIを使用して、カスタム損失関数、モデルアーキテクチャ、トレーニングループを定義できます。たとえば、Cortex Trainingは、ロールアウト(モデルの応答またはエージェントのインタラクション)の生成、モデルの重みの更新、システム全体での重みの同期を行うためのAPIを提供します。これらの構成要素により、動作を繰り返し生成し、結果を評価し、その結果を使用して時間の経過とともにモデルを改善するRLワークフローが可能になります。
この柔軟性は、基盤となるインフラストラクチャにも及びます。Cortex Trainingは、GPUで実行されているコードをユーザーが完全に可視化できるオープンソースバックエンドであるArcticプラットフォームを利用しています。高度なチームは、PRを提供し、より広範なAI/MLコミュニティからの新しい技術やイノベーションをトレーニングワークロードに組み込むことができます。
レシピ、統合、スキルの完全なセットについては、Cortex Trainingの例をご覧ください。
Snowflake AI Researchのモデリングチームでは、Arctic-SWEをはじめとするソフトウェアエンジニアリング(SWE)エージェントの構築において、Cortex Trainingをバックエンドとした「prime-rl」を採用しています。これにより、クラスタの運用管理を一切行うことなく、サーバーレスGPU基盤上で独自のアルゴリズムフレームワークや学習レシピを自在に開発することが可能です。最先端(SOTA)のソフトウェアエンジニアリング性能を引き出すために求められるトレーニングダイナミクスを、インフラ管理の負担ゼロで実現しています。
Boyi Liu
Senior Research Scientist, Snowflake AI Research
評価と反復
トレーニングは、新しいモデルが測定可能に優れている場合にのみ価値があります。Cortex Trainingを使用すると、チームはバッチ推論用にトレーニング済みのチェックポイントをロードしたり、評価やアプリケーションテストのためにエンドポイントの背後に展開したりできます。Snowflake ML実験を使用して、トレーニングの実行を追跡し、カスタムメトリクスをログに記録し、パフォーマンスを観察し、実験全体で実行を比較できます。これにより、自動ログ記録に依存するのではなく、キャプチャされるデータを完全に制御できます。チェックポイントはサーバー側に保持されるため、チームはトレーニングを再開したり、以前のチェックポイントから新しい実験を開始したりできます。
エージェントとアプリケーションへの展開
モデルが必要な品質とコストの目標を満たしたら、チームはそれを推論のために展開できます。
Cortex Trainingは、専用GPUを搭載したOpenAI互換の推論エンドポイントをサポートしています。これには、インタラクティブなアプリケーションやエージェント向けのストリーミング推論、非インタラクティブなニーズ向けのバッチ推論が含まれます。
本番アプリケーションが新しい軌跡、評価、結果を生成すると、ライフサイクルが再び始まります。ベンチマーク → トレーニング → ロールアウトの生成 → 評価 → 展開と提供 → 本番環境からの学習 → 再トレーニング。このループにより、エンタープライズデータとアプリケーションの経験が、ますます有能で専門的なモデルになります。
オープンな基盤によるコスト効率
Cortex Trainingは最適化された構成をすぐに提供しますが、高度なチームは特定のワークロードに合わせて調整したり、アップストリームに改善を提供したりできます。使用量はGPU時間で請求されるため、トレーニングが速くなるとコストが直接下がります。
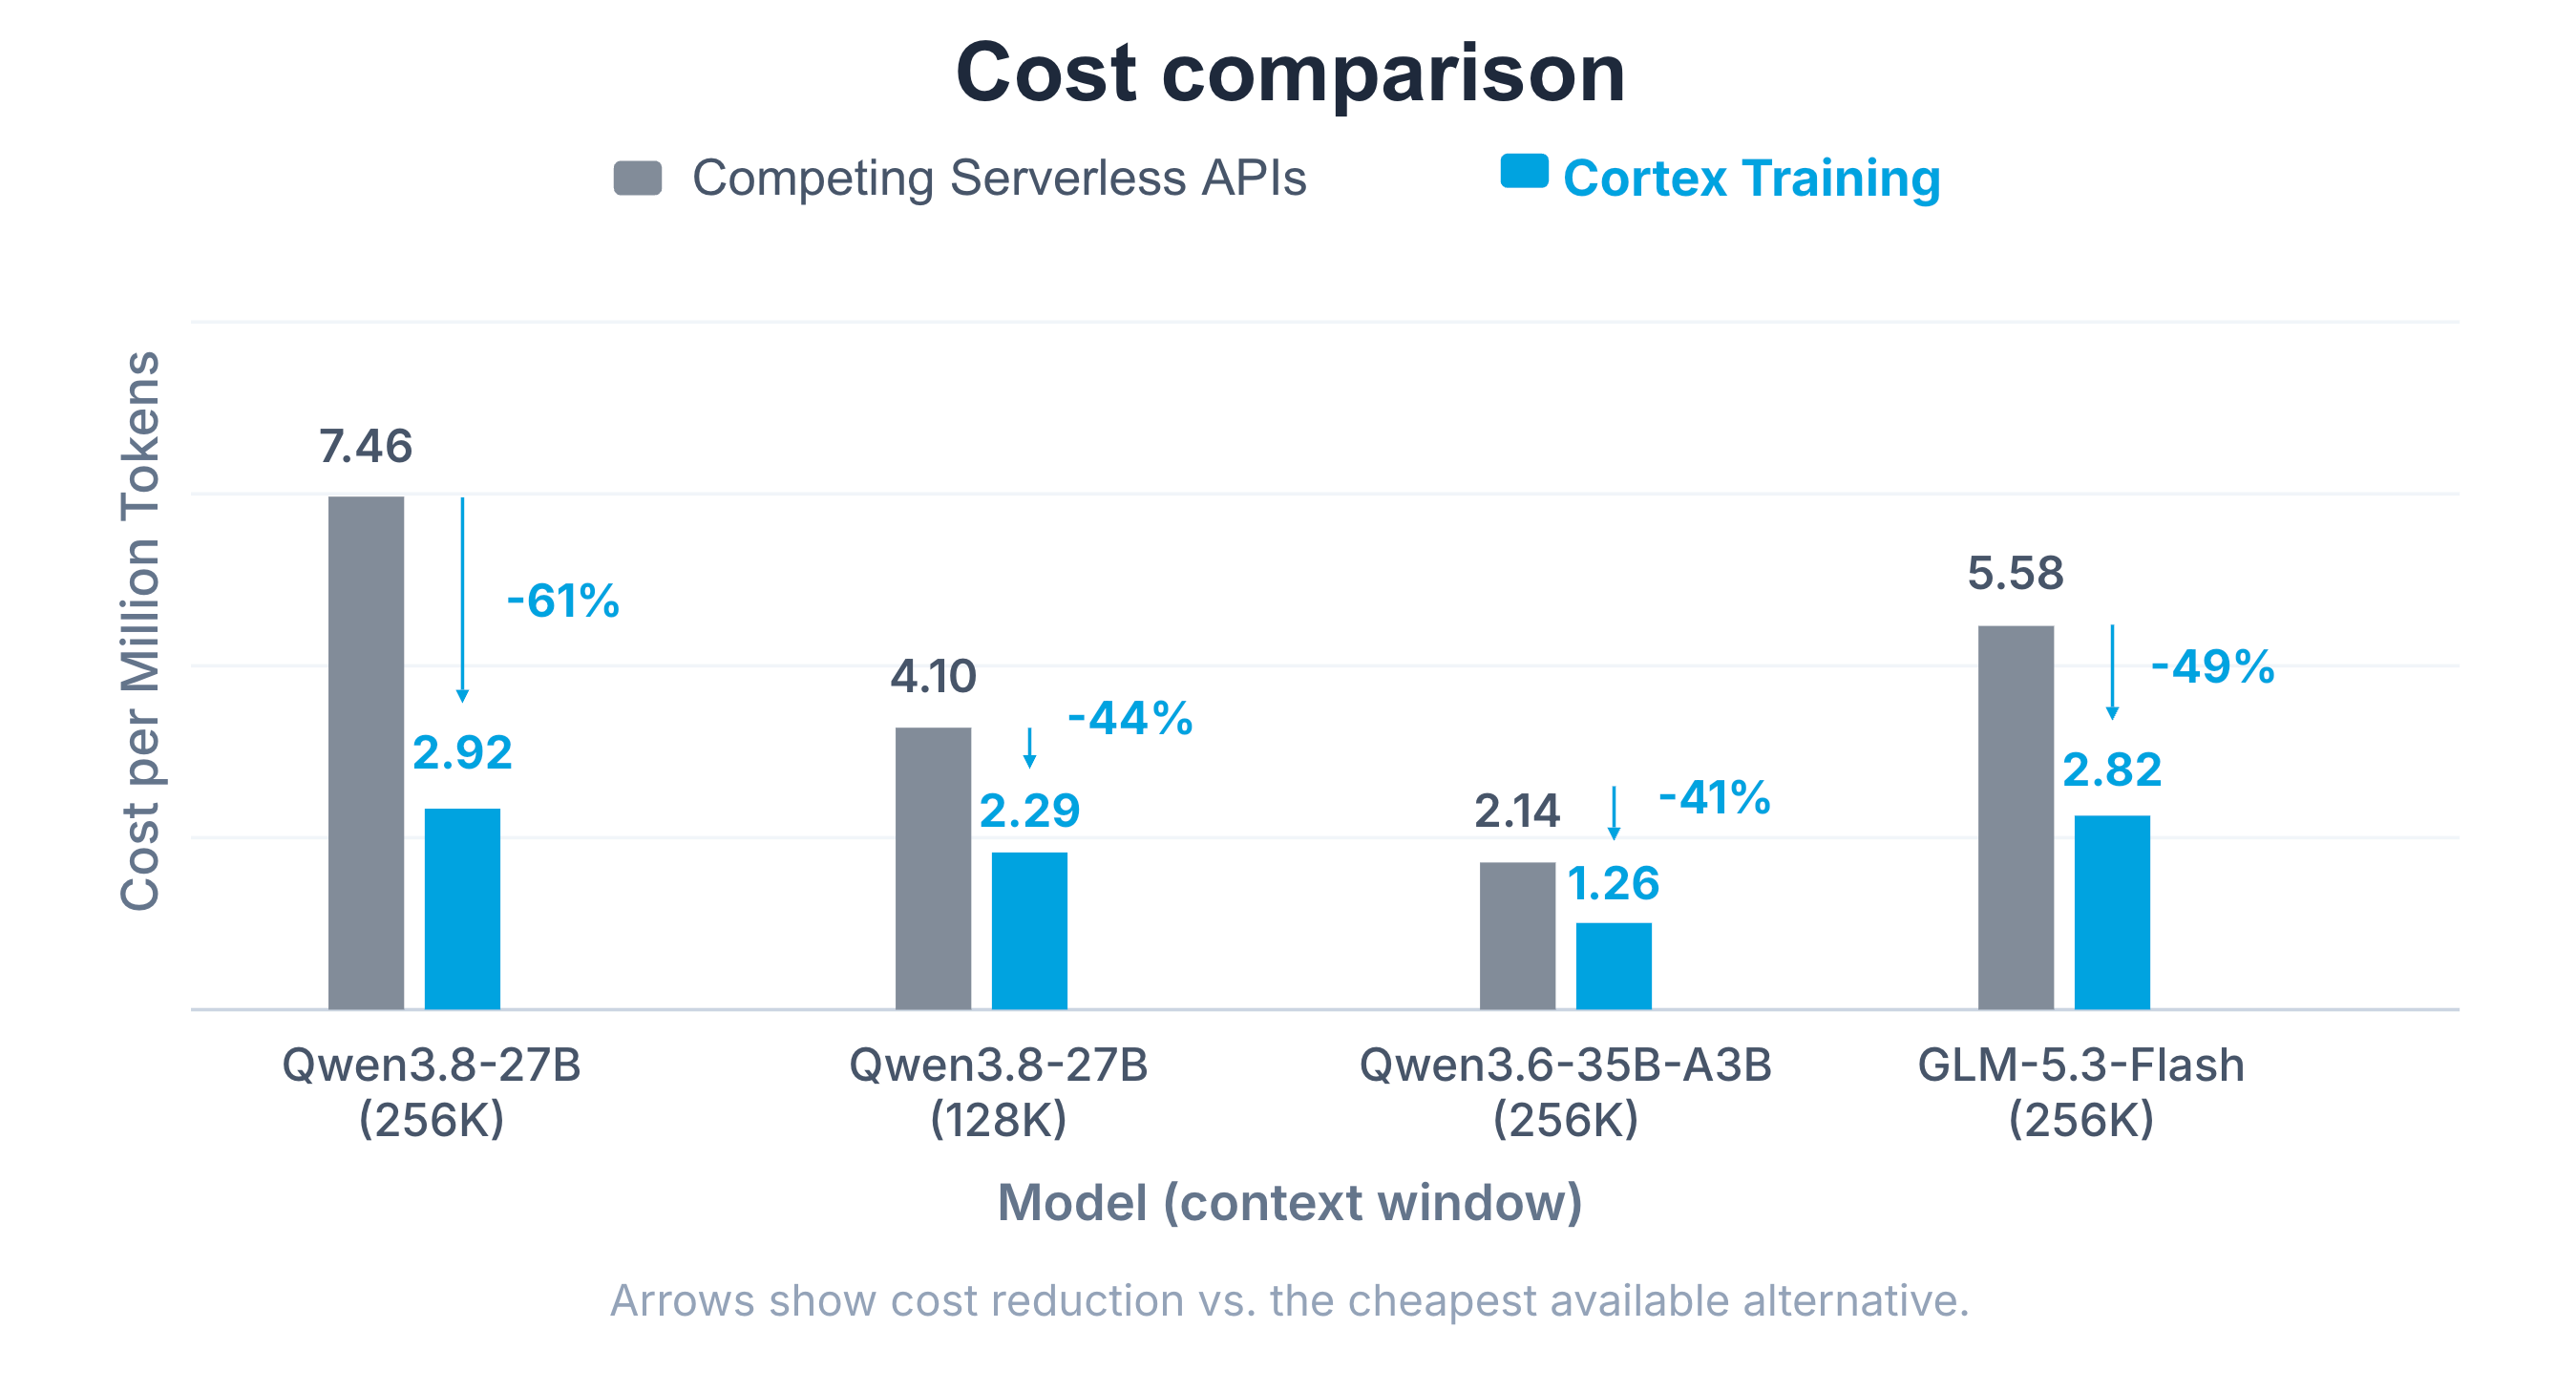
他のサーバーレストレーニングAPIと比較して、Cortex TrainingはLoRAトレーニングに強力なコスト効率を提供します。当社のベンチマークでは、Cortex Trainingは競合するサーバーレストレーニングAPI製品(Tinkerなど)よりも最大61%低コストです。[1]
Poetiqは、独自の再帰的自己改善(recursive self-improvement)アプローチを用いて、世界で最も強力なオプティマイザ(最適化エンジン)を構築しています。私たちはSnowflakeと共に、最適化領域に特化した世界初の大規模言語モデル(LLM)の事後学習(ポストトレーニング)を開始しました。Cortex Trainingの使いやすさと柔軟性のおかげで、LoRAやSFT(教師あり微調整)から、当社独自のGRPO実装を用いたフルパラメータの事後学習に至るまで、私たちが求めるあらゆるワークロードを滞りなく処理できています。
Ian Fischer
Co-CEO, Poetiq
LLMポストトレーニングを始める
- 開始を支援するために、既存のSnowflakeアカウント内で完全に動作する、使いやすいクイックスタートノートブックを用意しました。
- 開始リポジトリを読むか、これらのすぐに使えるレシピのいずれかを選択してください。
- Cortex Trainingの詳細については、ドキュメントを確認するか、ウェブページにアクセスしてください。
- サポートが必要な場合、またはSnowflakeのAIスペシャリストに相談する場合は、アカウントチームにお問い合わせください。
- コスト比較方法:競合するサーバーレスAPIオファリングの価格は、2026年10月22日にウェブページで公開された価格に基づいています。図5で指定されたコンテキスト長を使用して、Cortex TrainingでLoRA SFTトレーニングワークロードを実行し、H200 GPUあたりのスループットを測定しました。スループット(toks/sec)を使用して、式(price_per_second / throughput)x 1Mを使用して、Cortex Trainingの100万トークンあたりの価格を計算しました。↩


