10. Sept. 2026/Lesezeit: 7 MinutenStrategie & Einblicke
Autonomes Data Engineering: Ein 5-Stufen-Modell für die Ära der KI-Agenten
Data Engineering ist ein harter Job – man wacht auf und findet fehlgeschlagene Ausführungen vor, deren Untersuchung Stunden dauert, man muss einen ständigen Rückstau an Anfragen und Anforderungen von Geschäftsteams abarbeiten und Finanzteams Rede und Antwort stehen, die wissen wollen, warum die Kosten für all diese Pipelines immer weiter steigen. Und in vielerlei Hinsicht macht KI es noch schwieriger, da sie mehr und unterschiedlichere Arten von Daten einbringt und viel mehr Personen im gesamten Unternehmen ermöglicht, diese Daten durch Programmier- und Chat-Agenten zu nutzen, die SQL für sie schreiben können. Die meisten Data Engineering-Teams versuchen, Schritt zu halten, indem sie ihre eigenen Programmier-Agenten einsetzen, aber dennoch scheinen sie immer weiter ins Hintertreffen zu geraten.
Ein Bericht der MIT Technology Review zum Thema „Redefining Data Engineering in the Age of AI“ ergab, dass zwar acht von zehn Unternehmen KI-basierte Data-Engineering-Tools einsetzen, Data Engineers jedoch auch mit einer höheren Komplexität umgehen müssen. Dabei wird die Gewährleistung von Datensicherheit und Datenschutz als größte Herausforderung genannt (55 %).
Wir brauchen einen grundlegenderen Wandel. Anstatt sich darauf zu verlassen, dass KI bestehende Prozesse beschleunigt, ist es an der Zeit, die Prozesse selbst zu überdenken und über das manuelle Erstellen und Pflegen von Pipelines hinauszugehen. Datenteams werden mehr Zeit haben, sich auf das Ergebnis des Data Engineering, die Datenprodukte, zu konzentrieren, anstatt auf den Prozess der schrittweisen Transformation dieser Rohdaten. Es wird für Teams von entscheidender Bedeutung sein, sicherzustellen, dass Daten sowohl für Menschen als auch für KI nutzbar sind, wobei Kontext und Governance intakt bleiben.
Die Zukunft des Data Engineering wird davon abhängen, tatsächliche, nutzbare Datenprodukte zu erstellen, die Geschäftsentscheidungen vorantreiben können, und wirklich autonome Agenten alles erstellen, pflegen und optimieren zu lassen, was erforderlich ist, um diese Produkte auf dem neuesten Stand zu halten, wobei Menschen die wichtigsten Entscheidungsträger:innen und Schiedsrichter:innen sind.
Diese Agenten werden auf benötigte neue Produkte sowie auf Probleme und Ausfälle bei bestehenden Produkten achten und nach Möglichkeiten zur Verbesserung, Bereinigung und Optimierung suchen.
Menschen werden natürlich von entscheidender Bedeutung sein, aber ihre Rolle wird aufgewertet: Sie definieren die wichtigsten Geschäftsprobleme, leiten die Agenten zur richtigen Gesamtarchitektur an und stellen sicher, dass der Geschäftskontext für die Agenten, die die Datenprodukte nutzen, angemessen erfasst wird.
Jobs, die durch KI „professionalisiert“ werden, wachsen doppelt so schnell wie Jobs, die durch KI „demokratisiert“ werden – mit einem um 42 % schnelleren Lohnwachstum seit 2021. Quelle: PwC AI Jobs Barometer 2026
Source: PwC AI Jobs Barometer 2026
Der Weg zum autonomen Data Engineering
Dies ist ein großer Wandel, und Teams werden dieses Ziel nicht über Nacht erreichen können, und das sollten sie auch nicht. Ein besserer Ansatz besteht darin, zu entscheiden, dass dies das richtige Ziel ist, und sich dann schrittweise und überlegt darauf zuzubewegen. Bei jedem Schritt werden Teams mehr darüber erfahren, wozu die Agenten und Modelle in der Lage sind, und Vertrauen darin aufbauen, wie viel sicher automatisiert werden kann und wo Sie zusätzliche Human-in-the-Loop-Prüfungen (HITL), Tools oder Prozesse benötigen. Viele Unternehmen sind bereits auf dem Weg: Jedes Team, das einen softwaredefinierten Lebenszyklus, Versionskontrolle, deklarative Pipelines oder KI-gestützte Entwicklung eingeführt hat, hat einen Schritt in die Zukunft gemacht.
Die Reifegradkurve für autonomes Data Engineering
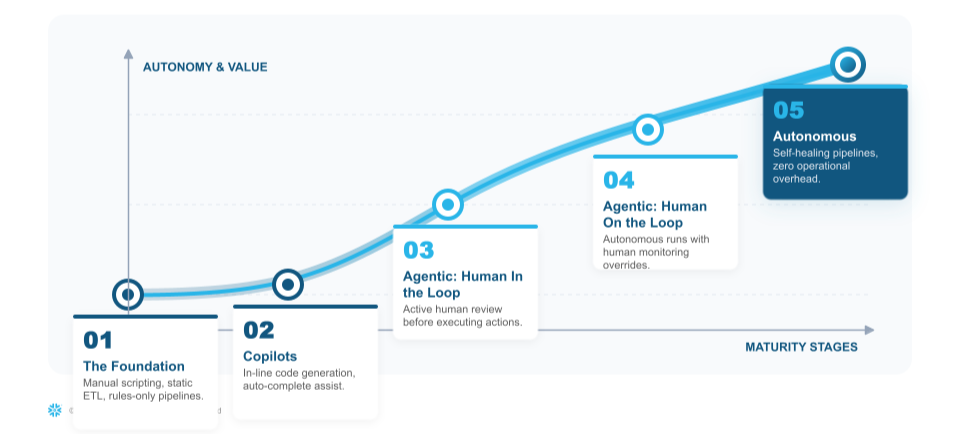
| Stufe 1: Die Grundlage |
In dieser Phase erstellen und pflegen Data Engineers Pipelines manuell. Jede Schemaänderung, Orchestrierungsentscheidung und Reaktion auf Fehler erfordert menschliches Eingreifen. Teams, die Stufe 1 als den Ort betrachten, an dem sie ihre Engineering-Grundlagen in Ordnung bringen, werden in späteren Phasen mehr Erfolg haben. Der Übergang zu moderneren Data Engineering-Praktiken, wie z. B. deklarativen Pipelines, kann zu einer verbesserten Effizienz führen. Travelpass beispielsweise machte seine Data Engineering-Bemühungen zugänglicher, was dem Team half, zu skalieren und Daten über 350 % effizienter an Geschäftsbereiche zu liefern. |
| Stufe 2: Copilots |
Hier hält KI Einzug in den Editor. Autovervollständigung und Inline-Codegenerierung reduzieren die Reibung bei Transformation und Konfiguration, aber die Engineers treffen immer noch jede Entscheidung. Der grundlegende Workflow hat sich nicht geändert, auch wenn der Output gestiegen ist. |
| Stufe 3: Agentic: Human in the Loop |
In Stufe 3 wird KI zu einem Mitarbeiter. Agenten können Änderungen wie Pipeline-Modifikationen, Fehlerbehebungen und Schema-Migrationen vorschlagen, aber nichts wird ohne ausdrückliche menschliche Genehmigung ausgeführt. Engineers überprüfen Code, anstatt ihn zu schreiben, was dazu beitragen wird, die Reaktionszeit bei Vorfällen radikal zu verkürzen. |
| Stufe 4: Agentic: Human on the Loop |
An diesem Punkt beginnen die Vorteile der Automatisierung wirklich zu glänzen. Agenten handeln unabhängig bei ausgewählten, klar definierten Aufgaben, wie dem Erkennen von Anomalien und dem Anpassen von Pipelines an vorgelagerte Änderungen, ohne auf eine Genehmigung zu warten. Engineers haben weiterhin Einblick in das, was Agenten tun, und können die Aktionen der Agenten bei Bedarf außer Kraft setzen. |
Stufe 5: |
In Stufe 5 hat Data Engineering grundlegend verändert, was es bedeutet, mit Daten zu arbeiten. Pipelines erkennen ihre eigenen Fehler und Ursachen im gesamten Stack, wenden Korrekturen an, validieren Ergebnisse und dokumentieren Änderungen ohne menschliches Eingreifen. Der betriebliche Aufwand geht gegen null. Data Engineers definieren die Richtlinien, Standards und Geschäftssemantik. Sie entscheiden auch, was die Plattform autonom tun darf und was ihr Urteilsvermögen erfordert, sodass Änderungen mit großen Auswirkungen zur menschlichen Überprüfung weitergeleitet werden. Ihre Rolle hat sich vollständig von der Ausführung zur Governance verlagert, und sie haben sich von Pipeline-Erstellern zu echten Geschäftspartnern entwickelt. |
„Alles ausschließlich in Snowflake zu erledigen, war ein Gamechanger. Jetzt entwerfen wir an einem Donnerstag etwas, und am Dienstag ist es bereits in Produktion.“
Thomas Bodenski
COO & Chief Data & Analytics Officer, TS Imagine
Neudefinition der Erstellung von Datenprodukten in der Ära der KI-Agenten
Eine der großen Veränderungen, die dies ermöglicht, ist der Übergang vom Denken in Daten-Pipelines zum Denken in Datenprodukten, die nicht nur Daten umfassen, sondern auch Semantik, Qualität und alles, was ein Agent benötigt, um seine Aufgaben mit den Daten erfüllen zu können. Beispielsweise kann ein Datenprodukt zur Kundenbindung Daten zum Abwanderungsrisiko von Kund:innen enthalten, die die Aktivitätsdaten jedes einzelnen Kontos mit einer semantischen Ansicht verknüpfen, die definiert, was das Unternehmen als „gefährdet“ einstuft, zusammen mit dokumentierten Qualitätsprüfungen. Jeder Agent oder jede:r Analyst:in, der oder die auf dieses Datenprodukt zugreift, würde dann eine konsistente, vertrauenswürdige Antwort für seine oder ihre Bemühungen zur Kundenbindung erhalten.
Das traditionelle Modell geht von der Infrastruktur aus und baut darauf auf: die Datengrundlage aufbauen, Schemata definieren, Pipelines erstellen und dann einen geschäftlichen Bedarf bedienen. Das funktionierte, als Datenprodukte noch selten und stabil waren.
Moderne Datenteams gehen umgekehrt vor: Beginnen Sie mit dem Geschäftsproblem und identifizieren Sie den Agenten-Workflow, der es löst. Bestimmen Sie, welche Daten dieser Agent benötigt, und erstellen Sie das Datenprodukt, um diese bereitzustellen. Dies richtet den Datenbestand an Geschäftsergebnissen statt an technischen Ebenen aus und führt einen vertikalen Ansatz für Datenprodukte ein, bei dem Pipelines auf Ergebnisse und nicht auf Schemata ausgelegt sind.
Beim echten autonomen Data Engineering ist die Plattform genauso wichtig wie die Wahl des Agenten-Framework. Leistungsstarke Teams müssen zunächst Versionskontrolle, automatisierte Tests und CI/CD-Pipelines festigen – dieselben Best Practices, die leistungsstarke Datenteams seit Jahren anwenden. Governance, Interoperabilität und vereinheitlichte Daten sind die Voraussetzungen, die es sicher machen, autonomen Workflows zu vertrauen.
Schaffen Sie die Grundlage; autonomes Data Engineering wird folgen
Der Wechsel zu autonomem Data Engineering ist eine betriebliche Notwendigkeit. Die Teams, die am schnellsten die Reife erreichen, werden dies nicht tun, weil sie die besten Modelle hatten. Sie werden dieses Ziel erreichen, weil sie die Rolle der Data Engineers zu Geschäftspartnern aufgewertet und ein Fundament geschaffen haben, das stark genug ist, damit autonome Agenten darauf arbeiten können, und dessen Governance so solide ist, dass man ihnen vertrauen kann.
Um auf diesem Weg erfolgreich zu sein, müssen Kunden auf eine Plattform setzen, die nicht nur ihre heutigen Anforderungen erfüllt, sondern sich auch weiterentwickelt und neue Innovationen sowohl im Data Engineering als auch in der KI aufnimmt, ohne alles selbst zusammenfügen oder aufbauen zu müssen. Erfahren Sie, wie Snowflake mit dem Data-eng-benchmark den Standard zur Messung von Qualität und Token-Effizienz für autonome Data Engineering-Arbeiten setzt.
Für einen praktischen Leitfaden für die ersten Schritte mit autonomem Data Engineering, einschließlich Architekturmustern, Governance-Frameworks und den Engineering-Praktiken, die Agenten-Workflows zuverlässig machen, lesen Sie Build Pipelines for AI: An Essential Guide to Smarter Data Engineering.
