データエンジニアリングは困難な業務です。失敗した実行の調査に何時間も費やし、ビジネスチームからの絶え間ない要望やニーズのバックログに対応し、パイプラインのコストが上昇し続ける理由を知りたがる財務チームに説明する必要があります。さらに、AIは多くの点でこの状況を難しくしています。より多くの多様なデータをもたらし、SQLを記述できるコーディングやチャットエージェントを通じて、社内のより多くの人々がそのデータを使用できるようにしているためです。ほとんどのデータエンジニアリングチームは、独自のコーディングエージェントを導入して遅れを取らないようにしていますが、それでもますます遅れをとっているようです。
MITテクノロジーレビューのレポート『AI時代におけるデータエンジニアリングの再定義』によると、8割の組織がAIベースのデータエンジニアリングツールを導入している一方で、データエンジニアは増大する複雑性への対応にも追われており、最大の課題として『データのセキュリティとプライバシーの確保(55%)』が報告されています。
より根本的なシフトが必要です。既存のプロセスを高速化するためにAIに頼るのではなく、プロセス自体を見直し、パイプラインの手動での構築や維持から脱却する時期に来ています。データチームは、生データを段階的に変換するプロセスよりも、データエンジニアリングの成果物であるデータプロダクトに集中するための時間をより多く確保できるようになります。チームにとって、コンテキストとガバナンスを維持したまま、人間とAIの両方がデータを消費できる状態にすることが重要になります。
データエンジニアリングの未来は、ビジネスの意思決定を促進できる実用的で有用なデータプロダクトを作成すること、そして、人間を主要な意思決定者および裁定者として、それらのプロダクトを最新の状態に保つために必要なすべてを真に自律的なエージェントに構築、維持、最適化させることにかかっています。
これらのエージェントは、必要とされる新しいプロダクト、既存のプロダクトの問題や障害に注意を払い、改善、クリーンアップ、最適化の機会を探索します。
もちろん人間は重要ですが、その役割は高度化します。最も重要なビジネス課題を定義し、適切な全体アーキテクチャについてエージェントを導き、データプロダクトを消費するエージェントのためにビジネスのコンテキストが適切に捉えられていることを確認します。
AIによって『専門性が高められた(プロフェッショナル化された)』職種は、AIによって『民主化された』職種の2倍のペースで雇用が拡大しており、2021年以降の賃金上昇率においても42%上回っています。
Source: PwC AI Jobs Barometer 2026
自律型データエンジニアリングへのジャーニー
これは大きな変化であり、チームが一夜にして到達できるものではなく、そうすべきでもありません。より良いアプローチは、これが正しい目標であると判断し、段階的かつ慎重にそこに向かって進むことです。各ステップで、チームはエージェントとモデルの機能について学び、どこまで安全に自動化できるか、どこに追加のヒューマンインザループ(HITL)チェック、ツール、またはプロセスが必要かについて信頼を築きます。多くの企業がすでにこの取り組みを進めています。ソフトウェア定義のライフサイクル、バージョン管理、宣言型パイプライン、またはAI支援開発を導入したすべてのチームは、未来に向けて一歩を踏み出しています。
自律型データエンジニアリングの成熟度曲線
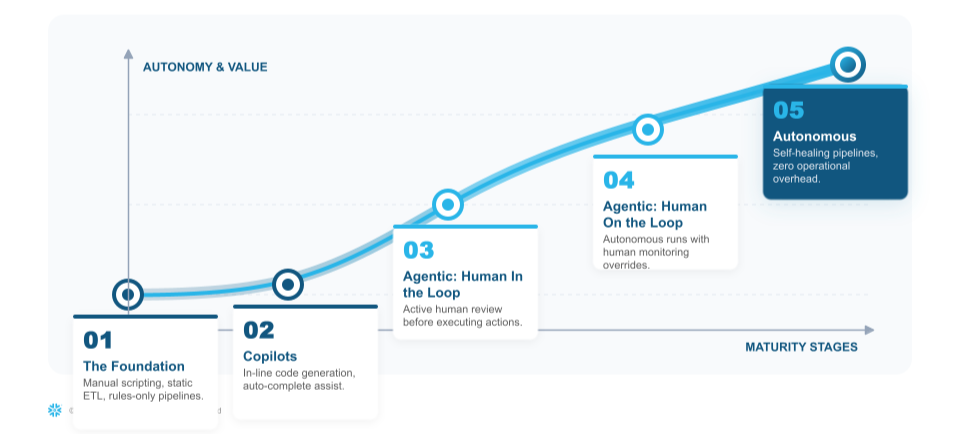
| ステージ1: 基盤の構築 |
このステージでは、データエンジニアが手動でパイプラインを構築および維持します。スキーマの変更、オーケストレーションの決定、障害対応のすべてに人間の労力が必要です。ステージ1をエンジニアリングのFundamentalsを正しく理解する場として扱うチームは、後のステージでより大きな成功を収めるでしょう。宣言型パイプラインなど、よりモダンなデータエンジニアリングプラクティスへの移行により、効率が向上します。たとえばTravelpassは、データエンジニアリングの取り組みをよりアクセスしやすくし、チームの規模を拡大して、ビジネス部門へのデータ提供の効率を350%以上向上させました。 |
| ステージ2: コパイロット |
ここでAIがエディターに導入されます。オートコンプリートとインラインコード生成により、変換と構成の摩擦が軽減されますが、エンジニアは依然としてすべての決定権を持っています。出力は増加しましたが、基本的なワークフローは変わっていません。 |
| ステージ3: エージェンティック:ヒューマンインザループ |
ステージ3は、AIがコラボレーターになり始める段階です。エージェントはパイプラインの変更、障害の修正、スキーマの移行などの変更を提案できますが、人間の明示的な承認なしには何も実行されません。エンジニアはコードを書く代わりにレビューを行うため、インシデントの応答時間を大幅に短縮できます。 |
| ステージ4: エージェンティック:ヒューマンオンザループ |
この時点で、自動化のメリットが真に発揮され始めます。エージェントは、異常の検出や上流の変更へのパイプラインの適応など、選択された明確に定義されたタスクに対して、承認を待たずに独立して行動します。エンジニアは依然としてエージェントの行動に対するオブザーバビリティを持ち、必要に応じてエージェントのアクションをオーバーライドできます。 |
ステージ5: |
ステージ5では、データエンジニアリングにより、データに関わる業務の意味が根本的に変わります。パイプラインは、人間の介入なしに、スタック全体で自身の障害と根本原因の問題を検出し、修正を適用し、結果を検証し、変更内容を文書化します。運用オーバーヘッドはゼロに近づきます。 データエンジニアは、ポリシー、標準、ビジネスセマンティクスを定義します。また、プラットフォームが自律的に実行できることと、自身の判断が必要なことを決定し、影響の大きい変更は人間のレビューに回されるようにします。彼らの役割は実行からガバナンスへと完全に移行し、パイプラインの構築者から真のビジネスパートナーへと昇格します。 |

“すべての作業をSnowflake上で完結させたことは、まさに画期的でした。今では、木曜日に設計したものが、翌週の火曜日にはもう本番環境で稼働しています”
Thomas Bodenski
COO & Chief Data & Analytics Officer, TS Imagine
エージェンティック時代におけるデータプロダクト構築の再定義
これを可能にする大きな変化の1つは、データパイプラインについて考えることから、データプロダクトについて考えることへの移行です。データプロダクトには、データだけでなく、セマンティクス、品質、およびエージェントがデータを使用してタスクを達成するために必要なすべてが含まれます。たとえば、顧客ロイヤルティのデータプロダクトには、顧客のチャーンリスクデータが含まれる場合があります。これは、個々のアカウントのアクティビティデータと、ビジネスが「リスクあり」と定義するセマンティックビュー、および文書化された品質チェックを組み合わせたものです。このデータプロダクトにアクセスするエージェントやアナリストは、顧客ロイヤルティの取り組みに対して一貫した信頼できる回答を得ることができます。
従来のモデルはインフラストラクチャから始まり、データファウンデーションを構築し、スキーマを定義し、パイプラインを作成してから、ビジネスニーズに対応するというように積み上げていきます。これは、データプロダクトが少なく安定していた時代には機能しました。
モダンなデータチームはこれを逆に行っています。ビジネス課題から始め、それに対処するエージェントのワークフローを特定します。そのエージェントが必要とするデータを決定し、それを提供するデータプロダクトを構築します。これにより、データエステートの方向性が技術的なレイヤーではなくビジネスの成果に向けられ、データプロダクトへの垂直的なアプローチが導入されます。ここでは、パイプラインはスキーマではなく結果のために設計されます。
真の自律型データエンジニアリングでは、プラットフォームはエージェントフレームワークの選択と同じくらい重要です。パフォーマンスの高いチームは、まずバージョン管理、自動テスト、CI/CDパイプラインを固める必要があります。これらは、パフォーマンスの高いデータチームが長年採用してきたのと同じベストプラクティスです。ガバナンス、相互運用性、統合されたデータは、自律型ワークフローを安全に信頼するための前提条件です。
基盤の構築:自律型データエンジニアリングへの道
自律型データエンジニアリングへの移行は、運用上の必要性です。最も早く成熟に達するチームは、最高のモデルを持っていたからそこに到達するわけではありません。データエンジニアの役割をビジネスパートナーに引き上げ、自律型エージェントが動作するのに十分な強固な基盤と、それらを信頼するのに十分な強固なガバナンスを構築したためです。
このジャーニーで成功するためには、お客様は、現在のニーズを満たすだけでなく、すべてを自分たちでつなぎ合わせたり構築したりすることなく、データエンジニアリングとAIの両方における新しいイノベーションを進化させ、吸収し続けるプラットフォームに賭ける必要があります。SnowflakeがData-eng-benchmarkを使用して、自律型データエンジニアリング作業の品質とトークン効率を測定する標準をどのように設定しているかについて、詳しくはこちらをご確認ください。
アーキテクチャパターン、ガバナンスフレームワーク、エージェンティックなワークフローの信頼性を高めるエンジニアリングプラクティスなど、自律型データエンジニアリングを始めるための実践的なガイドについては、AIのためのパイプライン構築:よりスマートなデータエンジニアリングのための必須ガイドをご覧ください。


