애플리케이션 데이터를 분석에 활용하는 데 복잡한 파이프라인이 필요해서는 안 됩니다. 그런데 오늘부터는 필요하지 않습니다. Postgres 데이터 미러링 기능이 GA로 제공되기 때문입니다.
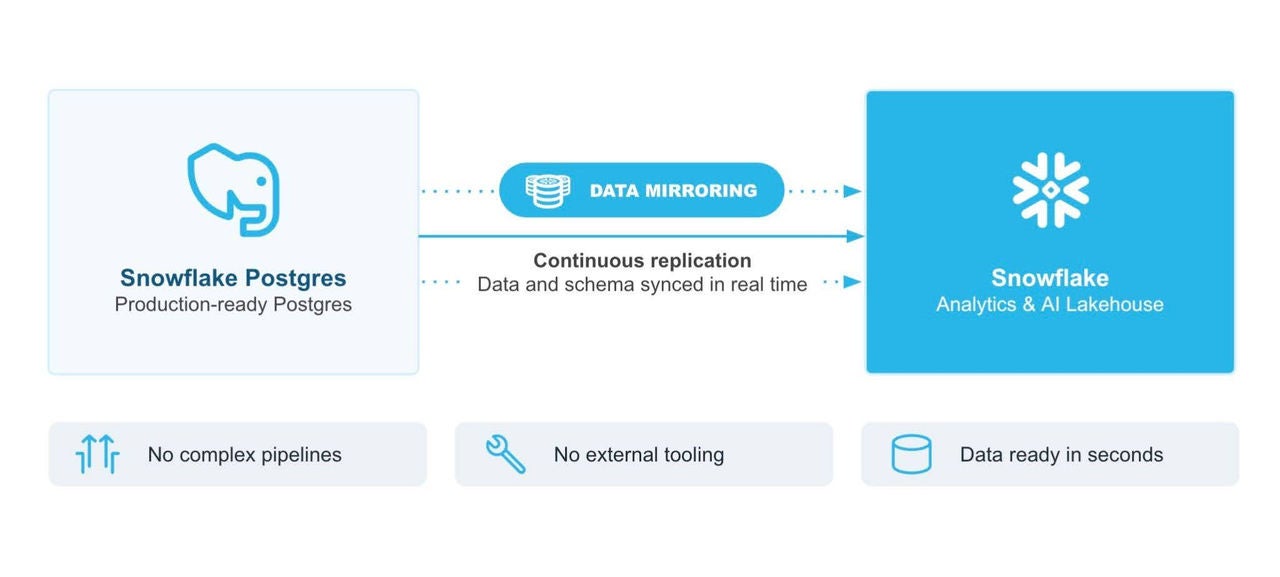
Postgres 데이터 미러링은 분석과 AI를 위해 Postgres 테이블을 Snowflake로 원활하게 복제합니다. 몇 초 만에 미러를 설정하면 모든 삽입, 업데이트, 삭제가 Snowflake로 직접 전달됩니다. 스키마 변경은 자동으로 반영되고 새 테이블도 자동으로 감지됩니다.
무엇보다 배포하거나 관리해야 할 외부 인프라가 없습니다. Postgres와 Snowflake가 매끄럽게 연동될 뿐입니다.
파이프라인 부담을 없애는 데이터 미러링
데이터 팀에 가장 고된 업무가 무엇인지 물어보면 같은 답이 돌아옵니다. 바로 트랜잭션 시스템과 분석 시스템 사이에서 데이터를 옮기는 일입니다. 팀은 CDC 커넥터를 계속 관리하고, 깨지는 배치 작업과 어긋나는 스냅샷을 수습하느라 어려움을 겪습니다. 이 문제는 30년 동안 이어져 왔고, 우리는 이런 상황을 당연하게 받아들이는 데 너무 익숙해졌습니다.
AI 시대에는 적시성이 중요합니다. 실시간으로 조치할 수 있는 위치에 데이터가 준비되어 있으면 기술 부채를 줄이고 팀이 필요한 데이터를 지체 없이 활용할 수 있어 비즈니스 가치를 창출할 수 있습니다. 지연되고 지속적인 관리가 필요한 파이프라인은 엔지니어링 시간만 소모하는 것이 아닙니다. 데이터를 실제 상황보다 몇 시간, 심지어 며칠씩 뒤처지게 만듭니다. 어젯밤 배치로 적재한 데이터로는 사기 탐지 모델이 오늘의 공격을 막을 수 없습니다. 데이터 미러링은 이러한 시차를 없애 줍니다.
작동 방식: Postgres 데이터 미러링
데이터 미러링은 Postgres 데이터를 Snowflake로 지속적으로 복제하며, 변경 사항을 수초 내에 반영합니다. 미러를 생성하면 Snowflake는 원본 테이블의 현재 상태를 반영하도록 대상 테이블을 유지합니다. 스키마 변경 사항뿐 아니라 미러링 대상 스키마에 추가한 새 테이블도 반영됩니다.
Snowsight 인터페이스에서 몇 번 클릭하거나 단일 SQL 명령으로 설정할 수 있으며, 더 간편하게 설정하려면 Snowflake CoCo에 요청하기만 하면 됩니다.
데이터 미러링은 다음과 같은 이점을 제공합니다.
추가 인프라 불필요: 미러는 Snowflake 내부에서 실행되므로 처리해야 할 추가 서비스나 공급업체가 없습니다.
최신 읽기: 미러링된 모든 테이블에는 이미 적용된 데이터와 진행 중인 변경 사항을 결합하는 실시간 $live 뷰가 포함됩니다. 사용자는 원본에서 커밋된 변경 사항을 수 초 내에 확인할 수 있습니다.
트랜잭션 일관성: 원본의 단일 트랜잭션에서 발생한 변경 사항은 대상 시스템에도 함께 반영됩니다. 외래 키 관계가 유지되고 조인 결과도 정확하게 유지됩니다.
기본 제공되는 변경 이력: 모든 테이블에는 삽입, 업데이트, 삭제를 보여주는 7일간의 변경 피드($changes)가 제공됩니다. 이 피드는 Snowflake와 Postgres 양쪽에서 모두 쿼리할 수 있습니다.
규모가 커져도 고처리량 유지: 최적화된 적용 전략은 전체 테이블 스캔을 건너뛰므로 데이터가 증가해도 비용과 성능이 안정적으로 유지됩니다.
무엇보다 이 모든 것은 개방형 기반 위에 구축됩니다. 내부적으로 미러링은 Snowflake의 오픈소스 Postgres 확장인 pg_lake를 사용해 표준 논리적 복제로 변경 사항을 캡처하고 Apache Iceberg™ 테이블에 기록합니다. 데이터베이스와 데이터 사이에 독점 계층이 존재하지 않습니다. 운영 단순성을 위해 표준 Snowflake 테이블에 미러링할 수도 있고, 완전한 이식성을 위해 자체 스토리지의 Iceberg 테이블에 미러링할 수도 있습니다.
데이터 미러링의 차별점: 풀 방식이 아닌 푸시 방식
대부분의 복제 도구는 데이터베이스와 Snowflake 사이에 별도의 서비스를 끼워 넣습니다. 이 서비스는 Postgres 내부에서 무슨 일이 일어나는지 알지 못한 채 네트워크를 통해 변경 사항을 가져옵니다. 예를 들어 스키마가 언제 변경됐는지, 스냅샷이 진행 중인 변경 사항과 어떻게 맞물리는지, 데이터베이스 다운인지 단순한 네트워크 문제인지 알 수 없습니다. 데이터 미러링은 이 모델을 뒤집습니다.
Postgres 확장은 데이터베이스 내부에서 변경 사항을 캡처하고 이를 트랜잭션 단위 배치로 오브젝트 스토리지의 개방형 Iceberg 변경 로그에 푸시합니다. 그런 다음 Snowflake는 서버리스 컴퓨팅으로 해당 배치를 역시 트랜잭션 방식으로 적용합니다. 확장이 Postgres에서 일어나는 모든 일을 파악하므로 소스에서 스냅샷, 스키마 변경, 복구를 조율해 다운스트림에서 충돌하지 않도록 합니다.
양쪽의 트랜잭션 덕분에 모든 미러링된 테이블이 함께 전진하며 Postgres 트랜잭션 경계에 정확히 랜딩합니다. 삽입은 업서트가 아니라 추가 방식으로 처리되므로, 규모가 크고 삽입이 빈번한 테이블도 데이터가 늘어날 때 속도와 비용 효율성을 유지할 수 있습니다.
그 결과 다음과 같은 이점을 얻을 수 있습니다.
추가 공급업체 없음: 추가로 평가하거나 비용을 지불하고 관리해야 할 공급업체가 없습니다.
추가 인프라 없음: 새롭게 구축하거나 모니터링해야할 인프라가 없습니다.
느려지는 업서트 없음: 테이블이 커져도 성능 저하를 일으키지 않습니다.
변경 데이터에 대한 락인 없음: 변경 데이터가 개방형 Apache Iceberg 테이블에 랜딩되고 미러링이 Snowflake의 오픈소스 pg_lake 확장 위에 구축되기 때문입니다.
"데이터 미러링으로 데이터 관리가 간소화되어 데이터 복사 프로세스를 완전히 없앨 수 있었습니다. 지원 업무 부담과 비용이 줄었고, 고객은 채권 가격 산정에 필요한 신용 스프레드 데이터를 더 빠르고 안정적으로 받아볼 수 있게 되었습니다."
Mike Willett
Head of Analytics Data Platform, SimCorp
데이터 미러링 활용 사례
데이터 미러링은 최신 트랜잭션 데이터가 필요한 분석 및 AI 워크로드 어디에나 유용합니다. 오늘날 팀들은 다음과 같이 활용하고 있습니다.
비용 지불 대상 공급업체 하나 줄이기: Postgres 데이터를 Snowflake로 가져오기 위해 미들웨어를 운영하는 데이터 플랫폼 팀은 단 한 번의 CREATE_MIRROR 호출로 전체 파이프라인을 대체할 수 있습니다. Ericsson은 바로 이 방식을 적용해 네 개의 레거시 데이터베이스를 통합하고 동기화 파이프라인을 제거했으며 데이터 처리 시간을 99% 단축했습니다.
현재 상황을 보여 주는 대시보드: 전자상거래 팀이 주문 테이블을 Snowflake로 미러링하면 모든 구매, 취소, 반품이 몇 초 안에 표시됩니다. 운영 대시보드는 전날 마감 수치가 아니라 실시간 매출을 반영합니다. 플래시 세일로 주문이 급증하면 다음 날 보고서를 기다리지 않고 즉시 확인할 수 있습니다.
현재 상황을 정확히 파악하는 AI 에이전트: 지원 팀은 고객 계정과 주문 이력을 Snowflake에 미러링하고, Snowflake Cortex AI 에이전트는 이를 제품 데이터, 배송 상태, 과거 상호작용과 결합합니다. 고객이 ‘제가 주문한 물건은 어디까지 왔나요?’라고 물으면 에이전트는 현재 비즈니스 상태를 기반으로 답합니다.
실시간 트랜잭션 기반 사기 및 리스크 점수화: 금융 서비스 기업은 결제 이벤트를 Snowflake에 미러링하고 이를 대상으로 점수화 모델을 실시간으로 실행합니다. 의심스러운 패턴은 다음 날 아침 배치 작업이 마침내 실행된 뒤가 아니라 자금 정산 전에 플래그가 지정됩니다.
별도로 구축할 필요 없는 감사 추적: 규정 준수 팀은 사용자 지정 이력 테이블을 유지 관리하지 않고도 $changes 피드를 사용해 ‘무엇이 언제 변경됐는가?’에 답할 수 있습니다. 미러링된 테이블 전반의 모든 삽입, 업데이트, 삭제는 7일 동안 쿼리할 수 있습니다.
“이전에는 애플리케이션 데이터와 분석 데이터가 서로 다른 곳에 있었습니다. 이제는 모두 Snowflake에 있습니다. 트랜잭션 데이터가 Snowflake로 자동 미러링되므로, 고객은 별도의 작업 없이 이 데이터에 AI를 활용할 수 있습니다.”
Alan Buxton
Chief Technology Officer, Simfoni
데이터 미러링 빠르게 시작하기
데이터 미러링은 현재 Snowflake Postgres가 실행되는 모든 리전에서 AWS와 Microsoft Azure를 통해 사용할 수 있습니다. Postgres 데이터 미러링은 다음 세 단계로 시작할 수 있습니다.
Snowflake Postgres 인스턴스를 새로 생성하거나 기존 인스턴스를 사용합니다.
Snowsight에서 몇 번 클릭하거나 단일 SQL 명령을 사용하거나 CoCo에 요청해 미러를 생성합니다. 특정 테이블, 전체 스키마 또는 데이터베이스를 선택합니다.
Snowflake에서 대상 테이블을 통해 데이터를 쿼리합니다.
CALL SNOWFLAKE.POSTGRES.CREATE_MIRROR(
    mirror_name       => 'data_mirror',
    postgres_instance => 'my-pg',
    postgres_database => 'postgres',
    target_database   => 'MIRRORTOSNOWFLAKE',
    postgres_tables   => NULL,
    postgres_schemas  => ['public'],
    refresh_interval  => '1 minute',
    warehouse         => NULL
);
한 번 설정하면 이후에는 신경 쓸 필요가 없습니다.
한 가지 더, Snowflake 분석 환경의 데이터를 Postgres로 다시 미러링하는 방법이 궁금하시다면 다음 소식을 기대해 주세요.
데이터 미러링과 Snowflake Postgres에 대한 자세한 내용은 다음 리소스를 확인하세요.
미래 전망 진술
본 게시물에는 당사의 향후 제품 제공에 대한 미래 전망 진술이 포함되어 있으며, 이는 제품 제공에 대한 보장이 아닙니다. 실제 결과 및 제공 내용은 달라질 수 있으며, 알려진 위험과 알려지지 않은 위험 및 불확실성의 영향을 받을 수 있습니다. 보다 자세한 내용은 최신 10-Q를 참조하세요.

