15 de out. de 2026/Leitura: 6 minProduto e tecnologia
Data Mirroring em GA: seus dados do Postgres na plataforma Snowflake, sem pipelines
Os dados do seu app não deveriam precisar de um pipeline complexo para se tornarem dados de análise de dados. A partir de hoje, isso não é mais necessário: o recurso de espelhamento de dados do Postgres agora está em GA.
O espelhamento de dados do Postgres replica suas tabelas do Postgres diretamente no Snowflake para análise de dados e IA. Você pode configurar um espelho em segundos, e cada inserção, atualização e exclusão flui diretamente para o Snowflake. As alterações de esquema são replicadas por conta própria, e as novas tabelas são detectadas automaticamente.
E o melhor: não há infraestrutura externa para implementar ou gerenciar. É apenas o Postgres funcionando perfeitamente com a plataforma Snowflake.
O espelhamento de dados elimina o custo dos pipelines
Pergunte a qualquer equipe de dados qual é a tarefa mais difícil delas, e a resposta será a mesma: mover dados entre sistemas transacionais e analíticos. As equipes enfrentam dificuldades para monitorar conectores de CDC, tarefas em lote que falham e snapshots que ficam defasados. Esse problema existe há 30 anos, e nos acostumamos demais a aceitar que seja assim mesmo.
Agilidade é essencial na era da IA. Ter seus dados prontos e em um local onde você possa agir sobre eles em tempo real traz valor para os negócios, pois elimina a dívida técnica e fornece às equipes os dados necessários sem demora. Pipelines atrasados e que exigem monitoramento constante não consomem apenas o tempo da equipe de engenharia. Eles deixam seus dados horas ou dias atrás da realidade. Um modelo de fraude não consegue impedir o ataque de hoje usando a carga em lote da noite anterior. O espelhamento de dados elimina essa brecha.
Como funciona: espelhamento de dados do Postgres
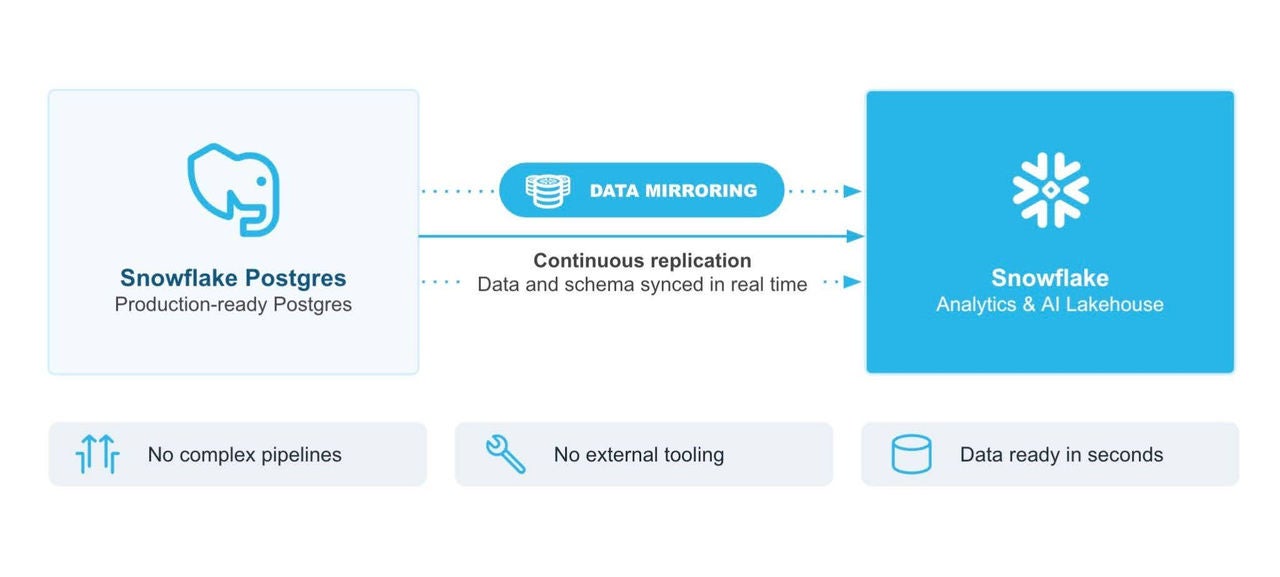
Continuamente, o espelhamento de dados replica seus dados do Postgres na plataforma Snowflake em segundos. Depois de criar um espelho, o Snowflake mantém tabelas de destino que refletem o estado atual das tabelas de origem, incluindo alterações de esquema e novas tabelas adicionadas aos esquemas espelhados.
Configure tudo com poucos cliques na interface do Snowsight ou com um único comando SQL. Melhor ainda: basta pedir ao Snowflake CoCo.
Com o espelhamento de dados, você tem:
Nenhuma infraestrutura adicional: os espelhos são executados na plataforma Snowflake, sem serviços ou fornecedores adicionais para gerenciar.
Leituras de dados atualizados: cada tabela espelhada inclui uma exibição $live que combina dados já aplicados com alterações em andamento. Os leitores veem as alterações confirmadas na origem em segundos.
Consistência transacional: as alterações de uma única transação de origem aparecem no destino juntas. As chaves estrangeiras são preservadas, e as junções permanecem precisas.
Histórico de alterações integrado: cada tabela recebe um feed de alterações de sete dias ($changes), que mostra inserções, atualizações e exclusões. É possível consultá-lo tanto no Snowflake quanto no Postgres.
Alta taxa de transferência ao ajustar a escala: uma estratégia otimizada de aplicação evita varreduras de tabelas completas. Assim, os custos e a performance permanecem estáveis à medida que o volume de dados aumenta.
Além disso, tudo é desenvolvido sobre uma base aberta. Nos bastidores, o espelhamento usa o pg_lake, a extensão de código aberto da Snowflake para Postgres, para capturar alterações por meio da replicação lógica padrão e gravá-las em tabelas do Apache Iceberg™. Não há uma camada proprietária entre seu banco de dados e seus dados. Você pode espelhar os dados em tabelas padrão do Snowflake para simplificar ou em tabelas Iceberg no seu próprio armazenamento para obter portabilidade total.
Por que o espelhamento de dados é diferente: envie em vez de buscar
A maioria das ferramentas de replicação insere um serviço separado entre seu banco de dados e o Snowflake. Esse serviço busca as alterações pela rede sem saber o que está acontecendo no Postgres: quando um esquema mudou, como um snapshot se alinha às alterações em andamento ou se o banco de dados está indisponível ou se o problema está apenas na rede. O espelhamento de dados inverte esse modelo.
Uma extensão do Postgres captura as alterações dentro do banco de dados e as envia, em lotes transacionais, para logs de alterações abertos do Iceberg no armazenamento de objetos. Em seguida, o Snowflake aplica esses lotes com processamento sem servidor, também de forma transacional. Como a extensão acompanha tudo o que acontece no Postgres, ela coordena snapshots, alterações de esquema e recuperação na origem para evitar conflitos nas etapas posteriores.
Funções Transactions dos dois lados fazem com que todas as tabelas espelhadas avancem juntas, exatamente no limite de uma transação do Postgres. As inserções são acrescentadas em vez de passar por upsert. Assim, as maiores tabelas, com maior volume de inserções, permanecem rápidas e econômicas à medida que crescem.
Os resultados:
Nenhum novo fornecedor para avaliar, pagar e gerenciar.
Nenhuma nova infraestrutura para implementar e monitorar.
Nenhum upsert que fique mais lento conforme suas tabelas crescem.
Sem dependência de fornecedor para seus dados de alterações, pois eles são armazenados em tabelas abertas do Apache Iceberg, e o espelhamento usa nossa extensão de código aberto pg_lake
"Com o espelhamento de dados, simplificamos a gestão dos dados e eliminamos por completo o processo de cópia. Reduzimos custos e esforço de suporte, e nossos clientes passaram a receber mais rápido e com mais confiabilidade os dados de spread de crédito necessários para precificar títulos de renda fixa."
Mike Willett
Head of Analytics Data Platform, SimCorp
O que as equipes estão desenvolvendo com o espelhamento de dados
O espelhamento de dados é útil sempre que suas cargas de trabalho analíticas ou de IA dependem de dados transacionais atualizados. Veja como as equipes já estão usando esse recurso:
Um fornecedor a menos para pagar: uma equipe de plataforma de dados que usa middleware para transferir dados do Postgres para o Snowflake pode substituir pipelines inteiras por uma única chamada CREATE_MIRROR. A Ericsson fez exatamente isso, consolidando quatro bancos de dados herdados, eliminando pipelines de sincronização e reduzindo o tempo de processamento de dados em 99%.
Dashboards que mostram o que está acontecendo agora: uma equipe de comércio eletrônico espelha sua tabela de pedidos no Snowflake. Cada compra, cancelamento e devolução aparece em segundos. O dashboard de operações reflete a receita atual, não o fechamento do dia anterior. Quando uma promoção relâmpago gera um pico de vendas, a equipe vê isso imediatamente, em vez de esperar pelo relatório do dia seguinte.
Agentes de IA que realmente sabem o que está acontecendo: Uma equipe de suporte espelha contas de clientes e históricos de pedidos no Snowflake, onde os agentes do Snowflake Cortex AI combinam essas informações com dados de produtos, status de envio e interações anteriores. Quando um cliente pergunta "Onde está meu pedido?", o agente responde com base no estado atual da empresa.
Pontuação de fraude e risco em transações em tempo real: uma empresa de serviços financeiros espelha eventos de pagamento no Snowflake e executa modelos de pontuação sobre eles em tempo real. Padrões suspeitos são sinalizados antes da liquidação do valor, não na manhã seguinte, quando uma tarefa em lote finalmente é executada.
Trilhas de auditoria que você não precisa criar: uma equipe de conformidade usa o feed $changes para responder "O que mudou e quando?" sem manter tabelas personalizadas de histórico. Cada inserção, atualização e exclusão nas tabelas espelhadas pode ser consultada durante sete dias.
“Antes, os dados das nossas aplicações e os dados de analytics ficavam em lugares diferentes. Agora está tudo no Snowflake. Os dados transacionais são espelhados no Snowflake automaticamente, então nossos clientes podem usar IA sobre eles sem nenhum trabalho extra."
Alan Buxton
Chief Technology Officer, Simfoni
Comece a usar o espelhamento de dados em minutos
O espelhamento de dados já está disponível na Amazon Web Services e no Microsoft Azure em todas as regiões onde o Snowflake Postgres funciona. Você pode começar a usar o espelhamento de dados do Postgres em três etapas:
Iniciar o Snowflake Postgres ou usar uma instância existente.
Criar um espelho com poucos cliques no Snowsight, com um único comando SQL ou pedindo ao CoCo. Escolher tabelas específicas, um esquema completo ou um banco de dados.
Consultar seus dados no Snowflake usando as tabelas de destino.
CALL SNOWFLAKE.POSTGRES.CREATE_MIRROR(
    mirror_name       => 'data_mirror',
    postgres_instance => 'my-pg',
    postgres_database => 'postgres',
    target_database   => 'MIRRORTOSNOWFLAKE',
    postgres_tables   => NULL,
    postgres_schemas  => ['public'],
    refresh_interval  => '1 minute',
    warehouse         => NULL
);
Depois, basta configurar e deixar funcionar.
Mais um item: se você está pensando em como espelhar dados da análise de dados no Snowflake de volta para o Postgres, aguarde mais novidades!
Confira estes recursos para saber mais a respeito do recurso de espelhamento de dados e o Snowflake Postgres:
Declarações prospectivas
Este artigo contém declarações prospectivas, inclusive sobre nossas futuras ofertas de produtos, e não constituem compromissos de fornecimento de quaisquer ofertas de produtos. Os resultados e os produtos reais podem diferir e estão sujeitos a riscos e incertezas conhecidos e desconhecidos. Consulte nosso documento 10-Q mais recente para obter mais informações.

