アプリケーションデータをアナリティクスデータに変換するために、複雑なパイプラインは必要ありません。本日より、その必要はなくなりました。Postgresのデータミラーリングが一般提供されました。
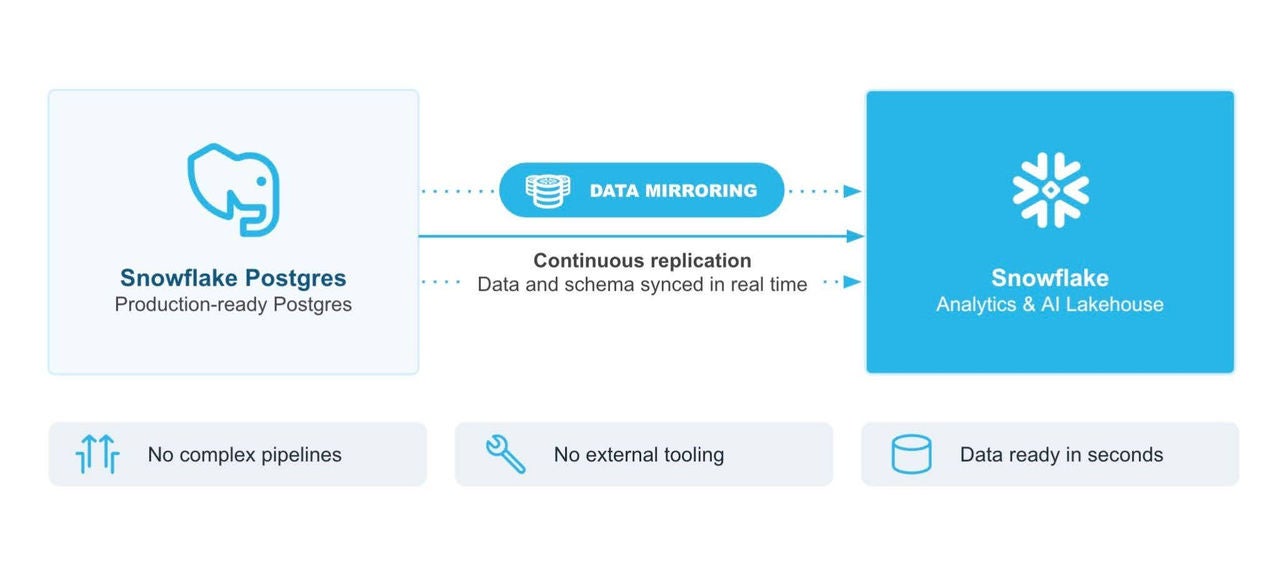
Postgresのデータミラーリングにより、PostgresのテーブルがアナリティクスやAI向けにSnowflakeへシームレスにレプリケートされます。ミラーは数秒で設定でき、すべての挿入、更新、削除が直接Snowflakeに流れます。スキーマの変更は自動的に引き継がれ、新しいテーブルも自動的に検出されます。
さらに、展開や管理が必要な外部インフラストラクチャはありません。PostgresがSnowflakeとスムーズに連携するだけです。
データミラーリングによるパイプラインの負担解消
データチームに最も苦痛な作業を尋ねると、トランザクションシステムと分析システム間のデータ移動という同じ答えが返ってきます。チームは、CDCコネクタの監視、中断するバッチジョブ、ドリフトするスナップショットへの対応に苦労しています。この問題は30年前から存在しており、私たちはその状態に慣れすぎてしまっています。
AIの時代において、適時性は重要です。データを準備し、リアルタイムでアクションを起こせる場所に配置することで、技術的負債を解消し、チームに必要なデータを遅滞なく提供して、ビジネス価値を引き出します。遅延が発生し、常に監視が必要なパイプラインは、エンジニアリングの時間を奪うだけではありません。データを現実から数時間、あるいは数日遅らせることになります。不正検知モデルは、昨晩のバッチロードでは今日の攻撃を防ぐことはできません。データミラーリングは、このギャップを解消します。
メカニズム:Postgresのデータミラーリング
データミラーリングは、Postgresデータを数秒でSnowflakeに継続的にレプリケートします。ミラーを作成すると、Snowflakeは、スキーマの変更やミラーリングされたスキーマに追加された新しいテーブルなど、ソーステーブルの現在の状態を反映するターゲットテーブルを維持します。
Snowsightインターフェイスで数回クリックするか、単一のSQLコマンドで設定できます。さらに、Snowflake CoCoに依頼することも可能です。
データミラーリングにより、以下のことが可能になります。
追加のインフラストラクチャが不要:ミラーはSnowflake内で実行されるため、追加のサービスやベンダーに対応する必要はありません。
最新の読み取り:ミラーリングされた各テーブルには、適用済みのデータと処理中の変更を組み合わせた$liveビューが含まれます。読み取り側は、コミットされたソースの変更を数秒以内に確認できます。
トランザクションの一貫性:単一のソーストランザクションからの変更は、ターゲットにまとめて表示される外部キーは保持され、結合は正確なままです。
組み込みの変更履歴:各テーブルには、挿入、更新、削除を示す7日間の変更フィード($changes)が提供されます。これは、SnowflakeとPostgresの両方からクエリ可能です。
大規模環境での高スループット:最適化された適用戦略により、テーブル全体のスキャンがスキップされるため、データが増加してもコストとパフォーマンスは安定します。
さらに、すべてがオープンな基盤上に構築されています。内部的には、ミラーリングはSnowflakeのオープンソースのPostgres拡張機能であるpg_lakeを使用して、標準の論理レプリケーションを介して変更をキャプチャし、Apache Iceberg™テーブルに書き込みます。データベースとデータの間に独自のレイヤーはありません。シンプルさを求めて標準のSnowflakeテーブルにミラーリングすることも、高い移植性を求めて独自のストレージ上のIcebergテーブルにミラーリングすることもできます。
データミラーリングが異なる理由:プルではなくプッシュ
ほとんどのレプリケーションツールは、データベースとSnowflakeの間に別のサービスを挟み込みます。そのサービスは、スキーマがいつ変更されたか、スナップショットが処理中の変更とどのように連携するか、データベースがダウンしているのかネットワークがダウンしているのかなど、Postgresの内部で何が起こっているかを知らずに、ネットワーク経由で変更をプルします。データミラーリングは、そのモデルを覆します。
Postgres拡張機能は、データベース内から変更をキャプチャし、トランザクションバッチとして、オブジェクトストレージ内のオープンなIceberg変更ログにプッシュします。その後、Snowflakeはサーバーレスコンピュートを使用して、それらのバッチをトランザクションとして適用します。拡張機能はPostgresで発生しているすべてを監視するため、ソースでスナップショット、スキーマの変更、リカバリを調整し、ダウンストリームで衝突しないようにします。
両側でのトランザクションは、ミラーリングされたすべてのテーブルが一緒に進行し、Postgresのトランザクション境界に正確に着地することを意味します。挿入はアップサートではなく追加されるため、挿入が最も多い大規模なテーブルでも、成長に合わせて高速かつコスト効率の高い状態を維持できます。
結果:
評価、支払い、管理を行う新しいベンダーが不要
展開および監視する新しいインフラストラクチャが不要
テーブルの成長に伴って速度を低下させるアップサートは不要
オープンなApache Icebergテーブルに配置され、ミラーリングはオープンソースのpg_lake拡張機能に基づいて構築されているため、変更データのロックインはなし
"データミラーリングの導入によってデータ管理が合理化され、従来のデータコピープロセスを完全に撤廃することができました。運用保守の工数とコストが削減されただけでなく、債券の価格評価(プライシング)に必要なクレジット・スプレッドデータを、クライアントへより迅速かつ確実に提供できるようになっています。"
Mike Willett
Head of Analytics Data Platform, SimCorp
データミラーリングを活用したチームの構築事例
データミラーリングは、分析やAIのワークロードが最新のトランザクションデータに依存しているあらゆる場面で役立ちます。現在、チームがこれをどのように活用しているかをご紹介します。
請求書に記載されるベンダーの削減:PostgresデータをSnowflakeに取り込むためにミドルウェアを実行しているデータプラットフォームチームは、単一のCREATE_MIRROR呼び出しでパイプライン全体を置き換えることができます。Ericssonはまさにこれを実行し、4つのレガシーデータベースを統合し、同期パイプラインを排除して、データ処理時間を99%短縮しました。
現在の状況を示すダッシュボード:Eコマースチームは、注文テーブルをSnowflakeにミラーリングしています。すべての購入、キャンセル、返品が数秒で表示されます。運用ダッシュボードには、昨日の終値ではなく、リアルタイムの収益が反映されます。フラッシュセールが急増した場合、明日のレポートではなく、すぐに確認できます。
状況を正確に把握するAIエージェント:サポートチームは、顧客アカウントと注文履歴をSnowflakeにミラーリングし、Snowflake Cortex AIエージェントがそれを製品データ、配送状況、過去のやり取りと結合します。顧客が「私の注文はどこですか?」と尋ねると、エージェントはビジネスの現在の状態に基づいて回答します。
ライブトランザクションでの不正およびリスクスコアリング:ある金融サービス企業は、支払いイベントをSnowflakeにミラーリングし、リアルタイムでスコアリングモデルを実行しています。不審なパターンは、バッチジョブが実行される翌朝ではなく、資金が決済される前にフラグが付けられます。
構築不要の監査証跡:コンプライアンスチームは、$changesフィードを使用して、カスタムの履歴テーブルを維持することなく、「いつ何が変更されたか」に回答します。ミラーリングされたテーブル全体のすべての挿入、更新、削除は、7日間クエリ可能です。
“以前は、アプリケーションデータとアナリティクスデータが別々の場所に存在していました。現在ではすべてがSnowflake上に集約されています。トランザクションデータがSnowflakeへ自動的にミラーリングされるため、クライアントは余計な手間や開発工数をかけることなく、そのデータをAIで即座に利活用できるようになりました。"
Alan Buxton
Chief Technology Officer, Simfoni
データミラーリングを数分で開始
データミラーリングは現在、Snowflake Postgresが実行されているすべてのリージョンのAWSおよびMicrosoft Azureで利用可能です。Postgresのデータミラーリングは、次の3つのステップで開始できます。
Snowflake Postgresをスピンアップするか、既存のインスタンスを使用する
Snowsightで数回クリックするか、単一のSQLコマンドを使用するか、CoCoに依頼してミラーを作成します。特定のテーブル、完全なスキーマ、またはデータベースを選択します。
ターゲットテーブルを使用してSnowflakeでデータをクエリする
CALL SNOWFLAKE.POSTGRES.CREATE_MIRROR(
    mirror_name       => 'data_mirror',
    postgres_instance => 'my-pg',
    postgres_database => 'postgres',
    target_database   => 'MIRRORTOSNOWFLAKE',
    postgres_tables   => NULL,
    postgres_schemas  => ['public'],
    refresh_interval  => '1 minute',
    warehouse         => NULL
);
あとは設定するだけです。
もう1つ:SnowflakeアナリティクスからPostgresにデータをミラーリングする方法を検討している場合は、今後の情報にご期待ください。
データミラーリングとSnowflake Postgresの詳細については、以下のリソースをご確認ください。
将来予想に関する記述
このページには、Snowflakeが将来提供する製品に関する記述を含め、将来の見通しに関する記述が含まれていますが、これはいかなる製品の提供も約束するものではありません。実際の結果や提供内容は異なる場合があり、既知および未知のリスクや不確実性の影響を受けます。詳細については、最新の四半期報告書(10-Q)をご覧ください。

