15. Okt. 2026/Lesezeit: 6 MinutenProdukt & Technologie
Data Mirroring ist allgemein verfügbar: Ihre Postgres-Daten in Snowflake, ganz ohne Pipelines
Ihre App-Daten sollten keine komplexe Pipeline benötigen, um zu Ihren Analytics-Daten zu werden. Ab heute ist das auch nicht mehr der Fall: Postgres Data Mirroring ist jetzt allgemein verfügbar.
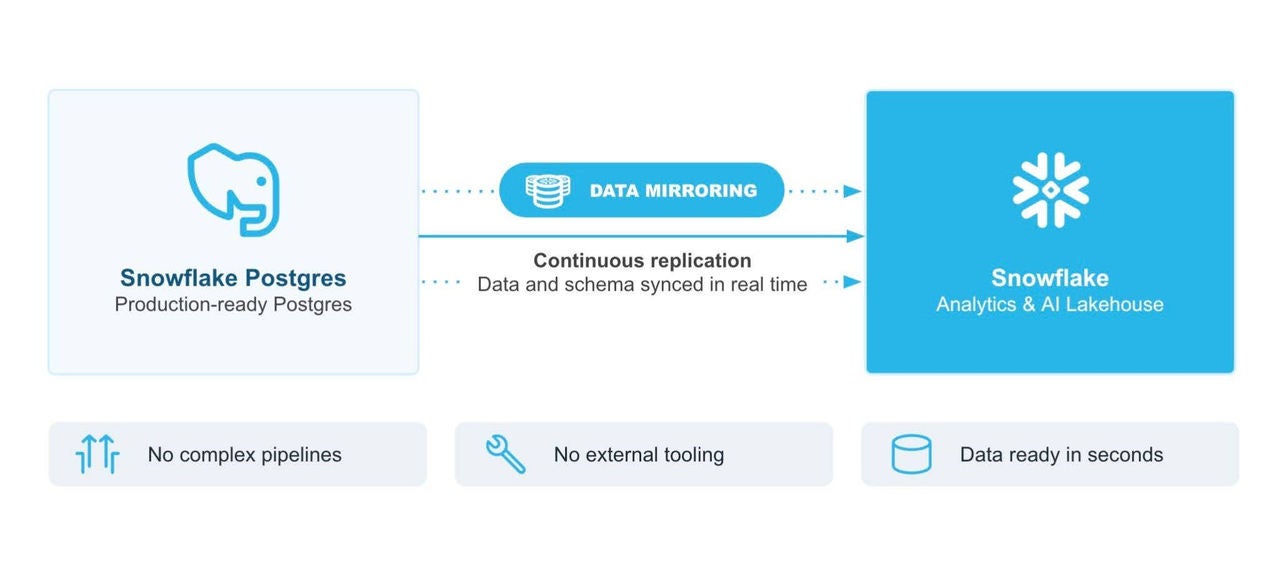
Postgres Data Mirroring repliziert Ihre Postgres-Tabellen nahtlos in Snowflake für Analytics und KI. Sie können einen Mirror in Sekundenschnelle einrichten, und jedes Insert, Update und Delete fließt direkt in Snowflake. Schemaänderungen werden automatisch übernommen, und neue Tabellen werden automatisch erfasst.
Das Beste daran ist, dass keine externe Infrastruktur bereitgestellt oder verwaltet werden muss. Es ist einfach Postgres, das reibungslos mit Snowflake zusammenarbeitet.
Data Mirroring eliminiert die Pipeline-Steuer
Fragen Sie ein beliebiges Datenteam nach seiner mühsamsten Aufgabe, und Sie werden dieselbe Antwort hören: das Verschieben von Daten zwischen transaktionalen und analytischen Systemen. Teams kämpfen mit der Überwachung von CDC-Konnektoren, Batch-Jobs, die abbrechen, und Snapshots, die abweichen. Dieses Problem besteht seit 30 Jahren, und wir haben uns zu sehr daran gewöhnt, dass es so ist.
Aktualität ist im Zeitalter der KI wichtig. Wenn Ihre Daten bereitstehen und sich an einem Ort befinden, an dem Sie in Echtzeit darauf reagieren können, erschließen Sie Business Value, indem Sie sowohl technische Schulden abbauen als auch Teams die benötigten Daten ohne Verzögerung zur Verfügung stellen. Pipelines, die hinterherhinken und ständige Überwachung erfordern, kosten nicht nur Entwicklungszeit. Sie lassen Ihre Daten Stunden oder Tage hinter der Realität zurückbleiben. Ein Betrugsmodell kann den heutigen Angriff nicht mit dem Batch-Load von letzter Nacht stoppen. Data Mirroring lässt diese Lücke verschwinden.
So funktioniert es: Postgres Data Mirroring
Data Mirroring repliziert Ihre Postgres-Daten kontinuierlich in Sekundenschnelle in Snowflake. Sobald Sie einen Mirror erstellen, pflegt Snowflake Zieltabellen, die den aktuellen Status ihrer Quelltabellen widerspiegeln, einschließlich Schemaänderungen und neuer Tabellen, die Sie zu gespiegelten Schemata hinzufügen.
Richten Sie es mit wenigen Klicks in der Snowsight-Oberfläche oder mit einem einzigen SQL-Befehl ein – oder noch besser, fragen Sie einfach Snowflake CoCo.
Mit Data Mirroring erhalten Sie:
Keine zusätzliche Infrastruktur: Mirrors laufen innerhalb von Snowflake, sodass keine zusätzlichen Dienste oder Anbieter verwaltet werden müssen.
Frische Reads: Jede gespiegelte Tabelle enthält eine $live-Ansicht, die bereits angewendete Daten mit laufenden Änderungen kombiniert. Leser sehen festgeschriebene Quelländerungen innerhalb von Sekunden.
Transaktionale Konsistenz: Änderungen aus einer einzelnen Quelltransaktion erscheinen gemeinsam auf dem Ziel. Fremdschlüssel bleiben erhalten, und Joins bleiben korrekt.
Integrierter Änderungsverlauf: Jede Tabelle erhält einen siebentägigen Änderungs-Feed ($changes), der Inserts, Updates und Deletes anzeigt. Dieser kann sowohl von Snowflake als auch von Postgres abgefragt werden.
Hoher Durchsatz bei Skalierung: Eine optimierte Apply-Strategie überspringt vollständige Tabellenscans, sodass Kosten und Performance stabil bleiben, während Ihre Daten wachsen.
Außerdem basiert alles auf einem offenen Fundament. Unter der Haube verwendet Mirroring pg_lake, die Open Source-Postgres-Erweiterung von Snowflake, um Änderungen über standardmäßige logische Replikation zu erfassen und in Apache Iceberg™-Tabellen zu schreiben. Es gibt keine proprietäre Schicht zwischen Ihrer Datenbank und Ihren Daten. Sie können der Einfachheit halber in Standard-Snowflake-Tabellen oder für volle Portabilität in Iceberg-Tabellen auf Ihrem eigenen Speicher spiegeln.
Warum Data Mirroring anders ist: Push, nicht Pull
Die meisten Replikationstools schieben einen separaten Dienst zwischen Ihre Datenbank und Snowflake. Dieser Dienst zieht Änderungen über das Netzwerk, ohne zu wissen, was in Postgres passiert: wann sich ein Schema geändert hat, wie ein Snapshot mit laufenden Änderungen übereinstimmt oder ob die Datenbank ausgefallen ist oder nur das Netzwerk. Data Mirroring dreht dieses Modell um.
Eine Postgres-Erweiterung erfasst Änderungen aus dem Inneren der Datenbank und pusht sie in transaktionalen Batches in offene Iceberg-Änderungsprotokolle im Objektspeicher. Snowflake wendet diese Batches dann mit serverloser Rechenressource an, ebenfalls transaktional. Da die Erweiterung alles sieht, was in Postgres passiert, koordiniert sie Snapshots, Schemaänderungen und Wiederherstellung an der Quelle, sodass sie nachgelagert nicht kollidieren.
Transaktionen auf beiden Seiten bedeuten, dass sich jede gespiegelte Tabelle gemeinsam vorwärts bewegt und genau an einer Postgres-Transaktionsgrenze landet. Inserts werden angehängt statt per Upsert eingefügt, sodass die größten, am stärksten von Inserts geprägten Tabellen schnell und kosteneffizient bleiben, während sie wachsen.
Die Ergebnisse:
Keine neuen Anbieter, die evaluiert, bezahlt und verwaltet werden müssen
Keine neue Infrastruktur, die bereitgestellt und überwacht werden muss
Keine Upserts, die verlangsamen, während Ihre Tabellen wachsen
Kein Lock-in bei Ihren Änderungsdaten, da sie in offenen Apache Iceberg-Tabellen landen und Mirroring auf unserer Open Source-Erweiterung pg_lake basiert
"Data mirroring has streamlined how we manage data, letting us remove our data copy process entirely. Support effort and costs are down, and our clients now get the credit spread data they need for bond pricing faster and more reliably."
Mike Willett
Head of Analytics Data Platform, SimCorp
Was Teams mit Data Mirroring entwickeln
Data Mirroring ist überall dort nützlich, wo Ihre analytischen oder KI-Workloads von frischen transaktionalen Daten abhängen. Hier ist, was Teams heute damit machen:
Ein Anbieter weniger auf der Rechnung: Ein Datenplattform-Team, das Middleware ausführt, um Postgres-Daten in Snowflake zu übertragen, kann ganze Pipelines durch einen einzigen CREATE_MIRROR-Aufruf ersetzen. Ericsson hat genau das getan, vier Altlast-Datenbanken konsolidiert, Sync-Pipelines eliminiert und die Datenverarbeitungszeit um 99 % reduziert.
Dashboards, die zeigen, was jetzt passiert: Ein E-Commerce-Team spiegelt seine Bestelltabelle in Snowflake. Jeder Kauf, jede Stornierung und jede Rücksendung wird in Sekundenschnelle angezeigt. Ihr Ops-Dashboard spiegelt den Live-Umsatz wider, nicht den gestrigen Abschluss. Wenn ein Flash-Sale ansteigt, sehen sie es sofort und nicht erst im morgigen Bericht.
KI-Agenten, die tatsächlich wissen, was los ist: Ein Support-Team spiegelt Kundenkonten und Bestellhistorie in Snowflake, wo Snowflake Cortex AI-Agenten sie mit Produktdaten, Versandstatus und vergangenen Interaktionen verknüpfen. Wenn ein Kunde fragt: „Wo ist meine Bestellung?“, antwortet der Agent aus dem aktuellen Status des Unternehmens.
Betrugs- und Risikobewertung bei Live-Transaktionen: Ein Unternehmen für Finanzdienstleistungen spiegelt Zahlungsereignisse in Snowflake und führt in Echtzeit Scoring-Modelle dagegen aus. Verdächtige Muster werden markiert, bevor das Geld abgewickelt wird, und nicht erst am nächsten Morgen, wenn endlich ein Batch-Job ausgeführt wird.
Audit-Trails, die Sie nicht erstellen müssen: Ein Compliance-Team verwendet den $changes-Feed, um die Frage „Was hat sich wann geändert?“ zu beantworten, ohne benutzerdefinierte Verlaufstabellen zu pflegen. Jedes Insert, Update und Delete über gespiegelte Tabellen hinweg kann sieben Tage lang abgefragt werden.
“Before, our application data and our analytics data lived in two different places. Now it's all in Snowflake. Transactional data mirrors to Snowflake automatically, so our customers can leverage AI over it without extra work."
Alan Buxton
Chief Technology Officer, Simfoni
Starten Sie in wenigen Minuten mit Data Mirroring
Data Mirroring ist heute auf AWS und Microsoft Azure in jeder Region verfügbar, in der Snowflake Postgres ausgeführt wird. Sie können Postgres Data Mirroring in drei Schritten nutzen:
Starten Sie Snowflake Postgres oder verwenden Sie eine Instanz, die Sie bereits haben.
Erstellen Sie einen Mirror mit wenigen Klicks in Snowsight, mit einem einzigen SQL-Befehl oder indem Sie CoCo fragen. Wählen Sie bestimmte Tabellen, ein vollständiges Schema oder eine Datenbank aus.
Fragen Sie Ihre Daten in Snowflake mithilfe der Zieltabellen ab.
CALL SNOWFLAKE.POSTGRES.CREATE_MIRROR(
    mirror_name       => 'data_mirror',
    postgres_instance => 'my-pg',
    postgres_database => 'postgres',
    target_database   => 'MIRRORTOSNOWFLAKE',
    postgres_tables   => NULL,
    postgres_schemas  => ['public'],
    refresh_interval  => '1 minute',
    warehouse         => NULL
);
Dann richten Sie es ein und vergessen es.
Noch etwas: Wenn Sie darüber nachdenken, wie Sie Daten von Snowflake Analytics zurück zu Postgres spiegeln, bleiben Sie dran!
Sehen Sie sich diese Ressourcen an, um mehr über Data Mirroring und Snowflake Postgres zu erfahren:
Zukunftsgerichtete Aussagen
Dieser Artikel enthält zukunftsgerichtete Aussagen, unter anderem über künftige Produktangebote. Diese Aussagen stellen keine Garantie dar, dass diese Angebote wirklich bereitgestellt werden. Die tatsächlichen Ergebnisse und Angebote können abweichen und unterliegen bekannten und unbekannten Risiken und Unsicherheiten. Weitere Informationen finden Sie in unserem jüngsten 10-Q-Formular.

