15 ottobre 2026/Lettura: 6 minProdotto e tecnologia
Data mirroring in GA: Postgres in Snowflake senza pipeline
I dati della tua app non dovrebbero richiedere una pipeline complessa per diventare dati analitici. Da oggi, non ne ha più bisogno: Il data mirroring per Postgres è ora in GA.
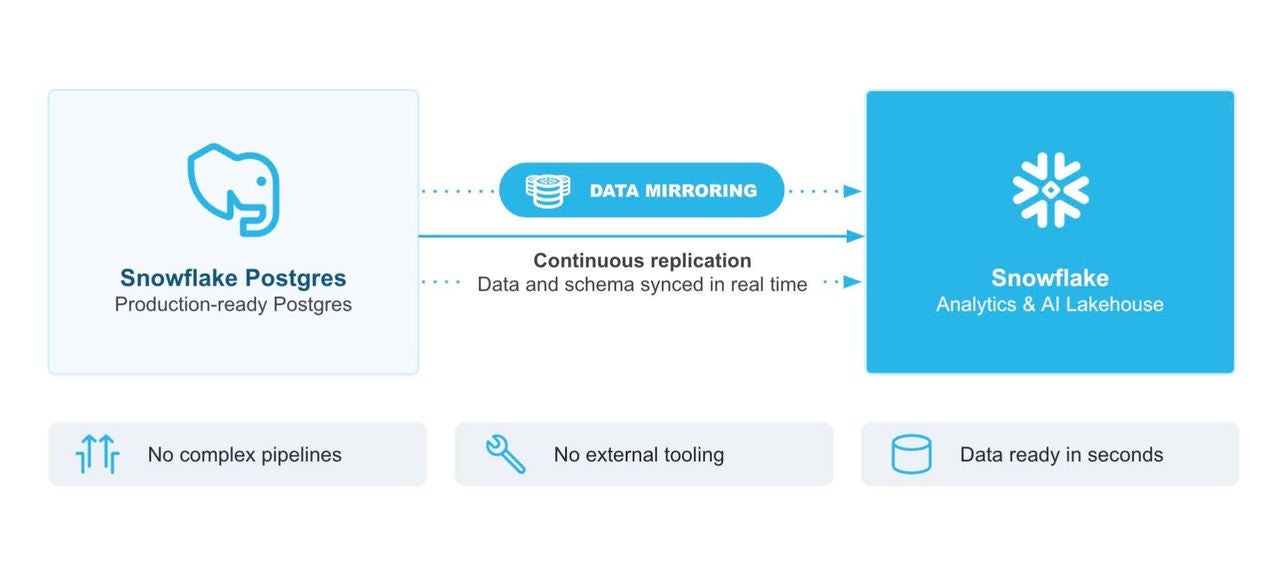
Il data mirroring per Postgres replica senza problemi le tue tabelle Postgres in Snowflake per l’analisi dei dati e l’AI. Puoi configurare un mirror in pochi secondi, e ogni inserimento, aggiornamento ed eliminazione fluisce direttamente in Snowflake. Le modifiche allo schema sono propagate automaticamente e le nuove tabelle sono rilevate in automatico.
Ancora meglio, non è necessaria alcuna infrastruttura esterna da implementare o gestire. È semplicemente Postgres che funziona perfettamente con Snowflake.
Il data mirroring elimina l’overhead delle pipeline
Chiedi a un team dati qualsiasi quale sia il processo più doloroso, e sentirai sempre la stessa risposta: spostare i dati tra sistemi transazionali e sistemi di analisi. I team sono costretti a fare da babysitter ai connettori CDC, a gestire processi batch che si bloccano e snapshot che perdono sincronizzazione. Questo problema esiste da 30 anni, e ci siamo assuefatti al punto da considerarlo normale.
La tempestività conta nell’era dell’AI. Avere i dati pronti e disponibili in un luogo dove puoi agire su di essi in tempo reale genera valore per il business, sia eliminando il debito tecnico sia fornendo ai team i dati di cui hanno bisogno senza ritardi. Le pipeline che rimangono indietro e richiedono una supervisione costante non costano solo tempo agli ingegneri. Lasciano i tuoi dati indietro di ore o giorni rispetto alla realtà. Un modello antifrode non può bloccare l’attacco di oggi con il caricamento batch di ieri notte. Il data mirroring fa sparire questo gap.
Data mirroring per Postgres: come funziona
Il data mirroring replica continuamente i tuoi dati Postgres in Snowflake in pochi secondi. Una volta creato un mirror, Snowflake mantiene tabelle di destinazione che riflettono lo stato attuale delle tabelle di origine, incluse le modifiche allo schema e le nuove tabelle aggiunte agli schemi mirrorati.
Configuralo in pochi clic nell’interfaccia Snowsight o con un singolo comando SQL, oppure, meglio ancora, chiedi semplicemente a Snowflake CoCo.
Con il data mirroring, ottieni:
Nessuna infrastruttura aggiuntiva: i mirror vengono eseguiti all’interno di Snowflake, quindi non ci sono servizi o fornitori aggiuntivi da gestire.
Letture aggiornate: ogni tabella in mirroring include una vista $live che combina i dati già applicati con le modifiche ancora in corso di applicazione. I lettori vedono le modifiche di origine confermate nel giro di pochi secondi.
Coerenza transazionale: Le modifiche provenienti da una singola transazione di origine compaiono insieme nella destinazione. Le chiavi esterne restano valide, e i join rimangono accurati.
Cronologia delle modifiche integrata: Ogni tabella riceve un feed delle modifiche di sette giorni ($changes) che mostra inserimenti, aggiornamenti ed eliminazioni. È interrogabile sia da Snowflake che da Postgres.
Throughput elevato su larga scala: Una strategia di applicazione ottimizzata evita le scansioni complete delle tabelle, così costi e prestazioni restano stabili man mano che i dati crescono.
Inoltre, è tutto costruito su una data foundation open. Dietro le quinte, il mirroring utilizza pg_lake, l’estensione Postgres open source Snowflake, per acquisire le modifiche tramite replica logica standard e scriverle in tabelle Apache Iceberg™. Non c’è nessun livello proprietario tra il tuo database e i tuoi dati. Puoi eseguire il mirroring su tabelle Snowflake standard per semplicità, oppure su Iceberg Tables nel tuo storage personale per la massima portabilità.
Perché il data mirroring è diverso: push, non pull
La maggior parte degli strumenti di replica inserisce un servizio separato tra il tuo database e Snowflake. Quel servizio estrae le modifiche tramite la rete senza sapere cosa sta succedendo dentro Postgres: quando è cambiato uno schema, come uno snapshot si allinea con le modifiche in corso, o se è il database a essere inattivo oppure solo la rete. Il data mirroring ribalta questo modello.
Un’estensione Postgres acquisisce le modifiche dall’interno del database e le invia, in batch transazionali, in change log Iceberg open nell’object storage. Snowflake applica quindi questi batch con capacità di calcolo serverless, anche in modo transazionale. Poiché l’estensione vede tutto ciò che accade in Postgres, coordina snapshot, modifiche allo schema e recovery direttamente all’origine, in modo che non entrino in conflitto a valle.
Le transazioni su entrambi i lati fanno in modo che ogni tabella in mirroring avanzi insieme, allineandosi esattamente a un confine di transazione di Postgres. Gli inserimenti vengono accodati piuttosto che sottoposti a upsert, quindi le tabelle più grandi e con il maggior numero di inserimenti restano rapide ed economiche man mano che crescono.
I risultati:
Nessun nuovo fornitore da valutare, pagare e gestire
Nessuna nuova infrastruttura da implementare e monitorare
Nessun upsert che rallenta man mano che le tabelle crescono
Nessun lock-in sui tuoi dati di modifica, poiché finiscono in tabelle Apache Iceberg open, e il mirroring è costruito sulla nostra estensione open source pg_lake
“Il mirroring dei dati ha semplificato la gestione dei dati, permettendoci di eliminare completamente il processo di copia. L’impegno e i costi di supporto sono diminuiti, e ora i nostri clienti ricevono i dati sugli spread creditizi di cui hanno bisogno per il pricing delle obbligazioni in modo più rapido e affidabile.”
Mike Willett
Head of Analytics Data Platform, SimCorp
Cosa costruiscono i team con il data mirroring
Il data mirroring è utile ovunque i tuoi carichi di lavoro analitici o di AI dipendano da dati transazionali aggiornati. Ecco cosa stanno facendo i team con questa tecnologia oggi:
Un fornitore in meno in fattura: un team della piattaforma dati che utilizza middleware per trasferire i dati Postgres in Snowflake può sostituire intere pipeline con una singola chiamata CREATE_MIRROR. Ericsson ha fatto esattamente questo, consolidando quattro database legacy, eliminando le pipeline di sincronizzazione e riducendo i tempi di elaborazione dei dati del 99%.
Dashboard che mostrano cosa sta succedendo in questo momento: un team ecommerce esegue il mirroring della propria tabella degli ordini verso Snowflake. Ogni acquisto, annullamento e reso compare nel giro di pochi secondi. La loro dashboard operativa riflette i ricavi live, non la chiusura di ieri. Quando una flash sale ha un picco, lo vedono immediatamente, invece che nel report di domani.
Agenti AI che sanno davvero cosa sta succedendo: un team di supporto esegue il mirroring degli account clienti e dello storico ordini in Snowflake, dove gli agenti AI Snowflake Cortex uniscono questi dati con i dati di prodotto, lo stato delle spedizioni e le interazioni passate. Quando un cliente chiede “Dov’è il mio ordine?”, l’agente AI risponde in base allo stato attuale del business.
Scoring antifrode e di rischio su transazioni live: un’azienda di servizi finanziari esegue il mirroring degli eventi di pagamento in Snowflake ed esegue modelli di scoring su di essi in tempo reale. I pattern sospetti sono segnalati prima che il denaro venga liquidato, non la mattina dopo, quando finalmente viene eseguito un processo batch.
Audit trail che non devi sviluppare: un team di compliance utilizza il feed $changes per rispondere alla domanda “Cosa è cambiato e quando?” senza dover mantenere tabelle di cronologia personalizzate. Ogni inserimento, aggiornamento ed eliminazione nelle tabelle mirrorate è interrogabile per sette giorni.
“Prima i dati delle applicazioni e quelli per l’analisi si trovavano in due posti diversi. Ora è tutto in Snowflake. I dati transazionali vengono replicati automaticamente in Snowflake, così i nostri clienti possono usarli con l’AI senza lavoro aggiuntivo.”
Alan Buxton
Chief Technology Officer, Simfoni
Inizia a usare il data mirroring in pochi minuti
Il data mirroring è disponibile oggi su AWS e Microsoft Azure in ogni regione dove è attivo Snowflake Postgres. Puoi iniziare a usare il data mirroring per Postgres in tre passaggi:
Avvia Snowflake Postgres, oppure utilizza un’istanza che hai già.
Crea un mirror con pochi clic in Snowsight, con un singolo comando SQL oppure chiedendo a CoCo. Scegli tabelle specifiche, uno schema completo o un intero database.
Esegui query sui tuoi dati in Snowflake utilizzando le tabelle di destinazione.
CALL SNOWFLAKE.POSTGRES.CREATE_MIRROR(
    mirror_name       => 'data_mirror',
    postgres_instance => 'my-pg',
    postgres_database => 'postgres',
    target_database   => 'MIRRORTOSNOWFLAKE',
    postgres_tables   => NULL,
    postgres_schemas  => ['public'],
    refresh_interval  => '1 minute',
    warehouse         => NULL
);
Poi impostalo e non pensarci più.
Un’ultima cosa: se ti stai chiedendo come eseguire il mirroring dei dati dall’analisi dei dati Snowflake verso Postgres, continua a seguire il nostro blog.
Consulta queste risorse per saperne di più sul data mirroring e su Snowflake Postgres:
Dichiarazioni previsionali
Questo articolo contiene dichiarazioni previsionali, anche sulle nostre future offerte di prodotti, che non costituiscono impegni a fornire alcuna offerta di prodotti. Le offerte e i risultati effettivi potrebbero essere diversi ed essere soggetti a incertezze e rischi noti e non noti. Fai riferimento al nostro più recente modulo 10‑Q per ulteriori informazioni.

