19 oct. 2026/Lecture : 5 minData engineering
La voie vers le data engineering autonome : réparer les défaillances des pipelines de données grâce à l’IA
Pendant des années, les défaillances de pipelines chez Snowflake ont suivi le même script : Une personne recevait une alerte. Elle épluchait les logs, identifiait la cause racine, écrivait un correctif, le testait et ouvrait une pull request (PR). Puis elle recommençait la nuit suivante.
Aujourd’hui, un agent exécute ce script à notre place. Il analyse chaque défaillance de pipeline surveillé et passe de la détection de l’incident à une PR prête à être examinée en moins de 16 minutes en moyenne. Voici comment nous l’avons créé et ce qu’il a changé pour notre équipe.
Un problème qui ne cessait de s’aggraver
Je suis data scientist au sein de l’équipe data interne de Snowflake. J’ai vu notre nombre de pipelines passer d’un volume qu’une seule personne pouvait maîtriser à une complexité réellement vertigineuse.
À première vue, multiplier les pipelines semble être un problème enviable : plus de données, plus de valeur. Mais chaque nouveau pipeline est un nouveau point de défaillance potentiel, et chaque nouvelle dépendance peut casser à 2 h du matin. Le nombre de défaillances n’augmentait pas parce que nos pipelines se dégradaient. Il augmentait parce qu’ils étaient plus nombreux, tandis que notre équipe ne grandissait pas au même rythme.
Ce que nous voulions vraiment créer
La plupart des outils s’arrêtent à l’alerte : Quelque chose ne fonctionne plus. Allez voir. Nous voulions un agent capable d’expliquer le problème et d’aider à le résoudre. Il devait donc prendre en charge l’intégralité du cycle :
- Analyser les pipelines en continu afin de détecter les mauvaises pratiques de code et les problèmes de performance.
- Détecter les défaillances de façon proactive, avant qu’elles ne s’aggravent.
- Examiner en profondeur les logs et la base de code pour identifier la cause racine réelle la plus probable.
- Tester les correctifs proposés avant toute mise en production.
- Ouvrir une PR propre, avec tout le contexte nécessaire, afin qu’une personne puisse rapidement l’examiner et la fusionner.
Cette dernière exigence est la plus importante. L’agent propose le correctif. Une personne décide toujours de ce qui sera mis en production.
Comment nous l’avons créé
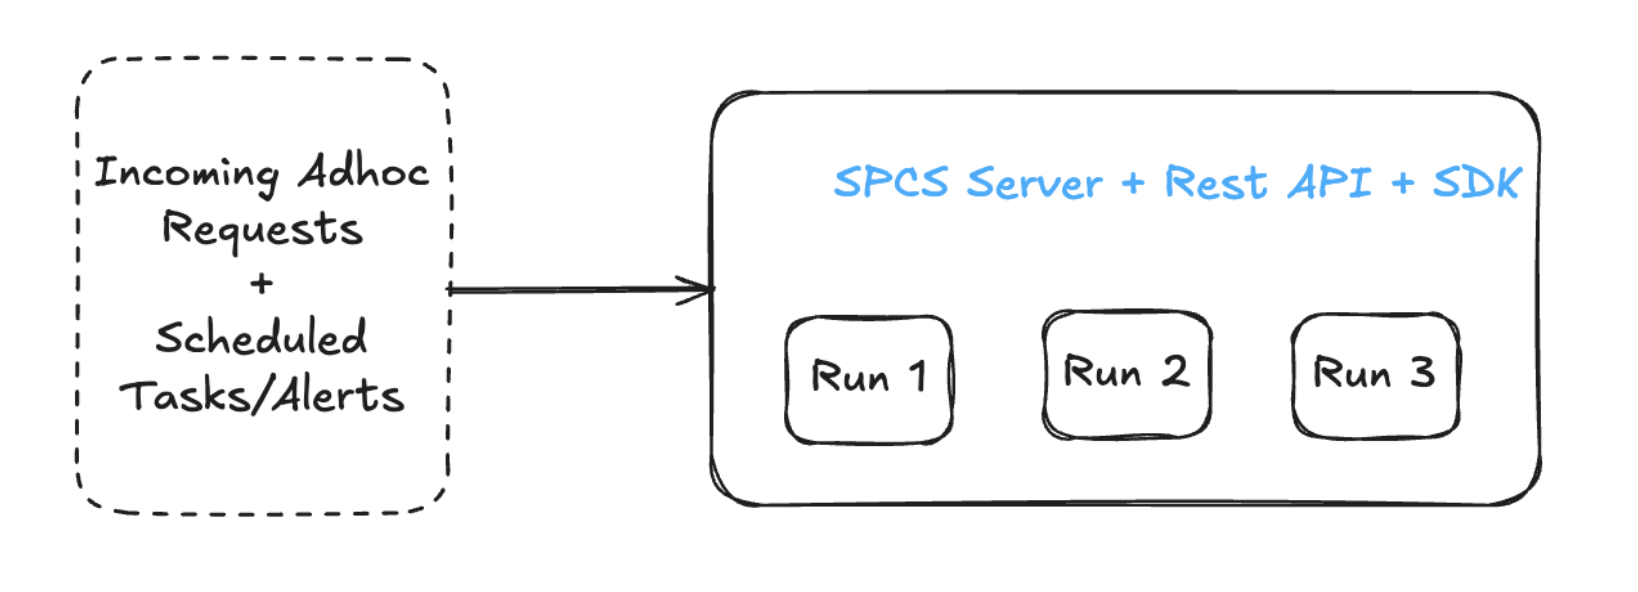
Nous avons étudié plusieurs architectures avant de trouver la bonne. Notre première idée était d’utiliser un serveur Snowpark Container Services exécutant une API REST : une solution autonome, avec tous les composants réunis au même endroit. Mais le nombre d’exécutions qu’un seul serveur pouvait prendre en charge aurait limité le système.
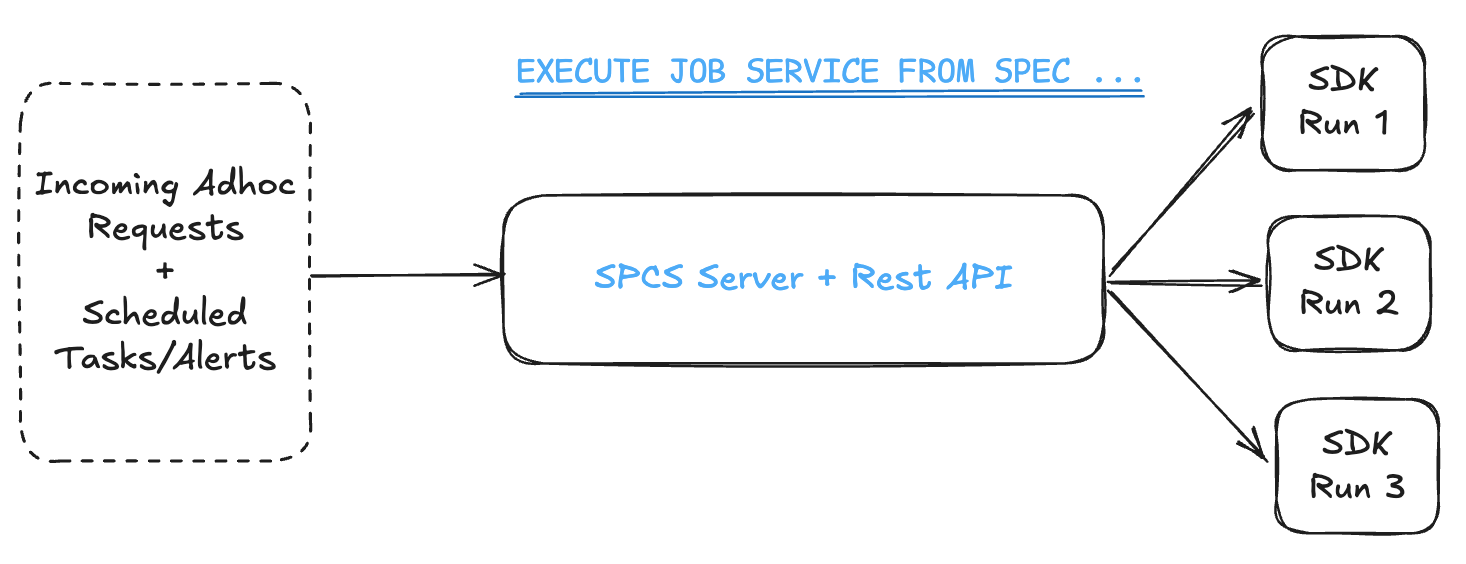
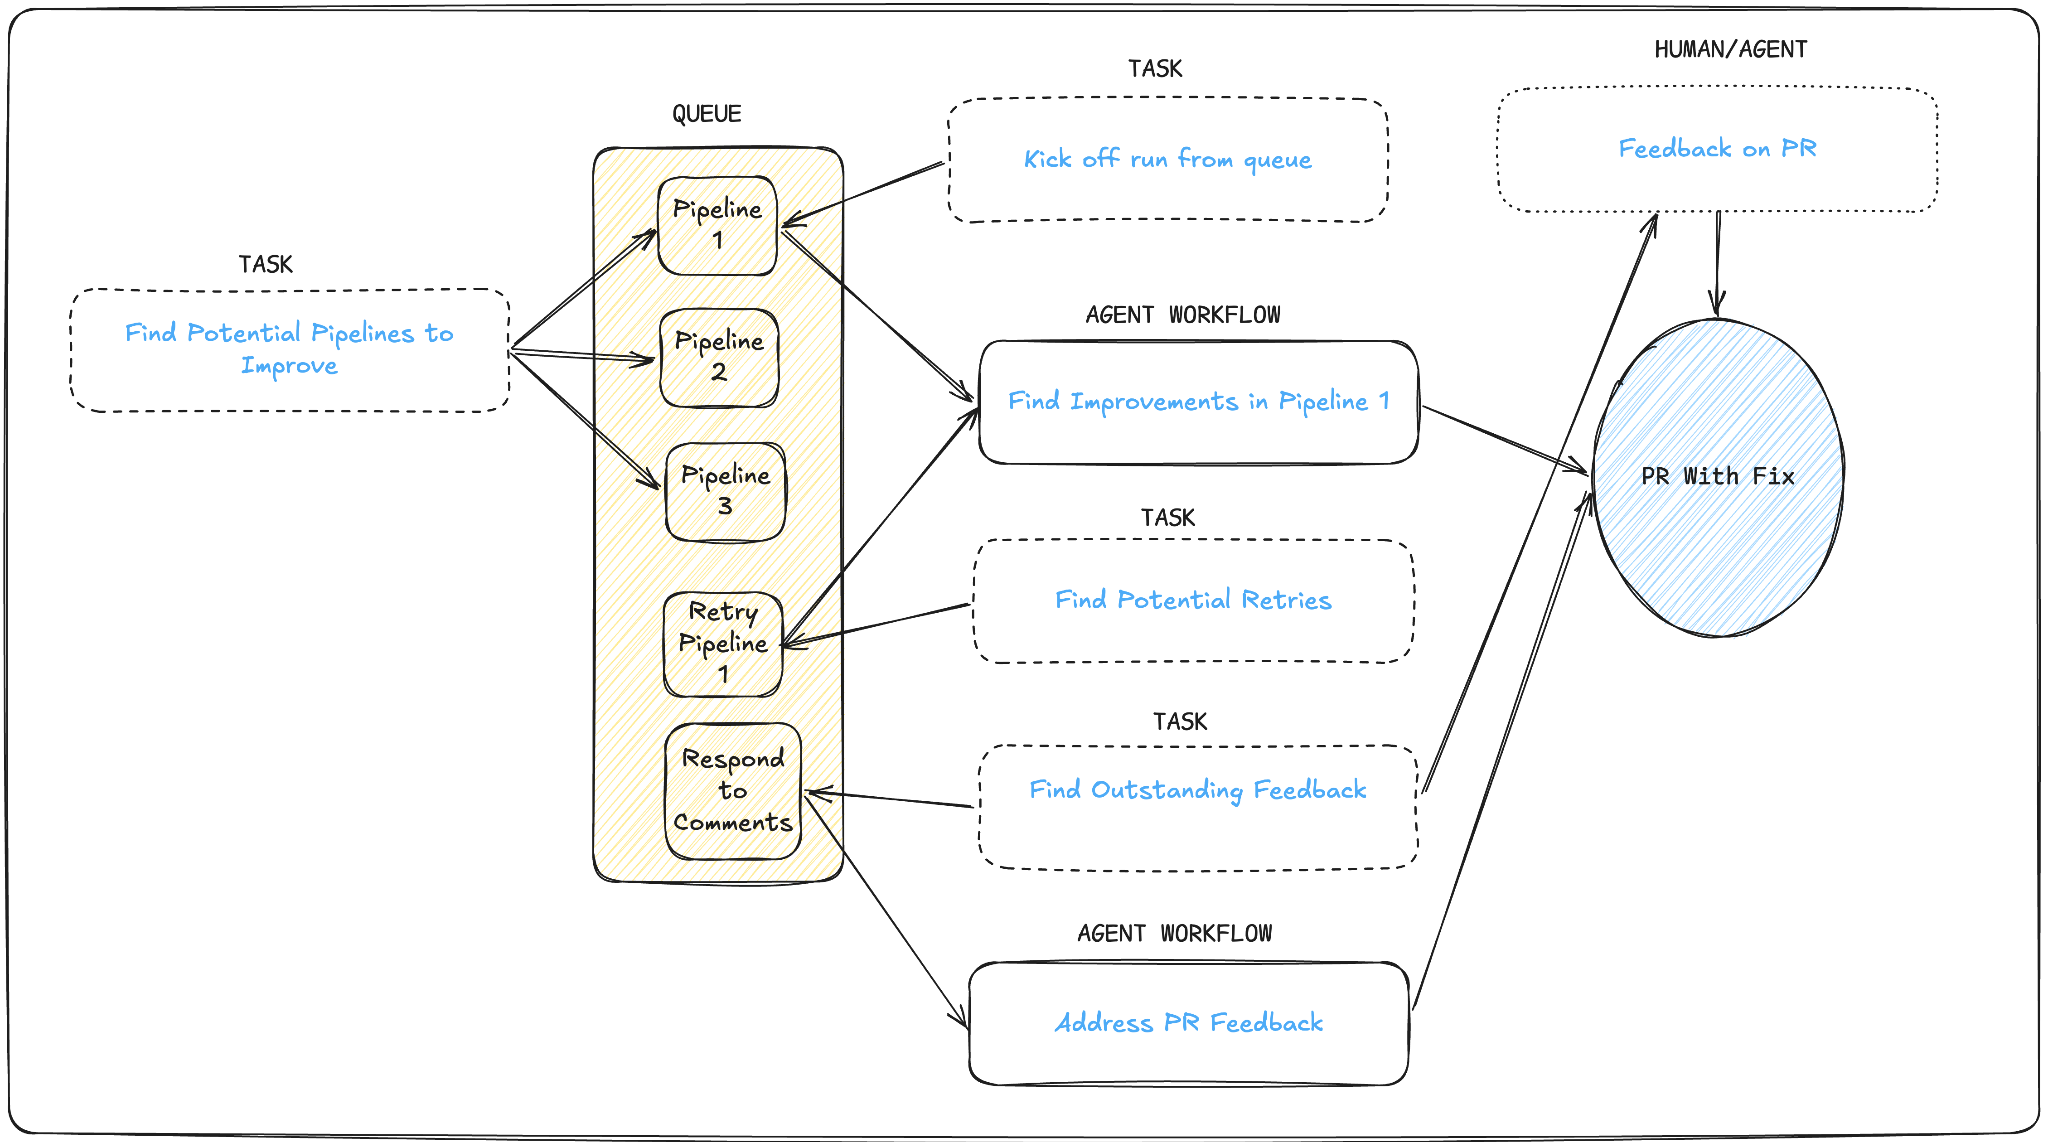
Cette approche nous a permis d’augmenter le nombre d’agents exécutés en parallèle, sans qu’un serveur unique ne crée de goulot d’étranglement.
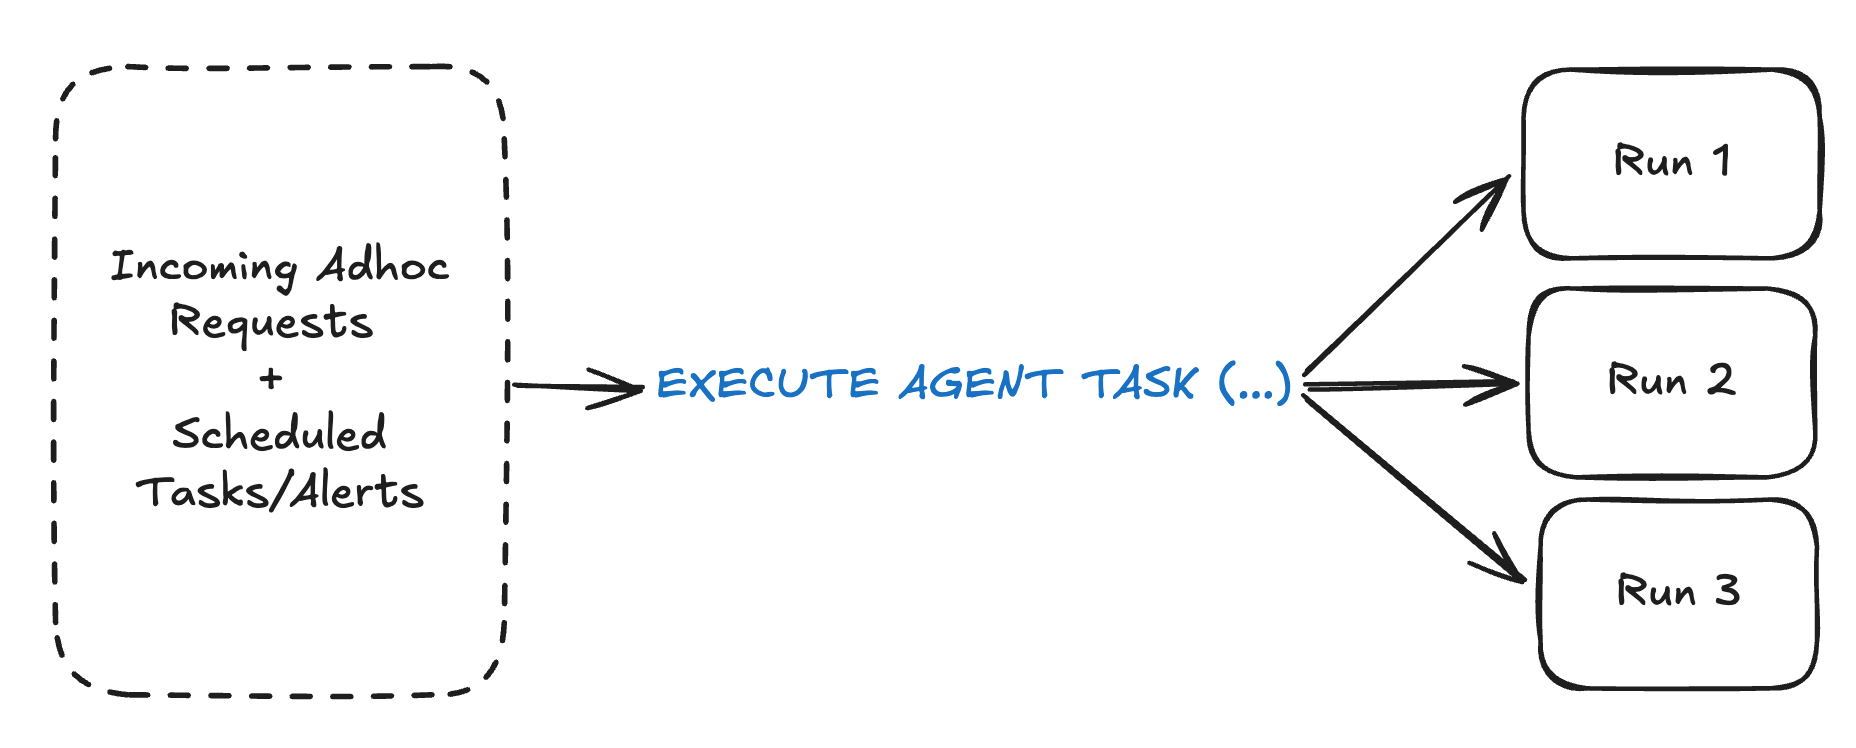
À terme, nous prévoyons d’aller plus loin en utilisant la nouvelle commande EXECUTE AGENT TASK des automatisations CoCo, actuellement en public preview, afin de simplifier nos exécutions et de les faire évoluer davantage.
Aucun serveur à gérer. Aucun pool de calcul partagé. Un seul appel SQL déclenche l’exécution d’un agent. Snowflake s’occupe du reste.
Nous avions besoin d’un moyen flexible de définir un workflow à partir d’instructions modélisées. Les workflows sont donc définis en JSON. Vous indiquez le fichier d’instructions, les dépôts auxquels l’agent peut accéder, un budget d’itérations, le modèle à exécuter et la destination des notifications une fois le travail terminé.
{
  "name": "fix-broken-pipeline",
  "owner": "your.name@snowflake.com",
  "agent": {
    "turns": [{"file": "org/repo:path/to/instructions.md"}],
    "model": "opus",
    "max_turns": 50
  },
  "repos": [{"repo": "org/repo", "branch": "main"}],
  "timeout_minutes": 30,
  "notifications": {
    "slack_channel": "#data-eng-alerts",
    "emails": ["your.name@snowflake.com"]
  }
}
Pour lancer l’exécution, il suffit d’une commande SQL :
CALL RUN_WORKFLOW('fix-broken-pipeline', '{"pipeline_id": "12345"}')

CREATE TASK SCHEDULE = '12 hours' AS
  CALL RUN_WORKFLOW('code-smells')
La tâche gère la planification. L’agent se charge du travail. Ces workflows peuvent être très simples. Nous pouvons aussi combiner plusieurs workflows simples et les retours humains pour créer des workflows plus complexes.
L’impact : des analyses approfondies des défaillances
Nous utilisons cette solution en production et, au cours des cinq derniers mois, sur les pipelines gérés par notre équipe, nous avons constaté :
- Une couverture presque complète du triage des défaillances de pipelines surveillés. Une solution conçue pour analyser chaque défaillance, pas seulement les plus visibles.
- Moins de 16 minutes entre la détection de l’incident et la création de la PR.
- Des centaines de PR fusionnées.
- Plus de 500 pipelines améliorés.
- Les améliorations apportées aux pipelines permettent d’économiser chaque jour des centaines de crédits auparavant gaspillés.
Ce dernier chiffre est particulièrement important. Le gaspillage de ressources de calcul lié aux pipelines peu performants s’accumule sans qu’on le remarque. La plupart des équipes ne le détectent jamais, car une personne doit le rechercher de manière proactive. Nos agents, eux, le font en permanence.
Le data engineering autonome
Ces travaux inspirent directement les solutions que notre équipe produit proposera à nos clients. Découvrez notre vision du data engineering autonome ici.
Déclarations prévisionnelles
cet article contient des déclarations prévisionnelles, notamment concernant nos futures offres de produits. Il ne constitue en aucun cas un engagement à fournir des offres de produits. Les résultats et les offres peuvent différer des prévisions et sont soumis à des risques et incertitudes connus ou inconnus. Découvrez notre dernier 10‑Q pour en savoir plus.
