19. Okt. 2026/Lesezeit: 5 MinutenData Engineering
Der Weg zum autonomen Data Engineering: Behebung von Daten-Pipeline-Ausfällen mit KI
Jahrelang folgte ein Pipeline-Ausfall bei Snowflake dem gleichen Skript: Jemand wurde angepingt. Diese Person durchsuchte Protokolle, ermittelte die Grundursache, schrieb einen Fix, testete ihn und öffnete einen Pull Request (PR). Und in der nächsten Nacht passierte das Ganze von vorn.
Heute führt ein Agent dieses Skript für uns aus. Er untersucht jeden überwachten Pipeline-Ausfall und benötigt von der Vorfallerkennung bis zu einem überprüfungsbereiten PR durchschnittlich weniger als 16 Minuten. Hier erfahren Sie, wie wir ihn entwickelt haben und was sich dadurch für unser Team geändert hat.
Das Problem, das immer schlimmer wurde
Ich bin Data Scientist im internen Datenteam von Snowflake und habe miterlebt, wie unsere Pipeline-Anzahl von einer überschaubaren Menge zu etwas wirklich Überwältigendem angewachsen ist.
Mehr Pipelines klingen nach einem guten Problem: mehr Daten, mehr Wert. Aber jede neue Pipeline ist eine neue Fehlerquelle, und jede neue Abhängigkeit ist eine weitere Sache, die nachts um 2 Uhr kaputtgehen kann. Unser Ausfallvolumen stieg nicht, weil unsere Pipelines schlechter wurden. Es stieg, weil wir mehr davon hatten und unser Team nicht im gleichen Tempo wuchs.
Was wir eigentlich entwickeln wollten
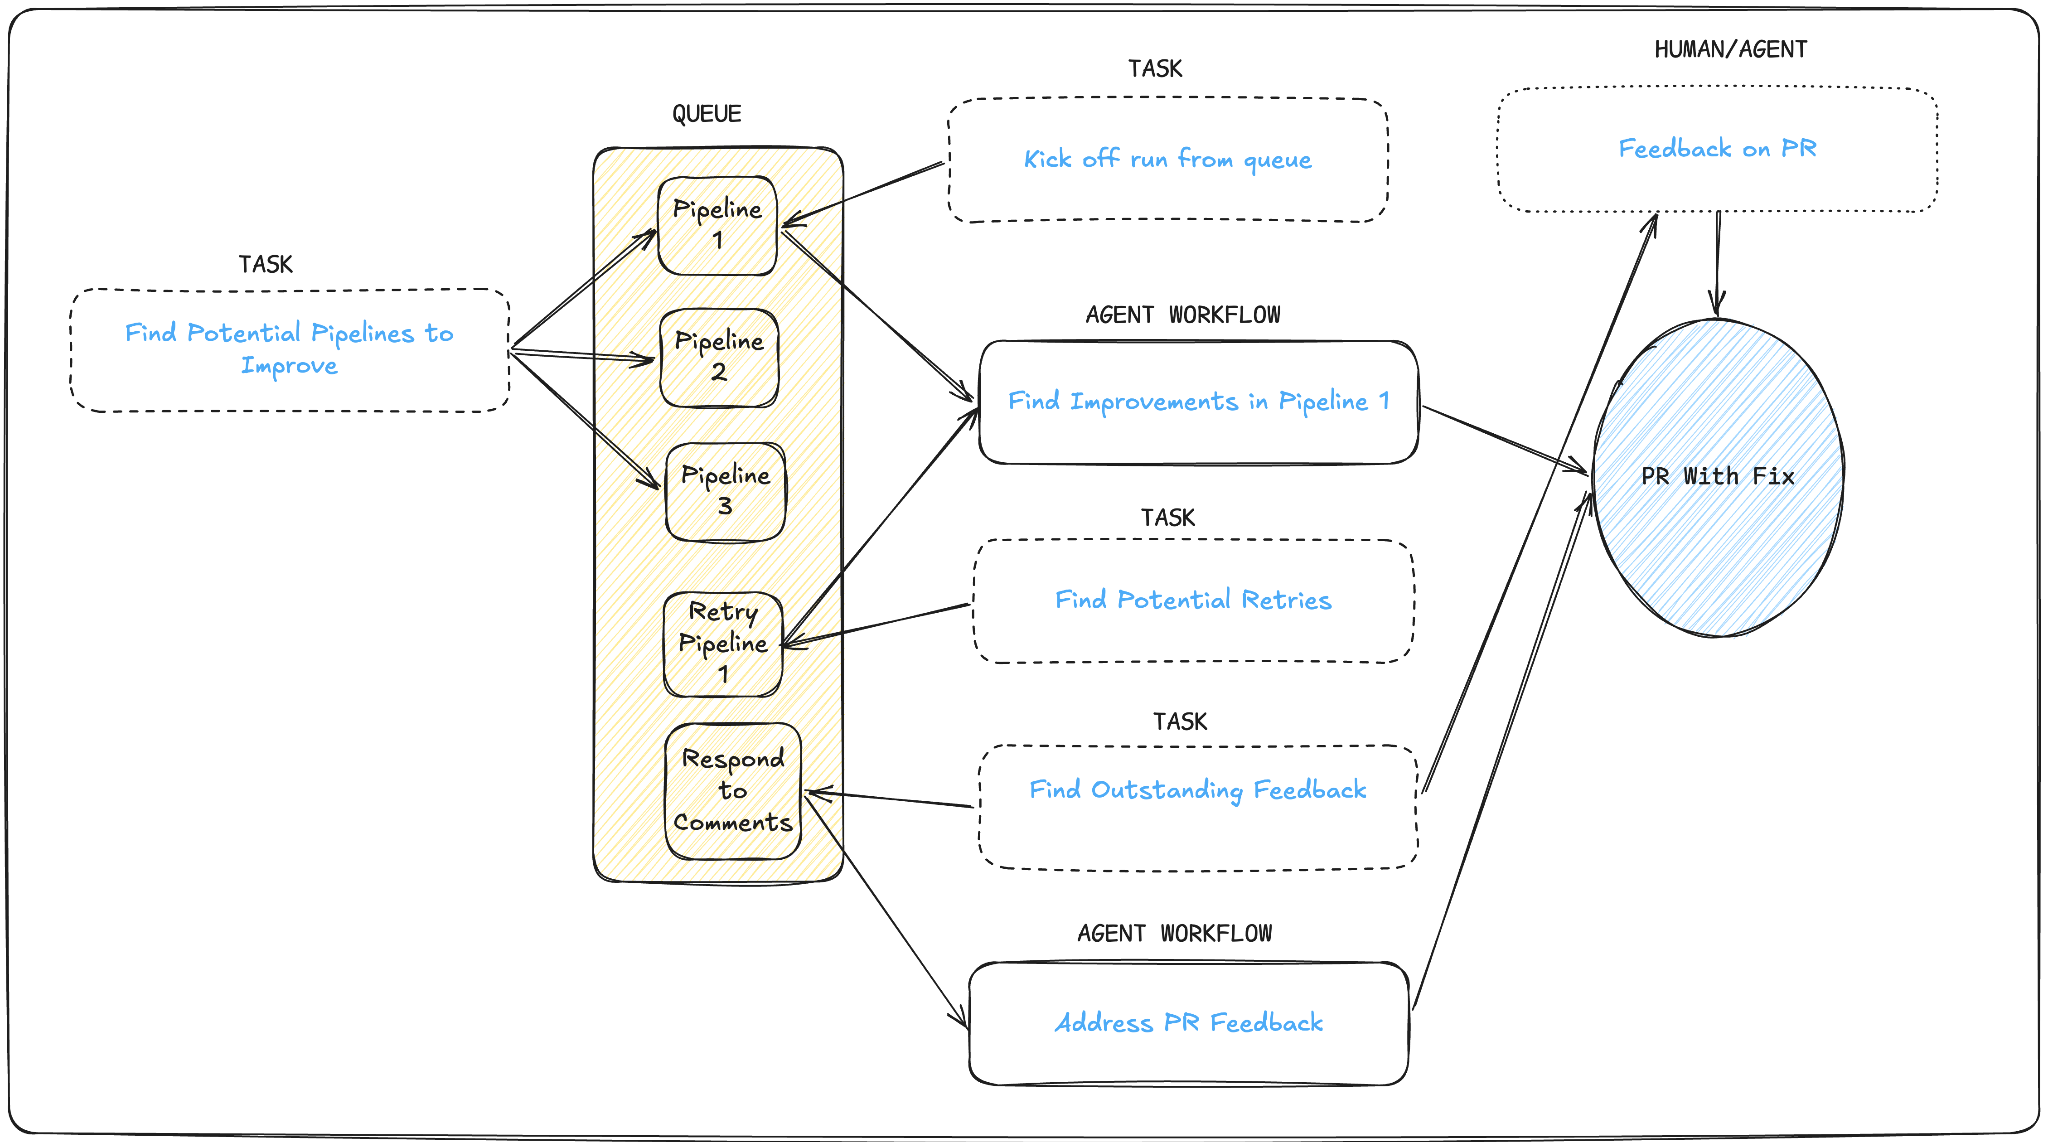
Die meisten Tools hören bei der Warnung auf: Etwas ist kaputt. Sehen Sie nach. Wir wollten einen Agenten, der das Problem erklären und bei der Lösung helfen kann. Das bedeutete, dass er den gesamten Zyklus abdecken musste:
- Pipelines kontinuierlich auf Code Smells und Performance-Probleme scannen.
- Ausfälle proaktiv abfangen, bevor sie eskalieren.
- Protokolle und die Codebasis durchsuchen, um die wahrscheinliche tatsächliche Grundursache zu ermitteln.
- Vorgeschlagene Fixes testen, bevor etwas in die Produktion gelangt.
- Einen sauberen PR mit vollständigem Kontext öffnen, damit der Mensch ihn schnell überprüfen und mergen kann.
Diese letzte Anforderung ist die wichtigste. Der Agent schlägt die Reparatur vor. Ein Mensch entscheidet weiterhin, was ausgeliefert wird.
Wie wir ihn entwickelt haben
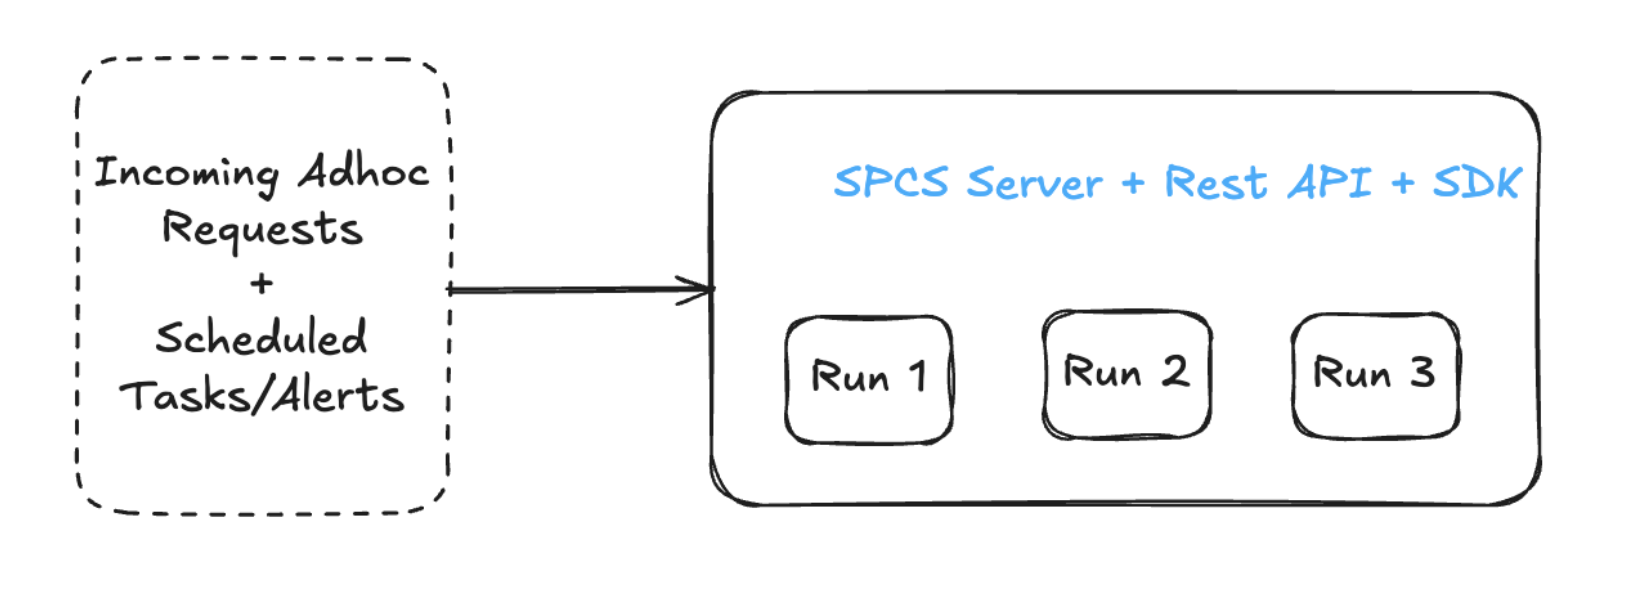
Wir haben uns einige Architekturen angesehen, bevor wir uns für die richtige entschieden haben. Unser erster Instinkt war ein Snowpark Container Services-Server, auf dem eine REST-API ausgeführt wird: in sich geschlossen, mit allem an einem Ort. Das hätte jedoch bedeutet, dass wir durch die Anzahl der Ausführungen begrenzt wären, die ein einzelner Server bewältigen kann.
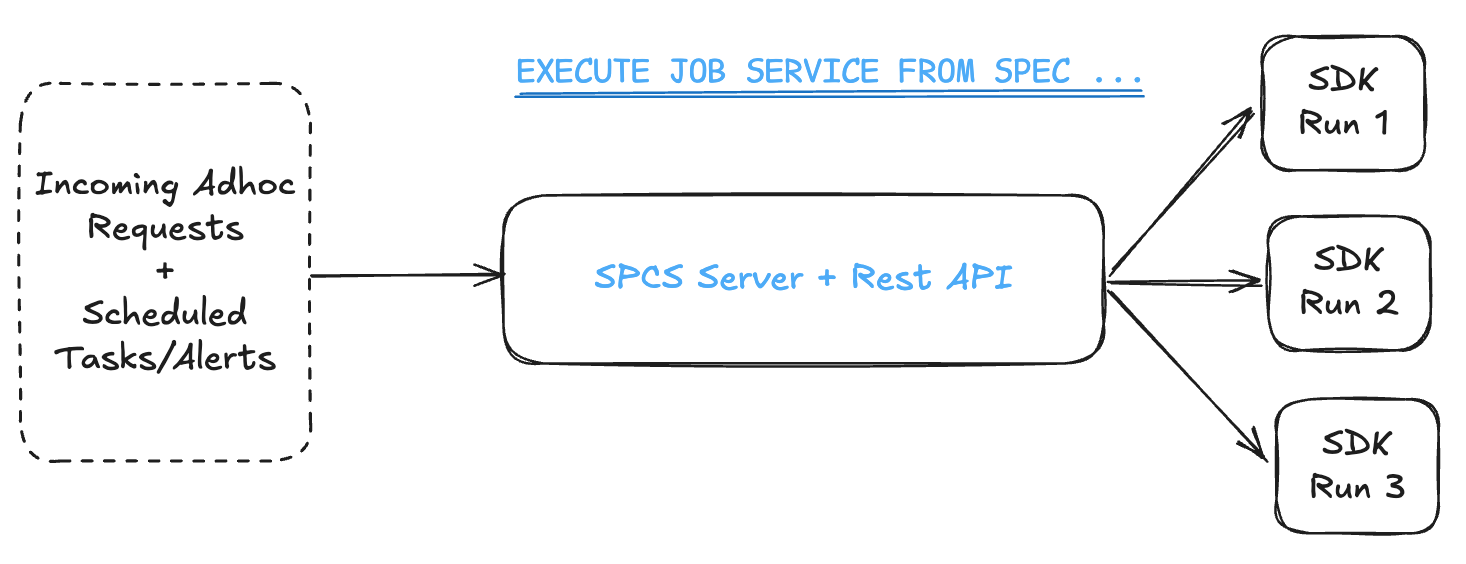
Dadurch konnten wir auf viele verschiedene parallel laufende Agenten hochskalieren, ohne durch einen einzelnen Server ausgebremst zu werden.
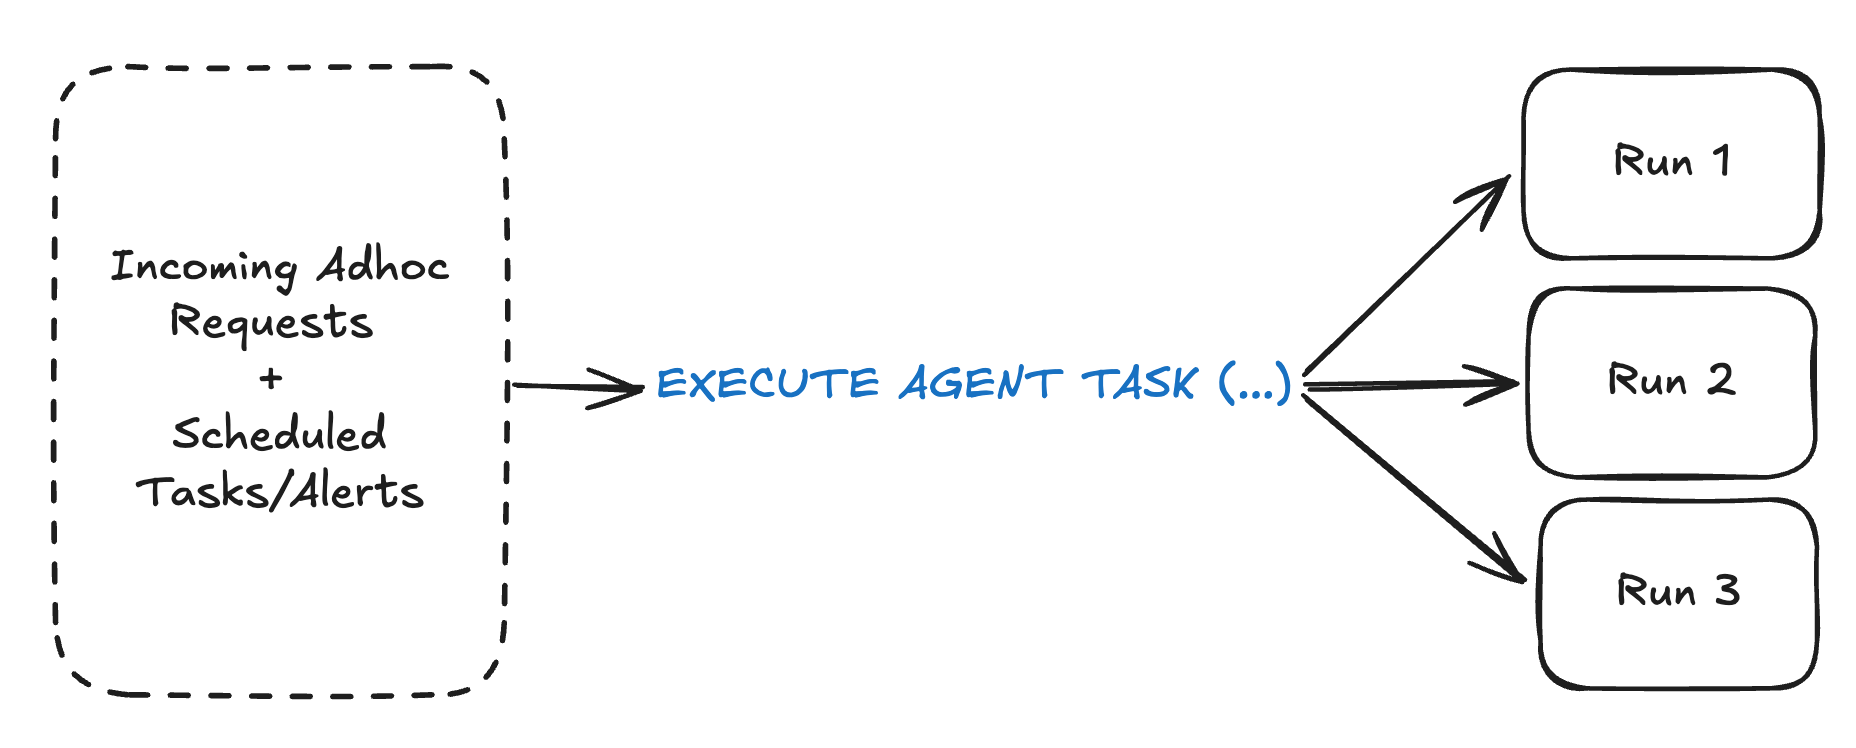
Letztendlich planen wir, darüber hinauszugehen und die neue EXECUTE AGENT TASK von CoCo Automations (jetzt in Public Preview) zu verwenden, um unsere Ausführungen noch weiter zu vereinfachen und zu skalieren.
Kein Server, der verwaltet werden muss. Kein gemeinsam genutzter Rechenressourcen-Pool. Ein SQL-Aufruf löst eine Agentenausführung aus. Snowflake kümmert sich um den Rest.
Wir brauchten eine flexible Möglichkeit, einen Workflow mit vorlagenbasierten Anweisungen zu definieren. Daher werden Workflows in JSON definiert. Sie geben die Anweisungsdatei an, auf welche Repos der Agent zugreifen kann, ein Turn-Budget, welches Modell ausgeführt werden soll und wohin Benachrichtigungen gesendet werden sollen, wenn die Arbeit erledigt ist.
{
  "name": "fix-broken-pipeline",
  "owner": "your.name@snowflake.com",
  "agent": {
    "turns": [{"file": "org/repo:path/to/instructions.md"}],
    "model": "opus",
    "max_turns": 50
  },
  "repos": [{"repo": "org/repo", "branch": "main"}],
  "timeout_minutes": 30,
  "notifications": {
    "slack_channel": "#data-eng-alerts",
    "emails": ["your.name@snowflake.com"]
  }
}
Die Ausführung ist reines SQL:
CALL RUN_WORKFLOW('fix-broken-pipeline', '{"pipeline_id": "12345"}')

CREATE TASK SCHEDULE = '12 hours' AS
  CALL RUN_WORKFLOW('code-smells')
Der Task kümmert sich um die Zeit. Der Agent kümmert sich um die Arbeit. Diese Workflows können recht einfach sein, oder wir können mehrere einfache Workflows und menschliches Feedback kombinieren, um komplexere Workflows zu erstellen.
Die Auswirkungen: Umfassende Untersuchungen von Ausfällen
Wir führen dies in der Produktion aus und haben in den letzten fünf Monaten bei den verwalteten Pipelines unseres Teams Folgendes beobachtet:
- Nahezu vollständige Triage-Abdeckung für überwachte Pipeline-Ausfälle. Entwickelt, um jeden Ausfall zu untersuchen, nicht nur die offensichtlichen.
- Weniger als 16 Minuten von der Vorfallerkennung bis zur PR-Erstellung.
- Hunderte von PRs gemergt.
- Über 500 Pipelines verbessert.
- Hunderte von täglich verschwendeten Credits durch Pipeline-Verbesserungen eingespart.
Diese letzte Zahl ist wichtig. Die Verschwendung von Rechenressourcen durch leistungsschwache Pipelines summiert sich unsichtbar. Die meisten Teams decken dies nie auf, da jemand proaktiv danach suchen muss, aber unsere Agenten suchen ständig danach.
Autonomes Data Engineering
Diese Arbeit ist zu einer direkten Inspiration für das geworden, was unser Produktteam den Kunden bieten wird. Lesen Sie hier mehr über unsere Vision für autonomes Data Engineering.
Zukunftsgerichtete Aussagen
Dieser Artikel enthält zukunftsgerichtete Aussagen, unter anderem über künftige Produktangebote. Diese Aussagen stellen keine Garantie dar, dass diese Angebote wirklich bereitgestellt werden. Die tatsächlichen Ergebnisse und Angebote können abweichen und unterliegen bekannten und unbekannten Risiken und Unsicherheiten. Weitere Informationen finden Sie in unserem aktuellen Formular 10-Q.
