何年もの間、Snowflakeでのパイプライン障害は同じ手順をたどっていました。誰かが呼び出されます。ログを調べ、根本原因を追跡し、修正コードを記述してテストし、プルリクエスト(PR)を作成します。そして翌日の夜にも、まったく同じことを繰り返していました。
現在では、エージェントがこの手順を代行しています。監視対象のすべてのパイプライン障害を調査し、インシデントの検出からレビュー可能なPRの作成までを平均16分未満で完了させます。このエージェントの構築方法と、それによってチームにもたらされた変化について説明します。
悪化し続けた課題
私はSnowflakeの社内データチームに所属するデータサイエンティストです。当社のパイプラインの数が、1人で把握できる規模から、圧倒的な規模へと拡大するのを見てきました。
パイプラインの増加は、データと価値の増加を意味するため、良いことのように思えます。しかし、新しいパイプラインは新たな障害発生箇所となり、新しい依存関係は深夜2時に破損する可能性のある要素を増やすことになります。a.m.障害の件数が増加していたのは、パイプラインの品質が悪化したからではありません。パイプラインの数が増加した一方で、チームの規模が同じペースで拡大していなかったためです。
実際に構築したかったもの
ほとんどのツールはアラートを出すだけで終わります。「何かが破損しました。確認してください」私たちが求めていたのは、問題を説明し、解決を支援できるエージェントでした。つまり、以下のサイクル全体を担う必要がありました。
- コードの不吉な臭いやパフォーマンスの問題がないか、パイプラインを継続的にスキャンする
- 障害が深刻化する前にプロアクティブに検知する
- ログとコードベースを調査し、実際の根本原因の可能性を特定する
- 本番環境に影響を与える前に修正案をテストする
- 人間が迅速にレビューしてマージできるように、完全なコンテキストを含むクリーンなPRを作成する
この最後の要件が最も重要です。エージェントは修正を提案します。何をリリースするかは、引き続き人間が決定します。
構築方法
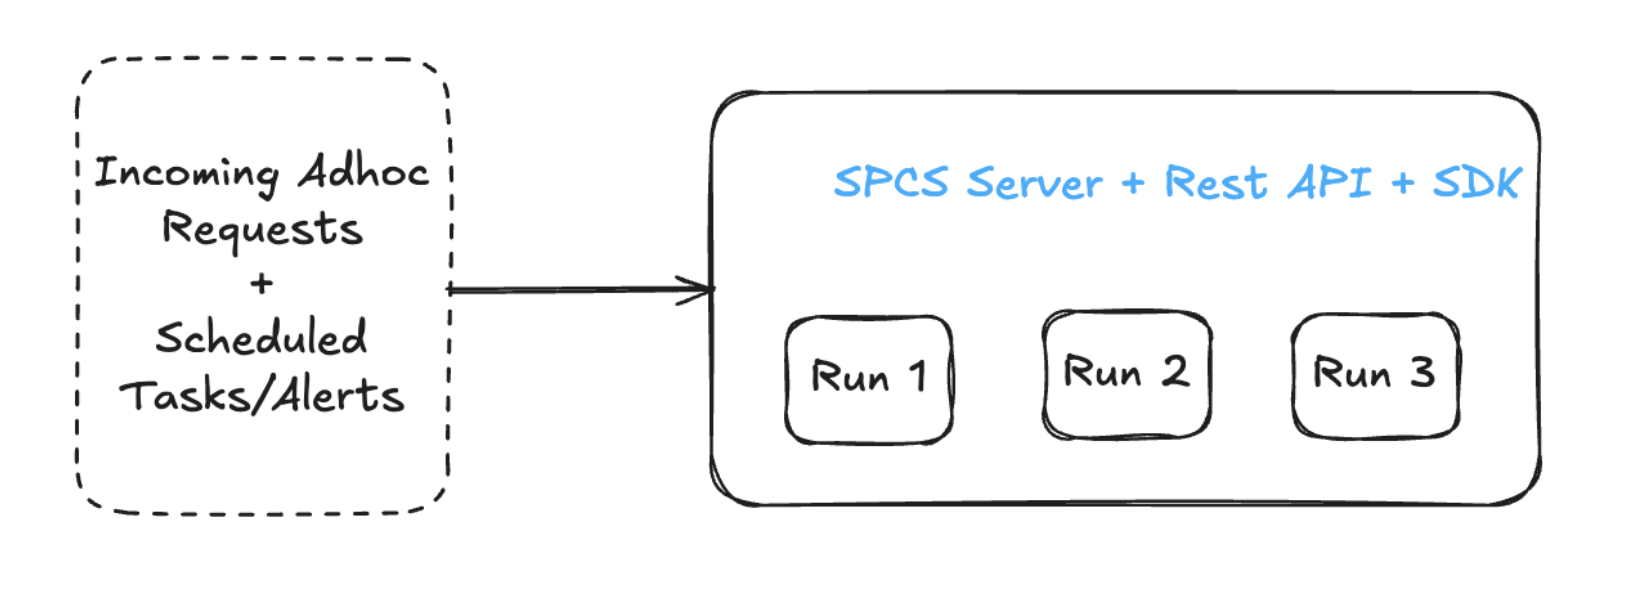
適切なアーキテクチャにたどり着くまでに、いくつかのアーキテクチャを検討しました。最初に思いついたのは、REST APIを実行するSnowparkコンテナサービスのサーバーでした。これは自己完結型であり、すべてが1か所にまとまっています。しかし、これでは単一のサーバーが処理できる実行回数に制限されることになります。
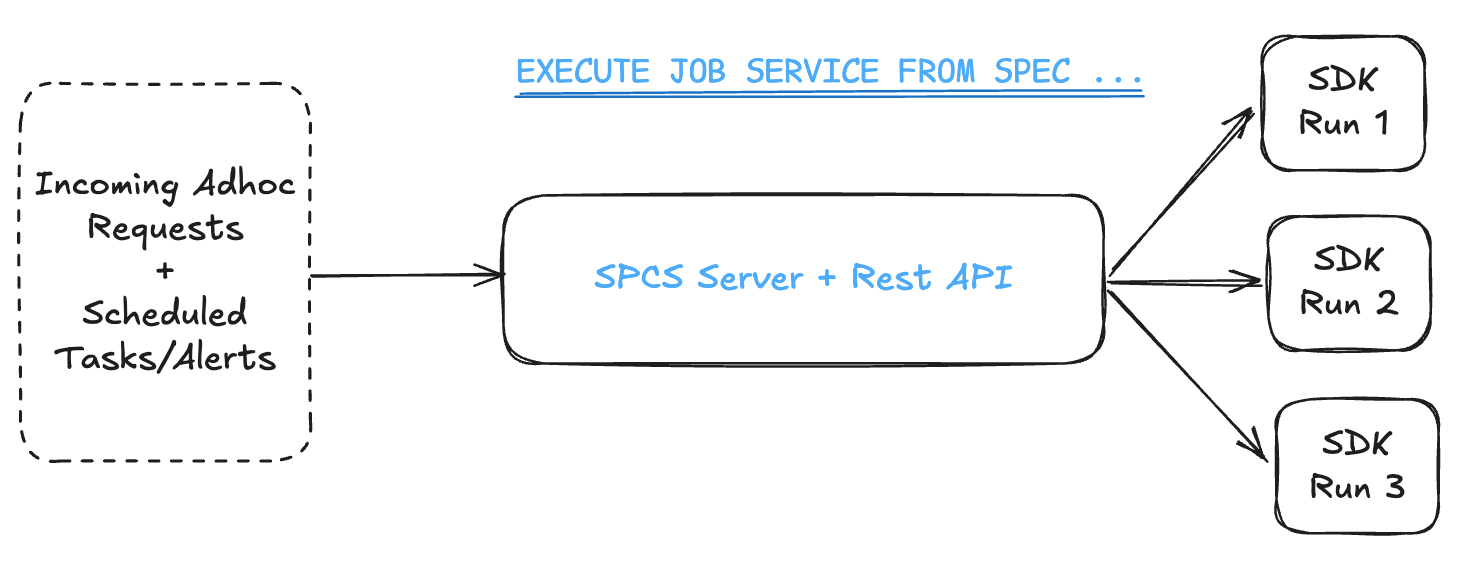
これにより、単一のサーバーがボトルネックになることなく、並行して実行される多数の異なるエージェントにスケールアップできるようになりました。
最終的にはこれを超えて、CoCo自動化の新しいEXECUTE AGENT TASK(現在パブリックプレビュー中)を使用し、実行をさらに簡素化して拡張する予定です。
管理するサーバーはありません。共有コンピュートプールもありません。1回のSQL呼び出しでエージェントの実行がトリガーされます。残りの処理はすべてSnowflakeが対応します。
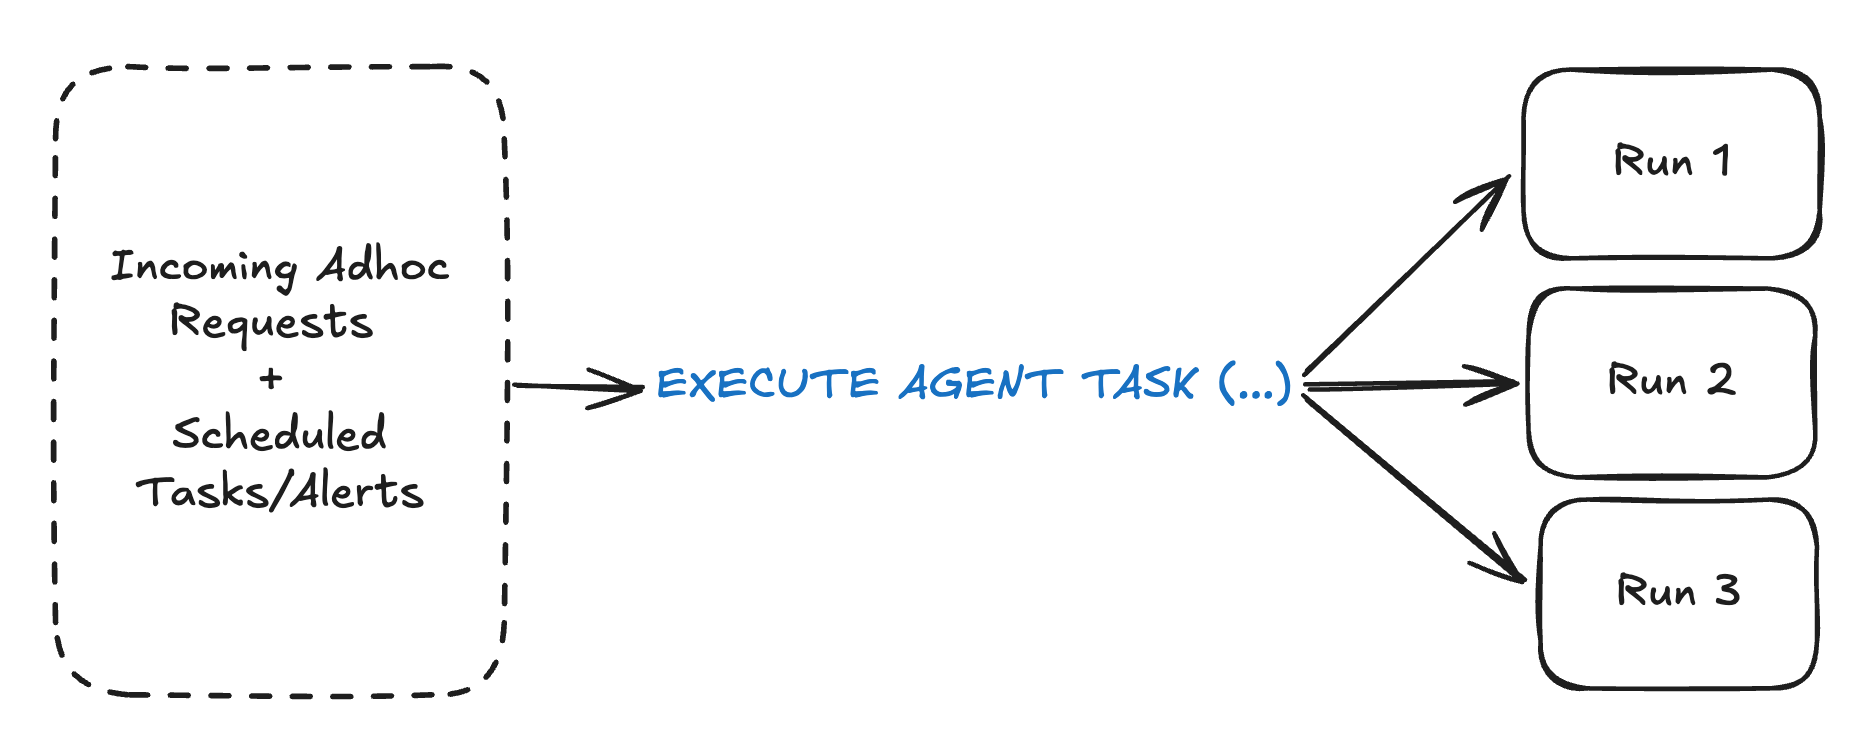
テンプレート化された指示を使用してワークフローを定義する柔軟な方法が必要でした。そのため、ワークフローはJSONで定義されています。指示ファイル、エージェントがアクセスできるリポジトリ、ターンのbudget、実行するモデル、作業完了時の通知の送信先を指定します。
{
  "name": "fix-broken-pipeline",
  "owner": "your.name@snowflake.com",
  "agent": {
    "turns": [{"file": "org/repo:path/to/instructions.md"}],
    "model": "opus",
    "max_turns": 50
  },
  "repos": [{"repo": "org/repo", "branch": "main"}],
  "timeout_minutes": 30,
  "notifications": {
    "slack_channel": "#data-eng-alerts",
    "emails": ["your.name@snowflake.com"]
  }
}
実行はSQLのみで行われます。
CALL RUN_WORKFLOW('fix-broken-pipeline', '{"pipeline_id": "12345"}')

CREATE TASK SCHEDULE = '12 hours' AS
  CALL RUN_WORKFLOW('code-smells')
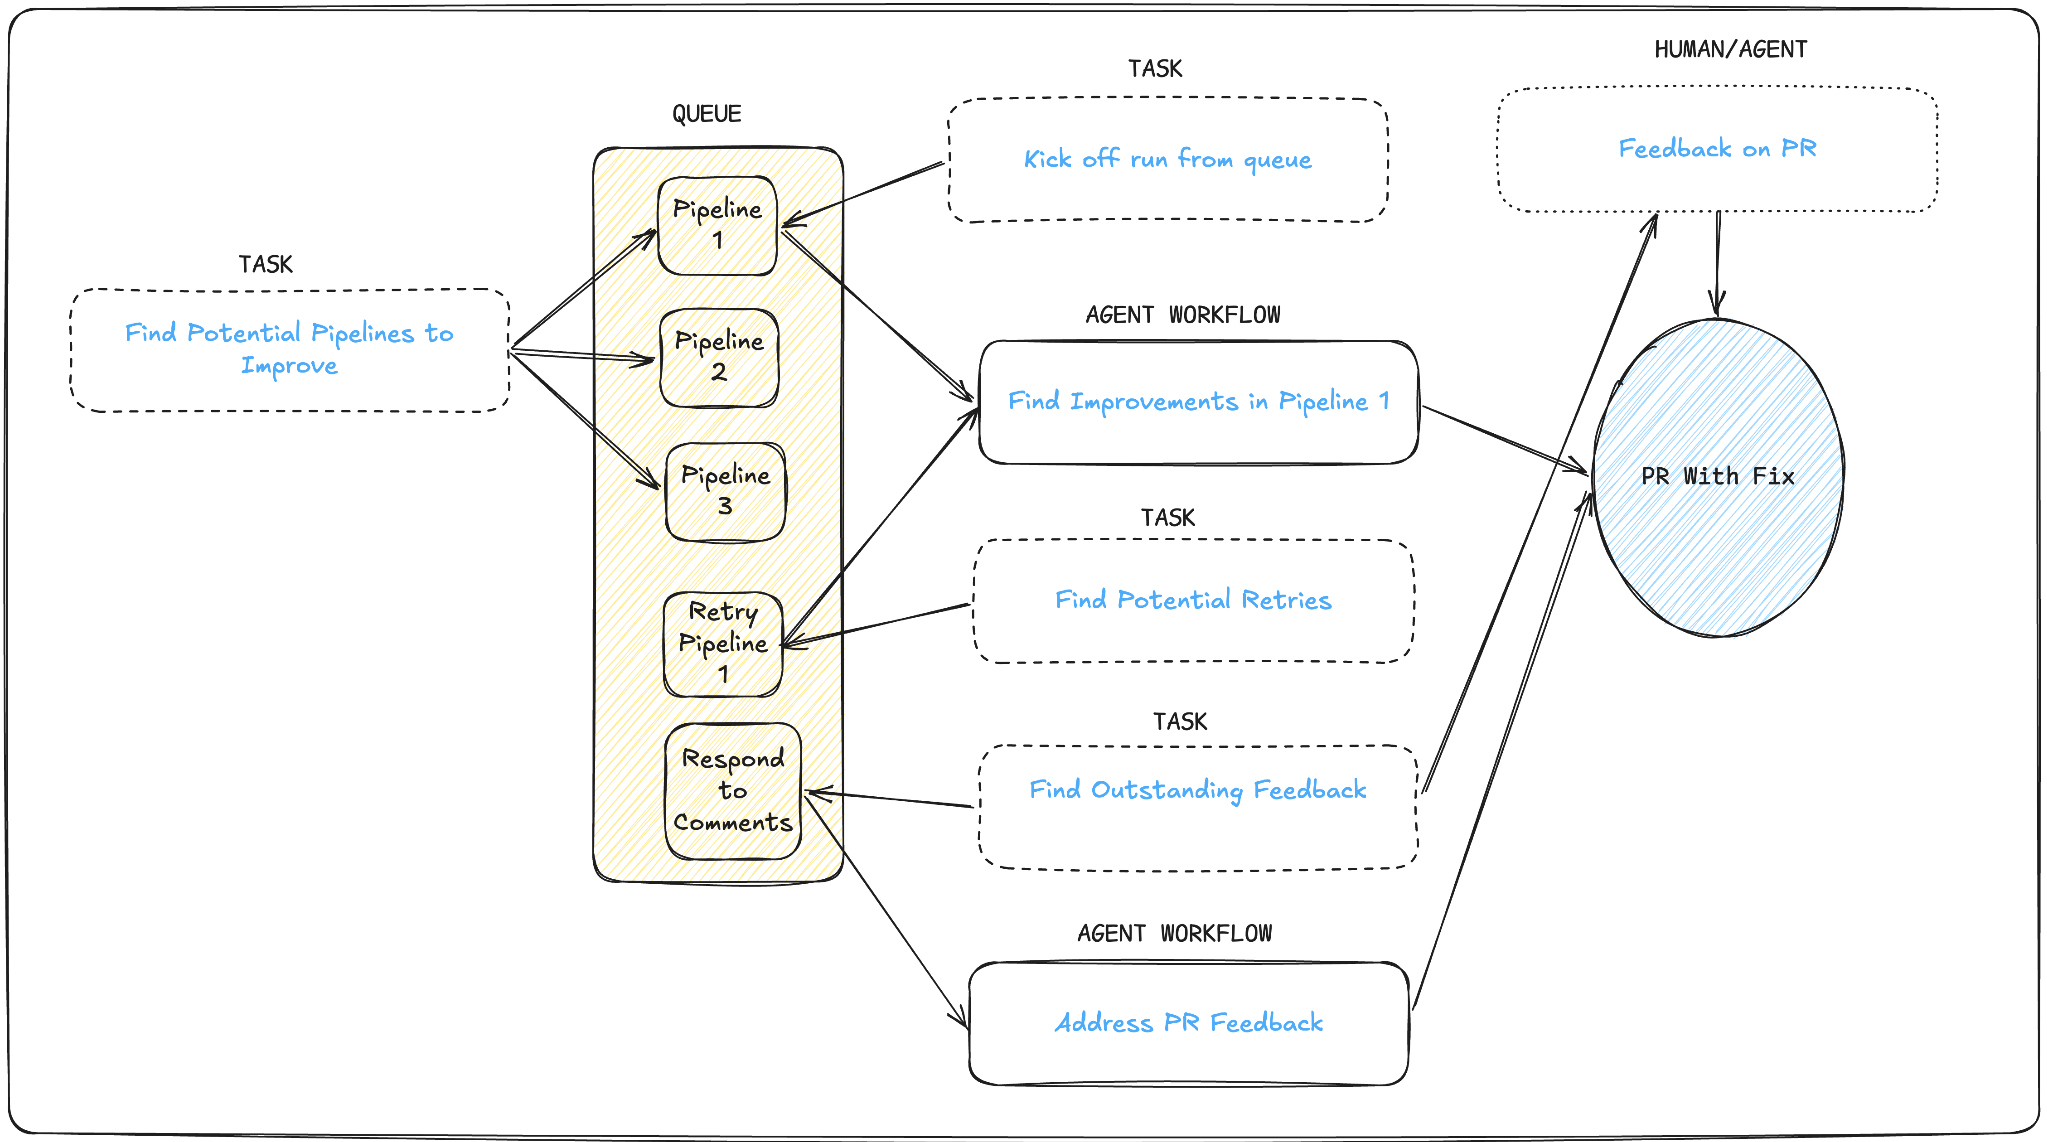
タスクがスケジュールを処理します。エージェントが作業を処理します。これらのワークフローは非常にシンプルなものにすることも、複数のシンプルなワークフローと人間のフィードバックを組み合わせてより複雑なワークフローを作成することもできます。
もたらされた影響:障害の包括的な調査
これを本番環境で実行しており、過去5か月間、チームが所有するマネージドパイプライン全体で以下の成果を確認しています。
- 監視対象のパイプライン障害に対するほぼすべてのトリアージカバレッジ。目立つ障害だけでなく、すべての障害を調査するように設計されています。
- 16分未満(インシデントの検出からPRの作成まで)
- 数百件のマージされたPR
- 500以上の改善されたパイプライン
- 数百クレジットの削減(パイプラインの改善により毎日節約された無駄なクレジット)
この最後の数字は重要です。パフォーマンスの低いパイプラインによるコンピュートの無駄は、目に見えない形で蓄積されます。誰かがプロアクティブに確認する必要があるため、ほとんどのチームはこれを表面化させることはありませんが、当社のエージェントは常に監視しています。
自律型データエンジニアリング
この取り組みは、当社の製品チームがお客様に提供する機能の直接的なインスピレーションとなっています。自律型データエンジニアリングのビジョンについては、こちらをご覧ください。
将来予想に関する記述
このページには、Snowflakeが将来提供する製品に関する記述を含め、将来の見通しに関する記述が含まれていますが、これはいかなる製品の提供も約束するものではありません。実際の成果や提供内容は異なる可能性があり、既知および未知のリスクおよび不確実性の影響を受けます。詳細については、最新の四半期報告書(10-Q)をご覧ください。
