10 novembre 2026/Lettura: 9 minProdotto e tecnologia
Hybrid Tables ora fino a 8 volte più veloci, automaticamente

A giugno abbiamo presentato in preview una nuova generazione di performance per le Snowflake Hybrid Tables. Oggi questi miglioramenti sono in GA e attivi per impostazione predefinita.
Le Hybrid Tables ora offrono throughput fino a 8 volte superiore, latenza p50 3 volte inferiore e latenza p99 2 volte inferiore.¹ Per le migliaia di clienti che già utilizzano le Hybrid Tables, i workload esistenti diventeranno automaticamente più rapidi ed economici, con margine per gestire volumi maggiori sulla stessa capacità di compute.
Dati transazionali senza un database separato
Pipeline, agenti AI e app interne dipendono tutti da letture e scritture transazionali rapide, sia per tracciare lo stato dei job, sia per memorizzare il contesto degli agenti o registrare le azioni degli utenti nelle app enterprise realizzate con Streamlit o Snowflake App Runtime. Troppo spesso questo ha significato mettere in piedi un database operativo separato, una pipeline per mantenerlo sincronizzato con l’analisi dei dati e un secondo set di controlli di governance.
Le Hybrid Tables portano invece letture e scritture rapide e conformi ad ACID direttamente nel database Snowflake. Dati transazionali e analitici convivono sotto lo stesso framework di governance e si possono unire in join in un’unica query. E con questa release, app e workflow esistenti ottengono un miglior rapporto prezzo/prestazioni senza nulla da riprogettare.
Cosa è in GA oggi per le Hybrid Tables
Throughput fino a 8 volte superiore
L’esecuzione di query a singolo statement per operazioni puntuali ripetitive offre ora un throughput fino a 8 volte superiore.¹ Significa che, per alcuni workload, ciò che prima richiedeva otto warehouse XS ora ne richiede uno solo, con una riduzione dei costi di compute superiore all’80%.2

Latenza inferiore sulla mediana e sulla coda
Con il nuovo engine delle Hybrid Tables, i risultati dei benchmark mostrano che la latenza p50 è 3 volte inferiore e la latenza p99 2 volte inferiore.3 Una mediana più rapida significa risposte più veloci su ogni richiesta. Una coda più contenuta significa meno richieste lente nei picchi di carico, ed è proprio ciò che utenti e sistemi a valle percepiscono di più.
Bulk load più rapidi ed economici
Gli insert bulk sono ottimizzati a livello di storage engine e i risultati dei benchmark dimostrano fino a scritture batch 10 volte più rapide con costi 10 volte inferiori, anche su tabelle con dati già presenti.3 I backfill e le sincronizzazioni di grandi volumi che un tempo richiedevano un’orchestrazione accurata ora funzionano con un semplice INSERT.
Pricing più semplice
Le Hybrid Tables seguono lo stesso modello basato su compute e storage che i clienti Snowflake già conoscono, ma abbiamo eliminato una delle dimensioni, così la fatturazione si basa su meno voci. Oggi i clienti registrano una riduzione dei costi del 15% in media e del 40% o più per i workload a throughput elevato.4
| Evoluzione delle Hybrid Tables | I risultati |
|---|---|
| Throughput più elevato | Fino a 8 volte più throughput, applicato automaticamente |
| Prestazioni batch più rapide | Bulk load fino a 10 volte più rapidi e 10 volte più economici, senza modifiche ai workflow |
| Riduzione dei costi | Risparmi sui costi del 40% o più |
Dove i clienti utilizzano le Hybrid Tables
Che si tratti di sviluppare un’app interna, eseguire una pipeline o orchestrare agenti AI, i workload su Hybrid Tables seguono in genere i tre pattern descritti di seguito. Molte app ne combinano più di uno.
Stato dei workflow
Pipeline, app e agenti hanno tutti bisogno di un posto in cui tracciare lo stato: stato dei job, checkpoint, sessioni e risultati intermedi. Spesso i team hanno utilizzato un database esterno solo per questo. Le Hybrid Tables mantengono lo stato dei workflow coerente a livello transazionale, nello stesso database Snowflake in cui risiedono i dati analitici prodotti da quei workflow, così i team possono interrogarli insieme.
Per esempio, MarketWise ha sostituito MySQL e DynamoDB per tracciare in tempo reale lo stato dei workflow delle sue pipeline di data engineering, riducendo i costi di infrastruttura del 35% ed eliminando movimenti di dati non necessari. Elementum orchestra agenti AI, regole di business e passaggi umani in processi multi-step sulle Hybrid Tables, con vincoli di primary key e foreign key applicati.
In preview, i workload di stato dei workflow dei clienti sono risultati fino a 5 volte più rapidi a p50 e 2,8 volte più rapidi a p99. Un cliente ha visto la latenza p90 scendere da 21 a 5 millisecondi, eseguendo il 55% di job in più.⁵
Serving dei dati applicativi
Quando un’app o un agente deve rispondere immediatamente a una domanda, per esempio se approvare un reso, quale prodotto consigliare o in che stato si trova una macchina, le Hybrid Tables trasformano Snowflake nel serving tier. I workload di data serving sono quelli che traggono i maggiori vantaggi da questa release. In preview hanno registrato latenza p50 fino a 6,7 volte inferiore e latenza p99 fino a 6,3 volte inferiore.⁵ Ora i team gestiscono molte più lookup concorrenti con molto meno compute.
Per esempio, Grailed fornisce a milioni di utenti raccomandazioni di stile personalizzate in meno di un secondo, a partire da risultati ML precalcolati nelle Hybrid Tables e senza un database di serving separato.
Lo stesso pattern si adatta ad ambienti operativi esigenti come il manifatturiero, la logistica e la supply chain. Gli operatori hanno bisogno di lookup in millisecondi sullo stato attuale di un job, di una macchina o di una spedizione, mentre chi si occupa di pianificazione esegue analisi sugli stessi dati. Le Hybrid Tables servono le lookup e le tabelle standard gestiscono i join su larga scala, entrambe su una sola piattaforma e senza tuning tabella per tabella. È qui che i miglioramenti su p99 contano di più: una coda lenta può bloccare una linea di produzione o una pianificazione.
Scritture affidabili ad alta concorrenza
Alcuni workload scrivono costantemente. App e servizi registrano ogni azione utente, chiamata API, invocazione di modello o transazione come record che deve essere scritto in modo affidabile. Le tabelle standard sono progettate per l’analisi dei dati e possono incorrere in contese di lock con scritture concorrenti intense. Le Hybrid Tables usano un locking a livello di riga progettato esattamente per questo pattern.
In preview, i workload di event log e record capture sono risultati fino a 3,4 volte più rapidi a p50 e 3,7 volte più rapidi a p99. In un cliente, il workload di log operativi ha visto la latenza di insert p90 ridursi del 66%, gestendo oltre 3 volte il volume di job.⁵
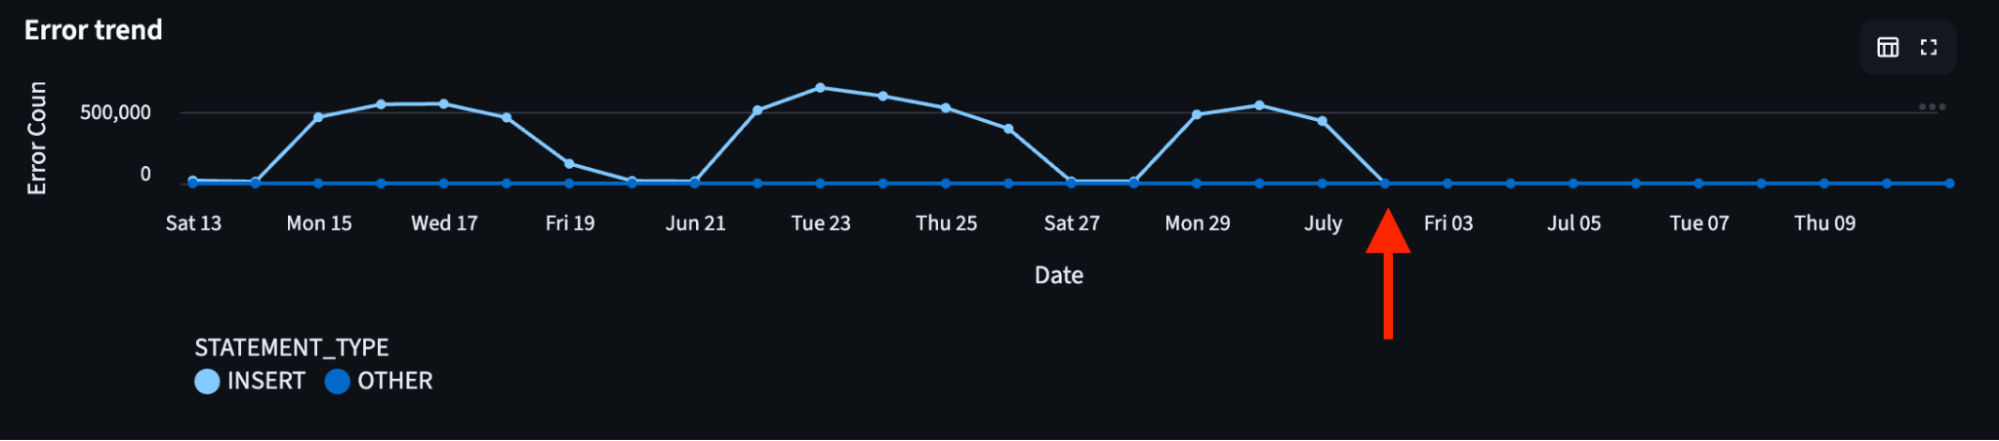
Writer, piattaforma AI enterprise, scrive ogni giorno circa 1,3 milioni di record di trace LLM su Snowflake per alimentare observability e QA dei modelli. Su una tabella standard, la latenza di insert p50 è schizzata e fino al 45% delle scritture non andava a buon fine. Writer ha cambiato la destinazione passando a una Hybrid Table, in pratica uno scambio di tabella, e la latenza di insert p50 è scesa di circa 15 volte. Gli errori si sono ridotti quasi a zero. Le Hybrid Tables assorbono le scritture, mentre una tabella standard clusterizzata per timestamp alimenta le analisi, tutto nello stesso database.
Appriss Retail blocca le frodi con dati sempre aggiornati
Appriss Retail aiuta a bloccare le frodi legate a resi e reclami per oltre 60 dei primi 100 retailer statunitensi, con un’accuratezza del 99,99%. Ogni reso e ogni reclamo riceve un punteggio in tempo reale. Acquisti, resi e reclami di ogni cliente sono riuniti in un unico profilo. I segnali di rischio sono calcolati da quello storico nel momento del reso, per approvare, segnalare o negare.
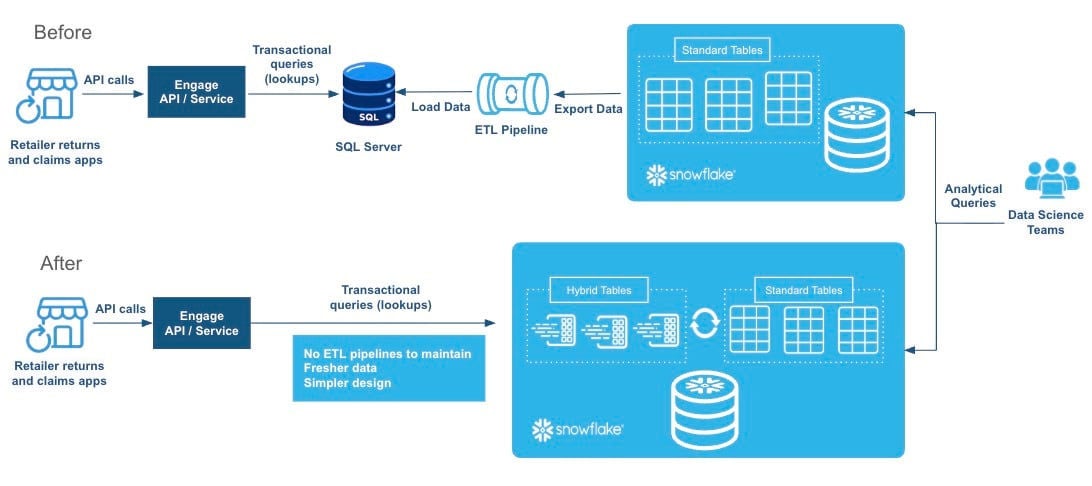
Prima delle Hybrid Tables, questo scoring dipendeva da un database SQL Server separato, alimentato da una pipeline ETL personalizzata. Il tempo dei team di engineering andava nella manutenzione della pipeline invece che nel miglioramento del rilevamento. Spostare i dati tra sistemi significava decidere sulle frodi basandosi su dati non aggiornati. E il caricamento dei dati rallentava lo stesso database che gestiva resi e reclami live.
Ora le app di resi e reclami dei retailer eseguono le lookup direttamente sulle Hybrid Tables, mentre i team di data science interrogano le tabelle standard sulla stessa piattaforma. Le lookup si completano rapidamente e le analisi scansionano terabyte di dati, tutto in Snowflake. La pipeline personalizzata non c’è più e le decisioni si basano sui dati nell’istante in cui sono generati.
“Ogni reso e ogni reclamo gestito dal nostro retailer più grande viene ora verificato tramite Hybrid Tables. Parliamo di oltre un milione di ricerche al giorno, senza esportare alcun dato da Snowflake.”
Kenny Vu
VP of Engineering, Appriss Retail
Come iniziare con le Hybrid Tables
Se utilizzi già le Hybrid Tables, non devi fare nulla. I miglioramenti sono attivi per impostazione predefinita.
Non hai mai usato le Hybrid Tables? Per crearne una basta un singolo statement e puoi unirla subito in join con le tue tabelle esistenti.
Crea una Hybrid Table per tracciare lo stato dei job di una pipeline
CREATE HYBRID TABLE job_state (
  job_id      INT PRIMARY KEY,
  status      VARCHAR,
  updated_at  TIMESTAMP_NTZ,
  INDEX idx_status (status)
);
Scritture e lookup puntuali rapide
INSERT INTO job_state VALUES (1001, 'RUNNING', CURRENT_TIMESTAMP());
SELECT status FROM job_state WHERE job_id = 1001;
Unisci lo stato transazionale ai dati analitici in un’unica query
SELECT j.job_id, j.status, r.rows_processed
FROM job_state j
JOIN job_run_metrics r ON j.job_id = r.job_id
WHERE j.status = 'FAILED';
Da qui puoi seguire un esempio completo con la quickstart guide ed esplorare la documentazione sulle best practice per le Hybrid Tables.
¹ Dati basati su benchmark eseguiti con lo Yahoo Cloud Serving Benchmark, con workload di lettura al 100% su un warehouse XS Gen2.
2 Derivato da un throughput 8 volte superiore su un singolo warehouse XS rispetto a otto warehouse XS a carico equivalente.
3 Dati basati su benchmark interni per il caricamento di 50 GB nelle Hybrid Tables con un warehouse 2XL.
4 Dati basati su stime Snowflake del risparmio medio sui costi tra i clienti, misurato sul consumo reale di credit in produzione a febbraio 2026.
⁵ Dati basati su osservazioni Snowflake della latenza di query p50, p90 e p99 per workload di clienti in produzione, prima e dopo l’attivazione del nuovo engine delle Hybrid Tables durante la public preview.

