10 nov 2026/9 min de lecturaProducto y tecnología
La tablas híbridas ahora son hasta 8 veces más rápidas, automáticamente

En junio, presentamos en versión preliminar una nueva generación de mejoras de rendimiento para las tablas híbridas de Snowflake. Hoy, esas mejoras están disponibles de forma general y activadas de manera predeterminada.
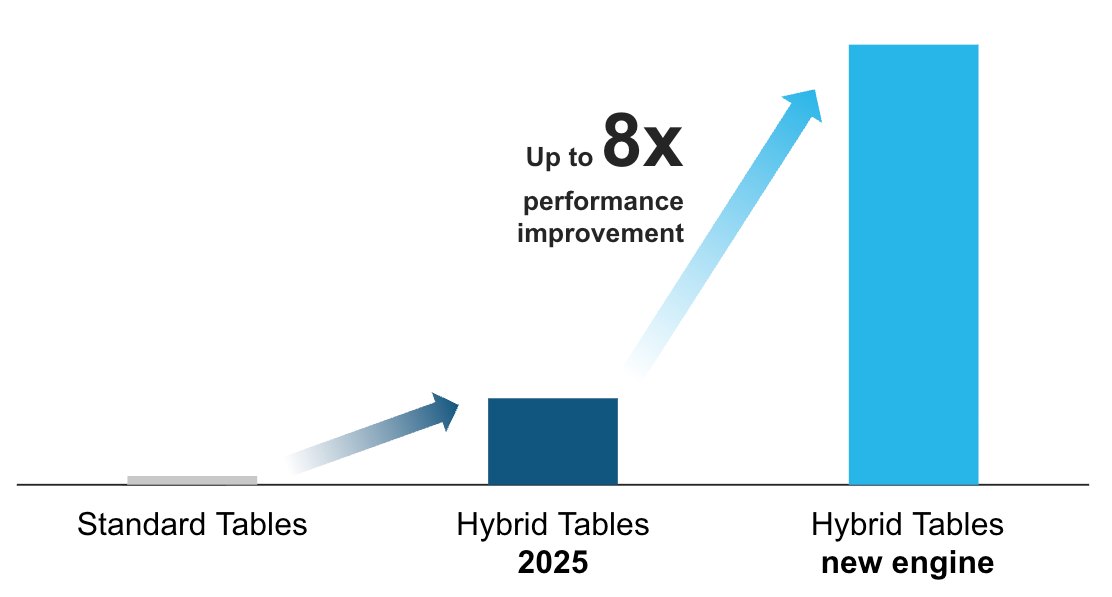
Las tablas híbridas ahora ofrecen un rendimiento hasta 8 veces mayor, una latencia p50 tres veces menor y una latencia p99 dos veces menor.¹ Para los miles de clientes que ya ejecutan las tablas híbridas, sus workloads actuales serán más rápidos y económicos automáticamente y podrán gestionar un mayor volumen con los mismos recursos de cómputo.
Datos transaccionales sin una base de datos independiente
Los pipelines, los agentes de inteligencia artificial (IA) y las aplicaciones internas dependen de lecturas y escrituras transaccionales rápidas, ya sea para hacer un seguimiento del estado de los trabajos, almacenar el contexto de los agentes o registrar lo que hacen los usuarios en aplicaciones empresariales creadas con Streamlit o Snowflake App Runtime. Con demasiada frecuencia, esto ha implicado poner en marcha una base de datos operativa independiente, un pipeline para mantenerla sincronizada con las analíticas y un segundo conjunto de controles de gobernanza.
En su lugar, las tablas híbridas incorporan lecturas y escrituras rápidas y compatibles con ACID en la base de datos de Snowflake. Los datos transaccionales y analíticos conviven bajo el mismo marco de gobernanza y pueden combinarse en una sola consulta. Además, con esta versión, las aplicaciones y los flujos de trabajo actuales obtienen una mejor relación precio-rendimiento sin necesidad de rediseñar su arquitectura.
Funcionalidades de tablas híbridas disponibles de forma general desde hoy
Mejora del rendimiento de hasta 8 veces
La ejecución de consultas de una sola sentencia para operaciones repetitivas de tipo puntual ofrece ahora hasta 8 veces más rendimiento.¹ Esto significa que, en determinados workloads, lo que antes requería ocho almacenes XS ahora solo necesita uno, lo que puede reducir los costes de cómputo en más de un 80 %.2
Menor latencia en los valores medianos y extremos
Con el nuevo motor de tablas híbridas, los resultados de las pruebas comparativas muestran que la latencia p50 es 3 veces menor y la latencia p99, 2 veces menor.3 Una mediana más rápida se traduce en respuestas más ágiles para cada solicitud. Una cola de distribución más estrecha implica menos solicitudes lentas durante los picos de carga, que es precisamente lo que más perciben los usuarios y los sistemas posteriores.
Cargas masivas más rápidas y rentables
Las inserciones masivas se optimizan en el motor de almacenamiento, y los resultados de las pruebas comparativas demuestran que las escrituras por lotes son hasta 10 veces más rápidas y tienen un coste 10 veces menor, incluso en tablas que ya contienen datos.3 Las cargas de datos históricos y las sincronizaciones a gran escala que antes requerían una orquestación meticulosa ahora funcionan con una simple instrucción INSERT.
Precios más sencillos
Las tablas híbridas siguen el mismo modelo de cómputo y almacenamiento que ya conocen los clientes de Snowflake, pero hemos eliminado una de las dimensiones para que se facturen menos conceptos. Ahora, los clientes han observado una reducción media de los costes del 15 % y del 40 % o más en workloads con un alto rendimiento.4
| Evolución de las tablas híbridas | Resultados |
|---|---|
| Mayor rendimiento | Rendimiento hasta 8 veces mayor, aplicado automáticamente |
| Procesamiento por lotes más rápido | Cargas masivas hasta 10 veces más rápidas y 10 veces más económicas, sin cambios en los flujos de trabajo |
| Reducción de costes | Ahorro de costes del 40 % o más |
Dónde utilizan los clientes tablas híbridas
Tanto si creas una aplicación interna como si ejecutas un pipeline u orquestas agentes de IA, los workloads de tablas híbridas suelen seguir los tres patrones que se describen a continuación. Muchas aplicaciones combinan más de uno.
Estado de los flujos de trabajo
Los pipelines, las aplicaciones y los agentes necesitan un lugar donde realizar un seguimiento del estado, incluidos el estado de los trabajos, los puntos de control, las sesiones y los resultados intermedios. A menudo, los equipos han utilizado una base de datos externa solo para este fin. Las tablas híbridas mantienen la coherencia transaccional del estado de los flujos de trabajo en la misma base de datos de Snowflake que contiene los datos analíticos generados por esos flujos, de modo que los equipos pueden consultar ambos conjuntamente.
Por ejemplo, MarketWise sustituyó MySQL y DynamoDB para hacer un seguimiento en tiempo real del estado de los flujos de trabajo de sus pipelines de ingeniería de datos, lo que redujo los costes de infraestructura en un 35 % y eliminó los movimientos de datos innecesarios. Elementum orquesta agentes de IA, reglas de negocio y pasos realizados por personas en procesos de varios pasos mediante las tablas híbridas, con restricciones obligatorias de clave primaria y clave externa.
Durante la vista previa, observamos que los workloads de estado de los flujos de trabajo de los clientes se ejecutaban hasta 5 veces más rápido en p50 y 2,8 veces más rápido en p99. Un cliente observó que la latencia p90 se redujo de 21 a 5 milisegundos mientras ejecutaba un 55 % más de trabajos.⁵
Servicio de datos de aplicaciones
Cuando una aplicación o un agente necesita responder al instante a una pregunta, por ejemplo, si debe aprobar una devolución, qué producto debe recomendar o cuál es el estado de una máquina, las tablas híbridas convierten Snowflake en la capa de servicio. Los workloads de servicio de datos son los que más se benefician de esta versión. Durante la versión preliminar, registraron una latencia p50 hasta 6,7 veces menor y una latencia p99 hasta 6,3 veces menor.⁵ Ahora, los equipos gestionan muchas más consultas simultáneas con muchos menos recursos de cómputo.
Por ejemplo, Grailed ofrece recomendaciones de estilo personalizadas en menos de un segundo a millones de usuarios a partir de resultados de aprendizaje automático precalculados en las tablas híbridas, sin una base de datos de servicio independiente.
El mismo patrón resulta adecuado para entornos operativos exigentes, como los de fabricación, logística y cadena de suministro. Los operadores necesitan realizar consultas en milisegundos sobre el estado actual de un trabajo, una máquina o un envío, mientras los responsables de planificación ejecutan analíticas sobre los mismos datos. Las tablas híbridas gestionan las consultas de búsqueda y las tablas estándar se encargan de las combinaciones a gran escala, todo en una única plataforma y sin ajustes específicos para cada tabla. Las mejoras de p99 son especialmente importantes en estos casos, donde una cola de distribución lenta puede detener una línea o retrasar una programación.
Escrituras fiables con alta simultaneidad
Algunos workloads escriben constantemente. Las aplicaciones y los servicios capturan cada acción del usuario, llamada a una API, invocación de un modelo o transacción como un registro que debe guardarse de forma fiable. Las tablas estándar están diseñadas para las analíticas y pueden sufrir contención de bloqueos cuando se producen numerosas escrituras simultáneas. Las tablas híbridas utilizan un bloqueo a nivel de fila diseñado específicamente para este patrón.
Durante la vista previa, los workloads de registro de eventos y captura de registros se ejecutaron hasta 3,4 veces más rápido en p50 y 3,7 veces más rápido en p99. En el workloads de registros operativos de un cliente, la latencia de inserción p90 se redujo un 66 % mientras se gestionaba más del triple de volumen de trabajos.⁵
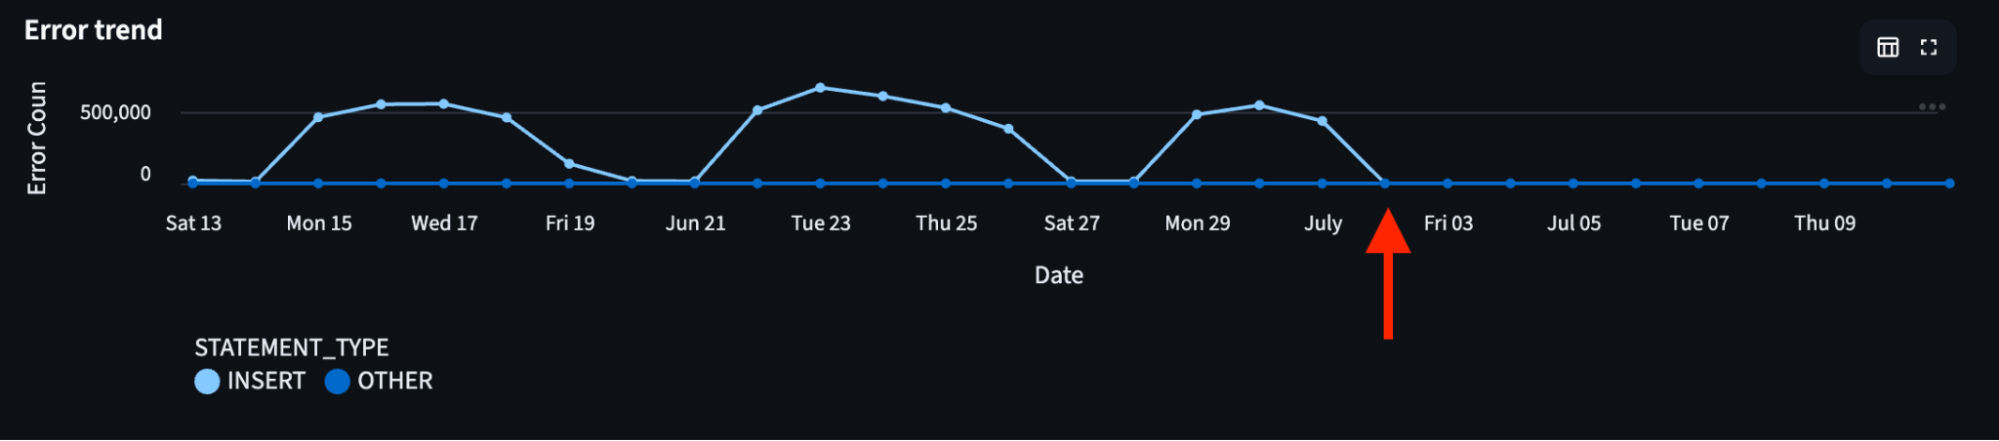
Writer, una plataforma empresarial de IA, escribe aproximadamente 1,3 millones de registros de seguimiento de modelos de lenguaje de gran tamaño al día en Snowflake para facilitar la observabilidad de los modelos y el control de calidad. En una tabla estándar, la latencia de inserción p50 se disparó y hasta el 45 % de las escrituras fallaron. Writer cambió el destino a una tabla híbrida (básicamente, sustituyó una tabla por otra) y la latencia de inserción p50 se redujo aproximadamente 15 veces. Los errores se redujeron hasta casi desaparecer. Las tablas híbridas absorben las operaciones de escritura, mientras que una tabla estándar agrupada por marca temporal impulsa las analíticas, todo ello en la misma base de datos.
Appriss Retail combate el fraude con datos recientes
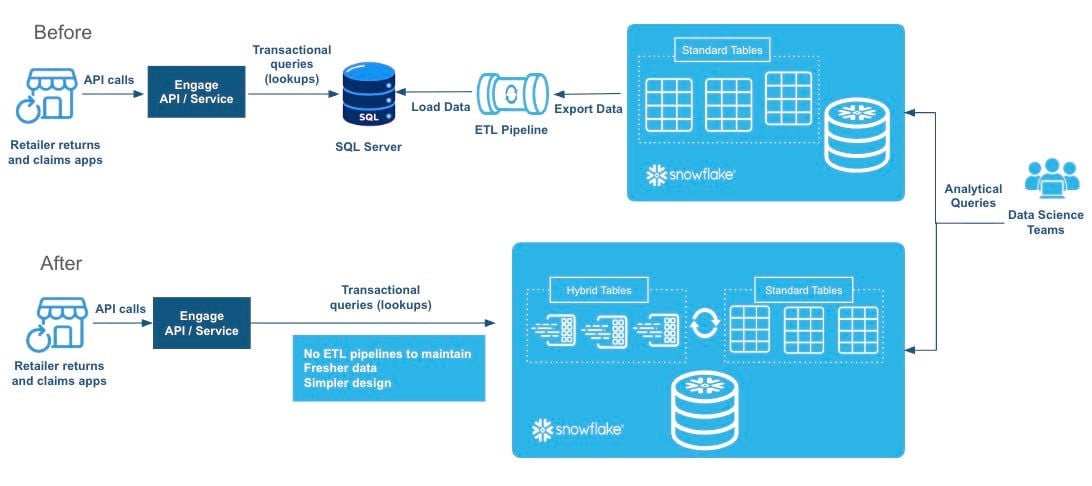
Appriss Retail ayuda a combatir el fraude relacionado con devoluciones y reclamaciones para más de 60 de los 100 principales minoristas estadounidenses, con una precisión del 99,99 %. Cada devolución y reclamación se evalúa en tiempo real. Las compras, devoluciones y reclamaciones de cada cliente se integran en un único perfil. Las señales de riesgo se calculan a partir de ese historial en el momento de la devolución para aprobarla, emitir una advertencia o rechazarla.
Antes de tablas híbridas, esa evaluación dependía de una base de datos SQL Server independiente alimentada por un pipeline personalizado de extracción, transformación y carga (ETL). El tiempo de ingeniería se dedicaba a mantener el pipeline en lugar de mejorar la detección. El movimiento de datos entre sistemas implicaba que las decisiones sobre fraude se tomaran con datos desfasados. Además, la carga de datos ralentizaba la misma base de datos que procesaba devoluciones y reclamaciones en tiempo real.
Ahora, las aplicaciones de devoluciones y reclamaciones de los minoristas realizan consultas directamente en tablas híbridas, mientras que los equipos de ciencia de datos consultan tablas estándar en la misma plataforma. Las consultas de búsqueda se completan rápidamente y las analíticas examinan terabytes de datos, todo en Snowflake. El pipeline personalizado ha desaparecido y las decisiones se toman con los datos en cuanto se generan.
“Ahora, cada devolución y reclamación que procesa nuestro mayor minorista se verifica con tablas híbridas. Son más de un millón de búsquedas al día, sin exportar ningún dato fuera de Snowflake”.
Kenny Vu
VP of Engineering, Appriss Retail
Cómo empezar a utilizar tablas híbridas
Si ya utilizas tablas híbridas, no tienes que hacer nada. Las mejoras están activadas de forma predeterminada.
¿Es la primera vez que utilizas tablas híbridas? Solo necesitas una sentencia para crear una y puedes combinarla de inmediato con tus tablas actuales.
Crea una tabla híbrida para hacer un seguimiento del estado de los trabajos de un pipeline.
CREATE HYBRID TABLE job_state (
  job_id      INT PRIMARY KEY,
  status      VARCHAR,
  updated_at  TIMESTAMP_NTZ,
  INDEX idx_status (status)
);
Escrituras y consultas puntuales rápidas
INSERT INTO job_state VALUES (1001, 'RUNNING', CURRENT_TIMESTAMP());
SELECT status FROM job_state WHERE job_id = 1001;
Combina el estado transaccional con datos analíticos en una sola consulta.
SELECT j.job_id, j.status, r.rows_processed
FROM job_state j
JOIN job_run_metrics r ON j.job_id = r.job_id
WHERE j.status = 'FAILED';
A continuación, consulta un ejemplo completo en la guía quickstart y explora la documentación sobre prácticas recomendadas para tablas híbridas.
¹ Datos basados en pruebas comparativas realizadas con Yahoo Cloud Serving Benchmark, un workload compuesto por un 100 % de lecturas y un almacén XS Gen2.
2 Cálculo derivado de un rendimiento 8 veces mayor en un único almacén XS frente a ocho almacenes XS con una carga equivalente.
3 Datos basados en pruebas comparativas internas para cargar 50 GB en tablas híbridas mediante un almacén 2XL.
4 Datos basados en estimaciones de Snowflake sobre el ahorro medio de costes de los clientes, medido a partir del consumo real de créditos en producción en febrero de 2026.
⁵ Datos basados en observaciones de Snowflake sobre la latencia p50, p90 y p99 de las consultas en workloads de producción de clientes, antes y después de activar el nuevo motor de tablas híbridas en la vista previa pública.