10 nov. 2026/Lecture : 9 minProduit et technologie
Des Hybrid Tables 8 fois plus rapides, automatiquement

En juin, nous avons présenté en preview une nouvelle génération de performance pour les Snowflake Hybrid Tables. Aujourd’hui, l’ensemble de ces améliorations est disponible pour tous nos clients et activé par défaut.
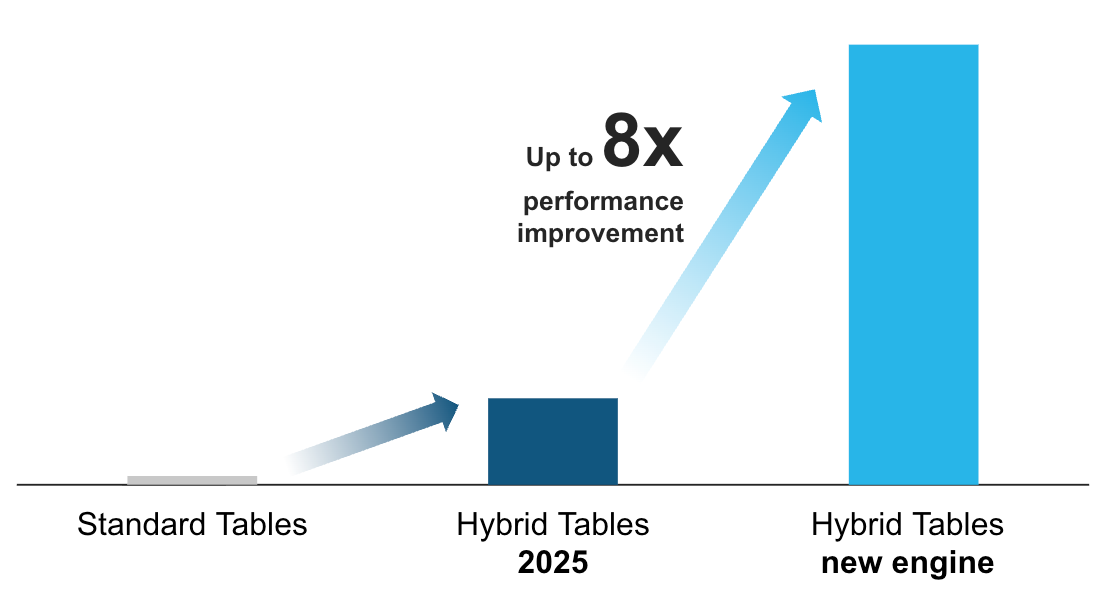
Les Hybrid Tables offrent désormais un débit jusqu’à 8 fois supérieur, une latence p50 3 fois plus faible et une latence p99 2 fois plus faible¹. Pour les milliers de clients qui utilisent déjà les Hybrid Tables, les charges de travail existantes deviennent automatiquement plus rapides et plus économiques. Elles peuvent aussi absorber davantage de volume avec les mêmes ressources de calcul.
Des données transactionnelles sans base de données distincte
Les pipelines, les agents d’intelligence artificielle et les applications internes dépendent tous de lectures et écritures transactionnelles rapides, qu’il s’agisse de suivre l’état des tâches, de stocker le contexte des agents ou d’enregistrer les actions des utilisateurs dans les applications d’entreprise créées avec Streamlit ou Snowflake App Runtime. Trop souvent, il fallait pour cela déployer une base de données opérationnelle distincte, un pipeline pour la synchroniser avec les données analytiques et un deuxième ensemble de contrôles de gouvernance.
À la place, les Hybrid Tables intègrent directement à la base de données Snowflake des lectures et écritures rapides et conformes aux propriétés ACID. Les données transactionnelles et analytiques coexistent dans le même environnement de gouvernance et peuvent être jointes dans une seule requête. Avec cette version, les applications et workflows existants bénéficient d’un meilleur rapport prix-performance, sans aucune refonte d’architecture.
Ce qui est désormais disponible pour tous nos clients avec les Hybrid Tables
Un débit jusqu’à 8 fois supérieur
L’exécution de requêtes à instruction unique pour les opérations ponctuelles répétitives offre désormais un débit jusqu’à 8 fois supérieur¹. Pour certaines charges de travail, un seul warehouse XS suffit donc là où il en fallait auparavant huit, ce qui peut réduire les coûts de calcul de plus de 80 %2.
Une latence réduite, aussi bien à la médiane qu’en queue de distribution
Avec le nouveau moteur Hybrid Tables, les benchmarks montrent une latence p50 3 fois plus faible et une latence p99 2 fois plus faible3. Une médiane plus rapide accélère la réponse à chaque requête. Une queue de distribution resserrée réduit le nombre de requêtes lentes lors des pics de charge, là où les utilisateurs et les systèmes en aval ressentent le plus la différence.
Des chargements en masse plus rapides et plus économiques
Les insertions en masse sont optimisées au niveau du moteur de stockage. Les benchmarks montrent des écritures par batch jusqu’à 10 fois plus rapides, pour un coût 10 fois inférieur, même dans les tables contenant déjà des données3. Les rechargements historiques et les synchronisations à grande échelle, autrefois complexes à orchestrer, s’effectuent désormais avec une simple instruction INSERT.
Une tarification simplifiée
Les Hybrid Tables suivent le modèle de calcul et de stockage que les clients Snowflake connaissent déjà, mais nous avons supprimé l’une de ses dimensions afin de réduire le nombre d’éléments facturés. Les clients ont ainsi constaté une baisse moyenne des coûts de 15 %, et d’au moins 40 % pour les charges de travail à haut débit4.
| Évolution des Hybrid Tables | Résultats |
|---|---|
| Débit supérieur | Jusqu’à 8 fois plus de débit, automatiquement |
| Performances batch accélérées | Chargements en masse jusqu’à 10 fois plus rapides et 10 fois moins chers, sans modifier les workflows |
| Réduction des coûts | Au moins 40 % d’économies |
Comment les clients utilisent les Hybrid Tables
Que vous développiez une application interne, exécutiez un pipeline ou orchestriez des agents d’intelligence artificielle, les charges de travail Hybrid Tables suivent généralement les trois schémas présentés ci-dessous. De nombreuses applications en combinent plusieurs.
État des workflows
Les pipelines, les applications et les agents ont tous besoin d’un espace pour suivre leur état, notamment le statut des tâches, les points de contrôle, les sessions et les résultats intermédiaires. Les équipes ont souvent déployé une base de données externe dans ce seul but. Les Hybrid Tables maintiennent l’état des workflows homogène sur le plan transactionnel, dans la même base de données Snowflake que les données analytiques produites par ces workflows. Les équipes peuvent ainsi interroger les deux ensemble avec une même requête.
Par exemple, MarketWise a remplacé MySQL et DynamoDB pour suivre en temps réel l’état des workflows de ses pipelines de data engineering, réduisant ainsi ses coûts d’infrastructure de 35 % et supprimant les déplacements de données inutiles. Elementum orchestre des agents d’intelligence artificielle, des règles business et des interventions humaines dans des processus en plusieurs étapes sur les Hybrid Tables, avec application des contraintes de clé primaire et de clé étrangère.
Pendant la preview, les charges de travail de suivi de l’état des workflows de certains clients se sont exécutées jusqu’à 5 fois plus vite en p50 et 2,8 fois plus vite en p99. Un client a vu sa latence p90 passer de 21 millisecondes à 5 millisecondes, tout en exécutant 55 % de tâches supplémentaires⁵.
Mise à disposition des données applicatives
Lorsqu’une application ou un agent doit répondre instantanément à une question, par exemple approuver ou non un retour, recommander un produit ou déterminer l’état d’une machine, les Hybrid Tables font de Snowflake la couche de mise à disposition. Les charges de travail de mise à disposition des données sont celles qui profitent le plus de cette version. Pendant la preview, leur latence p50 a été jusqu’à 6,7 fois plus faible et leur latence p99 jusqu’à 6,3 fois plus faible⁵. Les équipes peuvent désormais traiter beaucoup plus de recherches simultanées avec bien moins de ressources de calcul.
Par exemple, Grailed fournit en moins d’une seconde des recommandations de style personnalisées à des millions d’utilisateurs, à partir de résultats de ML précalculés dans les Hybrid Tables, sans base de données de mise à disposition distincte.
Le même schéma convient aux environnements opérationnels exigeants, notamment dans le secteur de l’industrie, la logistique et la supply chain. Les opérateurs doivent connaître en quelques millisecondes l’état actuel d’une tâche, d’une machine ou d’une expédition, tandis que les équipes de planification analysent les mêmes données. Les Hybrid Tables prennent en charge les recherches et les tables standard les jointures à grande échelle, sur une seule plateforme et sans réglage propre à chaque table. Les améliorations de la latence p99 sont particulièrement importantes ici, car une queue de distribution lente peut retarder une ligne de production ou un planning.
Des écritures fiables à forte concurrence
Certaines charges de travail écrivent en continu. Les applications et services enregistrent chaque action utilisateur, appel d’API, invocation de modèle ou transaction sous la forme d’un enregistrement qui doit être stocké de manière fiable. Les tables standard sont conçues pour l’analytique et peuvent subir des conflits de verrouillage en cas d’écritures simultanées intensives. Les Hybrid Tables utilisent un verrouillage au niveau des lignes, conçu précisément pour ce schéma.
Pendant la preview, les charges de travail de journalisation des événements et de capture des enregistrements se sont exécutées jusqu’à 3,4 fois plus vite en p50 et 3,7 fois plus vite en p99. Chez un client, la charge de travail de journal opérationnel a enregistré une baisse de 66 % de la latence p90 des insertions, tout en traitant plus de 3 fois le volume de tâches⁵.
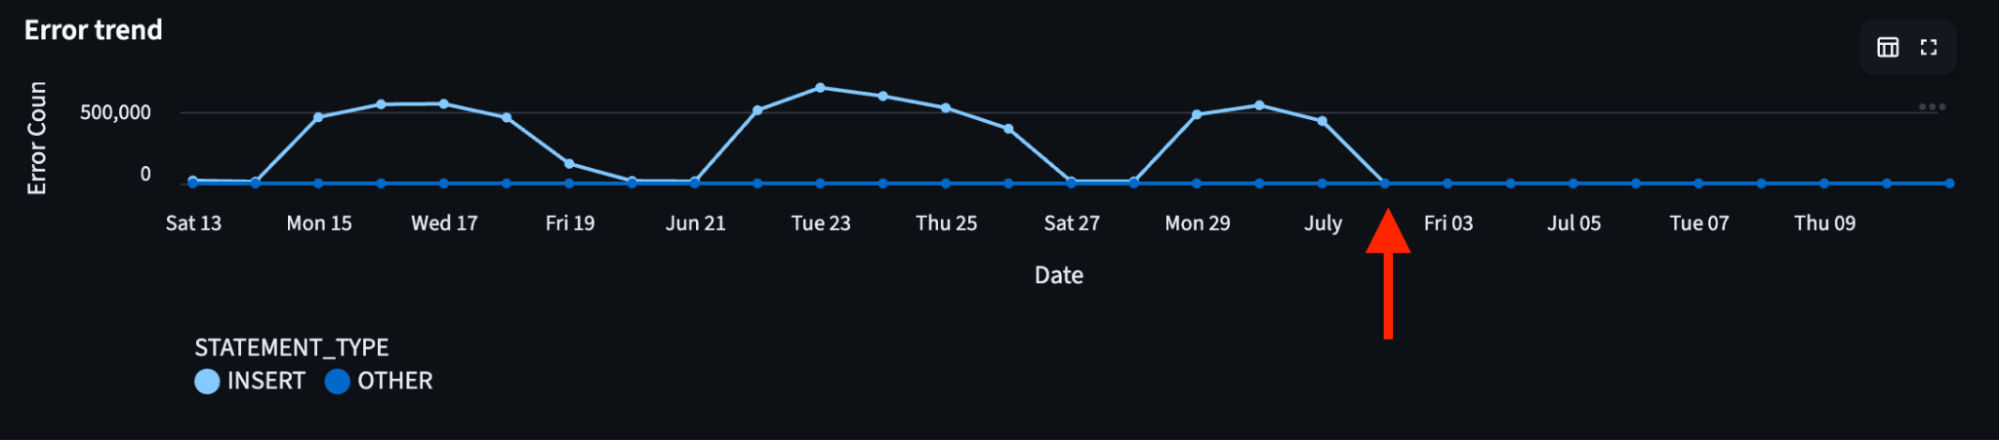
Writer, une plateforme d’intelligence artificielle d’entreprise, écrit chaque jour environ 1,3 million d’enregistrements de traces de LLM dans Snowflake pour assurer l’observabilité des modèles et l’assurance qualité. Sur une table standard, la latence p50 des insertions s’est envolée et jusqu’à 45 % des écritures ont échoué. Writer a remplacé la destination par une table hybride, autrement dit effectué un simple échange de tables, et la latence p50 des insertions a été divisée par environ 15. Le taux d’échec est tombé à presque zéro. Les Hybrid Tables absorbent les écritures, tandis qu’une table standard clusterisée par horodatage alimente les analyses, le tout dans la même base de données.
Appriss Retail lutte contre la fraude grâce à des données actualisées
Appriss Retail contribue à lutter contre la fraude liée aux retours et aux réclamations pour plus de 60 des 100 plus grands distributeurs américains, avec une précision de 99,99 %. Chaque retour et chaque réclamation fait l’objet d’une évaluation en temps réel. Les achats, retours et réclamations de chaque client sont regroupés dans un profil unique. Les signaux de risque sont calculés à partir de cet historique au moment du retour afin de l’approuver, d’émettre un avertissement ou de le refuser.
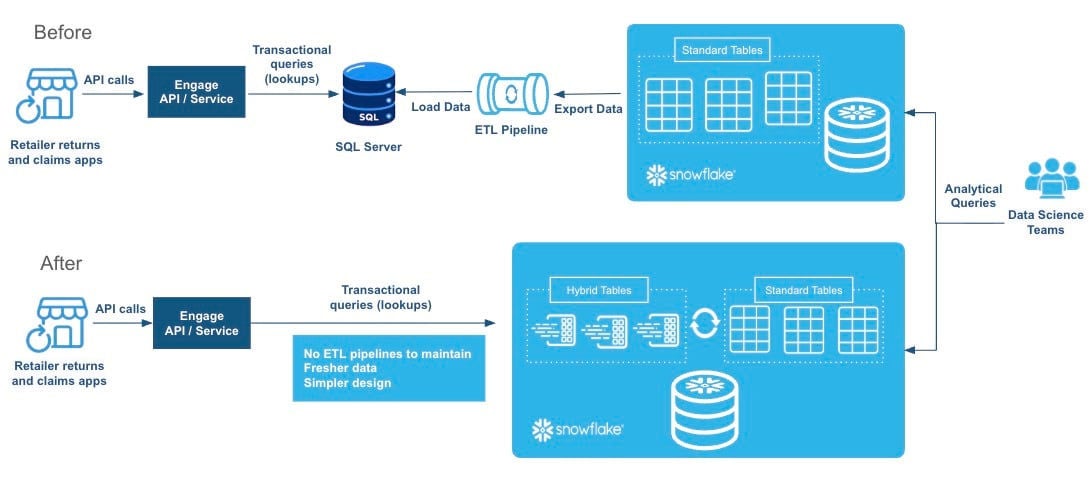
Avant les Hybrid Tables, cette évaluation reposait sur une base de données SQL Server distincte, alimentée par un pipeline ETL personnalisé. Les équipes d’ingénierie consacraient leur temps à la maintenance du pipeline plutôt qu’à l’amélioration de la détection. Le transfert des données entre les systèmes retardait les décisions relatives à la fraude. De plus, le chargement des données ralentissait la base de données qui traitait en direct les retours et les réclamations.
Désormais, les applications de retours et de réclamations des retailers effectuent leurs recherches directement dans les Hybrid Tables, tandis que les équipes de data science exécutent leurs requêtes sur des tables standard au sein de la même plateforme. Les recherches s’exécutent rapidement et les analyses parcourent des téraoctets de données, le tout dans Snowflake. Le pipeline personnalisé a disparu et les décisions reposent sur les données dès leur génération.
« Chaque retour et chaque réclamation traités par notre plus grand distributeur sont désormais vérifiés à l’aide de tables hybrides. Cela représente plus d’un million de recherches par jour, sans qu’aucune donnée ne soit exportée de Snowflake pour effectuer ces vérifications. »
Kenny Vu
VP of Engineering, Appriss Retail
Bien démarrer avec les Hybrid Tables
Si vous utilisez déjà les Hybrid Tables, vous n’avez rien à faire. Les améliorations sont activées par défaut.
Vous découvrez les Hybrid Tables ? Une seule instruction suffit pour en créer une, et vous pouvez immédiatement la joindre à vos tables existantes.
Créer une table hybride pour suivre l’état des tâches d’un pipeline
CREATE HYBRID TABLE job_state (
  job_id      INT PRIMARY KEY,
  status      VARCHAR,
  updated_at  TIMESTAMP_NTZ,
  INDEX idx_status (status)
);
Écritures ponctuelles et recherches rapides
INSERT INTO job_state VALUES (1001, 'RUNNING', CURRENT_TIMESTAMP());
SELECT status FROM job_state WHERE job_id = 1001;
Joindre l’état transactionnel aux données analytiques dans une seule requête
SELECT j.job_id, j.status, r.rows_processed
FROM job_state j
JOIN job_run_metrics r ON j.job_id = r.job_id
WHERE j.status = 'FAILED';
Découvrez ensuite un exemple complet dans le guide Quickstart, puis consultez la documentation consacrée aux bonnes pratiques des Hybrid Tables.
¹ Données issues de benchmarks réalisés avec Yahoo Cloud Serving Benchmark sur une charge de travail composée à 100 % de lectures, dans un warehouse Gen2 XS.
2 Calcul effectué à partir d’un débit 8 fois supérieur sur un seul warehouse XS, par rapport à huit warehouses XS soumis à une charge équivalente.
3 Données issues de benchmarks internes portant sur le chargement de 50 Go dans des Hybrid Tables avec un warehouse 2XL.
4 Données fondées sur les estimations de Snowflake concernant les économies moyennes réalisées par les clients, mesurées à partir de la consommation réelle de crédits en production en février 2026.
⁵ Données issues des observations de Snowflake concernant les latences p50, p90 et p99 des requêtes exécutées sur les charges de travail de production des clients, avant et après l’activation du nouveau moteur Hybrid Tables pendant la public preview.

