10. Nov. 2026/Lesezeit: 7 MinutenProdukt & Technologie
Hybrid Tables sind jetzt automatisch bis zu 8-mal schneller
Im Juni haben wir eine neue Generation der Performance von Snowflake Hybrid Tables in Preview vorgestellt. Heute sind diese Verbesserungen allgemein verfügbar und standardmäßig aktiviert.
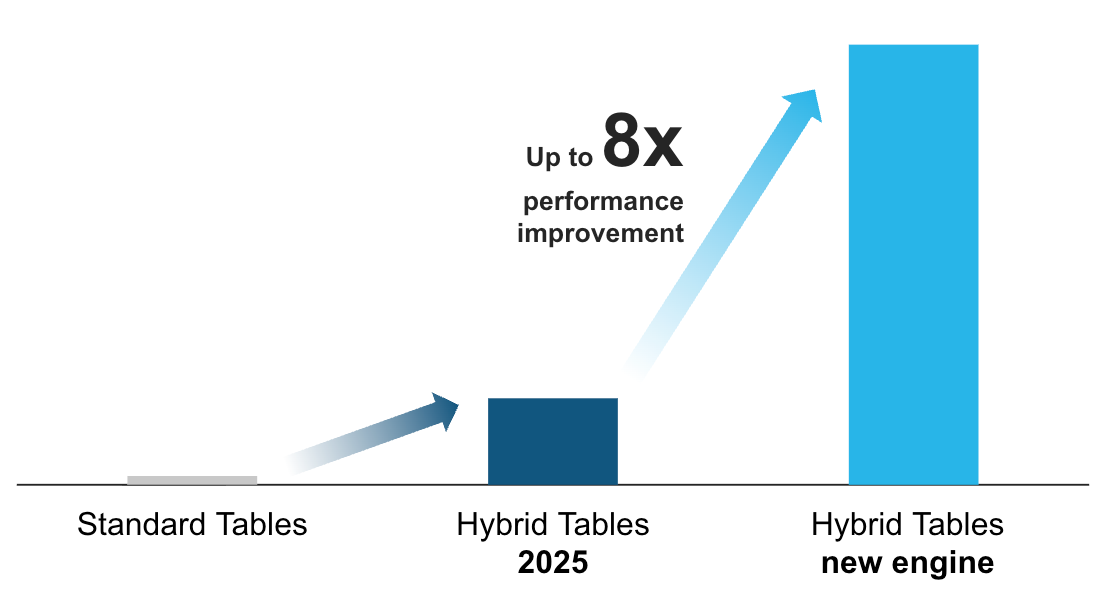
Hybrid Tables bieten jetzt einen bis zu 8-mal höheren Durchsatz, eine 3-mal geringere p50-Latenz und eine 2-mal geringere p99-Latenz.¹ Für die Tausenden von Kund:innen, die bereits Hybrid Tables nutzen, werden ihre bestehenden Workloads automatisch schneller und günstiger, mit Spielraum für die Verarbeitung von mehr Volumen auf derselben Rechenressource.
Transaktionale Daten ohne separate Datenbank
Pipelines, KI-Agenten und interne Apps sind alle auf schnelle transaktionale Lese- und Schreibvorgänge angewiesen, sei es, um den Jobstatus zu verfolgen, den Agentenkontext zu speichern oder aufzuzeichnen, was Nutzer:innen in Unternehmens-Apps tun, die mit Streamlit oder der Snowflake App Runtime erstellt wurden. Zu oft bedeutete dies die Einrichtung einer separaten operativen Datenbank, einer Pipeline, um sie mit Analytics synchron zu halten, und eines zweiten Satzes von Governance-Kontrollen.
Hybrid Tables bringen stattdessen schnelle, ACID-konforme Lese- und Schreibvorgänge in die Snowflake-Datenbank. Transaktionale und analytische Daten leben zusammen unter demselben Governance-Framework und können in einer einzigen Abfrage verknüpft werden. Und mit diesem Release erhalten bestehende Apps und Workflows eine bessere Preis-Performance, ohne dass etwas neu architektoniert werden muss.
Was heute mit Hybrid Tables allgemein verfügbar ist
Bis zu 8-mal höherer Durchsatz
Die Ausführung von Single-Statement-Abfragen für repetitive Punktoperationen liefert jetzt einen bis zu 8-mal höheren Durchsatz.¹ Das bedeutet für bestimmte Workloads, dass das, was früher acht XS-Warehouses erforderte, jetzt nur noch eines benötigt, was die Kosten für Rechenressourcen um mehr als 80 % senken kann.2
Geringere Latenz beim Median und am Ende
Mit der neuen Hybrid Tables-Engine zeigen Benchmark-Ergebnisse, dass die p50-Latenz 3-mal geringer und die p99-Latenz 2-mal geringer ist.3 Ein schnellerer Median bedeutet schnellere Antworten auf jede Anfrage. Ein engeres Ende bedeutet weniger langsame Anfragen bei Spitzenlast, was Nutzer:innen und nachgelagerte Systeme am meisten spüren.
Schnellere, kostengünstigere Bulk-Loads
Bulk-Inserts sind auf der Ebene der Storage-Engine optimiert, wobei Benchmark-Ergebnisse bis zu 10-mal schnellere Batch-Schreibvorgänge bei 10-mal geringeren Kosten zeigen, selbst bei Tabellen mit bestehenden Daten.3 Backfills und große Synchronisierungen, die früher eine sorgfältige Orchestrierung erforderten, funktionieren jetzt mit einem einfachen INSERT.
Einfachere Preisgestaltung
Hybrid Tables folgen demselben Modell für Rechenressourcen und Speicher, das Snowflake-Kund:innen bereits kennen, aber wir haben eine der Dimensionen entfernt, sodass Ihnen weniger Dinge in Rechnung gestellt werden. Jetzt haben Kund:innen gesehen, dass die Kosten im Durchschnitt um 15 % und bei Workloads mit hohem Durchsatz um 40 % oder mehr gesenkt wurden.4
| Entwicklung von Hybrid Tables | Die Ergebnisse |
|---|---|
| Höherer Durchsatz | Bis zu 8-mal mehr Durchsatz, automatisch angewendet |
| Schnellere Batch-Performance | Bis zu 10-mal schnellere, 10-mal günstigere Bulk-Loads ohne Workflow-Änderungen |
| Kostensenkung | 40 % oder mehr Kosteneinsparungen |
Wo Kund:innen Hybrid Tables nutzen
Egal, ob Sie eine interne App erstellen, eine Pipeline ausführen oder KI-Agenten orchestrieren, Hybrid Tables-Workloads folgen typischerweise den drei unten besprochenen Mustern. Viele Apps kombinieren mehr als eines.
Workflow-Status
Pipelines, Apps und Agenten benötigen alle einen Ort, um den Status zu verfolgen, einschließlich Jobstatus, Checkpoints, Sitzungen und Zwischenergebnissen. Teams haben oft eine externe Datenbank nur dafür betrieben. Hybrid Tables halten den Workflow-Status transaktional konsistent, in derselben Snowflake-Datenbank wie die analytischen Daten, die diese Workflows produzieren, sodass Teams beides zusammen abfragen können.
Zum Beispiel ersetzte MarketWise MySQL und DynamoDB, um den Workflow-Status seiner Data Engineering-Pipelines in Echtzeit zu verfolgen, was die Infrastrukturkosten um 35 % senkte und unnötige Datenverschiebungen eliminierte. Elementum orchestriert KI-Agenten, Geschäftsregeln und menschliche Schritte in mehrstufigen Prozessen auf Hybrid Tables, mit erzwungenen Primärschlüssel- und Fremdschlüssel-Constraints.
In Preview haben wir gesehen, dass die Workflow-Status-Workloads von Kund:innen bei p50 bis zu 5-mal schneller und bei p99 2,8-mal schneller ausgeführt werden. Ein:e Kund:in sah, wie die p90-Latenz von 21 Millisekunden auf 5 Millisekunden sank, während 55 % mehr Jobs ausgeführt wurden.⁵
Bereitstellung von Applikationsdaten
Wenn eine App oder ein Agent eine Frage sofort beantworten muss, z. B. ob eine Rücksendung genehmigt werden soll, welches Produkt empfohlen werden soll oder in welchem Zustand sich eine Maschine befindet, machen Hybrid Tables Snowflake zur Serving-Tier. Data-Serving-Workloads profitieren am meisten von diesem Release. In Preview sahen sie eine bis zu 6,7-mal geringere p50-Latenz und eine 6,3-mal geringere p99-Latenz.⁵ Jetzt bedienen Teams weitaus mehr gleichzeitige Lookups mit weitaus weniger Rechenressourcen.
Zum Beispiel liefert Grailed personalisierte Stilempfehlungen in Sekundenbruchteilen an Millionen von Nutzer:innen aus vorberechneten ML-Ergebnissen in Hybrid Tables, ohne separate Serving-Datenbank.
Dasselbe Muster passt zu anspruchsvollen operativen Umgebungen wie Fertigung, Logistik und Supply Chain. Bediener:innen benötigen Millisekunden-Lookups zum aktuellen Status eines Jobs, einer Maschine oder einer Sendung, während Planer:innen Analytics auf denselben Daten ausführen. Hybrid Tables bedienen die Lookups, und Standardtabellen verarbeiten groß angelegte Joins, beides auf einer Plattform ohne Anpassung pro Tabelle. Die p99-Verbesserungen sind hier am wichtigsten, wo ein langsames Ende eine Linie oder einen Zeitplan blockieren kann.
Zuverlässige Schreibvorgänge mit hoher Parallelität
Einige Workloads schreiben ständig. Apps und Services erfassen jede Benutzeraktion, jeden API-Aufruf, jeden Modellaufruf oder jede Transaktion als Datensatz, der zuverlässig landen muss. Standardtabellen sind für Analytics konzipiert und können bei starken gleichzeitigen Schreibvorgängen auf Sperrkonflikte stoßen. Hybrid Tables verwenden Row-Level-Locking, das genau für dieses Muster entwickelt wurde.
In Preview liefen Event-Log- und Record-Capture-Workloads bei p50 bis zu 3,4-mal schneller und bei p99 3,7-mal schneller. Der Operational-Log-Workload eines:einer Kund:in verzeichnete einen Rückgang der p90-Insert-Latenz um 66 %, während mehr als das Dreifache des Jobvolumens verarbeitet wurde.⁵
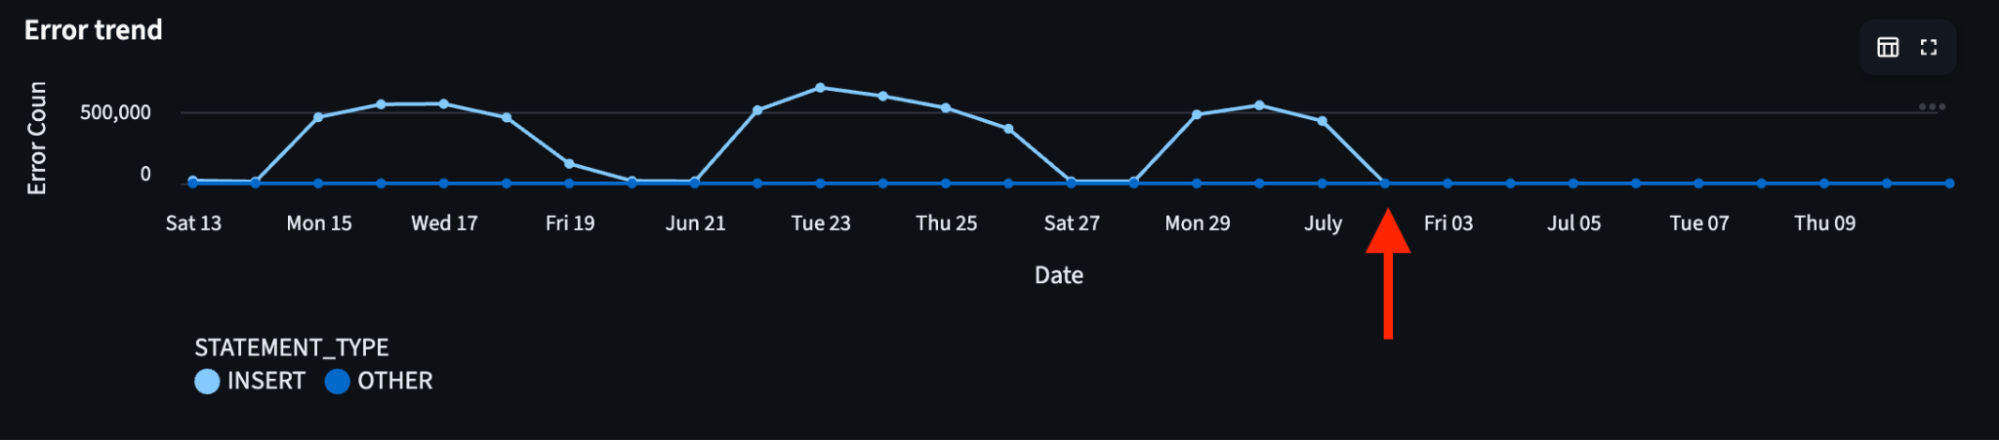
Writer, eine Enterprise-KI-Plattform, schreibt täglich etwa 1,3 Millionen LLM-Trace-Datensätze in Snowflake, um Modell-Observability und QA zu unterstützen. Auf einer Standardtabelle stieg die p50-Insert-Latenz sprunghaft an, und bis zu 45 % der Schreibvorgänge schlugen fehl. Writer änderte das Ziel auf eine Hybrid Table, im Wesentlichen ein Tabellentausch, und die p50-Insert-Latenz sank um das etwa 15-Fache. Die Ausfälle fielen auf fast null. Hybrid Tables absorbieren die Schreibvorgänge, während eine nach Zeitstempel geclusterte Standardtabelle Analytics antreibt, alles in derselben Datenbank.
Appriss Retail stoppt Betrug mit frischen Daten
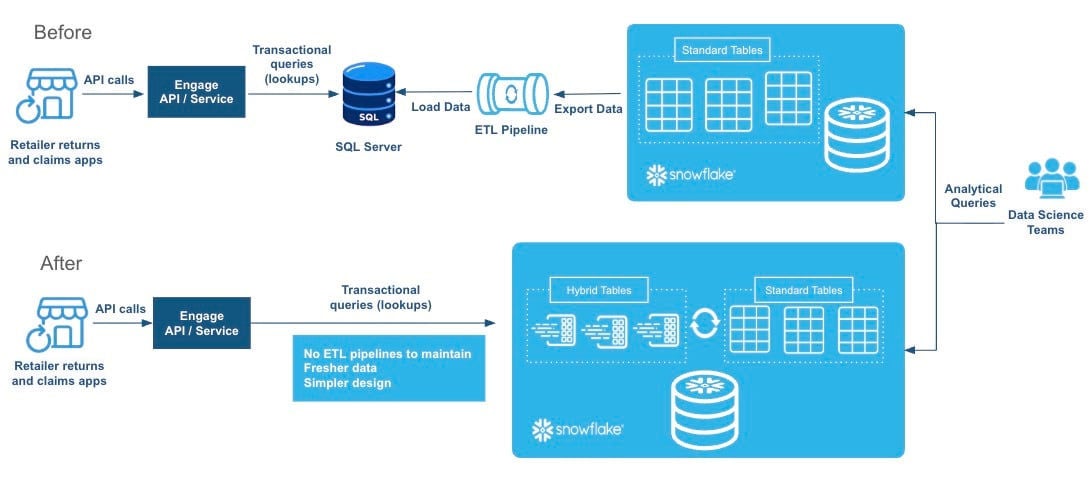
Appriss Retail hilft, Betrug im Zusammenhang mit Rücksendungen und Reklamationen für mehr als 60 der Top-100-US-Händler mit einer Genauigkeit von 99,99 % zu stoppen. Jede Rücksendung und Reklamation wird in Echtzeit bewertet. Die Käufe, Rücksendungen und Reklamationen jedes:jeder Käufer:in werden in einem einzigen Profil zusammengefasst. Risikosignale werden aus dieser Historie im Moment der Rücksendung berechnet, um sie zu genehmigen, zu warnen oder abzulehnen.
Vor Hybrid Tables hing dieses Scoring von einer separaten SQL Server-Datenbank ab, die von einer benutzerdefinierten ETL-Pipeline gespeist wurde. Engineering-Zeit floss in die Wartung der Pipeline anstatt in die Verbesserung der Erkennung. Das Verschieben von Daten zwischen Systemen bedeutete, dass Betrugsentscheidungen auf verzögerten Daten basierten. Und das Laden von Daten verlangsamte dieselbe Datenbank, die Live-Rücksendungen und -Reklamationen bediente.
Jetzt führen die Rücksendungs- und Reklamations-Apps der Händler Lookups direkt gegen Hybrid Tables aus, während Data Science-Teams Standardtabellen auf derselben Plattform abfragen. Lookups werden schnell abgeschlossen, und Analytics scannen Terabytes an Daten, alles in Snowflake. Die benutzerdefinierte Pipeline ist weg, und Entscheidungen laufen auf Daten in dem Moment, in dem sie generiert werden.
"Every return and claim our biggest retailer processes is now checked against Hybrid Tables. That’s more than a million lookups a day, with no data exported out of Snowflake to do it."
Kenny Vu
VP of Engineering, Appriss Retail
Erste Schritte mit Hybrid Tables
Wenn Sie bereits Hybrid Tables verwenden, müssen Sie nichts tun. Die Verbesserungen sind standardmäßig aktiviert.
Neu bei Hybrid Tables? Das Erstellen einer solchen erfordert ein einziges Statement, und Sie können sie sofort mit Ihren bestehenden Tabellen verknüpfen.
Erstellen Sie eine Hybrid Table, um den Status von Pipeline-Jobs zu verfolgen
CREATE HYBRID TABLE job_state (
  job_id      INT PRIMARY KEY,
  status      VARCHAR,
  updated_at  TIMESTAMP_NTZ,
  INDEX idx_status (status)
);
Schnelle Punkt-Schreibvorgänge und Lookups
INSERT INTO job_state VALUES (1001, 'RUNNING', CURRENT_TIMESTAMP());
SELECT status FROM job_state WHERE job_id = 1001;
Verknüpfen Sie den transaktionalen Status mit analytischen Daten in einer Abfrage
SELECT j.job_id, j.status, r.rows_processed
FROM job_state j
JOIN job_run_metrics r ON j.job_id = r.job_id
WHERE j.status = 'FAILED';
Gehen Sie von dort aus ein vollständiges Beispiel mit dem Quickstart Guide durch und erkunden Sie die Dokumentation für Best Practices für Hybrid Tables.
¹ Daten basieren auf Benchmarks, die mit dem Yahoo Cloud Serving Benchmark mit einem 100%igen Lese-Workload auf einem Gen2 XS-Warehouse durchgeführt wurden.
2 Abgeleitet von 8-fachem Durchsatz auf einem einzelnen XS-Warehouse im Vergleich zu acht XS-Warehouses bei gleicher Last.
3 Daten basieren auf internen Benchmarks für das Laden von 50 GB in Hybrid Tables unter Verwendung eines 2XL-Warehouses.
4 Daten basieren auf Snowflake-Schätzungen der durchschnittlichen Kosteneinsparungen bei Kund:innen, gemessen am realen Produktions-Credit-Verbrauch im Februar 2026.
⁵ Daten basieren auf Snowflake-Beobachtungen der p50-, p90- und p99-Abfragelatenz für Produktions-Workloads von Kund:innen vor und nach der Aktivierung der neuen Hybrid Tables-Engine während der Public Preview.