6月に、次世代のSnowflake Hybrid Tableのパフォーマンスをプレビューしました。本日、これらの改善が一般提供され、デフォルトで有効になりました。
ハイブリッドテーブルは現在、最大8倍のスループット向上、3倍のp50レイテンシー削減、2倍のp99レイテンシー削減を実現しています。¹ すでにハイブリッドテーブルを実行している何千ものお客様にとって、既存のワークロードは自動的に高速化および低コスト化され、同じコンピュートでより多くのボリュームを処理する余裕が生まれます。
個別のデータベースなしでトランザクションデータを処理
パイプライン、AIエージェント、社内アプリはすべて、ジョブの状態の追跡、エージェントのコンテキストの保存、StreamlitやSnowflakeアプリランタイムで構築されたエンタープライズアプリでのユーザーの操作の記録など、高速なトランザクションの読み取りと書き込みに依存しています。多くの場合、これは個別の運用データベース、アナリティクスと同期させるためのパイプライン、および2つ目のガバナンス制御セットを立ち上げることを意味していました。
代わりに、ハイブリッドテーブルは、高速でACID準拠の読み取りと書き込みをSnowflakeデータベースにもたらします。トランザクションデータと分析データは同じガバナンスフレームワークの下に共存し、単一のクエリで結合できます。そして今回のリリースにより、既存のアプリとワークフローは、再設計することなく、より優れた価格性能比を実現します。
ハイブリッドテーブルで本日一般提供される機能
最大8倍のスループット向上
反復的なポイント操作の単一ステートメントのクエリ実行により、最大8倍のスループットが実現します。¹ これは、特定のワークロードにおいて、以前は8つのXSウェアハウスを必要としていたものが1つで済むようになり、コンピュートコストを80%以上削減できることを意味します。2

中央値とテールでのレイテンシーの低下
新しいハイブリッドテーブルエンジンにより、ベンチマーク結果はp50レイテンシーが3倍低く、p99レイテンシーが2倍低いことを示しています。3 中央値が速いということは、すべてのリクエストに対する応答が速いことを意味します。テールが狭いということは、ピーク負荷時に遅いリクエストが少なくなることを意味し、これはユーザーやダウンストリームシステムが最も実感する部分です。
より高速で費用対効果の高い一括ロード
一括挿入はストレージエンジンレベルで最適化されており、ベンチマーク結果では、既存のデータがあるテーブルでも、最大10倍高速なバッチ書き込みを10分の1のコストで実証しています。3 かつては慎重なオーケストレーションが必要だったバックフィルや大規模な同期が、単純なINSERTで機能するようになりました。
よりシンプルな価格設定
ハイブリッドテーブルは、Snowflakeのお客様がすでに知っているのと同じコンピュートとストレージのモデルに従いますが、ディメンションの1つを削除したため、請求される項目が少なくなります。現在、お客様のコストは平均で15%、高スループットのワークロードでは40%以上削減されています。4
| ハイブリッドテーブルの進化 | 結果 |
|---|---|
| スループットの向上 | 最大8倍のスループット向上、自動的に適用 |
| バッチパフォーマンスの向上 | ワークフローの変更なしで、最大10倍高速、10分の1のコストでの一括ロード |
| コスト削減 | 40%以上のコスト削減 |
お客様がハイブリッドテーブルを使用する場所
社内アプリの構築、パイプラインの実行、AIエージェントのオーケストレーションのいずれであっても、ハイブリッドテーブルのワークロードは通常、以下で説明する3つのパターンに従います。多くのアプリは複数を組み合わせています。
ワークフローの状態
パイプライン、アプリ、エージェントはすべて、ジョブのステータス、チェックポイント、セッション、中間結果などの状態を追跡する場所を必要とします。チームは多くの場合、このためだけに外部データベースを実行してきました。ハイブリッドテーブルは、ワークフローの状態をトランザクション的に一貫して、それらのワークフローが生成する分析データと同じSnowflakeデータベースに保持するため、チームは両方を一緒にクエリできます。
たとえば、MarketWiseはMySQLとDynamoDBを置き換えて、データエンジニアリングパイプラインのワークフローの状態をリアルタイムで追跡し、インフラストラクチャコストを35%削減し、不要なデータ移動を排除しました。 Elementumは、ハイブリッドテーブル上のマルチステッププロセスで、AIエージェント、ビジネスルール、および人間のステップをオーケストレーションし、主キーと外部キーの制約を適用します。
プレビューでは、お客様のワークフロー状態のワークロードがp50で最大5倍、p99で最大2.8倍高速に実行されるのを確認しました。あるお客様は、ジョブを55%多く実行しながら、p90レイテンシーが21ミリ秒から5ミリ秒に低下しました。⁵
アプリケーションデータの提供
アプリやエージェントが、返品を承認するかどうか、どのプロダクトを推奨するか、マシンの状態はどうかなど、質問に即座に答える必要がある場合、ハイブリッドテーブルはSnowflakeを提供層に変えます。データ提供ワークロードは、このリリースから最大の利益を得ます。プレビューでは、p50レイテンシーが最大6.7倍、p99レイテンシーが最大6.3倍低下しました。⁵ 現在、チームははるかに少ないコンピュートで、はるかに多くの同時ルックアップを提供しています。
たとえば、Grailedは、個別の提供データベースなしで、ハイブリッドテーブルの事前計算されたML結果から、数百万人のユーザーに1秒未満のパーソナライズされたスタイルの推奨事項を提供します。
同じパターンは、製造、物流、サプライチェーンなどの厳しい運用環境にも適合します。オペレーターは、ジョブ、マシン、または出荷の現在の状態についてミリ秒単位のルックアップを必要としますが、プランナーは同じデータでアナリティクスを実行します。ハイブリッドテーブルはルックアップを提供し、標準テーブルは大規模な結合を処理します。どちらも、テーブルごとのチューニングなしで1つのプラットフォーム上で実行されます。遅いテールがラインやスケジュールを停止させる可能性があるここでは、p99の改善が最も重要です。
信頼性の高い高同時実行性の書き込み
一部のワークロードは常に書き込みを行います。アプリとサービスは、すべてのユーザーアクション、API呼び出し、モデル呼び出し、またはトランザクションを、確実に着地させる必要があるレコードとしてキャプチャします。標準テーブルはアナリティクス用に構築されており、同時書き込みが激しいとロックの競合が発生する可能性があります。ハイブリッドテーブルは、まさにこのパターンのために設計された行レベルのロックを使用します。
プレビューでは、イベントログとレコードキャプチャのワークロードは、p50で最大3.4倍、p99で最大3.7倍高速に実行されました。あるお客様の運用ログワークロードでは、ジョブボリュームの3倍以上を処理しながら、p90の挿入レイテンシーが66%低下しました。⁵
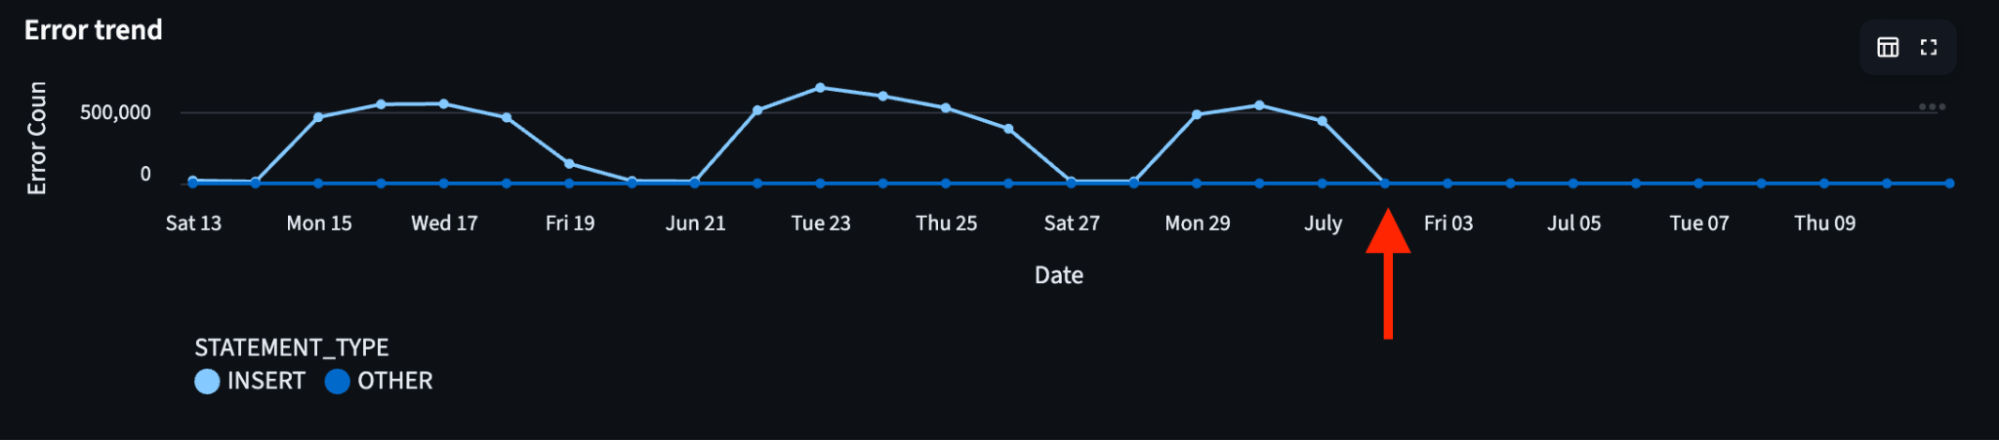
エンタープライズAIプラットフォームであるWriterは、モデルのオブザーバビリティとQAを強化するために、1日に約130万件のLLMトレースレコードをSnowflakeに書き込みます。標準テーブルでは、p50の挿入レイテンシーが急上昇し、最大45%の書き込みが失敗しました。Writerは宛先をハイブリッドテーブルに切り替えました。これは実質的にテーブルの交換であり、p50の挿入レイテンシーは約15分の1に低下しました。障害はほぼゼロに減少しました。ハイブリッドテーブルは書き込みを吸収し、タイムスタンプでクラスタリングされた標準テーブルはアナリティクスを強化します。これらはすべて同じデータベース内にあります。
Appriss Retailは最新のデータを使用して不正行為を阻止
Appriss Retailは、米国のトップ100の小売企業のうち60社以上について、返品やクレームに関連する不正行為を99.99%の精度で阻止するのに役立ちます。すべての返品とクレームはリアルタイムでスコアリングされます。各買い物客の購入、返品、クレームは、単一のプロファイルに照合されます。リスクシグナルは、返品の瞬間にその履歴から計算され、承認、警告、または拒否されます。
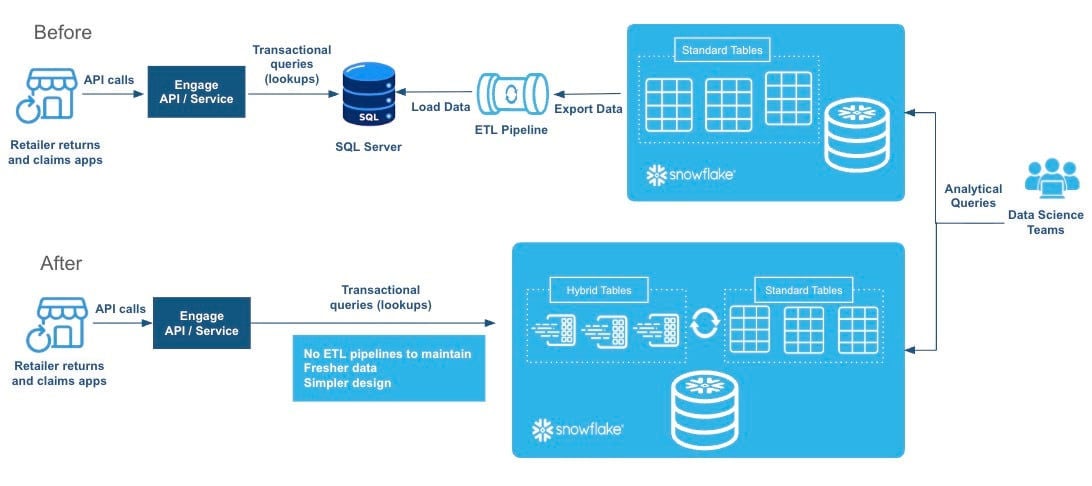
ハイブリッドテーブルの導入前は、そのスコアリングは、カスタムETLパイプラインによって供給される個別のSQL Serverデータベースに依存していました。エンジニアリングの時間は、検出の改善ではなく、パイプラインの維持に費やされました。システム間でデータを移動することは、不正行為の決定が遅延したデータで実行されることを意味しました。また、データをロードすると、ライブの返品やクレームを提供する同じデータベースの速度が低下しました。
現在、小売企業の返品およびクレームアプリはハイブリッドテーブルに対して直接ルックアップを実行し、データサイエンスチームは同じプラットフォーム上の標準テーブルをクエリします。ルックアップは迅速に完了し、アナリティクスはテラバイトのデータをスキャンします。これらはすべてSnowflakeで行われます。カスタムパイプラインはなくなり、決定はデータが生成された瞬間に実行されます。
"当社最大の小売クライアントが処理するすべての返品およびクレームは、現在ハイブリッドテーブルと照合されています。そのルックアップ回数は1日あたり100万件を超えますが、その処理のためにSnowflakeの外部へデータをエクスポートすることは一切行われていません。"
Kenny Vu
VP of Engineering, Appriss Retail
ハイブリッドテーブルの使用を開始する方法
すでにハイブリッドテーブルを使用している場合は、何もする必要はありません。改善はデフォルトで有効になっています。
ハイブリッドテーブルは初めてですか?作成には単一のステートメントが必要であり、既存のテーブルとすぐに結合できます。
パイプラインジョブの状態を追跡するためのハイブリッドテーブルを作成する
CREATE HYBRID TABLE job_state (
  job_id      INT PRIMARY KEY,
  status      VARCHAR,
  updated_at  TIMESTAMP_NTZ,
  INDEX idx_status (status)
);
高速なポイント書き込みとルックアップ
INSERT INTO job_state VALUES (1001, 'RUNNING', CURRENT_TIMESTAMP());
SELECT status FROM job_state WHERE job_id = 1001;
1つのクエリでトランザクション状態と分析データを結合する
SELECT j.job_id, j.status, r.rows_processed
FROM job_state j
JOIN job_run_metrics r ON j.job_id = r.job_id
WHERE j.status = 'FAILED';
そこから、クイックスタートガイドで完全な例を確認し、ハイブリッドテーブルのベストプラクティスのドキュメントを調べてください。
¹ Gen2 XSウェアハウスで100%の読み取りワークロードを使用してYahoo Cloud Serving Benchmarkを実行したベンチマークに基づくデータ。
2 同等の負荷での8つのXSウェアハウスに対する単一のXSウェアハウスでの8倍のスループットから導出。
3 2XLウェアハウスを使用してハイブリッドテーブルに50 GBをロードするための内部ベンチマークに基づくデータ。
4 2026年2月の実際の運用クレジット消費量で測定された、お客様全体の平均コスト削減のSnowflakeの推定に基づくデータ。
⁵ パブリックプレビュー中に新しいハイブリッドテーブルエンジンを有効にする前後の、お客様の運用ワークロードのp50、p90、およびp99クエリレイテンシーのSnowflakeの観察に基づくデータ。