25 settembre 2026/Lettura: 6 minProdotto e tecnologia
I customer journey di Capital One: osservabilità dall’impatto sul business alla causa principale
Un incidente inizia con dei sintomi: un picco di errori 500, un peggioramento della latenza o un calo delle conversioni, ad esempio. Le prime domande arrivano velocemente: cosa ha smesso di funzionare, e qual è l’impatto sui clienti?
L’osservabilità tradizionale inizia dal livello del servizio, non dall’impatto sul cliente. Le dashboard diventano rosse, gli alert si attivano e i team lavorano partendo dai segnali dell’infrastruttura e delle applicazioni per stimare contemporaneamente l’impatto sui clienti e isolare la causa principale. Questa traduzione dai segnali infrastrutturali all’impatto sul business dipende spesso dalla conoscenza istituzionale: Quali servizi alimentano il checkout o si trovano dietro il riepilogo dell’account? Per rispondere a una semplice domanda dei dirigenti come “quante persone non possono accedere?”, un team deve riunirsi in una breakout room per stimare l’impatto, per poi riconciliare tale stima durante il post mortem.
Capital One affronta direttamente questa lacuna nel suo blog post "Observability with Automated Customer Journey Graphs.” Il suo approccio ribalta l’indagine: Si parte dal livello delle interazioni con il cliente, per poi scendere nei livelli di servizio e infrastruttura. Quando un’indagine inizia con l’interazione di business già definita, l’impatto è chiaro e il percorso verso la mitigazione e la causa principale diventa l’unico obiettivo.
Per farlo, Capital One ha creato grafi di customer journey in cui i nodi rappresentano le interazioni con i clienti e gli archi mostrano come gli utenti si muovono lungo l’esperienza. I segnali di stato e il traffico vengono sovrapposti al grafo, trasformandolo in una superficie operativa per aggregare l’impatto prima di analizzare i dettagli a livello di servizio.
Capital One ha implementato questo approccio in Observe by Snowflake utilizzando la telemetria acquisita nel data lake di Observe, inclusi i log di real user monitoring (RUM), i dati di clickstream e i log di accesso alle API. In Observe, Capital One ha modellato e arricchito i dati con interazioni e servizi dopo l’ingestion, senza strumentazione a livello applicativo. Questo contesto di business viene definito una sola volta e applicato automaticamente per il consumo e la collaborazione da parte di qualsiasi persona coinvolta nel troubleshooting.
Il workflow journey-first in pratica: esempio ecommerce
Fase 1: partire dall’interazione con il cliente
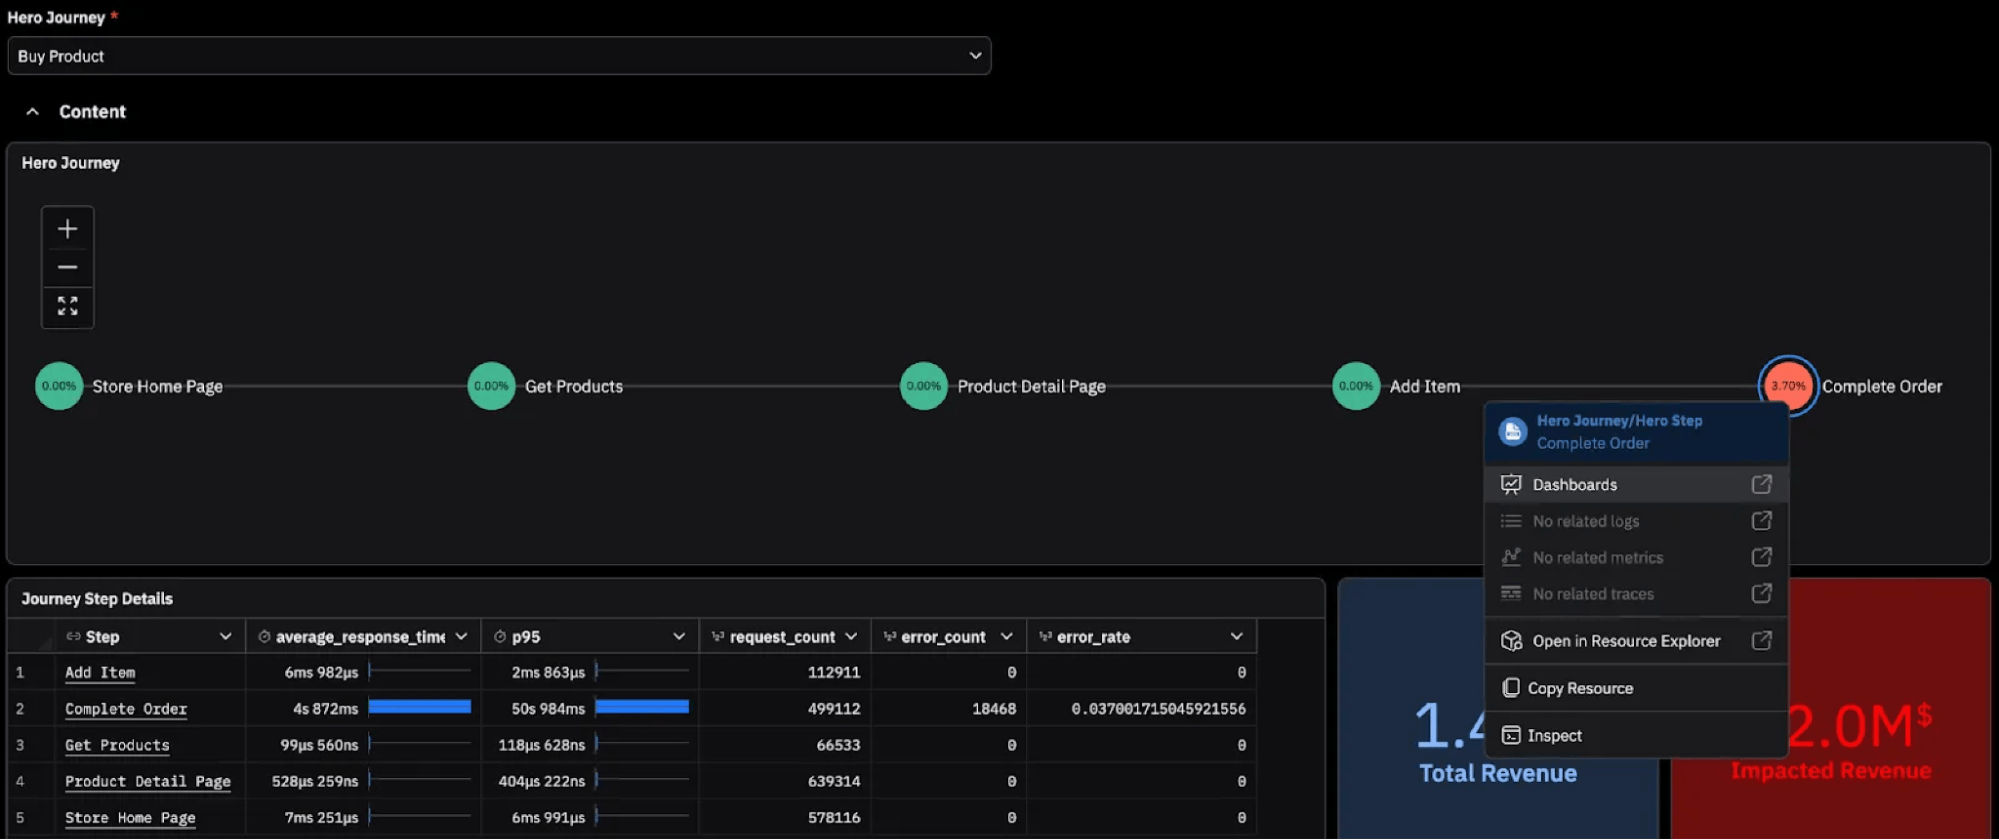
Considera il customer journey “Buy Product”: Home → Get Products → Product Details → Add Item → Complete Order. Negli strumenti legacy, vedere errori di log grezzi o picchi nelle metriche dell’infrastruttura, come l’utilizzo di CPU o memoria, non rivela immediatamente se gli acquisti sono bloccati o quanto sia estesa la portata dell’impatto. In un modello journey-first, si inizia dal degrado della customer experience.
Partendo da un customer journey in Observe, è possibile vedere immediatamente la portata dell’impatto. Misurare l’impatto dovrebbe essere il primo passo in qualsiasi incidente. Observe aggrega le metriche rate, errors e duration (RED) e le sessioni univoche in un contesto che conta davvero. L’indagine parte con l’impatto sul business già definito.
Fase 2: scendere nel dettaglio dell’operazione che sta fallendo
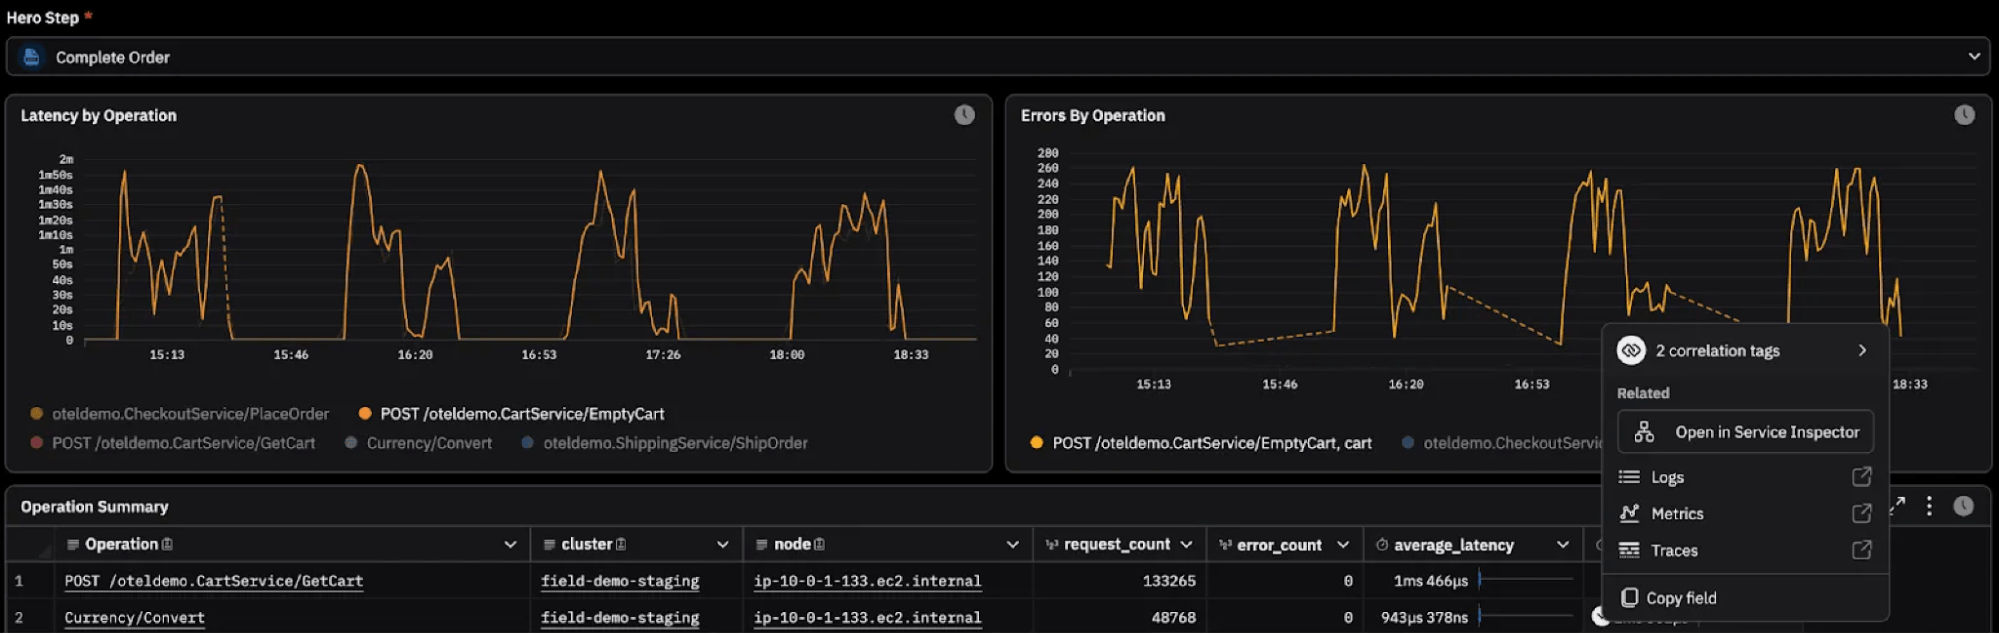
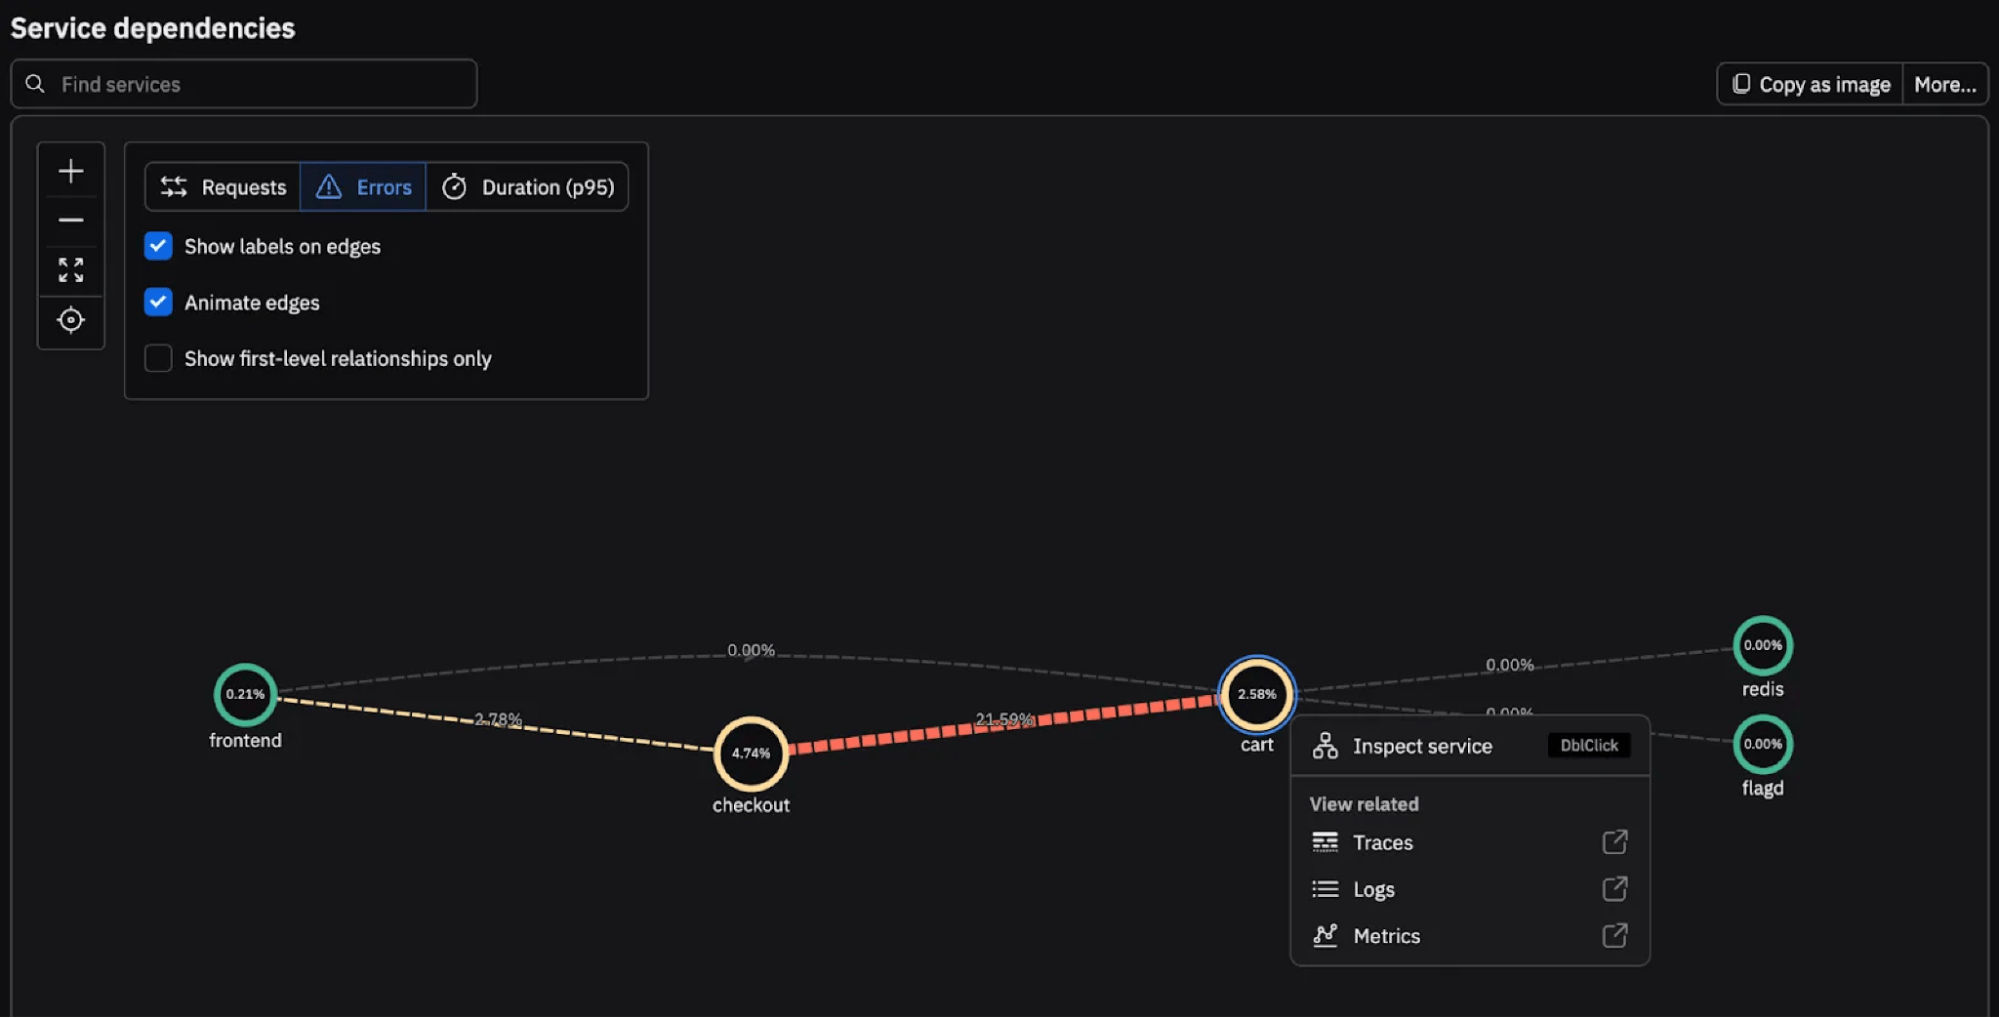
Una volta identificata l’interazione Complete Order come degradata, la domanda successiva riguarda la responsabilità e la portata. Da Complete Order, si passa a un’analisi a livello di servizio o di operazione. In questo esempio, l’operazione EmptyCart all’interno del servizio cart è la causa di latenza ed errori. L’indagine si restringe da un passaggio del cliente che fallisce a un’operazione specifica. I dirigenti verificano impatto e gravità, mentre i site reliability engineer (SRE) identificano il servizio problematico dalla stessa dashboard e dagli stessi dati, riducendo al minimo il tempo perso a riconciliare i risultati provenienti da strumenti diversi.
Fase 3: confermare con trace e log
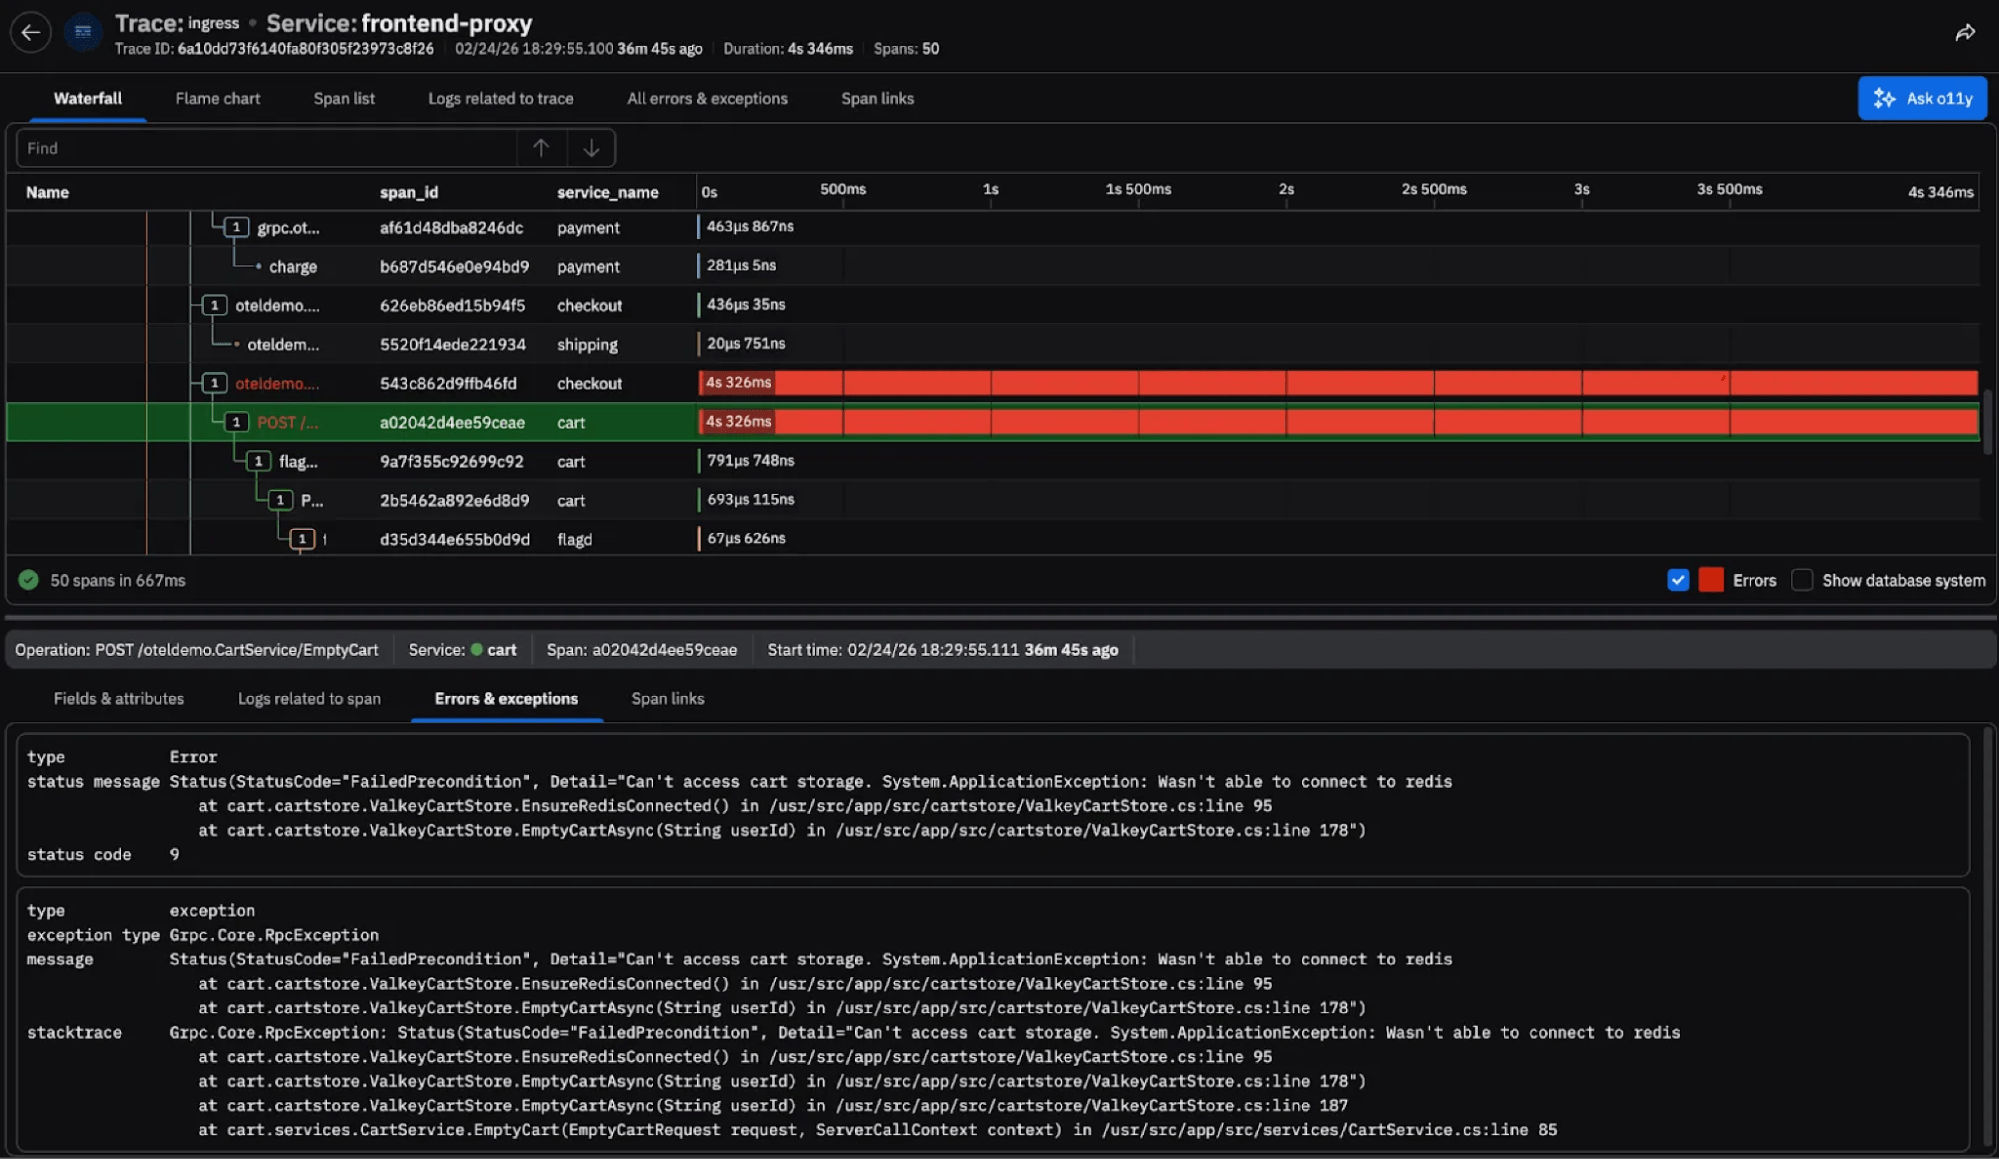
Una volta identificato il servizio alla base della causa principale, gli SRE possono avvisare in modo mirato il team applicativo responsabile e continuare l’indagine sulla telemetria correlata. Si passa alle trace per vedere dove viene impiegato il tempo e dove ha origine l’errore per una richiesta specifica, per poi analizzare nel dettaglio i log associati allo span downstream che fallisce. La narrazione dell’incidente è ora chiara: Gli utenti non riescono a completare un ordine → servizio downstream che fallisce → fallimento della trace per una richiesta correlata → messaggio di errore esplicito (causa principale). Grazie ai customer journey, in questo esempio gli SRE determinano che i clienti non possono completare il checkout perché l’operazione EmptyCart non riesce a recuperare da Redis il contenuto del carrello, proprio nel momento in cui il team applicativo avvisato si unisce alla chiamata.
Questo esempio dimostra l’analisi esplorativa degli incidenti. Partendo dall’impatto sul cliente, chi risponde all’incidente restringe l’indagine seguendo le relazioni nel data lake della telemetria (dall’interazione al servizio, dal servizio all’operazione, dall’operazione alla trace e dalla trace al log), finché la modalità di guasto non è confermata. La struttura è definita nei dati, ma l’indagine in sé è ancora guidata dalle persone. Gli ingegneri decidono dove concentrarsi successivamente, quali segnali contano e come riassumere i risultati per il resto del team. Questa sintesi è essenziale, ma richiede tempo sotto pressione.
AI SRE: accelerare il percorso verso la causa principale
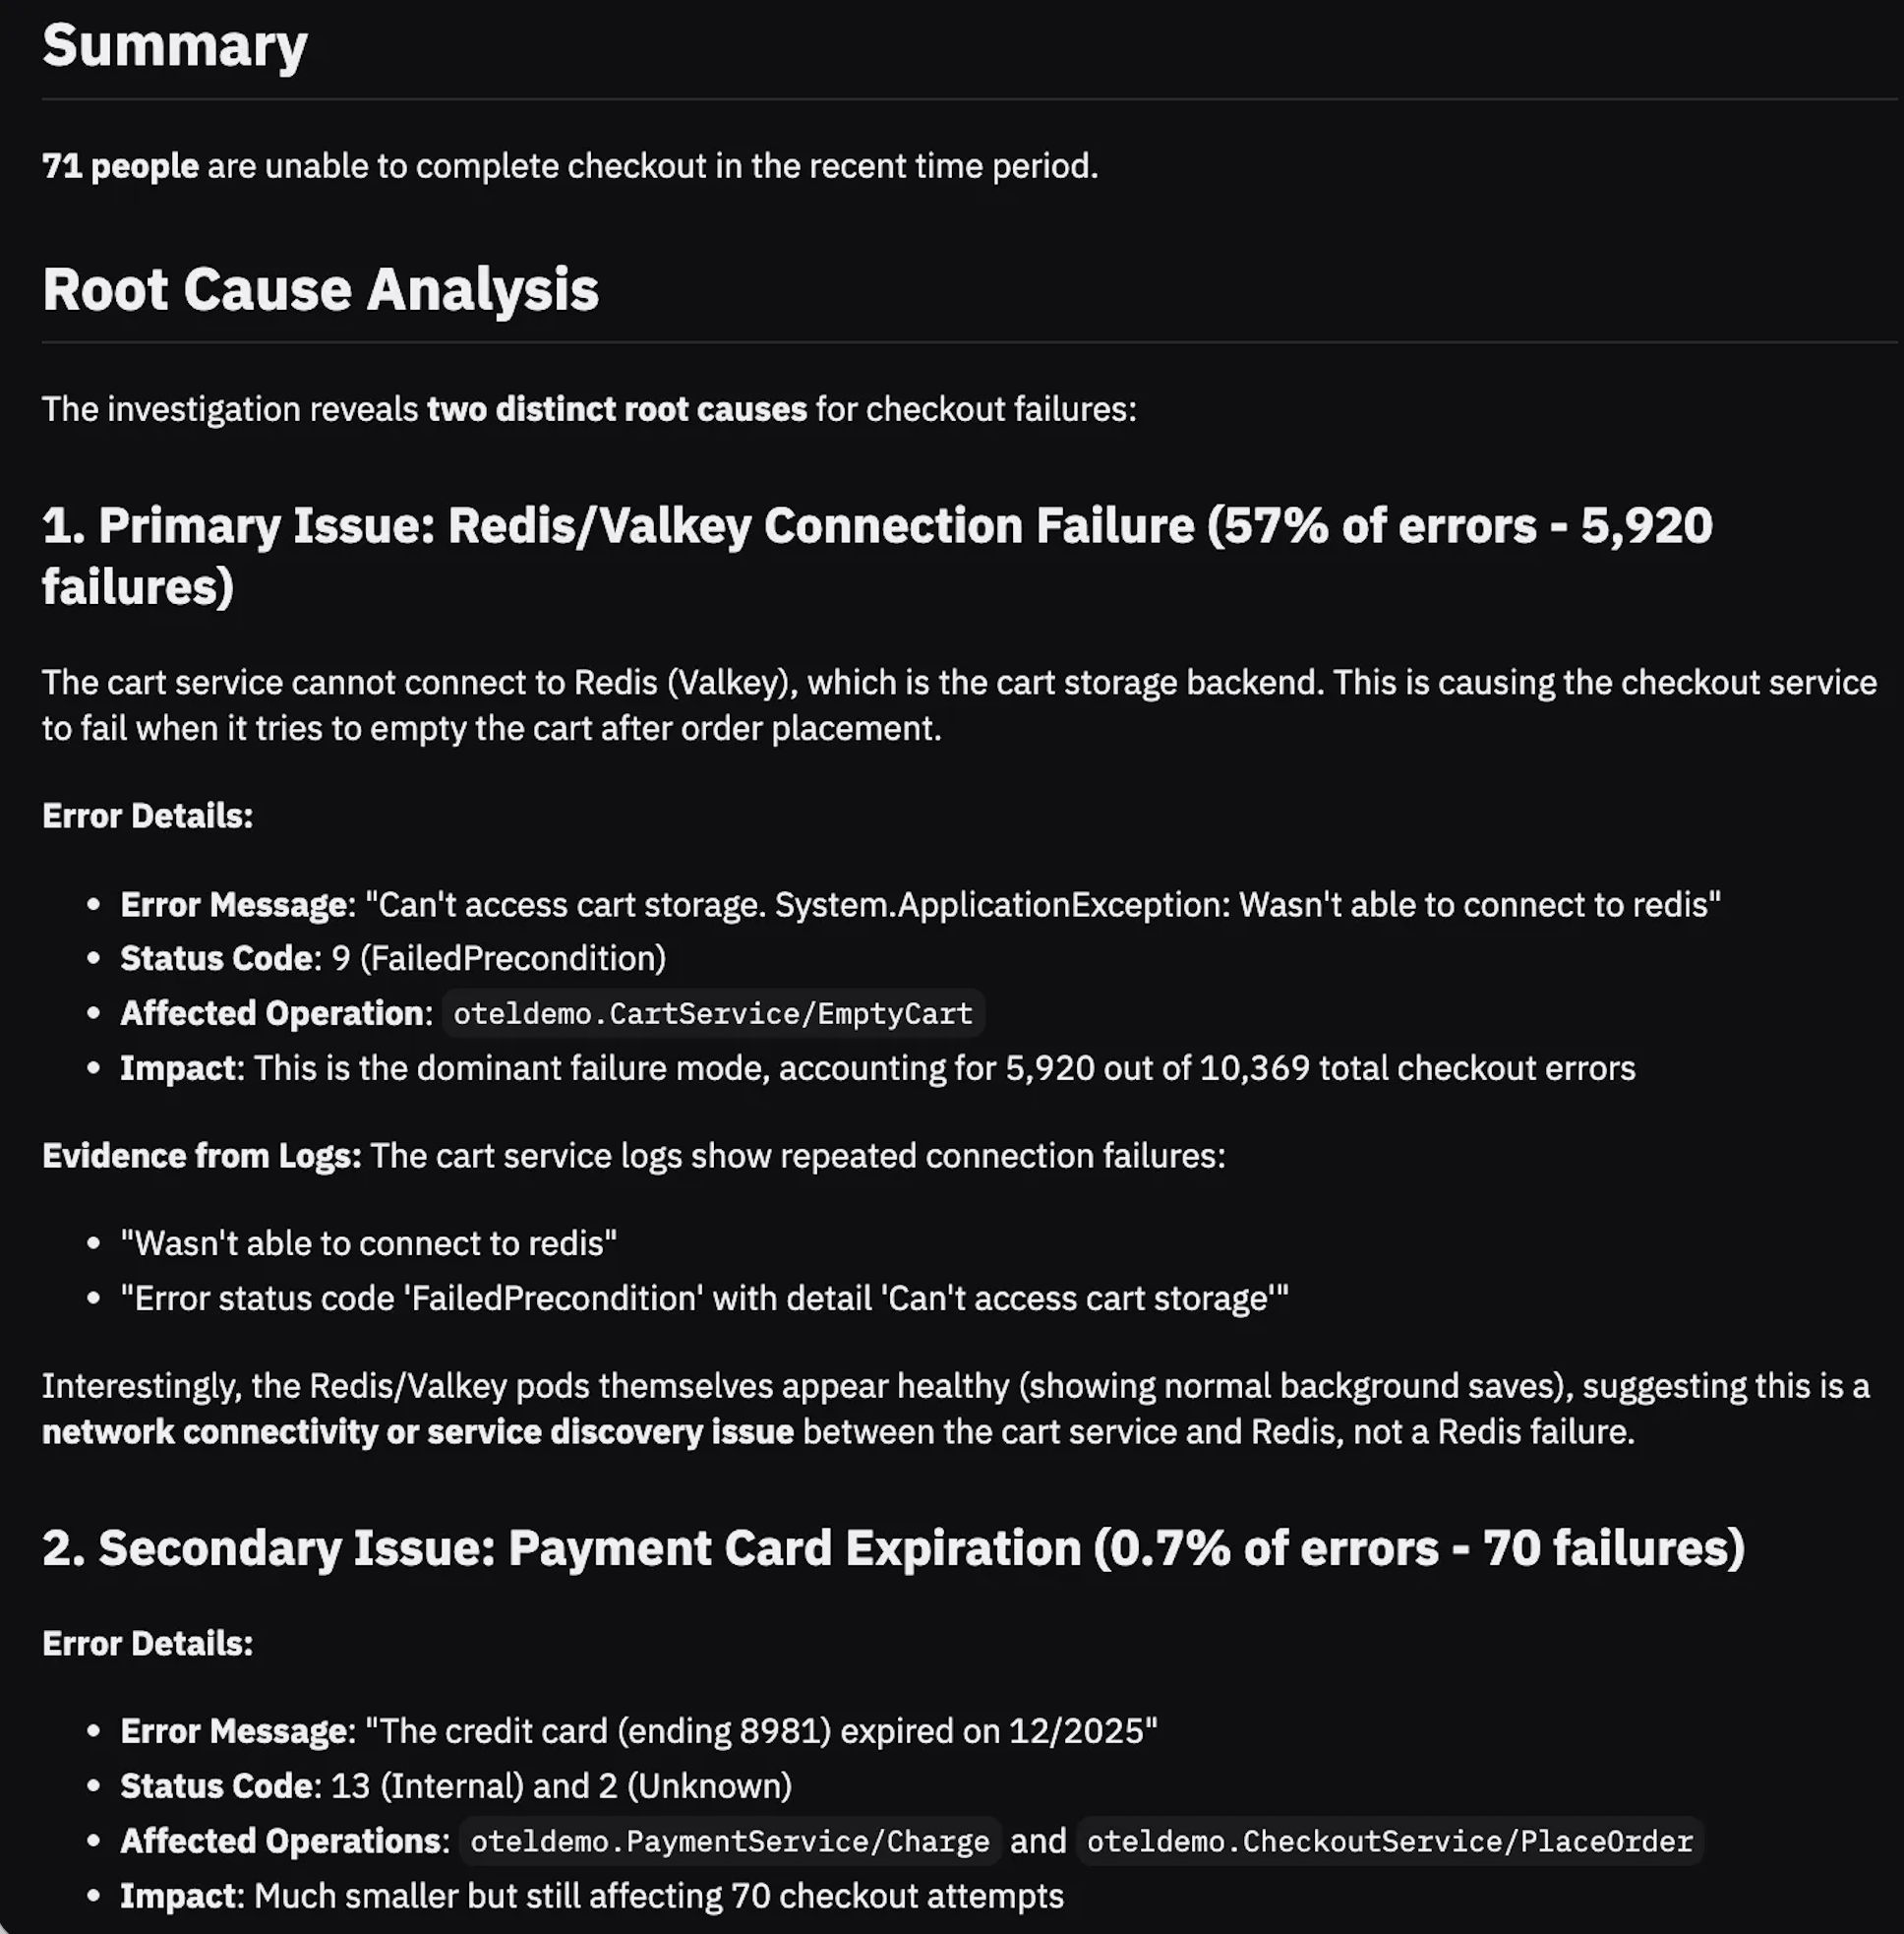
AI SRE opera sullo stesso grafo di contesto per l’osservabilità nel data lake della telemetria che alimenta il flusso journey. Invece di navigare manualmente ogni passaggio, un ingegnere può chiedere: “cosa sta causando il picco di pagamenti falliti?” AI SRE attraversa le interazioni, i servizi, le trace e i log connessi e restituisce un’indagine guidata con prove a supporto e schede di query interattive per un’analisi più approfondita, tutto in pochi secondi.
AI SRE può offrire notevoli guadagni di produttività nei workflow di osservabilità. I clienti riportano di completare i task in media circa 4 volte più velocemente, con alcune indagini fino a 10 volte più rapide. (Scopri di più su come AI SRE utilizza la telemetria unificata e il grafo di contesto per ridurre i tempi di indagine.)
AI SRE segue anche le relazioni definite nei tuoi dati. Le stesse connessioni che collegano l’impatto sul business all’implementazione guidano l’indagine, riducendo il tempo tra domanda e risposta e preservando al contempo la traccia delle prove.
I customer journey all’interno del grafo di contesto più ampio per l’osservabilità
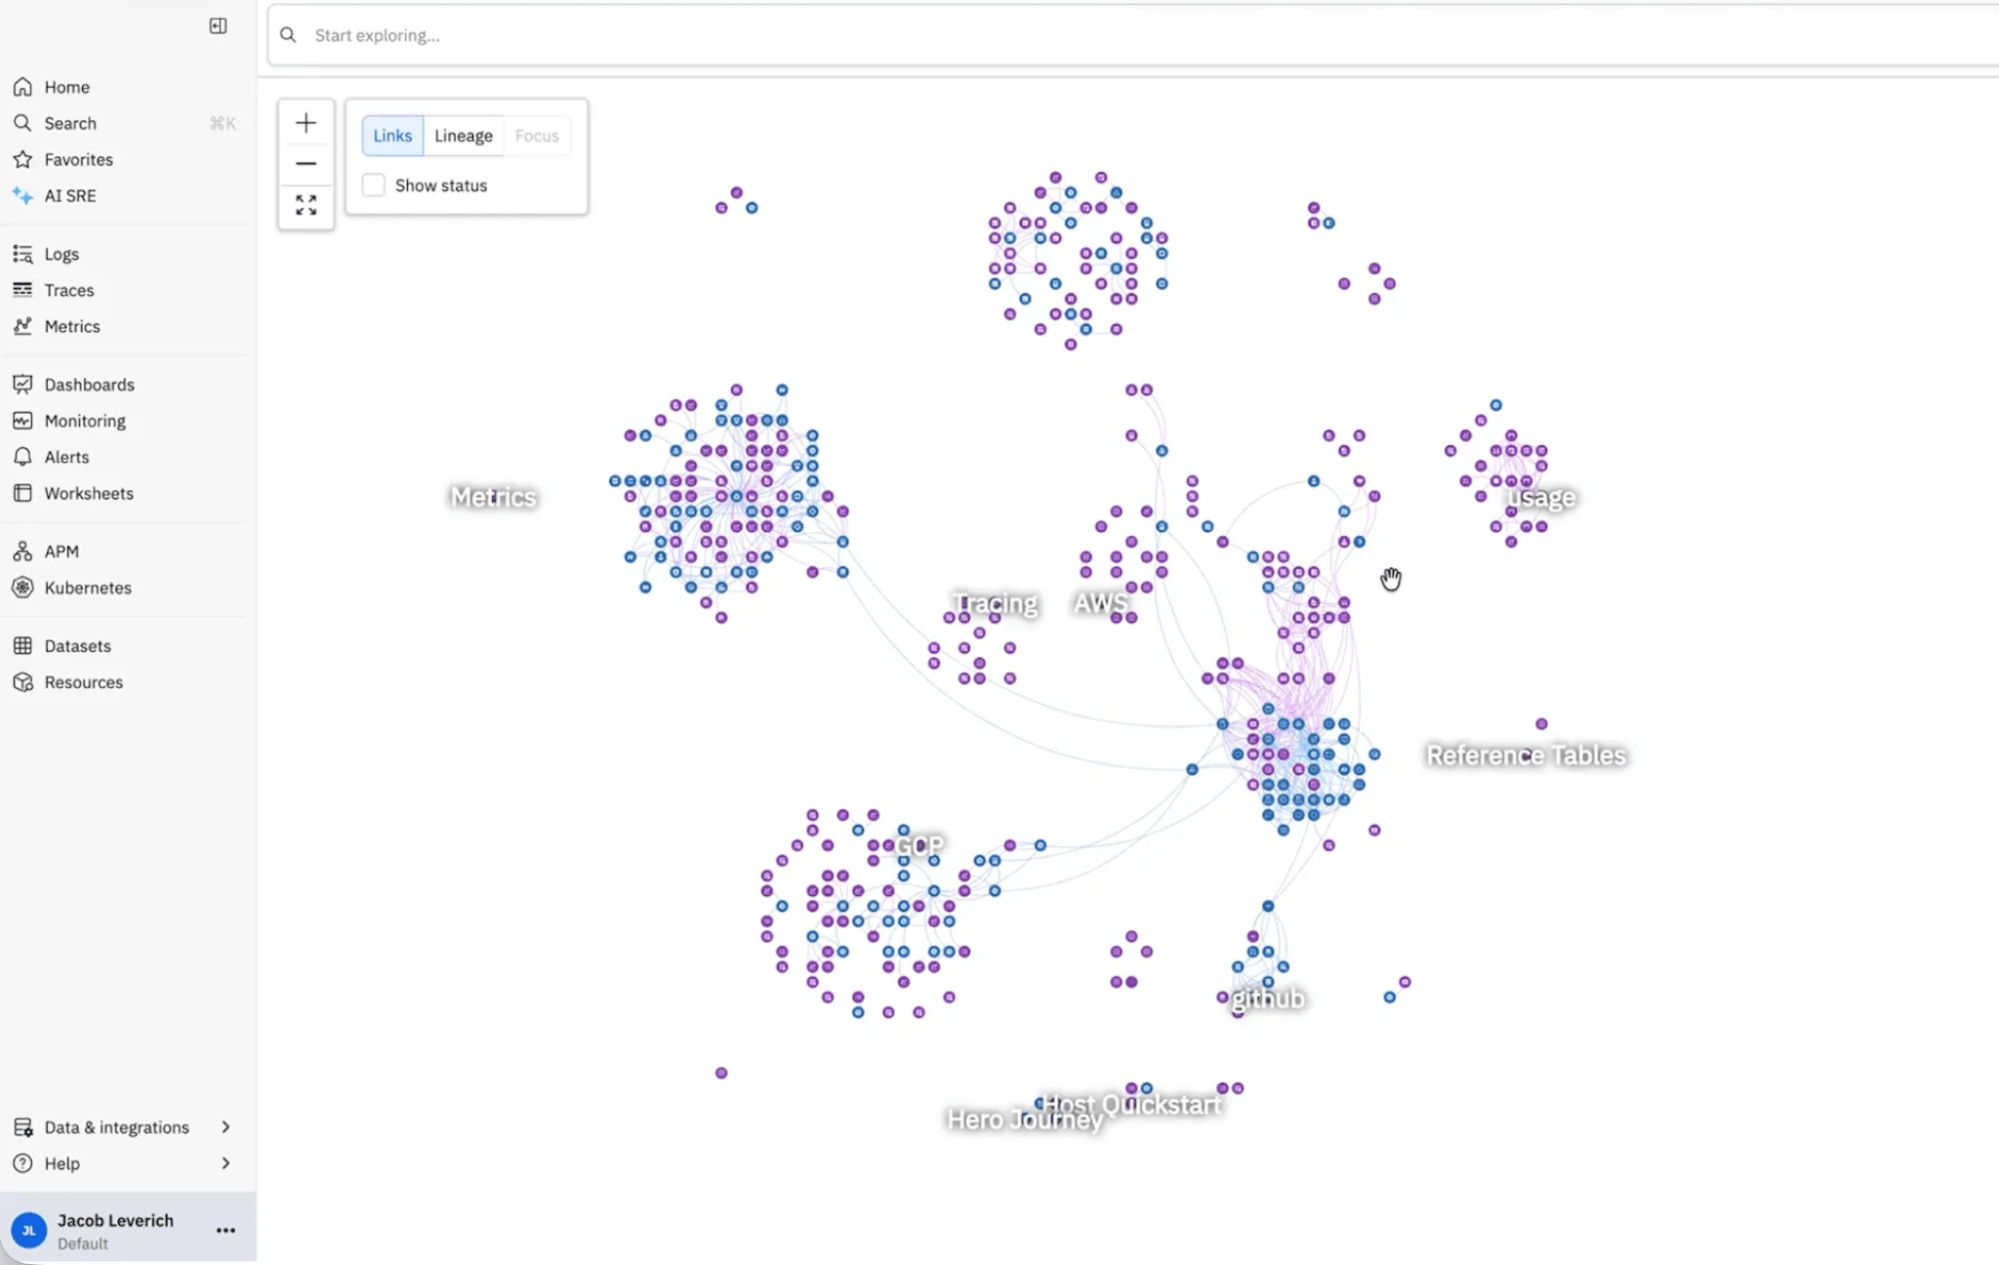
Il flusso journey descritto sopra è un dominio all’interno di un grafo di contesto più ampio per l’osservabilità in Observe. Tutta la telemetria importata nel data lake della telemetria è collegata tramite relazioni modellate che rispecchiano il modo in cui servizi, infrastruttura ed entità di business interagiscono.
I customer journey organizzano parte di quel grafo attorno alle interazioni di business. Altri domini collegano risorse cloud, dati di modifica e sistemi esterni come AWS e GitHub ai servizi che questi influenzano. Ogni nodo e arco rispecchia relazioni definite nel modello dei dati, e non in una dashboard predefinita.
Quando si passa da un passaggio del journey a un servizio, o da un servizio a una trace, si sta attraversando quel grafo più ampio. AI SRE opera sulla stessa struttura. I journey sono un punto di accesso allineato al business a un modello condiviso di come i tuoi sistemi e il contesto di business si connettono.
Osservabilità dall’impatto sul business alla causa principale
I customer journey in Observe mostrano come partire dall’impatto sul business trasformi l’indagine dal caos a una procedura. Poiché Observe è costruito attorno alle relazioni nel grafo di contesto, basato su un data lake della telemetria, è possibile passare tra diversi tipi di dati in base a come i tuoi sistemi ed entità di business sono effettivamente connessi.
Un grafo journey è un modo per organizzare queste relazioni ed è completamente supportato come parte delle funzionalità principali di Observe. Lo stesso meccanismo si applica a qualsiasi entità modellata nei dati: clienti, transazioni, spedizioni, dispositivi, chiamate telefoniche e reclami. Una volta definite queste relazioni, diventano contesto per l’analisi senza dover imparare dashboard e runbook durante l’incidente, grazie ad AI SRE.
Questo è il cambiamento descritto da Capital One: si inizia con ciò che i clienti stanno vivendo, per poi passare solo ai dati correlati, con il contesto intatto. In Observe, i customer journey sono un dominio all’interno di un grafo di contesto più ampio per l’osservabilità, costruito sul data lake della telemetria. Poiché quel grafo rispecchia come si connettono sistemi ed entità di business, il percorso dall’impatto sul business alla causa principale è già definito, il che può portare a indagini più rapide ed efficienti.
Scopri di più su Observe by Snowflake e su come trasforma la telemetria in insight, velocemente.