Analytique en streaming : analyser les données en mouvement, et savoir quand c'est utile
Toutes les charges de travail en temps réel n’ont pas besoin de l’analytique en streaming. Cet article explique ce que recouvre concrètement l'analytique en streaming (ingestion en streaming, traitement de flux et mise à disposition des données à faible latence) et comment déterminer si vos usages l'exigent.
DÉFINITION DE L’ANALYTIQUE EN STREAMING
L'analytique en streaming est une composante de l'analytique en temps réel, dans laquelle les données sont ingérées en continu et, si nécessaire, traitées au fil de l'eau avant d'atteindre la couche de restitution. Elle associe ingestion en streaming, traitement de flux et mise à disposition à faible latence, afin que les résultats se mettent à jour à mesure que de nouveaux événements arrivent. Ses exigences en matière de fraîcheur des données et de traitement sont plus strictes que celles des autres approches d'analytique en temps réel.
Une demande d'« analyse en temps réel » commence souvent par un objectif de latence : cinq secondes, 30 secondes, voire une minute. Pourtant, savoir en combien de temps le résultat doit être disponible ne permet pas de déterminer si vous avez besoin d'analytique en streaming.
Un tableau de bord qui semble à jour aux yeux de l'utilisateur peut s'appuyer sur un traitement de flux qui transforme les événements en continu, au fil de l'eau, ou sur des requêtes rapides exécutées sur des données récemment chargées. Si la seconde approche répond au besoin, rien ne justifie d'assumer la complexité de l'analytique en streaming, ni les exigences qu'elle impose à l'architecture.
Pour prendre la bonne décision, commencez plutôt par répondre à ces trois questions : Au bout de combien de temps une réponse perd-elle sa valeur ? Les données doivent-elles être transformées ou enrichies pour être exploitables ? Et si oui, ce traitement doit-il s'effectuer en continu sur les événements en transit, ou peut-il intervenir une fois les données chargées ?
La première réponse définit votre objectif de fraîcheur. Les réponses aux deux questions suivantes indiquent quelles briques de l'analytique en streaming vous sont réellement nécessaires : de la seule ingestion en streaming jusqu'à l'association de l'ingestion et du traitement de flux.
Qu’est-ce que l’analytique en streaming ?
L'analytique en streaming est une discipline de bout en bout qui consiste à ingérer des données en continu, et éventuellement à les traiter au fil de l'eau, afin qu'elles atteignent la couche de restitution le plus rapidement possible pour éclairer les décisions et déclencher des actions. Certaines charges de travail d'analytique en streaming exigent que le système conserve un état et mette à jour les résultats au fur et à mesure de l'intégration de nouveaux événements : c'est le traitement de flux. D’autres nécessitent seulement une ingestion rapide et fiable dans une couche de restitution capable d’interroger immédiatement les données.
L’analytique en streaming s’inscrit dans une architecture événementielle plus large. Il est donc important de préciser le rôle de chaque composant.
L’ingestion en streaming désigne la manière dont les événements entrent dans l'environnement analytique. Des plateformes comme Kafka acheminent des événements horodatés entre producteurs et consommateurs, tandis que les API d'écriture directe et la capture des données modifiées (Change Data Capture, CDC) permettent d'extraire les données des systèmes opérationnels. L’objectif est d’acheminer les données rapidement et de manière fiable.
Le traitement des flux constitue la couche de calcul. Des moteurs comme Apache Flink ou Spark Structured Streaming permettent d'effectuer, sur ces flux, des agrégations sur fenêtres temporelles, des jointures avec état, du filtrage et de l'enrichissement.
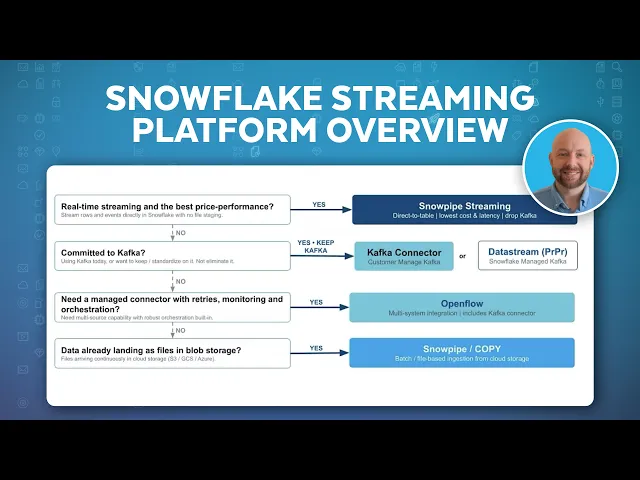
Découvrez Snowpipe Streaming, qui permet d'ingérer en continu de grands volumes de données pour obtenir des informations en quasi temps réel :
Analytique en streaming ou analytique en temps réel
L’analytique en streaming et l’analytique en temps réel sont souvent évoquées ensemble, mais elles ne désignent pas la même chose.
L’analytique en temps réel est le terme générique. Les données et les résultats doivent être suffisamment récents, et les requêtes suffisamment rapides, pour permettre une décision ou une action dans un délai défini. Cette fraîcheur peut provenir de l'ingestion en streaming, du chargement par micro-lots, de la réplication CDC ou d'une combinaison de ces approches. Les requêtes croisent généralement les données récentes avec l'historique.
En savoir plus sur l’analyse en temps réel >
L’analytique en streaming est une catégorie de l’analyse en temps réel. L'analytique en streaming impose, elle, des exigences plus strictes quant à la manière dont les données sont traitées avant d'atteindre la couche de restitution. Elle introduit un modèle de traitement plus spécifique : les événements entrants sont traités dès leur arrivée, souvent en conservant un état d'un événement, d'une fenêtre ou d'une séquence à l'autre. Les exigences de fraîcheur et de transformation des données sont plus strictes, car les calculs portent sur des données en mouvement et non au repos.
Imaginons une requête interactive qui renvoie un résultat en moins d'une seconde, sur des données chargées il y a cinq secondes. Si le métier a besoin d'une réponse datant de dix secondes au plus, cette architecture peut tout à fait répondre à l'exigence de temps réel. Aucune requête en streaming permanente n’est nécessaire.
Inversons maintenant l’exemple. Un pipeline actualise continuellement un agrégat, mais le tableau de bord qui l'affiche n'est consulté qu'une fois par heure. Le calcul s’effectue en streaming, mais cette fraîcheur supplémentaire apporte très peu de valeur à l’organisation.
C'est aussi pourquoi l'analytique en streaming fait partie de la catégorie plus large de l'analytique en temps réel, au lieu de constituer une catégorie distincte. Le calcul en streaming est l'un des moyens d'atteindre la fraîcheur des données qu'exige l'analytique en temps réel. Ce n'est toutefois pas le seul, et il entraîne une complexité supplémentaire en matière de gestion des états, d'ordonnancement des événements et de garanties de livraison.
Cette distinction détermine ce que vous devez créer. Une exigence de fraîcheur impose des contraintes sur la vitesse de disponibilité des données et le temps de réponse des requêtes. Une exigence de streaming signifie que le calcul doit lui-même suivre un flux continu d’événements, notamment les états, l’ordonnancement ou les règles temporelles dont dépend le résultat.
Pour certaines charges de travail, il suffit d’exécuter périodiquement le calcul sur les données récemment chargées. D’autres dépendent de séquences d’événements, de fenêtres glissantes ou d’un état cumulé qui doit être conservé à mesure que le flux progresse.
PSA BDP
Acteur mondial de la logistique, PSA BDP utilise Snowflake pour centraliser d'importants volumes de données logistiques à haute vélocité, notamment la localisation des navires et les perturbations, afin de les analyser et de les partager dans toute l'entreprise. La migration de l'ingestion en temps réel et du partage de données vers Snowflake lui a permis de réduire d'environ 40 % les coûts associés, par rapport à ses anciennes solutions.
Pourquoi les résultats du traitement des flux nécessitent du contexte
L'arrivée du traitement de flux dans l'architecture entraîne l'un des changements conceptuels les plus importants : il n'existe aucun moment naturel où les données entrantes peuvent simplement être considérées comme « terminées ».
Lorsque vous exécutez une requête sur la table des ventes de la semaine précédente, les limites sont évidentes. Vous savez quels enregistrements doivent être inclus dans le calcul. En revanche, avec un flux continu, c'est à vous de fixer ces limites : quels événements intègrent un calcul, combien de temps vous acceptez d'attendre les données tardives, et que faire lorsque des événements sont renvoyés ou livrés plusieurs fois.
Les fenêtres définissent ce que vous mesurez
La plupart des calculs en streaming nécessitent de convertir un flux continu en unités analysables. C’est là qu’interviennent les fenêtres.
- Une fenêtre fixe découpe le flux en périodes de durée fixe, qui ne se chevauchent pas. Vous pouvez, par exemple, calculer le volume de transactions de 10 h 00 à 10 h 05, puis ouvrir une nouvelle fenêtre de 10 h 05 à 10 h 10.
- Une fenêtre glissante, à l'inverse, se chevauche avec les précédentes.. Si vous souhaitez recalculer chaque minute « les transactions des dix dernières minutes », chaque nouvelle fenêtre contient une partie des événements de la précédente.
- Une fenêtre de session fonctionne différemment : elle regroupe les événements selon les périodes d'activité, et non selon des intervalles horaires fixes.
Autrement dit, un indicateur issu d'un flux, comme « 1 240 transactions », n'a pas de sens à lui seul. Encore faut-il savoir à quel intervalle ou à quelle session ces transactions se rapportent.
L’heure de l’événement et l’heure de traitement coïncident rarement
L'heure de l'événement (event time) correspond au moment où l'événement s'est réellement produit. L'heure de traitement (processing time) correspond au moment où le système analytique l'a reçu ou traité. Ces horodatages diffèrent souvent.
Imaginons qu’une transaction ait eu lieu à 10:04:58, mais n’ait atteint le pipeline analytique qu’à 10:06. Il peut s'agir d'une connexion réseau momentanément bloquée, ou d'un système en amont qui a retransmis l'événement. Du point de vue de l'heure de l'événement, la transaction appartient à la fenêtre 10 h 00 – 10 h 05. Du point de vue de l'heure de traitement, en revanche, cette fenêtre est déjà close.
C'est pourquoi les filigranes (watermarks) et les règles de gestion des données tardives sont indispensables. Un watermark représente l'estimation, par le système, de l'avancement de l'heure de l'événement. Il lui permet de déterminer à quel moment une fenêtre fondée sur l'heure de l'événement est prête à produire un résultat. Une politique de gestion des retards détermine ce qui se passe lorsque des événements arrivent après cette échéance. Attendre plus longtemps permet d'intégrer davantage d'événements retardataires avant que le résultat ne soit figé. À l'inverse, fermer la fenêtre plus tôt produit un résultat plus frais, mais augmente le risque que des données tardives nécessitent une mise à jour ou un traitement à part.
Will Xu, Principal Product Manager for Snowflake Interactive Analytics, recommande d’adapter cette tolérance à la décision elle-même : « Les équipes doivent déterminer le délai maximal de retard des données qu'une charge de travail peut tolérer. En règle générale, cette fenêtre est de quatre heures. Plus elle est étendue, plus le coût d’infrastructure augmente. C’est une décision stratégique à prendre dès le début de la planification. »
Les garanties de livraison influencent aussi le résultat
Les événements tardifs ne sont qu'une source d'incertitude parmi d'autres. Les nouvelles tentatives en sont une autre. Par nature, les systèmes distribués perdent des connexions, redémarrent des processus et renvoient des données. Une question en apparence banale finit alors par avoir d’importantes conséquences analytiques : Ai-je déjà traité cet événement ?
Avec une livraison « au moins une fois » (at-least-once), le système privilégie l'absence de perte d'événements. Un consommateur peut donc recevoir plusieurs fois le même événement. Les traitements en aval doivent donc tolérer les doublons, généralement grâce à des opérations idempotentes qui produisent le même résultat effectif lorsqu'elles sont répétées.
La livraison « exactement une fois » (exactly-once) vise à ce que chaque événement n'ait qu'un seul effet sur le résultat, même en cas de nouvelles tentatives d'envoi. Cela nécessite généralement de coordonner les systèmes qui produisent, traitent et stockent les événements.
Pour la personne qui consulte un résultat analytique, toute cette infrastructure se résume à un chiffre affiché à l’écran. Mais la sémantique ne doit pas se perdre dans le pipeline. Si un indicateur calculé en streaming doit orienter une décision, les équipes doivent connaître sa fenêtre de calcul, la manière dont les données tardives sont prises en compte et les garanties de livraison sur lesquelles il s'appuie.
Les équipes doivent également définir une règle de rapprochement des données. Le chiffre obtenu en streaming à 10 h 05 ne sera pas forcément identique au résultat du traitement par lots effectué ensuite, lorsque tous les enregistrements en retard auront été pris en compte. Déterminez à l’avance quel chiffre fera foi et comment résoudre les écarts.
ASTUCE
Documentez la fenêtre de calcul, la règle de gestion des données tardives et les garanties de livraison avec chaque indicateur. Un chiffre issu d'un flux inspire bien plus confiance lorsque ses utilisateurs savent quelles données il intègre et ce qui peut encore évoluer.
Quand le coût de l’analytique en streaming se justifie
Certaines charges de travail doivent réellement prendre des décisions dans des délais extrêmement courts. L'autorisation des paiements avec détection de fraude, les enchères publicitaires en temps réel et certains systèmes de contrôle industriel peuvent devoir réagir en quelques millisecondes. Le traitement s'effectue alors généralement directement dans l'application ou dans le pipeline de traitement de flux, afin que la décision puisse être prise au cours même de la transaction.
Mais la plupart des cas d’usage d’analytics en entreprise ne sont pas soumis à ces contraintes. Pour nombre d’entre eux, l’analytique en temps quasi réel suffit, sans calcul continu des données en transit. Une équipe des opérations peut avoir besoin de détecter en quelques minutes l’accumulation d’un retard afin de pouvoir intervenir. Ou encore, un processus logistique peut avoir besoin qu'une anomalie d'expédition soit signalée tant qu'il est encore possible de réacheminer la marchandise. Un processus automatisé peut avoir besoin de données de télémétrie récentes avant de décider de l’action suivante. Dans ces situations, disposer de données actualisées en quelques secondes ou minutes offre une réelle valeur opérationnelle.
Quand un traitement périodique ou par micro-batch suffit
Le traitement par batch perdure pour de bonnes raisons. Chaque exécution porte sur un ensemble de données délimité, à intervalle défini. Vous disposez ainsi d'une unité relativement claire à tester, rejouer et examiner en cas de problème.
Le traitement par micro-lots (micro-batching) raccourcit cet intervalle : de petits groupes d'enregistrements sont traités toutes les quelques secondes ou minutes. Selon la charge de travail, cette méthode peut souvent produire des données suffisamment récentes.
Par exemple, si un tableau de bord logistique reste utile avec une actualisation toutes les cinq minutes, conserver un état continu entre chaque événement entrant n'améliorera sans doute pas la décision. L'analytique en quasi temps réel est alors probablement plus adaptée. En revanche, si l'équipe doit détecter une séquence au moment même où elle se produit, ou si attendre cinq minutes ferait passer le moment d'intervenir, le traitement de flux se justifie davantage.
De nombreuses équipes combinent traitement par lots et streaming, plutôt que d'imposer le même modèle de traitement à chaque étape du pipeline.
Réduire la latence augmente généralement les coûts
Cette approche permet également d’établir un modèle de coûts plus pertinent. Réduire la latence suppose généralement des traitements plus fréquents et des marges opérationnelles plus serrées. Les coûts de calcul peuvent donc augmenter, tout comme l'effort de supervision, de dépannage et de rapprochement qu'exige la charge de travail. Mettez ce coût permanent en regard des décisions dont les résultats s'améliorent réellement lorsque les données leur parviennent plus tôt.
Ces exemples illustrent la diversité des exigences :
- Autorisation des transactions en cas de fraude : souvent quelques millisecondes, avec une logique de décision intégrée au chemin transactionnel ou au pipeline de traitement de flux.
- Détection des anomalies opérationnelles : de quelques secondes à quelques minutes, selon la rapidité de réaction attendue d'une personne ou d'un processus automatisé.
- Suivi des stocks et de l’exécution des commandes : généralement de l'ordre de quelques minutes : un traitement incrémental ou à intervalles courts peut suffire.
- Reporting de direction : souvent toutes les heures ou tous les jours, sauf si un autre workflow en aval consomme les données plus tôt.
PIÈGE COURANT
Une erreur fréquente consiste à croire que toute charge de travail d'analytique en streaming nécessite un traitement de flux. De nombreuses charges de travail n'ont besoin que d'une ingestion en streaming et d'une couche de requêtes rapide, sans fenêtres, sans gestion des états ni watermarks. Ajoutez un traitement de flux lorsque les données doivent être transformées, enrichies ou dédoublonnées en transit. Dispensez-vous-en lorsque les données brutes ingérées sont déjà prêtes à être interrogées.
Exécuter l’analytique en streaming sur Snowflake
Snowflake prend en charge l'analytique en streaming de bout en bout (ingestion, traitement de flux et restitution à faible latence) au sein d'une plateforme unique et gouvernée. Vos équipes n'ont donc pas à gérer une infrastructure de streaming distincte.
Le parcours de l’analytique en streaming comprend trois étapes, chacune faisant l’objet d’une présentation détaillée :
L’ingestion en streaming transmet les données d’événements à Snowflake dès leur production, sans passer par des fichiers intermédiaires ni par un stockage objet temporaire. Cela comprend l'ingestion directe par API via Snowpipe Streaming, Snowflake Kafka Connector et la capture des données modifiées (CDC) depuis les bases de données opérationnelles.
Le traitement de flux transforme, enrichit et structure les données en transit avant qu’elles n’atteignent la couche de mise à disposition. Cela comprend le dédoublonnage, les jointures avec des tables de dimensions, les agrégations sur fenêtres temporelles et le traitement des flux CDC, des opérations qui nécessitaient traditionnellement un moteur de traitement de flux distinct, comme Apache Flink.
La mise à disposition à faible latence permet d’interroger les données obtenues à la vitesse requise par la charge de travail. L’analytique interactive permet d'exécuter des requêtes en moins d'une seconde, même avec un grand nombre d'utilisateurs simultanés.
Comme ces trois étapes s’exécutent nativement dans Snowflake, chaque ligne bénéficie de la gouvernance, des contrôles d’accès et de la traçabilité que vous avez déjà configurés. Aucune stack de streaming distincte n’est à sécuriser ni à rapprocher.
Faire du streaming un choix de conception, pas un réflexe
Dès qu'il est question d'analytique en temps réel, le premier réflexe est souvent de passer directement à l'analytique en streaming : ingestion continue, traitement en transit, toute la pile technologique. Pourtant, l'analytique en temps réel est la notion générale, et l'analytique en streaming n'est qu'une des façons d'y parvenir. De nombreuses charges de travail en temps réel sont très bien servies par des requêtes rapides sur des données fréquemment actualisées, sans la moindre architecture de données en mouvement.
Partez des besoins réels de la charge de travail : le degré de fraîcheur nécessaire, la nécessité ou non de transformer les données pour les rendre exploitables, et l'obligation ou non d'effectuer cette transformation en transit. Ces réponses détermineront quelles briques de l'analytique en streaming intégrer à votre architecture. Vous aurez ainsi moins de composants à exploiter et à rapprocher, tout en bénéficiant des performances du streaming là où elles sont réellement utiles.
À RETENIR
Partez de la charge de travail, pas de la technologie. Définissez le niveau de fraîcheur des données requis, la nécessité ou non d'une transformation en transit et la rapidité de requête attendue par l'application ou l'utilisateur final. Ne mettez ensuite en place que les briques de l'analytique en streaming que ces réponses exigent.
Foire aux questions
Les experts Snowflake répondent à vos questions les plus fréquentes sur l’analytique en streaming.
L’analytique en streaming est-elle identique à l’analytique en temps réel ?
Non. L’analytique en streaming est une composante de l’analytique en temps réel. L’analytique en temps réel désigne toute charge de travail dans laquelle les données et les résultats doivent être suffisamment récents pour permettre de prendre rapidement une décision ou d’agir. Cette fraîcheur peut provenir d’une ingestion en streaming, d’un chargement par micro-batch ou d’une combinaison des deux. L'analytique en streaming implique précisément l'ingestion continue des données et, si nécessaire, leur traitement en transit, avant leur arrivée dans la couche de restitution, où elles peuvent être interrogées avec une faible latence.
Quand privilégier l’analytique en streaming au traitement par batch ?
L'analytique en streaming est utile lorsque les données doivent être disponibles pour l'analyse en quelques secondes, et qu'un traitement en transit (traitement de flux) est nécessaire pour transformer, enrichir ou dédoublonner les événements avant qu'ils n'atteignent la couche de restitution. Si des mises à jour périodiques permettent toujours d’obtenir la réponse à temps, l’analytique en temps quasi réel est souvent plus simple et moins coûteuse à exploiter.
Découvrir les ressources en analytique
Explorer les thèmes liés à l’analytique
Des analyses approfondies de chaque aspect de l’analytique
