
Streaming Analytics: Daten in Bewegung analysieren – und erkennen, wann Sie es brauchen
Nicht jeder Echtzeit-Workload benötigt Streaming Analytics. Dieser Artikel erklärt, was Streaming Analytics tatsächlich beinhaltet (Streaming-Ingestion, Stream-Processing und Bereitstellung mit geringer Latenz) und wie Sie feststellen können, ob Ihr Workload dies erfordert.
STREAMING ANALYTICS – DEFINITION
Streaming Analytics ist ein Teilbereich der Echtzeitanalyse, bei dem Daten kontinuierlich aufgenommen und optional während der Übertragung verarbeitet werden, bevor sie im Serving-Layer landen. Streaming Analytics verbindet Streaming-Ingestion, Stream-Processing und Bereitstellung mit geringer Latenz, sodass Ergebnisse aktualisiert werden können, sobald neue Ereignisse eintreffen. Die Anforderungen an Aktualität und Verarbeitung sind dabei strenger als bei anderen Formen der Echtzeitanalyse.
Eine Anfrage nach „Echtzeitanalyse“ beginnt oft mit einem Latenzziel: fünf Sekunden, 30 Sekunden, vielleicht eine Minute. Aber zu wissen, wie schnell das Ergebnis eintreffen muss, sagt Ihnen nicht, ob Sie Streaming Analytics benötigen.
Ein Dashboard, das sich für die Nutzer:innen aktuell anfühlt, könnte durch Stream-Processing unterstützt werden, das Ereignisse während der Übertragung kontinuierlich transformiert, oder durch schnelle Abfragen von kürzlich geladenen Daten. Wenn Letzteres die Anforderung erfüllt, gibt es keinen Grund, die Komplexität – und die daraus resultierenden Anforderungen an die Architektur – von Streaming Analytics auf sich zu nehmen.
Ein besserer Weg, die Entscheidung zu treffen, ist die Beantwortung von drei Fragen: Wie alt darf die Antwort sein, bevor sie an Wert verliert? Müssen die Daten transformiert oder angereichert werden, bevor sie nützlich sind? Und muss diese Transformation kontinuierlich bei Ereignissen während der Übertragung stattfinden, oder kann sie erfolgen, nachdem die Daten gespeichert wurden?
Die erste Antwort gibt Ihnen ein Ziel für die Aktualität. Die zweite und dritte Antwort sagen Ihnen, wie viel des Streaming-Analytics-Stacks Sie tatsächlich benötigen. Von reiner Streaming-Ingestion bis zu Streaming-Ingestion plus Stream-Processing.
Was ist Streaming Analytics?
Streaming Analytics bezeichnet den durchgängigen Prozess, der Daten kontinuierlich aufnimmt und optional während der Übertragung verarbeitet, damit sie den Serving-Layer so schnell wie möglich für Entscheidungen und Aktionen erreichen. Einige Workloads für Streaming Analytics erfordern, dass das System einen Zustand vorhält und Ergebnisse aktualisiert, wenn neue Ereignisse integriert werden (Stream-Processing). Andere benötigen nur eine schnelle, zuverlässige Ingestion in einen Serving-Layer, in dem die Daten nahezu sofort abfragbar sind.
Streaming Analytics ist Teil einer breiteren ereignisgesteuerten Architektur, daher lohnt es sich, genau zu unterscheiden, welche Komponente welche Aufgabe übernimmt.
Streaming-Ingestion beschreibt, wie Ereignisse in die Analyseumgebung gelangen. Plattformen wie Kafka transportieren mit Zeitstempeln versehene Ereignisse zwischen Producern und Consumern, während Direct-Write-APIs und Change Data Capture Daten aus operativen Systemen einbringen. Der Fokus liegt darauf, Daten zuverlässig und schnell zu übertragen.
Stream-Processing ist die Rechenebene. Engines wie Apache Flink oder Spark Structured Streaming bieten die Mechanismen für fensterbasierte Aggregationen, zustandsbehaftete Joins, Filterung und Anreicherung über diese Streams.
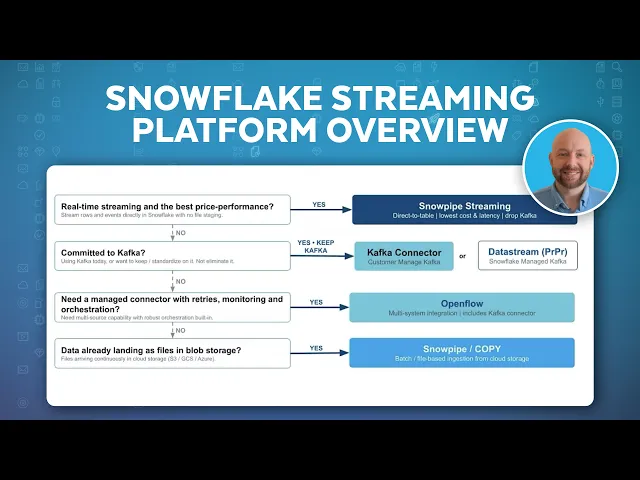
Sehen Sie sich einen Überblick über Snowpipe Streaming an, mit dem Sie große Mengen kontinuierlicher Daten für Erkenntnisse nahezu in Echtzeit streamen können:
Streaming Analytics vs. Echtzeitanalyse
Streaming Analytics und Echtzeitanalyse werden oft in einem Atemzug genannt, aber sie sind nicht dasselbe.
Echtzeitanalyse ist der Oberbegriff. Daten und Ergebnisse müssen aktuell genug und Abfragen schnell genug sein, damit eine Entscheidung oder Aktion innerhalb eines definierten Zeitfensters erfolgen kann. Diese Aktualität kann aus Streaming-Ingestion, Micro-Batch-Loading, CDC-Replikation oder einer beliebigen Kombination stammen – und Abfragen kombinieren typischerweise aktuelle Daten mit historischem Kontext.
Mehr über Echtzeitanalyse erfahren >
Streaming Analytics ist ein Teilbereich der Echtzeitanalyse. Dabei gelten strengere Anforderungen daran, wie Daten verarbeitet werden, bevor sie den Serving-Layer erreichen. Hinzu kommt ein spezifisches Verarbeitungsmodell: Eingehende Ereignisse werden bei ihrem Eintreffen verarbeitet, häufig mit einem Zustand, der über Ereignisse, Fenster oder Sequenzen hinweg beibehalten wird. Die Anforderungen an Datenaktualität und Transformation sind strenger, da die Berechnung auf Daten in Bewegung statt auf gespeicherten Daten erfolgt.
Angenommen, eine interaktive Abfrage liefert in weniger als einer Sekunde Ergebnisse für Daten, die vor fünf Sekunden geladen wurden. Wenn das Unternehmen eine Antwort benötigt, die höchstens zehn Sekunden alt ist, könnte diese Architektur die Echtzeitanforderung problemlos erfüllen. Eine dauerhaft laufende Streaming-Abfrage ist nicht nötig.
Drehen wir das Beispiel nun um. Eine Pipeline aktualisiert kontinuierlich ein Aggregat, aber das Dashboard, das es anzeigt, wird nur einmal pro Stunde überprüft. Die Berechnung erfolgt per Streaming, aber das Unternehmen zieht nur sehr wenig Nutzen aus dieser zusätzlichen Aktualität.
Dies ist auch der Grund, warum Streaming Analytics eher ein Teil der Echtzeitanalyse ist und keine eigenständige Kategorie daneben. Streaming-Berechnung ist eine Möglichkeit, die Aktualität zu erreichen, die Echtzeitanalyse erfordert – aber es ist nicht die einzige Möglichkeit, und sie bringt zusätzliche Komplexität bei der Zustandsverwaltung, Reihenfolge und Zustellsemantik mit sich.
Die Unterscheidung wirkt sich darauf aus, was Sie aufbauen müssen. Eine Anforderung an die Aktualität legt Einschränkungen fest, wie schnell Daten verfügbar sind und wie schnell Abfragen Ergebnisse liefern. Eine Streaming-Anforderung bedeutet, dass die Berechnung selbst einen fortlaufenden Ereignisstrom verfolgen muss – einschließlich aller Zustands-, Reihenfolge- und Zeitsemantiken, von denen das Ergebnis abhängt.
Für einige Workloads reicht es aus, die Berechnung regelmäßig für neu geladene Daten auszuführen. Andere hängen von Ereignissequenzen, gleitenden Fenstern oder akkumuliertem Zustand ab, die erhalten bleiben müssen, während sich der Datenstrom entwickelt.
Warum Ergebnisse aus dem Stream-Processing Kontext brauchen
Eine der größten konzeptionellen Veränderungen, wenn Stream-Processing in die Architektur Einzug hält, ist, dass es keinen natürlichen Punkt gibt, an dem die Eingabe einfach „fertig“ ist.
Wenn Sie eine Abfrage für die Umsatz-Tabelle der letzten Woche ausführen, ist die Grenze offensichtlich. Sie wissen, welche Datensätze in die Berechnung gehören. Aber bei einem fortlaufenden Stream müssen Sie diese Grenzen selbst festlegen – welche Ereignisse zu einer Berechnung gehören, wie lange Sie bereit sind, auf verspätete Daten zu warten, und was passieren soll, wenn Ereignisse wiederholt oder mehr als einmal zugestellt werden.
Fenster definieren, was Sie messen
Die meisten Streaming-Berechnungen benötigen eine Möglichkeit, einen fortlaufenden Stream in analysierbare Einheiten umzuwandeln. Hier kommen Fenster ins Spiel.
- Ein Tumbling Window erstellt feste, sich nicht überschneidende Zeiträume. Sie könnten das Transaktionsvolumen von 10:00 bis 10:05 Uhr berechnen und dann ein neues Fenster von 10:05 bis 10:10 Uhr starten.
- Ein Sliding Window überschneidet sich. Wenn Sie möchten, dass „Transaktionen der letzten zehn Minuten“ jede Minute neu berechnet werden, enthält jedes neue Fenster einige Ereignisse aus dem vorherigen.
- Ein Session Window funktioniert anders und gruppiert Ereignisse nach Aktivitätszeiträumen anstatt nach festen Uhrzeitgrenzen.
Ein Streaming-Wert wie „1.240 Transaktionen“ ist für sich genommen also unvollständig. Sie müssen auch wissen, zu welchem Intervall oder welcher Sitzung diese Transaktionen gehören.
Ereigniszeit und Verarbeitungszeit sind selten identisch
Die Ereigniszeit ist der Zeitpunkt, an dem etwas tatsächlich passiert ist. Die Verarbeitungszeit ist der Zeitpunkt, an dem das Analysesystem es gesehen oder verarbeitet hat. Diese Zeitstempel unterscheiden sich oft.
Angenommen, eine Transaktion fand um 10:04:58 Uhr statt, erreichte die Analytics-Pipeline aber erst um 10:06 Uhr. Vielleicht ist eine Netzwerkverbindung ins Stocken geraten, oder ein vorgeschaltetes System hat das Ereignis erneut gesendet. Aus der Perspektive der Ereigniszeit gehört die Transaktion in das Fenster von 10:00 bis 10:05 Uhr. Aber aus der Perspektive der Verarbeitungszeit ist dieses Fenster bereits vergangen.
Aus diesem Grund sind Watermarks und Richtlinien für verspätete Daten erforderlich. Ein Watermark ist die Schätzung des Systems, wie weit die Ereigniszeit fortgeschritten ist. So kann es entscheiden, wann ein Ereigniszeitfenster bereit ist, ein Ergebnis zu liefern. Eine Lateness-Policy bestimmt, was passiert, wenn Ereignisse nach diesem Zeitpunkt eintreffen. Längeres Warten erfasst mehr Nachzügler, bevor ein Ergebnis feststeht, während ein früheres Schließen aktuellere Ergebnisse liefert, aber mit einer größeren Wahrscheinlichkeit, dass verspätete Daten ein Update erfordern oder separat behandelt werden müssen.
Will Xu, Principal Product Manager für Snowflake Interactive Analytics, schlägt vor, diese Toleranz in der Entscheidung selbst zu verankern: „Teams sollten das maximale Fenster festlegen, das ein Workload für spät eintreffende Daten tolerieren kann. Typischerweise beträgt das Fenster vier Stunden. Je größer das Fenster, desto höher die Infrastrukturkosten. Es ist eine geschäftliche Entscheidung, die früh in der Planungsphase getroffen werden sollte.“
Auch die Zustellsemantik beeinflusst das Ergebnis
Verspätete Ereignisse sind nur eine Quelle der Unsicherheit. Wiederholte Zustellungen sind eine weitere. Verteilte Systeme verlieren naturgemäß Verbindungen, starten Prozesse neu und senden Daten erneut. Letztendlich wird eine ziemlich banale Frage wichtige analytische Konsequenzen haben: Habe ich dieses Ereignis bereits verarbeitet?
Bei der At-least-once-Zustellung priorisiert das System die Vermeidung von Ereignisverlusten, was bedeutet, dass ein Consumer dasselbe Ereignis möglicherweise mehr als einmal erhält. Die nachgelagerte Verarbeitung muss Duplikate tolerieren – üblicherweise durch idempotente Operationen, die bei Wiederholung dasselbe effektive Ergebnis liefern.
Die Exactly-once-Zustellung soll sicherstellen, dass jedes Ereignis das Ergebnis genau einmal beeinflusst, selbst wenn Wiederholungsversuche stattfinden. Dies erfordert typischerweise eine Koordination über die Systeme hinweg, die die Ereignisse produzieren, verarbeiten und speichern.
Für jemanden, der ein analytisches Ergebnis liest, erscheint all diese Infrastruktur nur als eine Zahl auf einem Bildschirm. Aber die Semantik sollte nicht innerhalb der Pipeline verschwinden. Wenn eine Streaming-Metrik eine Entscheidung beeinflussen wird, sollten Teams ihr Fenster kennen, wissen, wie verspätete Daten behandelt werden, und welche Zustellgarantien dahinterstehen.
Teams benötigen auch eine Abgleichsrichtlinie. Eine um 10:05 Uhr verwendete Streaming-Zahl kann von einem späteren Batch-Ergebnis abweichen, nachdem verzögerte Datensätze ihren Weg durch das System gefunden haben. Entscheiden Sie im Voraus, welcher Wert maßgeblich ist und wie Abweichungen aufgelöst werden.
KURZER TIPP
Dokumentieren Sie Fenster, Lateness-Policy und Zustellsemantik zusammen mit der Kennzahl. Einer Streaming-Zahl ist viel leichter zu vertrauen, wenn Nutzer:innen wissen, welche Daten sie enthält und was sich noch ändern kann.
Wann Streaming Analytics die Kosten wert ist
Manche Workloads haben tatsächlich extrem kurze Entscheidungsfenster. Betrugsautorisierung, Anzeigengebote und bestimmte Maschinensteuerungssysteme müssen möglicherweise innerhalb von Millisekunden reagieren. Die Verarbeitung findet dann meist direkt in der Anwendung oder im Stream-Processing-Pfad statt, sodass die Entscheidung innerhalb der Transaktion fallen kann.
Aber die meisten Enterprise-Analytics-Anwendungsfälle arbeiten nicht unter diesen Einschränkungen, und viele können durch Analysen nahezu in Echtzeit abgedeckt werden, ohne kontinuierliche Berechnung während der Übertragung. Ein Operations-Team muss möglicherweise innerhalb weniger Minuten sehen, wie sich ein Backlog entwickelt, damit jemand eingreifen kann. Oder ein Logistik-Workflow muss möglicherweise eine Sendungsausnahme anzeigen, während eine Umleitung noch möglich ist. Ein automatisierter Prozess benötigt möglicherweise aktuelle Telemetrie, bevor er entscheidet, was als Nächstes zu tun ist. In solchen Fällen hat eine Aktualität im Bereich von Sekunden bis Minuten einen echten, praktischen Wert.
Wann periodische oder Micro-Batch-Verarbeitung ausreicht
Es gibt gute Gründe, warum sich die Batch-Verarbeitung gehalten hat. Jeder Lauf arbeitet mit einer begrenzten Datenmenge in einem definierten Intervall, was Ihnen eine relativ klare Einheit zum Testen, Wiederholen und Überprüfen gibt, wenn etwas schiefgeht.
Micro-Batching verkürzt das Intervall, sodass kleine Gruppen von Datensätzen alle paar Sekunden oder Minuten verarbeitet werden. Abhängig vom Workload kann dies oft ausreichend aktuelle Daten liefern.
Wenn beispielsweise ein Logistik-Dashboard bei einem Aktualisierungsintervall von fünf Minuten nützlich ist, verbessert die Aufrechterhaltung eines kontinuierlichen Zustands zwischen jedem eingehenden Ereignis die Entscheidung möglicherweise nicht, und Analysen nahezu in Echtzeit sind wahrscheinlich die bessere Wahl. Wenn das Team jedoch eine Sequenz erkennen muss, während sie sich entfaltet, oder wenn ein Warten von fünf Minuten dazu führen würde, dass sich das Interventionsfenster schließt, spricht mehr für Stream-Processing.
Viele Teams kombinieren Batch- und Streaming-Ansätze, anstatt jede Phase der Pipeline in dasselbe Verarbeitungsmodell zu zwingen.
Geringere Latenz bedeutet normalerweise höhere Kosten
Dieser Ansatz bietet Ihnen auch ein nützlicheres Kostenmodell. Eine geringere Latenz erfordert im Allgemeinen eine häufigere Verarbeitung und engere betriebliche Toleranzen, was die Kosten für Rechenressourcen erhöhen kann – ebenso wie den Aufwand für Überwachung, Fehlerbehebung und Datenabgleich, den der Workload erfordert. Vergleichen Sie diese laufenden Kosten mit den Entscheidungen, deren Ergebnisse sich tatsächlich verbessern, wenn die Daten sie schneller erreichen.
Diese Beispiele zeigen, wie unterschiedlich die Anforderungen sein können:
- Betrugsautorisierung: Oft Millisekunden, mit Entscheidungslogik in der Transaktion oder im Stream-Processing-Pfad.
- Erkennung betrieblicher Anomalien: Sekunden bis Minuten, je nachdem, wie schnell eine Person oder ein automatisierter Workflow reagieren muss.
- Bestands- und Fulfillment-Überwachung: Häufig in Minuten gemessen, wobei eine inkrementelle oder kurzintervallige Verarbeitung die Anforderung erfüllen könnte.
- Management-Reporting: Oft stündlich oder täglich, es sei denn, ein anderer nachgelagerter Workflow konsumiert die Daten früher.
HÄUFIGER FALLSTRICK
Ein häufiger Fehler ist die Annahme, dass jeder Streaming-Analytics-Workload Stream-Processing erfordert. Viele Workloads benötigen nur Streaming-Ingestion und eine schnelle Abfrageschicht – keine Fenster, keine Zustandsverwaltung, keine Watermarks. Setzen Sie Stream-Processing ein, wenn die Daten während der Übertragung transformiert, angereichert oder dedupliziert werden müssen; lassen Sie es weg, wenn die aufgenommenen Rohdaten bereits abfragebereit sind.
Streaming Analytics mit Snowflake
Snowflake unterstützt Streaming Analytics auf einer einzigen Plattform mit zentraler Governance – von der Ingestion über das Stream-Processing bis zur Bereitstellung mit geringer Latenz –, sodass Teams keinen separaten Streaming-Infrastruktur-Stack betreiben müssen.
Die Streaming-Analytics-Pipeline umfasst drei Stufen, die jeweils in einem eigenen Deep Dive vertieft werden:
Streaming-Ingestion bringt Ereignisdaten bereits bei ihrer Entstehung in Snowflake – ohne Staging-Dateien oder zwischengeschalteten Objektspeicher. Dies umfasst die direkte API-Ingestion über Snowpipe Streaming, den Snowflake Kafka Connector und Change Data Capture aus operativen Datenbanken.
Stream-Processing transformiert, reichert an und strukturiert Daten während der Übertragung, bevor sie den Serving-Layer erreichen. Dies umfasst Deduplizierung, Joins mit Dimensionstabellen, Zeitfenster-Aggregationen und CDC-Verarbeitung – Operationen, die bisher eine separate Stream-Processing-Engine wie Apache Flink erforderten.
Die Bereitstellung mit geringer Latenz macht die resultierenden Daten mit der Geschwindigkeit abfragbar, die der Workload erfordert. Interactive Analytics unterstützt hochgradig parallele Abfragen im Subsekundenbereich.
Da alle drei Stufen nativ in Snowflake ausgeführt werden, erbt jede Zeile die bestehenden Governance-Regeln, Zugriffskontrollen und die Datenherkunft (Data Lineage), die Sie konfigurieren. Es gibt keinen separaten Streaming-Stack, den Sie absichern oder abgleichen müssen.
Streaming als Designentscheidung, nicht als Standard
Sobald Echtzeitanalyse ins Spiel kommt, liegt der Gedanke nahe, direkt auf Streaming Analytics zu setzen: kontinuierliche Ingestion, Verarbeitung während der Übertragung, der gesamte Stack. Doch Echtzeitanalyse ist der Oberbegriff, und Streaming Analytics ist nur ein Weg dorthin. Viele Echtzeit-Workloads werden durch schnelle Abfragen über häufig aktualisierte Daten gut bedient, ganz ohne Data-in-Motion-Architektur.
Beginnen Sie mit dem, was der Workload tatsächlich erfordert: wie aktuell die Daten sein müssen, ob sie vor ihrer Nutzung transformiert werden müssen und ob diese Transformation während der Übertragung erfolgen muss. Lassen Sie diese Antworten bestimmen, wie viel des Streaming-Analytics-Stacks in das Design gehört. Sie haben am Ende weniger bewegliche Teile zu betreiben und abzustimmen – und erhalten dennoch Streaming-Performance, wo sie einem Zweck dient.
WICHTIGSTE ERKENNTNIS
Beginnen Sie mit dem Workload, nicht mit der Technologie. Definieren Sie, wie aktuell die Daten sein müssen, ob sie eine Transformation während der Übertragung erfordern und welche Abfragegeschwindigkeit die konsumierende Anwendung oder der:die Nutzer:in benötigt – und bauen Sie dann nur die Teile des Streaming-Analytics-Stacks, die diese Antworten verlangen.
Häufig gestellte Fragen
Ihre häufigen Fragen zu Streaming Analytics, beantwortet von Snowflake-Expert:innen.
Ist Streaming Analytics dasselbe wie Echtzeitanalyse?
Nein. Streaming Analytics ist ein Teilbereich der Echtzeitanalyse. Echtzeitanalyse umfasst jeden Workload, bei dem Daten und Ergebnisse aktuell genug für eine zeitnahe Entscheidung oder Aktion sein müssen. Diese Aktualität kann aus Streaming-Ingestion, Micro-Batch-Loading oder einer beliebigen Kombination stammen. Streaming Analytics bedeutet konkret, dass Daten kontinuierlich aufgenommen und optional während der Übertragung verarbeitet werden, bevor sie für Abfragen mit geringer Latenz im Serving-Layer landen.
Wann sollten Sie Streaming Analytics anstelle von Batch-Verarbeitung verwenden?
Streaming Analytics ist nützlich, wenn Daten innerhalb von Sekunden für die Analyse verfügbar sein müssen und wenn eine Verarbeitung während der Übertragung (Stream-Processing) erforderlich ist, um Ereignisse zu transformieren, anzureichern oder zu deduplizieren, bevor sie den Serving-Layer erreichen. Kommen die Antworten auch mit periodischen Aktualisierungen rechtzeitig an, ist eine Analyse nahezu in Echtzeit oft einfacher und kostengünstiger zu betreiben.
Ressourcen zu Analytics entdecken
Analytics-Themen entdecken
Detaillierte Einblicke in jeden Aspekt von Analytics
